Unified Agent:跨设备AI不再追问“哪台设备”,性能最高提升40.8%
Unified Agent: Managing Interactions across Devices
在多设备深度渗透日常生活的今天,人们早已习惯在不同屏幕之间穿梭:通勤路上用手机翻看心仪的餐厅,到工位后在电脑前处理邮件,回到家又靠在沙发上用平板核对日程。当多模态大模型从单一 App 里的聊天助手走向能够接管物理设备的通用 Agent 时,一种显而易见的需求浮出水面:用户希望随时随地唤出同一个 AI,让它顺理成章地推进先前的事务。
ArXiv URL:https://arxiv.org/abs/2608.05729v1
现实往往很尴尬。当用户随口吩咐一句“帮我预订我刚才看的那家餐厅”时,现有的多模态 Agent 往往当场卡壳。因为在发出指令的当下,手机屏幕已经熄灭,面前只有亮着的电脑,Agent 既没有当前画面的直接线索,也缺乏连贯的跨设备记忆,只能机械地反问一句:“请问您是在哪台设备上看的?”
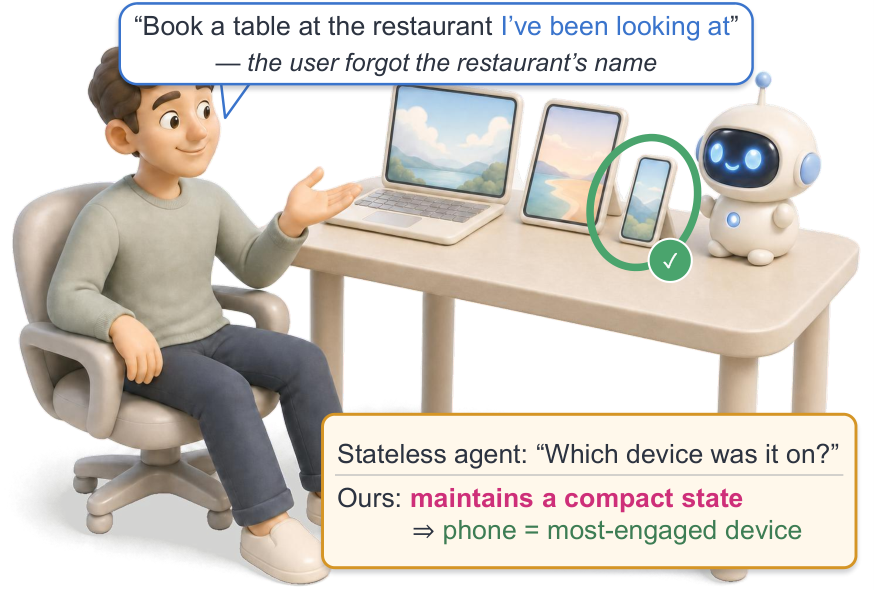
来自加利福尼亚大学圣迭戈分校(UC San Diego)的研究团队针对这一盲区,提出了全新的跨设备多模态智能体框架 Unified Agent。这项研究的核心洞见在于:跨设备、跨时间的交互决策,既不需要暴力拼接所有设备的历史画面导致上下文爆炸,也不能依赖毫无状态记忆的即时工具调用;Agent 必须维护一个精炼且随时可用于动作决策的“携带状态(carried state)”。在专门构建的基准评测 UA-Bench 中,Unified Agent 相比现有四类主流智能体架构取得了 0.194 至 0.408 的全指标性能跨越,同时将历史状态的长度开销锁死在一个稳定常数级,彻底打破了线性膨胀的多模态上下文困局。
为什么当前的多设备 Agent 普遍“缺乏眼力见”?
要理解 Unified Agent 的价值,必须先看清现存智能体架构在多设备协同场景下的天然短板。
当前主流的 Agent 设计大致分为两类。第一类将各类设备粗暴地视作一系列外部工具(Tool-use Agent)。这种架构本质上是无状态的(stateless),它默认每一次交互都是全新的输入。如果用户发出的指令缺乏具体指向,例如没有明确指明“用 iPhone 预订”,Agent 就无法从当前的局部视野(例如摄像头或正在工作的屏幕)中找到答案。一旦用户指点屏幕的手势已经放下、浏览过的页面已经切入后台,能够支撑决策的物理线索便彻底蒸发,模型只能无奈地向用户发起澄清式提问。
第二类则是多智能体系统(Multi-agent systems)。这类架构通常在每个设备或任务节点上分配专门的代理,通过网络协议或集中调度器(Orchestrator)进行分工协作。然而,现有多智能体协同关注的主要是任务拆解与即时分发,它们预设目标设备的执行能力是静态配置好的,或者依赖当前请求里携带的明确参数载荷。一旦某个请求依赖于跨越数分钟、穿插在两三台设备之间的注意力痕迹,各个设备上的代理之间就很难自发聚合出连贯的因果链条。
更关键的工程阻碍是上下文膨胀。如果为了记住一切而把多台设备上的摄像头视频帧、屏幕截图、对话历史不做过滤地持续丢进模型的上下文窗口,输入长度会随着时间线性飙升。实验表明,常规的全上下文方案所占用的上下文体积迅速膨胀至 Unified Agent 紧凑状态的 11 倍以上。这不仅极大推高了推理延迟和 API 成本,更会让大模型迷失在大量无意义的背景噪声中,导致“大海捞针”式的决策失效。
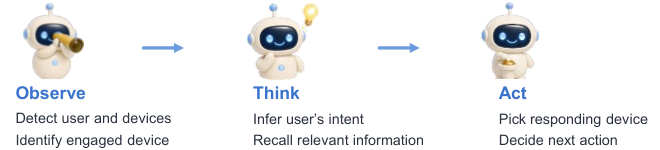
携带状态:用三条线索把碎片拼成决策
Unified Agent 的核心突破在于其状态设计(State Design)。研究团队并没有引入复杂的端到端可学习外挂存储器,也没有对模型执行昂贵的微调,而是定义了一个由轻量结构化文本承载、持续滚动的携带状态 $S_t$。这个状态始终保持紧凑,并被精准拆解为三条支撑后续行动的“证据流”:
首先是交互参与证据(Engagement Evidence)。这是解决设备归因谜题的关键钥匙。Agent 通过设备摄像头感知用户与各个设备的互动强度,将视线凝视、手部指点、物理接触等离散的人机互动行为,量化并累积绑定到具体的物理设备上。回到开头的例子,即便用户预订时两手空空,状态里也已经沉淀了“用户在手机上交互最深入、停留时间最长”的显式记录。当模糊指令降临时,Agent 便能第一时间锁定手机,而非无差别质询。
其次是陈述事实(Stated Facts)。用户在跨设备场景下经常会零星抛出关键信息,例如“周五下午三点有个评审”,或者“这台平板是给客户展示用的”。Unified Agent 会按主题以及关联设备对这些事实进行结构化沉淀。即使多个设备上讨论的是同一个主题,事实流也能清晰区隔它们归属于哪台物理载体,避免设备间的信息串扰与幻觉。
最后是待办请求(Standing Request)。跨设备任务往往伴随着延迟执行,用户可能先提出一个待办想法,过了一会儿才触发执行。该证据流实时保留最新尚未终结的操作意图,确保当触发信号出现时,动作解码器能够立刻将意图与目标设备进行组装。
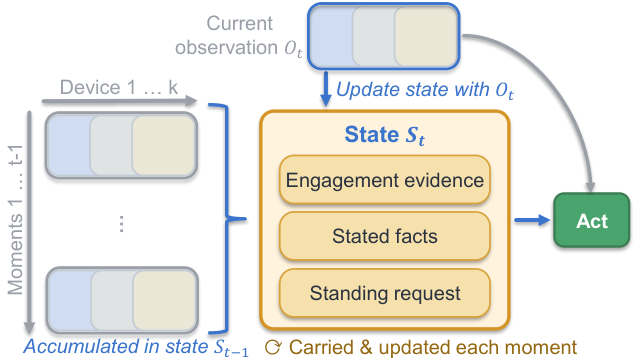
整个系统的运转遵循严密的“感知–折叠–执行”闭环。在时刻 $t$,系统已经持有上一阶段沉淀的状态 $S_{t-1}$,此时某一设备的摄像头捕获了当前局部的单重视角观测 $O_t$(包括图像与当前语音文本)。系统并不把 $O_t$ 简单贴在历史记录末尾,而是执行一次折叠更新(Fold):
\[S_t = U(S_{t-1}, O_t)\]更新算子 $U$ 负责将新的交互证据、事实与待办请求提炼吸收到三条证据流中,抛弃冗余的多模态原始数据。在完成状态刷新后,决策解码器 $D$ 结合最新状态 $S_t$ 与当前瞬时观测 $O_t$ 生成具体动作指令:
\[a_t = D(S_t, O_t)\]值得注意的是,Unified Agent 在下游执行层面采取了优雅的“松耦合”策略:大模型只负责在最高层做设备决断,输出自然语言控制指令,指定具体由哪一台或哪几台设备执行何种任务;而设备端则使用自身系统原生的原生控制逻辑(Native Controls)来承接落地。这种控制权切分让单一模型能够即插即用地适配各种异构硬件,而无需为每种设备定制底层驱动模型。
逼近真实物理规律的基准:UA-Bench
为了科学量化不同状态设计对跨设备协同的真实影响,研究团队打造了一套高保真、可复现的三维交互基准 UA-Bench。
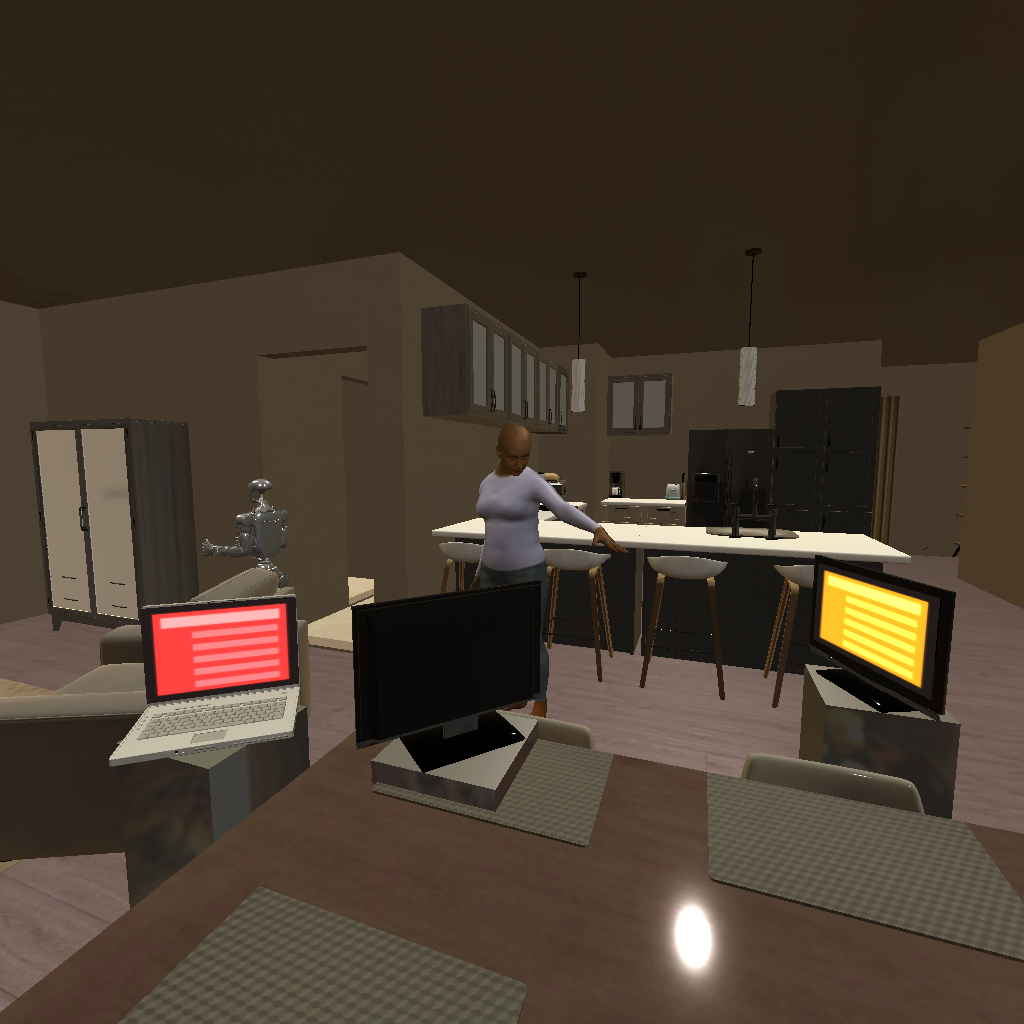
现有的智能体评测要么局限于纯网页浏览,要么停留在合成环境下的文本对话,极少考察物理空间多设备分布与时序线索交织的复杂场景。UA-Bench 构建了一名用户在逼真三维房间内与多台设备(手机、平板、笔电、桌面屏幕等)互动的完整时序。环境在空间布局、光照、设备摆放位置、对话主题及用户动作姿态上施加了系统的受控扰动。
评测的核心严苛之处在于:在每个离散时序切片上,Agent 只能拿到当前所激活设备的单目局部摄像头视野,既没有能够鸟瞰全屋的“上帝视角”,也不允许在发生请求时把先前的录像从头重播一遍。任务链条涵盖了从环境感知与设备检测、参与设备辨识、意图解析、跨设备信息召回,一直到最终的多设备动作派发全流程。通过合成渲染引擎自带的元数据与语义图(Semantic Maps),评测能够以客观的确定性逻辑校验模型产出的归因设备与执行动作,排除了传统大模型充当裁判(LLM-as-a-judge)时常出现的评分漂移与主观偏差。
实验结论:状态质量全面压倒规模暴力
在 UA-Bench 的全面对抗测试中,Unified Agent 展现出了极为稳固的压制性优势。研究团队将其与全上下文保留机制(Full context)、无状态响应机制,以及适配自顶尖学术成果的四类主流基准(涵盖经典记忆检索框架与多智能体分发网络)进行了成对统计检验。
实验的核心发现集中在三个层面:
第一,宏观表现大幅跃升。在聚合了设备辨识、意图理解、事实召回、设备路由与后续动作五项下游决断的 Overall 综合得分上,Unified Agent 全面超过所有对比系统。面对四类已发表的经典基准方案,Unified Agent 取得的绝对优势幅度达到了 0.194 至 0.408。通过配对 Bootstrap 统计检验($p < 10^{-3}$),该优势在严苛的 Holm 置信调整后依然完全显著,证明紧凑状态所带来的推理确定性远非检索式记忆或松散多 Agent 通信所能比拟。
第二,超越基础模型的全普适性。很多系统级优化往往高度绑定特定模型的特性,但在更换了不同的底层多模态大模型家族、拉大模型参数规模等级、以及调整推理思考预算(Reasoning Effort)的全部设定下,Unified Agent 的领先位次保持得异常稳定。数据证明,即便给对比系统换上推理能力极强的顶配基座,只要其内部状态机制未能妥善解耦跨设备时序证据,其整体表现依然无法逾越使用轻量携带状态的 Unified Agent。状态工程的合理性,是基础模型尺寸与算力无法单方面代偿的关键维度。
第三,各设计要素的功能解耦非常纯粹。消融实验清晰地揭示了各项机制的贡献边界:交互参与证据直接决定了“识别正在交互的设备”的准确率;陈述事实流是后续“跨设备信息召回”的生命线;而外部注入的设备能力描述则精准支撑了“请求路由到哪台设备”。每一条证据流各司其职,互不抢占上下文带宽。
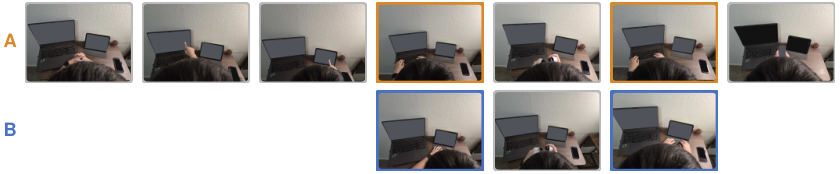
为了验证该机制能否走出三维仿真环境、应对现实世界纷繁复杂的视觉挑战,研究团队进一步采集了真实物理场景照片进行成对测试。如上图所示,在严格控制光照与角度的对照测试中,用户在 Episode A 中与笔记本电脑互动,而在 Episode B 中改为与平板电脑互动,但到了最后发出动作请求的时刻,画面中的环境与用户手势完全一致。无状态系统在这种情况下彻底陷入盲猜,而 Unified Agent 凭借状态中沉淀的物理接触证据(手部触碰设备的视觉线索),在两套真实照片序列中均 100% 准确识别出早先互动的真实设备,并精准提取出了对应设备屏幕上的关键时间信息,完全避开了诱导性干扰。
迈向真正可用的个人跨设备智能体
长期以来,业界在构建复杂任务智能体时往往容易滑向两个极端:要么寄希望于大模型拥有无限上下文窗口,将原始音视频全量堆积,试图用算力硬解一切;要么设计层层嵌套的复杂多 Agent 协同网络,在频繁的节点通讯和格式转换中损耗了上下文的确定性。
Unified Agent 提供了一条极具启发性的工程化中道。它表明,跨设备交互的核心障碍并不是视觉感知的分辨率不够高,也不是规划模型的逻辑链路不够长,而是信息在物理设备间的流转缺乏结构化的锚定。通过将散落在线索消失瞬间的“参与痕迹”即时提炼为高密度的显式事实,系统不仅彻底摆脱了长上下文窗口带来的性能反噬,还将不可控的黑盒隐空间记忆转变为人类与开发者完全可读、可审计、可修改的显式状态。
这种“设计即数据最小化(data minimization by design)”的架构特性,同时为隐私敏感的多设备生态提供了极佳的落地范本。系统无需在私有设备间互传冗长且侵犯隐私的摄像头原始录像,只需同步几行高度精炼的交互事实摘要,即可让用户无缝享受到“懂我所想、随叫随到”的跨端连贯体验。这项工作不仅确立了跨设备 Agent 评测的标准范式,更清晰地指明:在追求更大模型规模的同时,如何优雅地组织与携带状态,才是决定智能体能否走出单一屏幕、自如穿梭于现实世界的核心胜负手。