TurnSight:百度提出轮次级后见自蒸馏,多轮工具调用提升7.7%
TurnSight: Turn-Level Hindsight Self-Distillation for Tool-Integrated Reasoning
让大语言模型(LLM)调用外部工具完成复杂推理,也就是工具集成推理(Tool-Integrated Reasoning,简称 TIR),已经成为构建智能体(Agent)的标准范式。模型不再是一步到位输出最终文本,而是需要不断地生成代码或 API 请求、解析环境返回的执行结果、修正错误,直到推导出终极答案。
ArXiv URL:https://arxiv.org/abs/2608.04007v1
然而,一旦进入多轮交互的长链路任务,现有的强化学习方法就会遭遇严重的归因困境。以目前主流的基于可验证奖励的强化学习(RLVR,如 GRPO)为例,系统通常只能在终点根据最终答案的对错给出单一的轨迹级标量奖励。这种粗粒度的奖励分配方式,往往会将成功归功于轨迹里的每一个动作,或是将失败归咎于所有步骤。哪怕智能体中间某一步的工具调用极度精妙,只要最终答案因为末尾微小的计算失误挂掉,这一步就会同罪受罚;反之,一段充满冗余无用调用的轨迹只要碰巧答对,所有低效操作也会被强化。
为了打破这种“吃大锅饭”式的轨迹级信用分配(Credit Assignment),百度与中国人民大学的研究团队提出了 TurnSight。这是一种面向多轮工具推理的轮次级后见自蒸馏框架(Turn-Level Hindsight Self-Distillation)。该方法不依赖额外的标准轨迹标注,也不向模型灌输上帝视角的标准答案,而是直接利用智能体自身与环境交互产生的真实执行结果构建后见监督信号。实验表明,TurnSight 在 Qwen3-8B 模型上将多轮工具推理的综合性能提升了 7.7%,并在长上下文和参数缺失等极具挑战的子任务中大幅拉开差距。
多轮工具调用的信用难题与传统自蒸馏的失效
要理解 TurnSight 的突破点,需要先看清现有解决方案为何在多轮交互中屡屡碰壁。
面对长程任务中的稀疏奖励,社区最直接的尝试是引入更密集的单步监督。例如,许多方法尝试将模型生成的工具调用与预先标注的标准轨迹进行比对。这种机制表面上提供了细粒度的步级反馈,但在多轮交互中极度脆弱。一旦模型在第一轮输入了一个与标准答案不同但同样合法的参数,外部环境的状态就已经发生了不可逆的漂移。此时,强行要求后续步骤去对齐原本的标准轨迹,就变成了刻舟求剑——环境已经变了,原本的“标准动作”在当前状态下甚至可能直接报错。
在策略自蒸馏(On-Policy Self-Distillation,简称 OPSD)因此被寄予厚望。自蒸馏的核心逻辑是:在训练阶段为同一个模型开启一个拥有“特权上下文”的教师分支,让教师去评估学生模型在自身访问到的状态下所生成的动作,以此提供密集反馈。
然而,现有的自蒸馏范式在移植到工具推理场景时,暴露了两个结构性缺陷。
首先是特权信息的“状态错位(State Misalignment)”。多数自蒸馏工作倾向于把终局的标准答案、外部检索到的技能或成功的专家轨迹塞进教师分支。这些全局特权信息能告诉模型“最终任务该怎么做”,却无法客观评价“在当前这个被改动过的特定环境状态下,模型刚刚发起的工具调用到底合不合理”。环境执行的动态变化被全局答案所掩盖,导致自蒸馏给出的监督信号与当前局势脱节。
其次是优化粒度的错配。传统的自蒸馏几乎都是在 Token 级别计算教师和学生的概率差距。但在工具交互场景中,智能体的一个决策单元并不是孤立的 Token,而是一个完整的交互轮次(Turn)——它包含自然语言思考、API 函数选取以及 JSON 参数构建。如果把蒸馏拆解到 Token 级别,格式化字符、缩进、参数名称和核心逻辑会产生幅度甚至正负完全相反的反馈,同一轮交互内的 Token 彼此打架,信用分配反而被严重撕裂。
TurnSight 的核心机制:以后见之明重构轮次信用
针对上述痛点,TurnSight 确立了两个核心原则:第一,监督信号必须与模型当前真实身处的执行状态严格对齐;第二,信用评估的最小颗粒度必须是完整的交互轮次。
TurnSight 的具体工作流可以拆解为后见特权构建、轮次级聚合、多视界一致性筛选以及保号优势调制四个紧密相连的步骤。
1. 以真实执行结果构建特权上下文
TurnSight 摒弃了外部标准答案,教师分支获得的唯一特权信息,就是学生模型自己这趟交互里真实发生的工具执行结果(Tool Execution Outcomes)。
假设模型在第 $k$ 轮根据历史上下文 $c_{i,t}$ 输出了动作,并观察到了环境返回的工具调用结果 $o_{i,k}$。在推演发生的瞬间,模型是不知道这一步调用到底会返回有效数据还是报错信息的;但事后来看,这段执行结果就是最直接的“后见证据(Hindsight Block)”。将这段未来发生的执行反馈拼接到原本的上下文中,就构成了特权上下文 $c_{i,t}^{+(d)}$:
\[c_{i,t}^{+(d)} = c_{i,t} \oplus \mathcal{H}_{i,k}^{(d)}\]其中 $\mathcal{H}{i,k}^{(d)}$ 包含了未来 $d$ 步交互所产生的工具调用与观测结果。教师模型(由冻结的参考策略 $\pi{\mathrm{ref}}$ 充当)在看到这些后见执行反馈后,重新评估学生在第 $k$ 轮生成的 Token:
\[\delta_{i,t}^{(d)} = \log\pi_{\mathrm{ref}}(y_{i,t}\mid c_{i,t}^{+(d)}) - \log\pi_{\theta}(y_{i,t}\mid c_{i,t})\]如果教师在获悉执行结果后,对学生生成的动作概率大幅上升,说明这一步在事后被证明极有价值;如果概率暴跌,则说明后见证据显示这一步是个低级失误或无效调用。
2. 从 Token 噪声到轮次级稳定表征
为了消除 Token 级别的符号噪声,TurnSight 并不直接拿单步 Token 的差距做梯度更新,而是将第 $k$ 轮内属于策略生成的所有 Token 集合 $\mathcal{Y}_{i,k}$ 进行算术平均:
\[\bar{\delta}_{i,k}^{(d)} = \frac{1}{\lvert \mathcal{Y}_{i,k} \rvert}\sum_{t\in\mathcal{Y}_{i,k}}\delta_{i,t}^{(d)}\]这种轮次级的聚合彻底抹平了标点、转义字符和冗长参数内部的细碎震荡,使模型获得了一个关于“这一整轮思考与工具调用究竟是对是错”的全局定性分数 $\bar{\delta}_{i,k}^{(d)}$。
3. 多前瞻视界的交叉方向一致性筛选
在多轮交互中,不同的工具决策显现价值的时间跨度截然不同。某些决策(例如 API 参数格式是否合法、函数名称是否匹配)在单步执行后就能立竿见影地得到验证;而另一些决策(例如检索某个关键词以备后用)可能要等到两三轮之后的复杂计算中才能体现出战略价值。
单一看近处可能错杀具有长远价值的尝试,单一看远处又容易引入无关的后续噪声。TurnSight 的应对方案是构建多个不同前瞻深度(Lookahead Depth $d \in \mathcal{D}H$)的后见视图。系统首先统计各个视界下反馈分数的符号 $s{i,k}^{(d)} \in {+1, -1}$,并采用少数服从多数的机制确定该轮决策的主流方向 $v_{i,k}$:
\[d_{i,k}^* = \arg\max_{d\in\mathcal{D}_H: s_{i,k}^{(d)}=v_{i,k}} \left\vert{}\bar{\delta}_{i,k}^{(d)}\right\vert{}\]这意味着,如果某个前瞻视界的评估方向与多数视界发生冲突,系统会果断将其判定为偶发噪声并予以剔除;而在与主流方向保持一致的视界中,选取绝对值最大、证据最确凿的那个作为最终的轮次后见信号 $\bar{\delta}_{i,k}^*$。这种机制在保留丰富长程信息的同时,过滤掉了不稳定的局部抖动。
4. 组内归一化与保号优势调制
拿到了单轮的绝对信号后,还面临最后一个门槛:不同 Query 的难度不同,轨迹长度不同,教师和学生的原始对数概率差在数值尺度上差异极大。
TurnSight 借鉴了 GRPO 的同胞采样思想,在针对同一 Prompt 采样出的 $G$ 条交互轨迹中,计算后见信号的均值 $\mu_{q_i}^{\delta}$ 和方差 $\sigma_{q_i}^{\delta}$,进行组内相对归一化:
\[\widehat{\delta}_{i,k} = \frac{\bar{\delta}_{i,k}^* - \mu_{q_i}^{\delta}}{\sigma_{q_i}^{\delta} + \epsilon}\]在最终调整策略梯度时,TurnSight 没有引入额外的模仿学习损失函数,也没有把自蒸馏设计成硬性改变优化方向的强加目标,而是设计了一个有界的权重因子 $w_{i,t}$,去自适应缩放原生的强化学习优势函数 $A_{i,t}^{\mathrm{base}}$:
\[w_{i,t} = 1 + \epsilon_w \tanh\left(\mathrm{sign}\left(A_{i,t}^{\mathrm{base}}\right) \widehat{\delta}_{i,k}\right)\] \[\widetilde{A}_{i,t} = A_{i,t}^{\mathrm{base}}\left[(1-\lambda) + \lambda w_{i,t}\right]\]这里的数学设计十分精巧:通过引入 $\mathrm{sign}\left(A_{i,t}^{\mathrm{base}}\right)$,确保后见信号只会“放大”或“缩小”原有的强化学习奖励,而绝不会反转其正负号。换句话说,最终任务成功的轨迹依旧保持正向鼓励,但其中被后见机制认定为“无用且拖沓”的轮次,其获得的鼓励会被大幅缩减;任务失败的轨迹整体受罚,但其中被证明“探索方向极佳”的个别操作,受罚程度会被显著削弱。RL 探索的大方向被完好保留,但轮次间的信用被切分得极其精准。
实验评测:长程复杂交互中的跨越式提升
为了严格评估 TurnSight 的通用性与稳定性,研究人员采用开源框架 verl,以 Qwen3-4B 和 Qwen3-8B 为基础模型,在仅使用合成工具交互数据集 FTRL 进行后训练的前提下,同时在域内基准(FTRL)以及极具代表性的域外基准(BFCL、ToolHop)上进行了评测。
评测对比了标准强化学习算法(GRPO)、结合轨迹比对的步级监督方法(MatchTIR)以及数种主流的自蒸馏策略(如 SDPO、RLSD、SDAR)。
从实验数据中可以提炼出几个极具启发性的结论:
第一,仅依赖终局结果的 GRPO 虽然在域内训练集上有一定提升,但在域外基准(BFCL 与 ToolHop)上泛化表现较弱。这印证了此前的理论假设:面对长链路的复杂多轮调用,单一的轨迹级标量奖励无法帮助模型学会合理的中间归因,学到的策略极易过拟合在训练集的特定执行路径上。
第二,现有的 Token 级或依赖外部答案的自蒸馏方法(如 RLSD 等)虽然略优于朴素 GRPO,却普遍打不过显式建模工具调用的基线。这说明,如果自蒸馏的教师总是拿着脱离实际状态的全局答案对每一个 Token 评头论足,给出的信号不仅充满矛盾,还会干扰强化学习的探索节奏。
第三,TurnSight 在各项基准上全面刷新了最佳水平。在 Qwen3-8B 模型上,TurnSight 取得了相对最强基线 7.7% 的综合表现跃升。尤其是在 BFCL 的“长上下文(Long Context)”与“缺失参数(Miss Parameter)”两个极度考验多轮纠错与因果推理的子集上,TurnSight 的表现尤为抢眼。这直接证明了多前瞻视界和轮次级聚合在捕捉长依赖因果关系时的威力。
一个违背直觉的发现:为什么标准答案反而有害?
在论文的消融实验与深入分析中,有一项反直觉的发现格外引人注目:在构建自蒸馏的特权上下文时,到底给教师看什么信息最好?
直觉上,给予教师的信息越全面、越全知,教师给出的指导理论上应该越精确。研究人员对比了三种特权上下文的组合方式:
-
仅提供工具执行结果(Tool result only,即 TurnSight 默认方案)
-
工具执行结果 + 终局标准答案(Tool result + ground-truth answer)
-
仅提供终局标准答案(Ground-truth answer only)
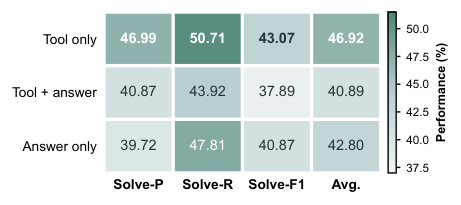
实验结果清晰地表明,仅使用工具执行结果的方案取得了最好的性能。当向特权上下文中额外塞入终局标准答案后,模型的表现不仅没有上升,反而出现了明显的下滑;而只给标准答案的方案表现最差。
这个现象背后的因果逻辑非常深刻:
在多轮工具交互中,智能体每迈出一步,其实都是在与一个充满不确定性的动态环境打交道。工具执行返回的报错代码、截断文本或空返回值,是与当前环境直接关联的第一手因果证据。教师模型根据这些即时反馈,能够精准判断“刚刚这句调用在这个特定环境里究竟有没有推进问题解决”。
相反,如果提前把最终的标准答案塞给教师,教师在评估中间某个工具调用时,注意力会不可避免地被终局目标所带偏。它会倾向于用全局终局去倒推局部动作,甚至因为学生当前的局部尝试与标准答案规划的路径不一致,就错误地贬低了这一步极具价值的自主探索。过多的特权信息反而稀释了局部因果性,导致后见评估偏离了当下的执行状态。
此外,在对混合权重 $\lambda$ 和调制幅度 $\epsilon_w$ 的超参数敏感性分析中,两者均呈现出非常典型的单峰分布。最优参数均落在 0.5 左右。这说明,后见自蒸馏不能喧宾夺主:它必须作为对原生强化学习优势函数的适度校准,既要依靠细粒度信用平摊掉噪声,又要依靠原生的环境探索保持长线目标的牵引。
总结与展望
TurnSight 为长程交互式智能体的训练提供了一种全新且极具实操价值的思路。
它跳出了“必须依赖人工标注黄金轨迹”的模仿学习局限,也摆脱了“给模型灌输上帝视角标答”的特权自蒸馏思维定式。通过向智能体自身的交互历史借智慧,以真实发生的工具执行结果作为后见之明,并在轮次级别实现跨时域的一致性聚合,TurnSight 成功在保持纯在策略强化学习自由探索特性的同时,化解了多轮信用分配的顽疾。
这项工作给智能体算法演进带来的关键启示在于:在复杂动态环境的交互中,对模型动作最公允的裁判,往往不是高高在上的预设答案,而是环境在下一刻真实砸向它的物理回声。学会倾听并有效利用这些即时的交互回声,或许正是大模型迈向更高阶自主规划与工具推理的必经之路。