LOPD:给自蒸馏换上可学习隐空间,不到30%采样预算超越GRPO
Latent On-Policy Self-Distillation
在大模型与智能体迈向自我演化(Self-Evolving AI)的演进路径中,一个悬而未决的核心命题始终困扰着研究者:智能体到底该如何消化过去的经验,并将其无损内化进自身策略?
ArXiv URL:https://arxiv.org/abs/2608.13040v1
强化学习虽然能够依托环境奖励进行探索,但在复杂的工具交互与多轮代码编写任务中,奖励信号往往极其稀疏,策略优化常常面临采样效率低下的瓶颈。近来兴起的在线自蒸馏(On-Policy Self-Distillation, OPSD)被视作极具前景的替代路线。这类方法无需调用更大规模的外部模型,而是让模型分饰两角:学生模型基于当前任务历史进行采样,教师模型则额外接收特权信息(Privileged Context)——例如测试用例的标准答案、环境反思反馈或过往成功轨迹。由此,教师在学生真实访问的状态分布上输出高信息密度的词元级(Token-level)监督分布,大幅缓解了策略脱轨与梯度方差问题。
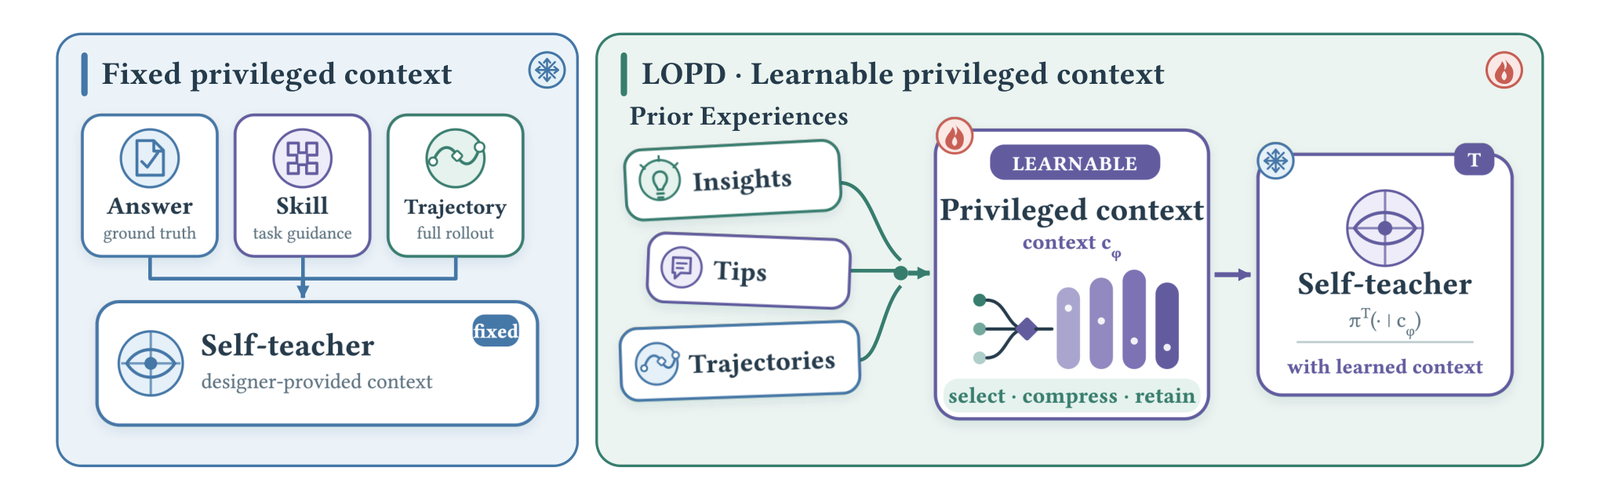
但现有自蒸馏体系隐藏着一个致命的结构性缺陷:教师模型所看到的特权上下文,几乎全是由人类工程师人为预设的离散文本。无论是强制拼接一个成功案例,还是注入一段反思摘要,人类经验所设定的先验,往往与学生当前真正需要的梯度方向存在天然错配。来自北京邮电大学、新加坡国立大学与上海交通大学的研究团队在一项最新工作中指出:智能体进化的上限,不应被工程师设定的文本模板所禁锢。他们提出了隐式在线自蒸馏(Latent On-Policy Self-Distillation,简称 LOPD)。该方法将特权上下文重构成一个端到端可学习的隐空间连续向量,不仅彻底摆脱了人工规则对经验形态的束缚,更在工具调用与代码生成两大高壁垒场景下,仅耗费不到 30% 的 Rollout 预算便击败了 GRPO 与现有自蒸馏基线。
人工预设特权上下文的“倒挂之困”
理解 LOPD 的出发点,必须先看清现有 OPSD 方法究竟在什么地方遭遇了天花板。
在标准的在线自蒸馏范式中,学生和教师通常共享相同的基座架构与初始参数。为了让教师产生比学生更高质量的预测分布,研究人员必须人为给教师“开小灶”。常见的做法包括:直接把环境给出的真实结果拼进提示词(如标准 OPSD)、让教师观察同一批次里其他成功分支的动作(如 SDPO),或是由专门的模块总结成离散技能规则塞入上下文(如 Skill-SD)。
直觉上,教师掌握的信息越多,蒸馏给学生的梯度理应越准确。然而论文揭示了一个令人警醒的实验反差:人工构造的特权上下文不仅无法通用,甚至经常导致模型性能严重倒退。
在基准评测中,针对 Qwen3-4B 基座,引入同批成功轨迹作为特权信息的 SDPO,在复杂函数调用评测 BFCL-v3 上的得分从基座的 $22.88$ 暴跌至 $15.75$,在多轮交互基准 ACEBench 上从 $50.6$ 掉至 $38.0$,在代码基准 LiveCodeBench 上也从 $45.61$ 跌落到 $38.78$。而直接提供最终答案的 OPSD 同样未能幸免,其在 LiveCodeBench 上的综合表现甚至劣于未经微调的初始模型。
这种性能倒挂的深层原因在于离散经验的不适配。以 SDPO 为例,其特权监督完全依赖当前策略能否在同组采样中碰巧跑通一条正确轨迹,一旦策略在困难任务上整体陷落,教师自身就会陷入无监督可用的境地;而注入标准轨迹的 OPSD 则显得过于严苛,学生在自主探索过程中很可能走向了另一条完全合法但与标准答案不同的前缀分支,此时强行拼接死板的人工答案,反而会向学生灌入大量与当前状态严重冲突的错误梯度。
显然,把经验强行翻译为离散的自然语言或代码片段,本质上是在用人类自以为是的逻辑去框定模型的认知过程。真正理想的特权上下文,不应是由外部规则写死的静态文本,而应该根据学生当前遇到的具体困境,自适应地在连续空间中动态调整——这正是 LOPD 试图开创的新图景。
LOPD:让经验表征在端到端蒸馏中自我淬炼
为了让特权信号实现动态演化,LOPD 并没有沿袭以往“设计更精妙提示词”的旧路,而是构建了一个纯粹在向量层面运算的可微蒸馏体系。
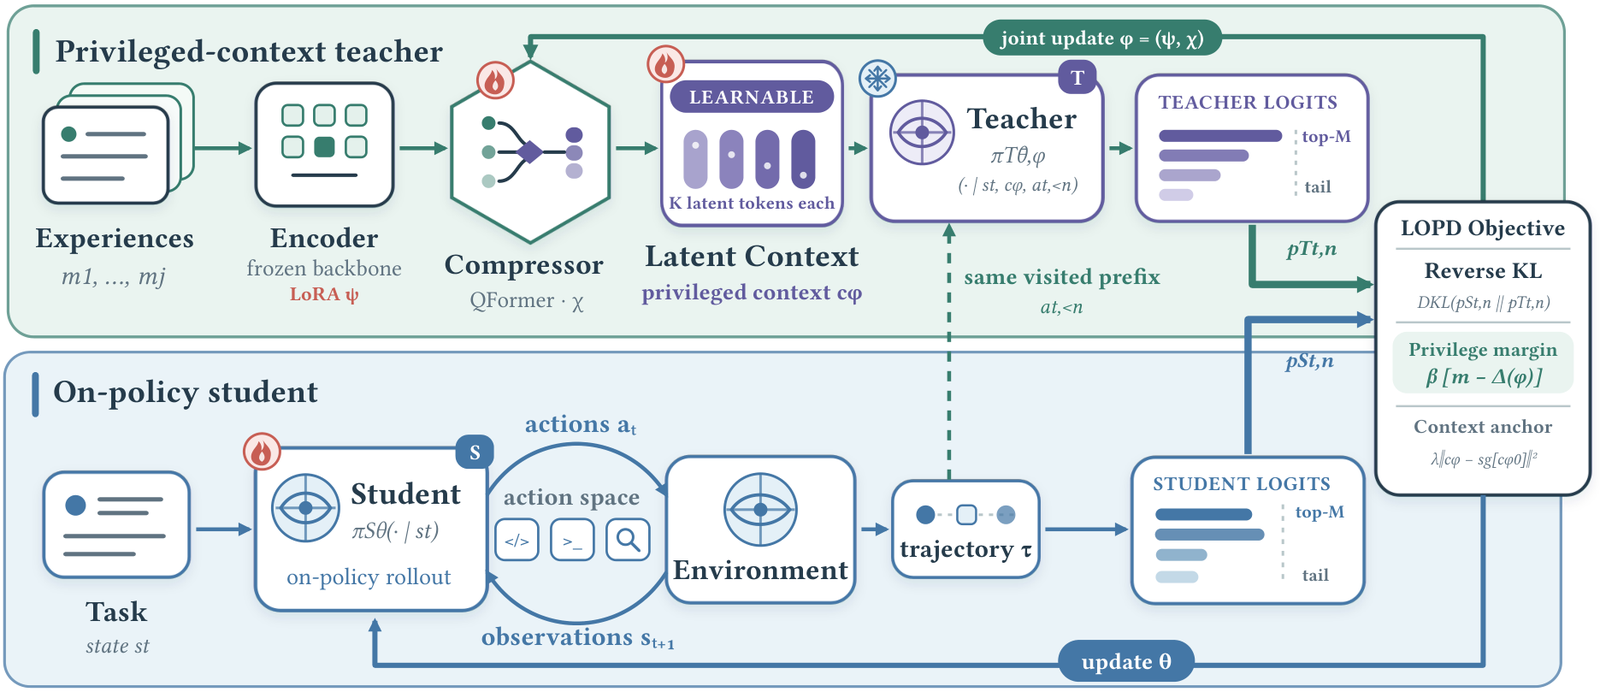
整体流程在宏观上依然维持在线自蒸馏的双角色架构:
-
学生自主探索:学生策略 $\pi_\theta^S$ 仅基于当前任务描述 $x$ 以及自身与环境交互产生的观测和历史动作 $\mathbf{s}t = (x, \mathbf{o}{\le t}, \mathbf{a}_{<t})$ 进行多轮 Rollout,生成完整的动作轨迹 $\mathbf{\tau}$。
-
经验向量合成:对于当前任务 $x$,检索模块从离线积累的成功经验库中召回最相关的 $J$ 条经验。注意,这里存储的仅是任务和紧凑的动作结果链。随后,一个参数为 $\phi$ 的经验合成器(Composer)将这些离散经验编码并重组为一串紧凑的连续隐式 Token:
这些 Token 不对应字典里的任何自然语言字符,而是直接作为软前缀(Soft Prefix)注入到教师模型的上下文窗口中。
-
稠密概率评估:教师模型由基座模型的冻结备份 $\bar{\theta}$ 充当,它接收注入了可学习隐式上下文 $\mathbf{c}\phi$ 的完整输入,对学生刚刚走过的每一个前缀状态重新评估,输出词表上的概率分布 $\mathbf{p}^{T}{t,n}$。
-
反向 KL 蒸馏:学生针对教师计算反向 KL 散度(Reverse-KL),只对实际执行的动作 Token 区域计算损失,迫使自身策略紧紧贴近教师的高置信度区域。
在整个体系中,最精妙的设计在于梯度的双向流动。在蒸馏过程中,教师的 Transformer 主干参数 $\bar{\theta}$ 始终保持冻结,但蒸馏损失反向传播时,梯度不仅直接更新学生参数 $\theta$,还会经由冻结的教师网络层层回传,最终流经连续隐式 Token $\mathbf{c}_\phi$,直达经验合成器 $\phi$。
这意味着,合成器在每一次训练迭代中都会被追问:刚才提供给教师的隐空间经验,是否真正帮到了当前这个状态下的学生?如果某些经验特征让教师给出了不切实际的严厉约束,梯度就会迫使合成器调整经验压缩方式;反之,如果某些表征成功指引了学生跨越难关,该表征模式就会在隐空间内得到强化。离散的经验文本由此蜕变为完全可微的监督载体。
压制平庸:特权裕度约束的数学逻辑
将上下文参数化引入端到端蒸馏,面临一个无法规避的理论隐患:教师的“摆烂塌缩”。
在无约束的目标函数下,模型最容易找到的局部最优解往往不是“教师学会更好地指导学生”,而是“教师主动向学生靠拢”。合成器完全可以学着输出一段毫无意义的隐式向量,使得注入特权上下文后的教师分布 $\mathbf{p}^T$ 与学生原始分布 $\mathbf{p}^S$ 几乎一模一样。此时蒸馏损失 $\mathcal{L}_{\mathrm{distill}}$ 会迅速降为接近于零的完美状态,但这不过是一场自欺欺人的数值游戏,学生模型根本没有吸收到任何实质性的增量知识。
为了粉碎这种平庸解,LOPD 引入了特权裕度约束(Privileged-Margin Constraint)。
首先,算法度量教师相对于学生的逐 Token 特权优势:
\[\delta_{t,n}(\phi) = \log \pi^T_{\bar{\theta},\phi}\left(a_{t,n} \mid \mathbf{s}_t, \mathbf{c}_\phi, a_{t,<n}\right) - \operatorname{sg}\left[\log \pi^S_\theta\left(a_{t,n} \mid \mathbf{s}_t, a_{t,<n}\right)\right]\]其中 $\operatorname{sg}[\cdot]$ 为停止梯度算子。直观来看,$\delta_{t,n}$ 衡量了在看到隐式经验之后,教师在正确动作上相较于学生的信心增量。
但并非学生生成的所有轨迹都值得教师去强行扩大优势。如果一条轨迹最终在环境中惨败,强行让教师维持高概率只会误导策略。因此,LOPD 将这一优势度量与真实环境反馈紧密绑定:引入验证优势系数 $A(\mathbf{\tau}) = 2r(\mathbf{\tau}) - 1$,将二值奖励映射到 ${-1, +1}$。若轨迹成功,$A(\mathbf{\tau})=1$,算法要求特权优势必须大于设定的正边界 $m$;若轨迹失败,$A(\mathbf{\tau})=-1$,则反向压制这种优势。
最终的优化目标构建为一个对偶极小极大问题:
\[\min_{\theta,\phi} \max_{\beta \ge 0} \;\; \mathcal{L}_{\mathrm{distill}}(\theta,\phi) + \beta \left(m - \Delta(\phi)\right) + \lambda \left\|\mathbf{c}_\phi - \operatorname{sg}\left[\mathbf{c}_{\phi_0}\right]\right\|_2^2\]其中 $\Delta(\phi)$ 是整个轨迹上加权平均的特权优势,$\beta$ 是动态调整的拉格朗日乘子,最后一项则是为了防止隐空间表征跑飞而设置的冷启动锚定正则项。
通过这一机制,拉格朗日乘子就像一个动态质检员:一旦合成器试图通过趋近学生来逃避监督职责,特权优势 $\Delta(\phi)$ 就会滑落至阈值 $m$ 以下,乘子 $\beta$ 随即剧烈抬升,给合成器施加极大的惩罚,倒逼其必须在隐空间中榨取出能让教师真正优于学生的关键特征。
全面超越基线:跨任务与跨模型的稳健泛化
评测基于极具说服力的跨领域、跨模型设置展开。实验覆盖了工具调用领域(EnvScaler、BFCL-v3 以及多轮长流程评测 ACEBench)与代码生成领域(LiveCodeBench v5/v6 以及 EvalPlus)。基座模型则跨越了 Qwen3-4B、Qwen3-8B 以及开源权重 Olmo3-7B。
在全部十项“模型基座—基准测试”组合中,LOPD 均斩获了最顶尖的综合胜率,展现出显著超越现有强化学习和离散蒸馏方案的综合素质:
在智能体工具调用场景中,随着基座模型规模从 4B 扩展到 8B,LOPD 的优势被进一步放大。在 Qwen3-8B 上,LOPD 在 EnvScaler 上的成功率达到 $66.4$,BFCL-v3 综合得分达到 $29.88$,ACEBench 得分达到 $62.7$。相比之下,此前最强的基线在这三个基准上的最高分数仅分别为 $60.2$、$29.00$ 和 $58.0$。与传统的离散上下文蒸馏相比,LOPD 在 EnvScaler 上大幅甩开 OPSD 整整 $14.4$ 个百分点,充分证明了隐空间自适应表征在复杂交互场景下的威力。
在代码生成与长程推理测试中,LOPD 同样展示了优异的跨范式泛化能力。在 Qwen3-4B 上,LOPD 将 LiveCodeBench 和 EvalPlus 的综合得分推升至 $48.78$ 和 $81.36$;在架构完全不同的 Olmo3-7B 上,LOPD 同样拿下了 $50.98$ 和 $78.41$ 的最佳成绩,明显领先于其他依赖离散反思或静态示例的基线。
与基线方法“顾此失彼、甚至反噬基座”的脆弱表现不同,LOPD 在所有测试集上均大幅稳超未微调的 Vanilla 基座模型,从未出现性能回退现象。这一稳定表现直接印证了作者的核心论点:限制模型自演化能力的往往不是经验数据本身,而是人工预设的离散中介形式;一旦把表征权还给模型,自蒸馏的泛化鲁棒性便能得到本质修复。
样本效率跃升与消融深度解析
在自演化系统的实际工程落地中,采样预算(Rollout Budget)直接决定了训练的计算成本。在与当前主流强化学习算法 GRPO 以及先进自蒸馏方法 Skill-SD 的正面对比中,LOPD 展现出压倒性的收敛速度。
在 EnvScaler 的训练动态追踪实验中,当基线方法依然在 $0.50$ 上下的平均奖励附近缓慢爬坡时,LOPD 仅消耗了不到总预算 $30\%$ 的采样次数,便迅速拉升至 $0.61$ 以上的高平均奖励水平,最终在有限资源内实现了对全量基线最终指标的彻底超越。这种高样本效率,直接得益于连续隐空间所提供的更加平滑、连续的稠密概率地形,免去了模型在离散文本空间盲目试错带来的巨大方差。
而针对整个框架核心机制的消融实验,更是直接坐实了隐式表征联合优化的必要性:
-
冻结合成器 vs. 端到端联合优化:如果仅使用冷启动初始化好的经验合成器 $\phi_0$ 并将其参数完全冻结,让教师仅充当静态隐式编码器,模型在 EnvScaler 上的最终成功率停留在 $0.573$。这证明,仅仅将经验压缩为向量还不够,必须通过在蒸馏过程中持续更新合成器,使其动态感知学生策略的薄弱点,才能彻底释放自学习的潜力。
-
裕度约束的决定性地位:当彻底移除特权裕度约束(即令 $m=0$)时,模型的性能不仅没有因联合优化而提升,反而戏剧性地崩塌至 $0.551$,甚至远逊于完全冻结的合成器。这一断崖式下跌无可辩驳地证实了理论分析:缺乏裕度保护的合成器迅速走向了“协同退化”与“概率塌缩”的捷径。而当将裕度阈值设定在合理区间(例如 $m=0.05$)时,模型性能跃升至 $0.637$ 的峰值。
在部署落地层面,LOPD 同样具备极高的工程亲和力。尽管训练期引入了检索器、合成器以及双流前向计算,但当蒸馏阶段结束时,所有的外挂脚手架均被彻底剥离。部署在生产环境中的学生策略,完全不需要经验数据库、检索模块或任何隐式 Token,它就是一个干干净净的原生 LLM 检查点。知识在隐空间的熔炉中被提炼提纯后,已经彻底固化进了学生的模型权重深处。
从让模型阅读人工提示词,到让模型在隐空间内自主决定“何为有价值的经验”,LOPD 的探索不仅为在线自蒸馏技术补齐了关键拼图,更向自主进化的终极目标递出了极富启发性的一步:未来的超级智能体,或许本就不该用人类的语言进行内心独白与经验沉淀;在连续表征的流转中,自演化的阶梯正在悄然铺开。