LongRCA Bench:长轨迹Agent故障谁背锅?免训练RCTA定位达24.1%
LongRCA Bench: Diagnosing Responsible Roles and Root Causes in Long-Horizon Agent Failures
在复杂软件工程、深度网页浏览或多智能体协同场景中,大语言模型驱动的 Agent 往往需要自主执行数十甚至数百个步骤。然而,长程执行一旦失败,传统的最终结果评测(Outcome-level Evaluation)便会陷入失灵:测试套件只能告诉你“任务未通过”,却无法说明致命错误究竟在哪一步埋下,更无法指出系统内部究竟是哪一个协同角色该为这次事故承担主要责任。
ArXiv URL:https://arxiv.org/abs/2608.15242v1
由于缺少精细化的过程诊断,开发者往往不得不面对几百条杂乱的工具调用、环境反馈和多角色交互日志,逐行排查“翻车”现场。由阿里巴巴、清华大学、中国科学院等机构联合发布的研究给出了新的解法:研究团队构建了包含 1,140 条真实长程失败轨迹的基准数据集 LongRCA Bench,并提出了名为 RCTA(Root-Cause Trajectory Attribution)的免训练诊断方法。实验揭示了一个极为严峻的事实:在超长上下文与深层逻辑传播面前,即便是当前最强的诊断基线,对最初致命故障步的精准定位率也仅有 13.2%;而免训练的 RCTA 框架通过跨阶段回溯交接指令,将定位准确率提升到了 24.1%,角色归因准确率达到 51.1%。
这项工作最核心的洞见在于:长轨迹 Agent 故障诊断必须将“谁该背锅(Responsible Role)”与“最早在哪一步出错(Root-Cause Step)”拆分为两个解耦的独立任务,因为真正埋下隐患的决策者,与最终在表面暴露报错的执行者,往往隔着数百步的执行鸿沟。
藏在数百步执行背后的“沉默杀手”
为了看清长轨迹故障的本质,可以参考论文中来自真实代码修复基准 SWE-bench Pro 的典型案例。在一个多智能体协作的代码修复系统中,负责全局分析的诊断智能体(DiagnostAgent)在第 37 步给出了一份修复方案,但该方案错误地使用了一个与任务约束冲突的 API;随后的执行智能体(Execution Agent)完全遵照该指令编写补丁、调用测试,甚至在第 163 步自信满满地向用户汇报“修复完成”。然而,外部评测器接入后跑了 47 个单元测试,全部宣告失败。
如果依照传统思路将报错归咎于最后提交代码的执行者,甚至归咎于第 163 步的完成汇报,整个诊断系统就发生了方向性误判。真正致命的“根因”(Root Cause)早在第 37 步就已确定,而后续多达 126 步的执行、验证与日志记录,本质上全是在“错误假设”上的无效空转。这段从真实错误源头到轨迹终点的距离,在论文中被称为根因到终点距离(Root-to-End Distance)。
这正是当前 Agent 落地调试时面临的最大痛点。以往诸如 AgentRx、TRAIL、Who&When 等诊断基准,大多依赖合成数据、人为注入的单一故障,或是轨迹长度仅有十几步的短链路。在那些简短任务中,错误发生后往往几步之内就会导致系统崩溃,回溯难度极低。但在真实复杂的业务场景中,模型具备一定的“错误容忍”或盲目推进能力,即使前期规划全盘皆错,下游智能体依然可以机械执行上百步,直到终局评测介入才暴露出全面溃败。
针对这一诊断真空,LongRCA Bench 汇集了来自 SWE-bench Pro、Terminal Bench 2、TravelPlanner、VitaBench 以及 WebArena Verified 五大真实领域的 1,140 条失败轨迹,总计涵盖 178,137 个执行步骤。所有轨迹均源于真实的交互失败,完全排除了人为注入的合成扰动。统计数据显示,这些轨迹的平均长度达到 156.3 步,中位数 145 步,最长甚至达到 728 步;而根因到终点距离的中位数高达 48 步,在 90 分位数上更拉长到了 183 步,最极端场景下有多达 605 步的后续无效操作。
面对如此漫长的干扰信息,现有的长文本大模型极易迷失在海量调用记录中,要么产生严重的幻觉,要么武断地指责轨迹末尾产生异常输出的下游执行者。
诊断双任务解耦:责任角色与致命根因
为了确立科学严谨的评估规范,LongRCA Bench 严格定义了两个相互独立、独立打分的预测目标,彻底打破了以往将“报错角色”等同于“责任角色”的混淆假设。
第一个任务是致命根因定位(Root-Cause Localization)。该任务要求系统输出一个具体的步骤序号,该序号必须是轨迹中最早引入不可逆致命错误的步骤。如果在轨迹中途某个 Agent 犯了一个错误,但随后通过自我反思或后续校验成功修复并继续推进,这个中间错误绝不能被算作根因。根因必须直接对最终的任务失败负责。
第二个任务是责任角色归因(Responsible-Role Attribution)。该任务要求输出在工作流中真正应当对这次失败承担决策或执行责任的角色名称。这个角色必须在轨迹预设的角色清单中合法存在,甚至可以包括人类协作者,但不需要与根因步骤的消息发送者强行绑定。
将两者拆分有着深刻的系统架构考量。在复杂的复合智能体系统中,一个角色可能发出了不合理的规划意图,但实际将该意图固化为系统状态的动作可能由环境协调器触发;或者执行 Agent 严格执行了规划 Agent 的毒化指令,如果只做步骤层面的字符映射,诊断模型就会把账算在无辜的下游执行者头上。在 LongRCA Bench 的评测协议中,角色归因哪怕完全正确,只要给出的根因步数偏移,根因定位依然记为零分;反之,哪怕准确定位到了错误指令发出的具体步数,如果把责任判定给了下游执行者,角色归因同样不能得分。这种硬核的双重打分标准,直接撕下了依靠概率顺风车“蒙混过关”的遮羞布。
数据集的所有黄金标准均由 22 名计算机专业的硕士和博士研究生完成标注。标注员需要完整审视任务提示词、带有全局唯一步数索引的统一轨迹、以及基准测试给出的失败评判结果,耗费长达 30 至 40 分钟方能完成一条长轨迹的深入溯源与交叉复核,确保了基准数据极高的权威性与置信度。
RCTA:从分段摘要到上游交接追溯
面对数百步的长程记录,如果直接把全量日志一股脑塞给大模型,即便是上下文窗口支持数十万 Token 的旗舰模型,也难以对抗“大海捞针”导致的注意力衰减;而如果采用自底向上的二分搜索或逐步判定,频繁的单步交互不仅推理开销巨大,还容易被局部合规的局部操作彻底带偏。
针对这一工程与算法瓶颈,本文提出了名为 RCTA(Root-Cause Trajectory Attribution)的免训练诊断流水线。RCTA 的设计哲学是:广度粗筛与深度证据追溯分离,先由粗粒度摘要捕获局部异常,再沿着角色协作的交接链路反向锁定根源。
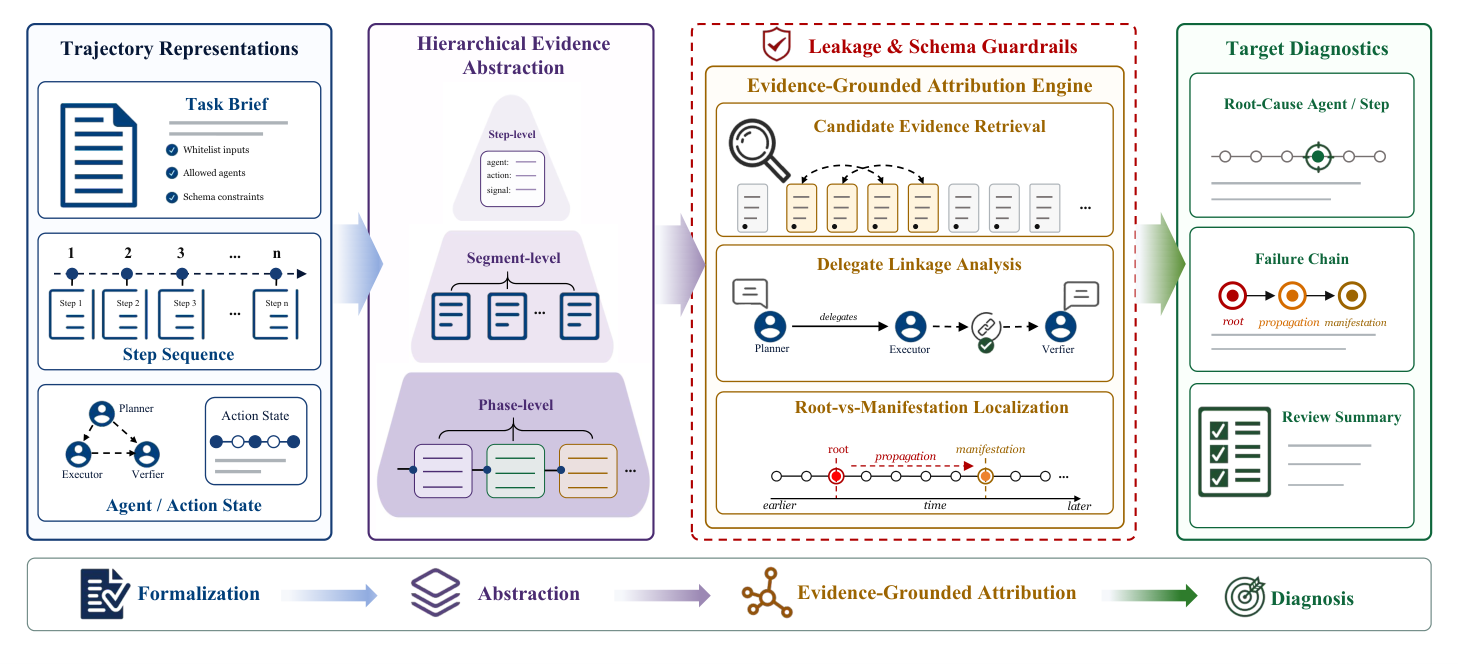
如上图所示,RCTA 的执行过程分为三个高度聚焦且互锁的阶段。
整个长轨迹首先在不调用大模型的前提下,按照固定的规则进行分段切分。切分边界受到字符数和步数硬上限的约束,并且会优先贴合日志中记录的任务完成或智能体角色交接(Handoff)转换点。为了防止跨分段处的语境割裂,每个分段都会向后保留多达 5 步的历史作为重叠上下文。这种纯规则切分既消除了模型切分的幻觉风险,又最大程度保留了协作边界的时序特征。
在完成切分后,系统进入候选错误步召回阶段。第一轮大模型调用并发审视各个独立分段,输出局部总结并提炼出疑似包含决策偏差、工具误用或逻辑断裂的候选错误步骤 ID;紧随其后的第二轮模型调用,则将所有分段摘要汇聚成一份按照子目标(Subgoal)组织的全局轨迹大纲。这一设计极为巧妙:它不再将长轨迹作为杂乱无章的纯文本展开,而是抽象成了带有时序演进感的高层逻辑骨架,使诊断模型能够站在全局视角重新对各个分段提报的候选步骤进行优先级排序与去粗取精。
随后是整个算法最核心的机制——向上游交接指令反向追溯(Tracing Candidates to Handoff Instructions)。针对初筛留存下来的每一个候选步骤,RCTA 并不孤立分析其执行日志。如果该步骤由下游的执行角色或校验角色产生,系统会顺着协作图谱,定向检索距离该步骤最近的、发送给该角色的上游交接指令;如果候选步骤本身就是某种策略输出,则检索更早阶段的顶层规划上下文。
最后,系统发起决定性的最终判定调用:将提纯后的候选步骤原始文本,与检索到的上游交接指令上下文进行对照质证。模型需要回答一个核心问题:当前的执行错误,究竟是执行者自身偏离了正确指令,还是上游交接指令本身就给出了致命的错误引导? 配合严格的格式校验和重试机制,RCTA 最终独立解耦输出责任角色与最早的致命根因序号。
实验评测:基线的普遍溃败与 RCTA 的突破
为了建立公平的对比基准,评测全部在统一的推断底座 DeepSeek-V4-Flash 上展开,覆盖全量 1,140 条测试轨迹,对比了包括全量单次提示(All-at-once)、逐步扫描(Step-by-step)、递归二分查找(Binary Search)、层次化共识投票(ECHO)以及基于依赖图搜索的 FALAT 等主流诊断方法。
评测指标涵盖了四个维度:独立评分的责任角色准确率(Role Acc)、根因步骤精确命中率(Root Exact Acc)、允许 $\pm 5$ 步误差的容忍命中率(Root $\pm 5$ Acc),以及源加权的根因平均绝对步数误差(Root MAE)。
从全局评测结果来看,长程故障定位的难度远超学术界此前的预期。在未引入 RCTA 机制前,表现最好的基线模型 ECHO 依靠分层上下文和集成投票机制,责任角色准确率也仅有 27.5%,精确根因定位率更是低至 13.2%,平均绝对误差高达 50.4 步。而直接把几十万字符输入上下文的 All-at-once 提示法,精确根因定位率更是惨淡的 7.1%。
更值得反思的是依赖图搜索方法 FALAT 的表现,在相同的评测基准下,其根因精确匹配率仅为 2.8%,在 $\pm 5$ 步的窗口内也只有 12.5%,甚至落后于最简单的单次提示法。这一现象表明,在现实复杂的百步长轨迹中,基于工具调用与消息变量构建的显式依赖链极其脆弱和繁杂,一旦某个环境步骤产生了微小的噪声反馈,图搜索就极易在下层复杂的执行分支中“迷路”,彻底失去寻找上游源头的能力。
相比之下,RCTA 展现出了压倒性的优势:
-
责任角色归因准确率达到 51.1%,相较于最强基线 ECHO(27.5%)实现了 23.6 个百分点的显著提升;
-
根因步骤精确命中率提升至 24.1%,几乎将基准最佳表现翻倍(提升 10.9 个百分点);
-
在 $\pm 5$ 步的容忍区间内,准确率攀升至 37.4%,超越最强基线 12.7 个百分点;
-
根因平均绝对步数误差(MAE)降至 38.6 步,比 ECHO 缩短了整整 11.8 步。
这组对比有力地证明了“摘要候选提取 + 上游交接反向追溯”双轨范式的有效性。它既没有陷入盲目深挖全量 Token 的算力黑洞,也没有被复杂的依赖图谱绑架,而是精准模拟了人类工程师排查线上事故时的标准排障路径:先顺着业务日志找异常迹象,再逆向排查最初的接口下发和架构分配。
为什么长程根因定位依然困难?
尽管 RCTA 刷新了当前基准的最佳纪录,但仔细审视数据可以发现:即使是 RCTA,其根因精确命中率也仅为 24.1%,这与高达 51.1% 的角色归因准确率形成了强烈的落差。这种性能割裂恰恰说明,在大模型诊断长程系统故障时,猜对“谁犯了错”容易,而精确咬定“在第几步首次犯错”要艰难得多。
为了探索性能受轨迹时序维度的影响,研究团队针对轨迹长度(Trajectory Length)与根因到终点距离(Root-to-End Distance)进行了分桶切片分析。
在轨迹长度维度上,当轨迹较短($\leq 100$ 步)时,RCTA 的精确定位准确率为 30.3%;而当轨迹拉长到 101–200 步与 201–400 步时,准确率均明显下滑并维持在 20.2%–20.3% 左右。值得注意的是,在大于 400 步的超长轨迹区间中,指标出现了看似反弹的 31.0%,但这主要是由于该区间样本数量极少(仅 42 条)且特定领域任务分布较为集中所致。整体趋势依然揭示出,执行时序一旦突破百步大关,状态空间的爆炸会急剧削弱模型在细粒度原子步骤上的辨析力。
而在根因到终点距离的切片中,数据呈现出更复杂的非单调波动:距离在 10 步以内、11–50 步、51–100 步以及 100 步以上时,RCTA 的定位准确率分别为 21.5%、27.1%、20.9% 和 25.6%。这表明致命隐患埋下的早晚,并不是决定诊断成败的唯一线性变量。有时候,即便错误就发生在终局前夕,但由于多智能体间频繁的冗余验证和无效报错混杂在一起,模型同样容易在多步相似的工具参数中产生细微的判定偏差。
这也解释了为什么将容忍窗口放宽至 $\pm 5$ 步时,RCTA 的准确率会迅速从 24.1% 跃升到 37.4%。在长程协作中,真正的逻辑转折往往不是孤立的一句话,而是一个包含“提出错误逻辑、下发调用指令、工具返回假阳性、再次确认”的小型动作簇。当前的评测模型已经能够极高概率命中这个故障发生的核心“风暴圈”,但在绝对严苛的 0 误差单点步数裁决上,仍然面临着深层语义对齐的微小扰动。
长程 Agent 落地诊断的范式转变
LongRCA Bench 与 RCTA 的提出,实质上宣告了传统依靠“黑盒端到端监控”来调试长程 Agent 时代的终结。以往产业界习惯于用黑盒视角看待智能体——只要最后测试通不过,就简单地把失败用例打包追加为 Few-Shot 样本,或者无差别地微调底层大模型。然而实验数据清晰地表明,如果不深入到执行图谱的内部进行溯源,大量的算法优化很可能是在“为无辜的执行者过度打补丁”,而放过了真正有缺陷的顶层规划逻辑。
不仅如此,这项研究也为未来的多智能体系统日志架构设立了新的设计标准。想要让后续的自动化运维与诊断系统(AIOps for Agents)生效,智能体平台在运行初期就必须严格固化两件事:其一是具备清晰时序语义的原子交接记录(Handoff Logging),其二是明确的角色责任链上下文映射。只有在基础设施层记录下严整的上下文边界,像 RCTA 这类基于证据链逆向回溯的免训练诊断机制才能发挥出最大价值。
当大语言模型从简单的单轮问答、短程对话,真正跨入需要自主决策成百上千步的复杂数字工作流时,构建高效、可信且解耦的故障溯源与责任归因体系,已经不再是一个边缘的评测课题,而是决定自主智能体能否真正迈向工业级严肃生产环境的底座级支柱。