LOFA:兼顾成交与对话纠偏,京东提出电商Agent在线反馈学习框架
Learning from Online User Feedback for Shopping Agents
在大语言模型(LLM)驱动的对话式导购场景中,智能体(Shopping Agent)不仅需要扮演传统推荐系统“根据历史行为召回和排序商品”的角色,更要像一位懂业务、能沟通的金牌导购:它要在多轮动态交流中捕捉用户含糊不清或随时变化的意图,调用搜索引擎检索货品,并以符合人类语言习惯的方式给出个性化推荐与解释。然而,工业级电商平台将这类智能体推向线上后,往往会面临一个核心痛点:现有系统的训练严重依赖静态的离线指令微调、人工标注的偏好数据或传统的交互日志。当智能体与海量真实用户产生高频互动时,日常产生的大量多轮交互日志,却因为噪声大、异构性高、反馈稀疏,始终难以转化为有效的在线自进化闭环。
ArXiv URL:https://arxiv.org/abs/2608.11604v1
针对这一瓶颈,京东(JD.com)联合中国人民大学提出了名为 LOFA(Learning from Online user Feedback for shopping Agents)的自适应学习框架。该研究跳出了过去“仅看用户最终有没有买”的离线行为视角,系统性地挖掘了真实电商交互日志中沉淀的两种互补反馈:一种是最终是否促成交易的“显式行为反馈”,另一种则是用户在对话中即时纠正、表达不满或补充约束的“对话内指令反馈”(In-dialogue directive feedback)。LOFA 将强化学习与具备特权信息的在策略蒸馏(On-Policy Distillation, OPD)结合,无须额外人工标注,就能让智能体不仅学到推荐在终局层面的“成败结果”,更深刻理解交互细节中的“失败原因”。
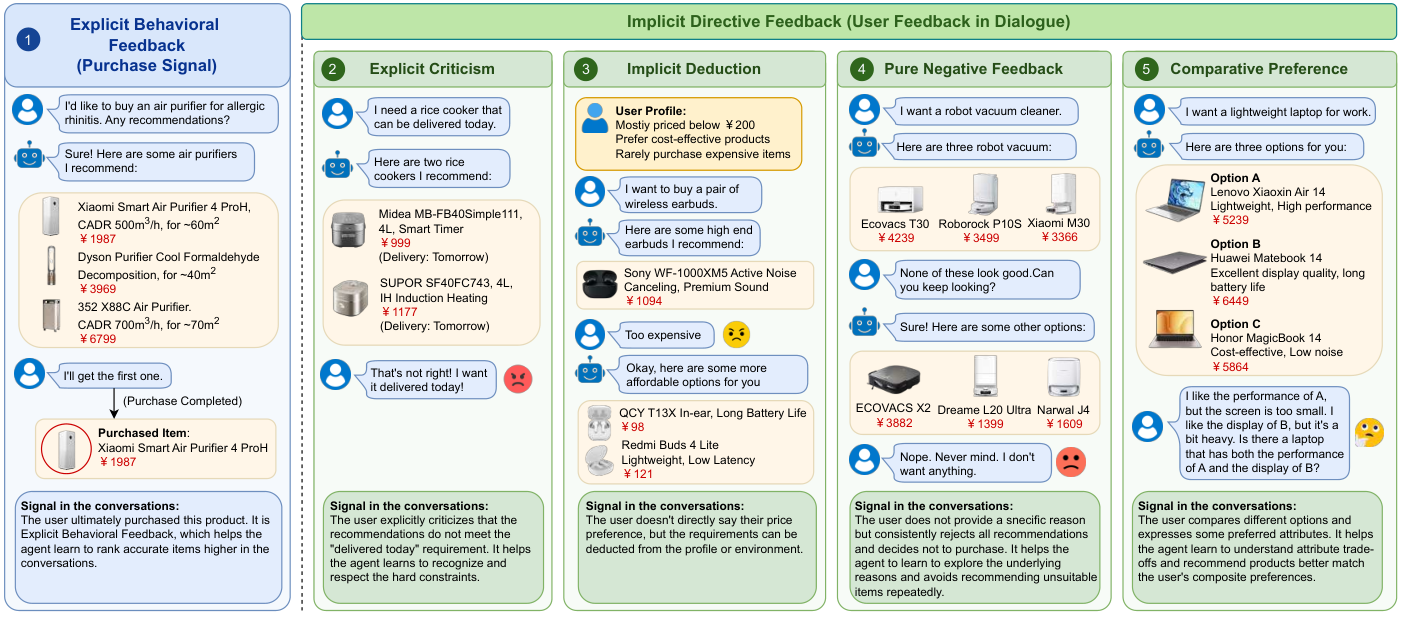
工业级导购日志中的“金矿”与开采难题
在真实电商导购日志中,数据往往呈现高度的复杂性。用户与智能体交互时,留下的信息绝不仅是最终的点击或加购。如图 1 所示,用户的反馈本质上由两个截然不同但高度互补的维度构成:
一方面是显式行为反馈。用户是否最终购买了推荐链路中的某款商品,提供了极为确凿的成败结果判定。但这种成交信号天然是稀疏且延迟的。在多轮对话中,用户可能在聊了四五轮之后才下单,甚至最终购买的决策与前序某次推荐解释的表述方式并不存在直接的强绑定关系。这种延迟性导致信度分配(Credit Assignment)非常困难,模型很难单纯依靠最终成败倒推每一轮决策的好坏。
另一方面是隐藏在自然语言之中的对话内指令反馈。例如,当智能体推荐了一款次日达的护肤品时,用户可能会在下一轮直接回复:“今天就要送达,明天的来不及”,或者“太贵了,有没有平替”。这种反馈并不直接等同于下单,但它蕴含着极具价值的信息增量——它直截了当地解释了上一轮推荐为什么被拒绝,清晰指明了未被满足的约束条件或偏好迁移。然而,此类反馈在自然语言日志中往往是高度异构且极其嘈杂的,用户有时表达得非常委婉,有时只是单纯发泄情绪(例如“算了不买了”),如何从非结构化的对话流中把有价值的监督信号自动开采出来,是长期阻碍模型利用线上日志的核心障碍。
过去的研究要么专注于构建更加庞大的静态偏好对齐数据集,要么把目光局限在模拟环境(Simulator)中的合成数据。LOFA 的出发点正在于破除对离线静态数据的依赖,把线上真实沉淀的“日志废料”变成能够推动智能体连续滚动的“数据飞轮”。
LOFA 框架:双轮驱动的解耦与协同
面对粒度完全不同、数据分布差异极大的两类反馈,直接将它们混合并采用单一目标函数进行端到端优化显然是不适宜的。显式行为反馈作用于整个会话级别的成败,适合宏观的决策与重排优化;而对话内的即时反馈则作用于单轮次(Turn-level)的文本理解与对齐。为此,LOFA 提出了一个如图 2 所示的双阶段解耦学习框架。
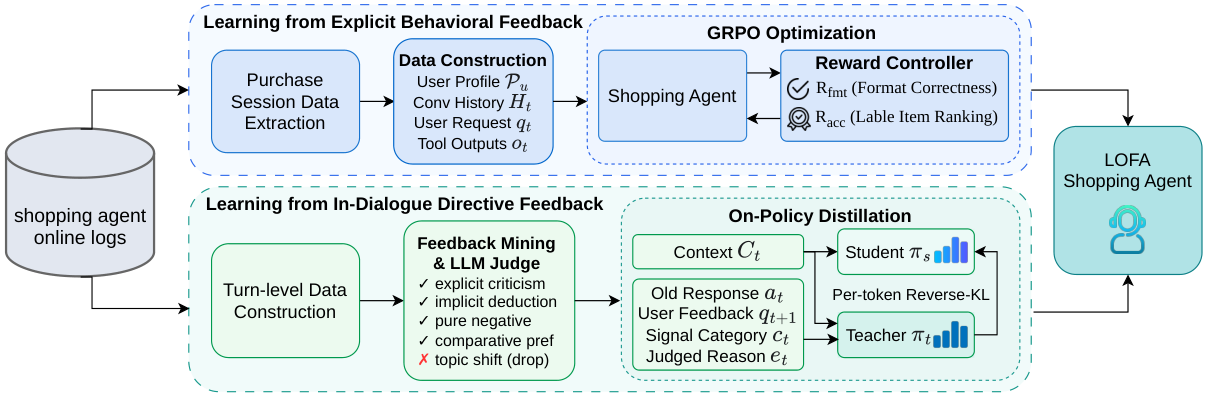
1. 显式行为反馈:基于 GRPO 的可验证强化学习
对于成交这类可直接验证的显式反馈,LOFA 将包含真实购买行为的历史会话抽取出来,构建强化学习训练集。在交互历史 $S={(q_1, o_1, a_1), \ldots, (q_T, o_T, a_T)}$ 的上下文中,智能体根据用户画像、短期偏好以及工具检索到的候选商品集合,生成最终的自然语言回复 $a_t’$ 与商品推荐排序列表 $R_t = {i_1, i_2, \ldots, i_K}$。用户的实际购买商品 $i^*$ 则被作为绝对真实的标签。
为了引导模型在维持格式规范的同时最大化推荐精准度,研究团队采用了组相对策略优化算法(Group Relative Policy Optimization, GRPO),并设计了联合奖励函数。该奖励由两部分构成:一是格式奖励 $R_{\mathrm{fmt}}(\tau)$,如果模型的生成不符合既定的结构化解析格式,将直接遭受惩罚;二是排序质量奖励 $R_{\mathrm{rank}}(\tau)$,采用工业界公认的归一化折损累计增益 $\mathrm{NDCG@10}$ 来度量目标购买商品 $i^*$ 是否被排在推荐列表的前列。
整体奖励设计保证了当模型输出格式崩溃时被严厉阻断,而在格式合规的前提下,纯粹以推荐排序的优劣来指引策略更新。通过这一强化学习阶段,智能体学会了如何从协同过滤和群体共性偏好的角度,做出最有可能促成购买转化的商品推荐决策。
2. 对话内指令反馈:自监督挖掘与特权在策略蒸馏
解决了“知其然”(促成交易)的问题后,更为关键的一步是解决“知其所以然”——让模型理解为什么被用户拒绝,并在接下来的轮次中迅速修复。
首先,LOFA 建立了一套无需人工介入的指令反馈挖掘管道。研究团队利用大模型对线上多轮日志进行细粒度剖析,将用户紧接着给出的自然语言反应划分为具有指导价值的不同类型,主要包括四种可操作信号:明确批评(指出具体推荐错误)、隐式推断(从用户言语中推导出未满足的偏好约束)、纯负向反馈(表达不满但未指明原因)以及对比偏好(提出关于参数、价格或品牌的更细偏好权衡)。对于那些无实质意义的话题转移或弃聊行为,挖掘管道则直接予以剔除。
确定了反馈类型 $c_t$ 并自动生成了反思解释 $e_t$ 之后,最大的工程挑战在于:如何在训练时利用这部分“未来发生的反馈”,却又保证模型在实际推理时依然只需要面对当下的输入?LOFA 巧妙地引入了特权在策略蒸馏(Feedback-Aware On-Policy Distillation)。
在具体实施中,系统并不需要一个参数量远大于基座的外部庞大 Teacher 模型,而是采用同一个模型权重,通过提示词(Prompt)工程构建了一个“具备特权视角的 Teacher”。Teacher 能够同时观察到当前的会话上下文 $X_t^S$ 以及未来发生的纠偏信息 $X_t^T$(即下一轮用户的吐槽、指令类型以及挖掘出的原因解释)。而 Student 模型在接收相同的会话上下文时,需要自主采样生成回复。
在 Student 生成的每个 Token 步长 $j$ 上,系统同时计算 Student 的概率分布 $p_s^{(j)}$ 和特权 Teacher 的概率分布 $p_t^{(j)}$,并通过最小化它们之间的 KL 散度进行在策略蒸馏:
\[\mathcal{L}_{\text{OPD}} = \mathbb{E}_{\hat{a}_t \sim p_s} \left[ \frac{1}{N} \sum_{j=1}^N D_{\mathrm{KL}}\left(p_s^{(j)} \,\|\, p_t^{(j)}\right) \right]\]这种设计将原本极度离散、难以对齐的自然语言反驳,转化为了密集的 Token 级概率分布监督。Student 模型在不依赖未来信息的前提下,被强制拉向“预先知道自己会被反驳并提前避坑”的输出空间,深刻习得了如何在当前轮次就生成符合用户潜在约束的精准回复。
顺序为何重要:训练流水线的架构考量
将 RL 与 OPD 结合时,训练的先后顺序至关重要。LOFA 探索并确立了“先 RL,后 OPD”的顺序训练流水线(Sequential Pipeline)。
这一设计背后的技术取舍非常符合电商业务的内在规律:显式强化学习的目标是建立模型对宏观商品空间、工具检索结果以及成交流程的底层认知,让智能体具备推荐排序的基本准度;若先进行细粒度的会话微调,后续强烈的 RL 奖励梯度很容易破坏模型在语言纠偏细节上的灵活性与对齐表现。实验表明,先通过 GRPO 让模型建立以转换为导向的强骨干能力,再通过在策略蒸馏引入反馈纠偏进行精细化对齐,能够使两种能力实现正向叠加,避免目标冲突带来的性能振荡。
真实电商场景评测:推荐与对话纠偏的双重跃升
评测数据均来源于京东自研智能导购产品“京言”的真实去隐私化日志。实验以 Qwen3-8B 作为主体骨干模型,同时在 Qwen3-4B 上验证通用泛化能力,并以 DeepSeek-V3.2 作为对话纠偏成功的判别评测模型。
在推荐排序评测中,指标主要考察模型在生成列表时将用户实际购买商品置顶的能力(包含 NDCG@K、Recall@K、MAP@K);而在对话指令解决评测中,则考察模型面对先前引发不满的问题时,改写生成新回复的“问题解决成功率”(Success Rate, SR)。
评测数据显示,仅依赖基础模型的导购智能体在复杂约束下表现十分薄弱。引入强化学习(+RL)后,模型在 NDCG、Recall 和 MAP 等推荐排名指标上均取得了极为显著的提升,证实了利用真实成交日志作为强化学习可验证奖励能够直接校准模型的商品排列能力。然而,仅靠 RL 带来的对话纠偏成功率提升相对有限,说明成交结果这种单一结果反馈无法教会模型如何去理解错综复杂的多轮语言博弈。
反观单纯引入在策略蒸馏(+OPD)的变体,对话问题解决成功率出现了跨越式的增长,但商品排序指标的提升幅度较为平缓。只有当二者按照 LOFA 设计的顺序结合(+RL $\rightarrow$ OPD)时,系统才在两个维度上同时斩获最优表现:不仅在 NDCG@10 等关键推荐指标上保持了高位,更在面对用户负向反馈时展现出了极高的问题修复能力。有趣的是,如果将顺序倒置(+OPD $\rightarrow$ RL),由于强化学习过程中的策略偏移,原本通过蒸馏学到的对话对齐能力受到了明显稀释,成功率出现了回落,这进一步验证了先宏观对齐后微观精修的合理性。
在对不同细分指令反馈类型的深入剖析中,LOFA 表现出了优秀的自适应性:
-
显式批评与隐式推断:LOFA 在这两类反馈上获得的相对增益最为显著。因为这类反馈本身包含了较为确切的错误定位或明确的偏好缺失,特权 Teacher 能够提供非常清晰的指导,Student 模型因而能够迅速学会不再重复犯错。
-
纯负向反馈与对比偏好:用户仅仅表达“不满意”或在多种复杂属性间犹疑不决时,缺乏明确的修改线索,属于最具挑战的样本。即便在这一严苛场景下,特权 Teacher 依然依靠对前序失败原因的自动回溯,为模型提供了有统计显著性的改写修正能力,帮助模型避开此前引发反感的表达。
消融分析:每一个组件在为何而战?
为了验证各优化部件的具体贡献,研究人员分别在强化学习阶段与蒸馏阶段进行了消融实验。
在行为反馈学习阶段,当移除推荐准确性奖励 $R_{\mathrm{rank}}$ 时,NDCG 等各项排序指标发生了断崖式下跌。这一结果毫不意外地证明,若没有明确针对购买目标的排序驱动,模型无法自发学会将潜在意向商品前置。而移除格式规范奖励 $R_{\mathrm{fmt}}$ 带来的主要是整体微调的稳定度下降,验证了格式惩罚在约束大模型输出模式、保证推理可解析性方面的基石作用。
在指令反馈学习阶段,消融掉任何一种对话反馈类别都会导致整体解决成功率的下滑。其中,移除“隐式推断”类别导致的性能折损最为严重。这揭示了一个在电商交互中非常关键的底层逻辑:真实用户往往很少像工程师写测试用例那样给出精准的指令,用户最常展现的状态是“欲言又止”或“话里有话”,从委婉语句中推导隐式约束的能力,恰恰是高端对话智能体与传统规则检索器之间最本质的鸿沟。
真实案例折射出的行为变迁
论文中的案例研究非常直观地展现了 LOFA 带来的质变。
在一个关于时效约束的典型负向反馈案例中,用户急需当天送达的商品,而原始系统的初次推荐虽然在标题里写着“今日”,但实际给出的物流选项却是“次日达”,引发了用户的反感与质疑。在基座模型尝试修正时,它机械地更换了一批商品,却索性对时间这一核心冲突闭口不谈,导致问题依旧没有解决。经过 LOFA 优化后的模型则敏锐地捕捉到了用户的不满核心在于“同城配送时效”,于是在修改回复时明确挑选了支持即时或同城当日送达的商品,并主动给出了如何勾选配送选项以避免延误的操作说明,完美化解了用户的顾虑。
在另一个关于“礼物挑选”的导购案例中,用户提出了较为抽象的送礼诉求。基础模型容易陷入刻板印象,将范围无脑收窄到某一类极度同质化的护肤品套装中,最终彻底偏离了用户的真实意图,未能召回目标商品。LOFA 则通过强化学习所习得的商品关联理解,精准将用户最终购买的商品排到了推荐的首位,并在自然语言层面给出了契合送礼场景的得体推荐词。
这两个生动的案例印证了 LOFA 所倡导的理念:显式成交反馈解决的是“推得准不准”的问题,而对话内的即时指令解决的是“聊得懂不懂”的问题。
总结与展望
LOFA 的核心价值不仅在于几项评测指标的突破,更在于它向业界展示了一种无需依赖昂贵人工标注、完全基于生产环境原生日志实现闭环进化的可行范式。随着各类智能体在真实商业场景中接管越来越多的交互窗口,被动接受离线训练数据的传统模式终将遇到天花板。通过巧妙地把用户的自然反应拆解为“宏观结果”与“微观解释”,并分别采用契合其数据特性的强化学习与特权蒸馏加以吸收,LOFA 为构建能够自我造血、自我迭代的工业级智能体数据飞轮提供了极具启发性的实践参考。