锁定70年未解常数十分位:普林斯顿等揭秘长程AI数学研究新范式
Long-Horizon AI Research for Grothendieck Constant: A Case Study in Human-AI Mathematical Collaboration
数学界历来将前沿研究视为人类高级心智的专属领地。在以往的认知中,大语言模型或许可以在国际数学奥林匹克竞赛(IMO)级别的问题中大显身手,或者在自动化评分工具的辅助下刷榜,但一旦进入需要数周甚至数月持续推进、目标随中间结果动态调整的真实科研长程(Long-Horizon)场景,现存的智能体系统往往会因为上下文失忆、目标漂移和缺乏高层审美而陷入瘫痪。
ArXiv URL:https://arxiv.org/abs/2608.11195v2
由普林斯顿大学、加州大学洛杉矶分校(UCLA)与德克萨斯大学奥斯汀分校(UT Austin)组成的研究团队,打破了这一固有印象。他们构建了一个异步人机协作的 AI 科研系统,针对自 1953 年由现代代数几何奠基人亚历山大·格罗滕迪克(Alexander Grothendieck)提出以来悬置了 70 余年的经典问题——格罗滕迪克常数(Grothendieck constant $K_G$),展开了长达一个多月的高强度人机协同攻关。
研究最终将格罗滕迪克常数的理论上下界收窄至:
\[\frac{6\pi}{11} \le K_G \le \frac{\pi}{2\log(1+\sqrt{2})} - 3.47 \times 10^{-4}\]数值范围被精确锁定在 $1.7135\ldots \le K_G \le 1.7818\ldots$ 之间。这一突破不仅创造了数十年来关于该常数最大幅度的实质性改进,更是人类历史上首次将 $K_G$ 的“十分位”精确锁定为 7。更为关键的是,研究中关于下界的突破性证明,彻底颠覆了半个世纪以来依赖人工构造特殊“坏矩阵”的传统范式,而这套全新的数学论证核心正是由 AI 系统在经历上界搜索失败后自主转化探索路径推导出来的。
这项工作不仅是一篇数学成果报告,更是一份关于“长程 AI 科学探索”的系统性解剖案例。整个过程跨越 40 天、240 个研究 Session、耗用 2091 次前沿推理模型调用和 1.52 亿 Token,总 API 账单仅约 5400 美元。它清晰地刻画出当下顶尖模型在真实科研工作中的核心能力边界:极其擅长局部技术执行,但在长程研究判断与研究状态维护上存在显著的系统性缺陷。
悬置七十年的常数与舍入几何
要理解这项突破的技术含金量,必须先回归格罗滕迪克常数本身的数学内涵。在理论计算机科学与泛函分析的交汇处,该常数刻画了一类离散组合极值与连续优化松弛之间的最大内在张力。
考虑一个由实数矩阵 $A = (a_{ij}) \in \mathbb{R}^{m \times n}$ 定义的双线性离散优化问题:
\[\operatorname{OPT}(A) := \max_{x \in \{\pm 1\}^m, y \in \{\pm 1\}^n} \sum_{i,j} a_{ij} x_i y_j\]这是一个典型的 NP-hard 问题。在算法理论中,解决此类难题的标准手段是将其松弛为可以在多项式时间内精确求解的半正定规划(SDP),即将离散的标量符号 $x_i, y_j \in {\pm 1}$ 提升为单位球面 $S^{d-1}$ 上的连续向量 $u_i, v_j$:
\[\operatorname{SDP}(A) := \max_{u_i, v_j \in S^{d-1}} \sum_{i,j} a_{ij} \langle u_i, v_j \rangle\]格罗滕迪克不等式断言,存在一个与矩阵维度 $m, n$ 无关的通用常数 $K$,使得连续松弛的目标函数值至多为离散最优值的 $K$ 倍:
\[\operatorname{OPT}(A) \le \operatorname{SDP}(A) \le K \cdot \operatorname{OPT}(A)\]满足这一不等式的最小常数就是格罗滕迪克常数 $K_G$。它不仅是度量 SDP 松弛算法最坏情况近似比的核心常数,还深刻影响着巴拿赫空间几何、量子纠缠中贝尔不等式的最大违反界限(即量子关联相较于经典关联的最大优势)。
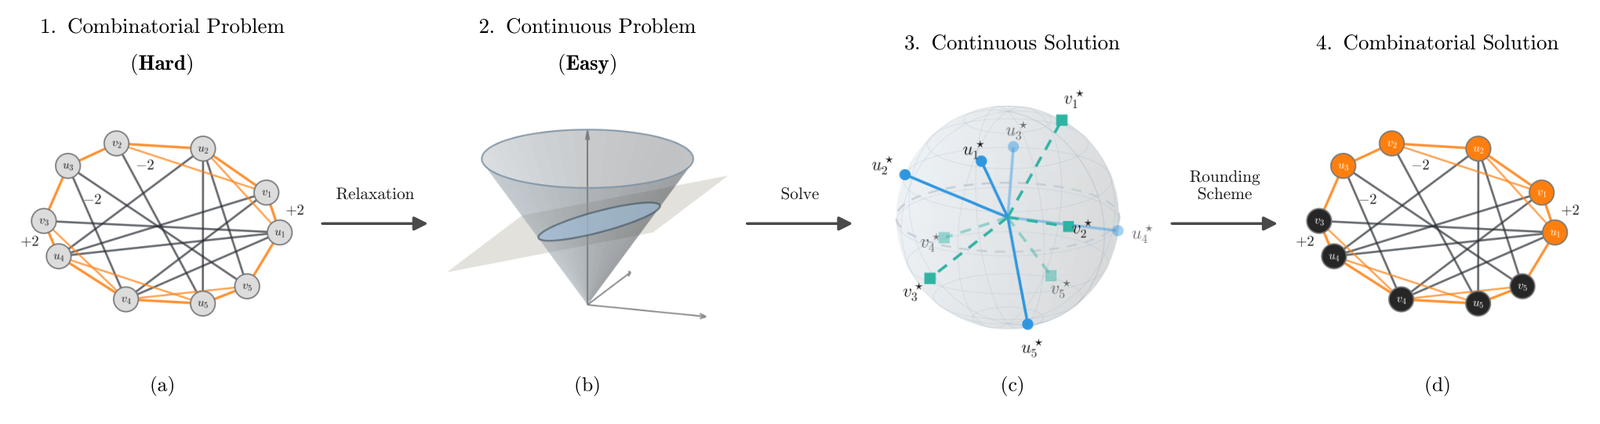
证明 $K_G$ 的上界本质上是在设计算法。研究者需要构造一种通用的“舍入方案”(Rounding Scheme),将 SDP 解出的高维连续向量映射回离散符号 $\pm 1$。经典方法是 Krivine 方案:利用奇符号函数将高维空间划分为正负两个区域,向量投影落入哪个区域就赋予哪个符号。1977 年,Krivine 基于随机半空间划分给出了著名的上界 $\pi / (2\log(1+\sqrt{2})) \approx 1.7822$,并猜想此界已达极限。尽管 2011 年该猜想被否定,但在过去数十年里,后续工作对上界的推进幅度仅仅停留在 $10^{-5}$ 量级。
下界的推进则更为坎坷。过去 70 年中,所有的下界证明全部走“构造主义”路线:数学家必须耗费巨大心力显式构造出特定的矩阵 $A$,通过直接证明该实例上 $\operatorname{SDP}(A) / \operatorname{OPT}(A)$ 的比值很大来顶起下界。自 Davie 与 Reeds 在 1970 年代给出 $1.6769\ldots$ 以来,后人经过数十年的精细构造,也仅将该界限推进了 $10^{-12}$ 到 $10^{-26}$ 的微小缝隙,导致科学界连 $K_G$ 小数点后第一位究竟是 6 还是 7 都无法断定。
极限划分与逆向突围:两大数学成果的诞生
本次人机协作彻底改写了上下界两端的研究局面,分别形成了两个核心数学理论。
在上界方面,研究团队引入了所谓“极限 Krivine 方案”(Limiting Krivine schemes)。过去的所有显式舍入构造都是在固定的低维空间(如一维超平面或二维混合)中寻找划分,而新理论通过构造一类在无穷维极限下收敛的“三次-五次曲面划分”(Cubic-quintic scheme),打破了低维曲面的表达局限。这种方案赋予了舍入算法更加平滑的非线性边界响应,使得归一化相关函数的最坏情况表现得到提升。最终将保持了十余年的最好上界压低了 $3.47 \times 10^{-4}$,这是理论计算机界首次确证“提升舍入维度能带来实质性渐进提升”。
在下界方面,系统完成了一次极具颠覆性的“范式跃迁”。长久以来,所有研究者都在试图寻找更极端的特定矩阵,而这次得到的下界定理却不依赖任何具体矩阵构造。AI 系统从对舍入函数归一化相关函数 $H(t) = b_1 t + b_3 t^3 + \dots$ 的泰勒展开分析中,发现所有合法的 Krivine 划分方案在几何上都必须服从一个此前未被察觉的内在结构约束:
\[b_3 \ge 2b_1 - \frac{11}{6}\]这个代数不等式揭示了一堵全局性的“几何之墙”:没有任何 Krivine 舍入方案能够同时压低一阶与三阶展开项。系统将这种针对所有算法方案的“普遍性障碍”,直接反向转化为关于常数本身的理论下界,一举证明了:
\[K_G \ge \frac{6\pi}{11} \approx 1.7135\ldots\]这不仅是半个世纪以来对 $K_G$ 下界最大幅度的单次推进,更是该领域首个“非构造性下界”。它以极为漂亮的代数形式,一举将 $K_G$ 的十分位死死钉在了 7 上。
双模型协作系统的工程闭环
为了支撑长达数周的高难度数学探索,研究团队设计了一套名为科研套件(Research Harness)的系统架构。面对长程探索,最致命的问题是长上下文的注意力退化以及浮点计算误差引起的虚假繁荣。为此,该系统搭建了三个严密的技术咬合点。
整个架构在算力层实行明确的分工。底层主力使用了两个前沿大模型:负责高阶数学命题拆解、策略规划和证明推导的推理模型(前期为 OpenAI GPT-5.5-Pro,调至最高推理算力预算,中后期切换为 GPT-5.6-Sol);负责落地实现、脚本调度和环境联调的代码智能体(Anthropic Claude Code,驱动 Claude Opus 与 Claude Fable 5)。浮点数值探索部署在单台 4 卡 GPU 节点上,而所有用于验证数学猜想、提供严格证书(Certificates)的计算,必须全部经由高精度区间算术软件库 Arb 进行 CPU 级严格区间验证,杜绝一切由于浮点舍入误差导致的“伪定理”。
系统的组织核心是基于文件的结构化长期记忆(Session Reports)。如果将所有推导历史塞进模型的即时上下文窗口,模型的推理效率会在剧烈的注意力稀释下迅速崩溃。系统将研究切分为 240 轮独立的 Session,每个 Session 结束时,必须向代码仓库提交一份提炼后的阶段报告,包含当轮沉淀的核心引理、可执行代码、形式化推导以及被证伪的方向。后续 Session 启动时,仅读取经过精简的高层状态摘要,从而在不撑爆上下文的前提下,维持跨越数周的研究连贯性。
人类专家在此系统中的生态位并非一线推导者,而是定期的“异步领航员”。人类操作员不参与繁重的代数推导或代码调试,而是以每天审阅 Session 报告的频率,在关键分支节点注入高层学术品味,累计发出了约 40 次战略指令。
从失败上界到下界发现:一次意外的认知转向
下界定理 $K_G \ge 6\pi/11$ 的诞生历程,展现了复杂科研探索中极富戏剧性的一幕。这个里程碑式的结论并非预设蓝图的产物,而是一次典型的“从失败中汲取洞见”的路径突围。
在最初的数十个 Session 中,系统的核心任务全部集中在上界搜索上:让人工智能不断优化三次划分曲面的系数,试图通过数值逼近寻找更好的上界常数。然而,连续数十轮优化陷入了停滞,系统的目标函数在某个阈值前反复振荡,多组参数拟合均告失败。
此时,人类专家介入,通过一条异步指令调整了系统的优化元目标:“停止盲目的数值微调,去分析究竟是什么全局几何属性在阻止上界数值的继续减小”。
接管该指令后,推理模型展现出了惊人的概念抽象能力。它放弃了单纯的梯度搜索,转而提取了多组失败方案的泰勒展开系数,开始在代数层面推导相关函数必须满足的变分极值条件。系统发现,此前所有试图优化高阶项的尝试,都会不可避免地导致一阶系数发生反向劣化。推理模型敏锐地抓住了这个不变的代数对抗现象,通过多次局部引理的证明与合并,最终在符号层面上形式化证明了 $b_3 \ge 2b_1 - 11/6$ 的全局刚性约束。
随后,系统调用 Arb 工具链对该约束进行了基于区间算术的严密边界覆盖测试,确认该不等式在整个紧致参数域上无任何死角。原本用于寻找最优上界算法的“阻碍条件”,在重新构架后摇身一变,成为了束缚所有算法性能的普遍法则,直接转化为了关于常数 $K_G$ 的坚实下界。
局部巨人与全局侏儒:当前 AI 的科研能力真相
通过对整个长程运行记录的全景复盘,研究者提炼出一个深刻的结构性规律:目前的 AI 智能体在不同维度的科研功能上,表现出极端的不对称性。
研究团队将长程数学研究解构为三个层级的核心机能:
-
技术执行(Technical Execution):在既定明确的高层目标下,完成局部的引理推导、构造测试用例、编写验证代码和进行代数运算;
-
研究判断(Research Judgement):在面对庞杂的分支时,评估哪个方向具备理论价值、何时应当果断止损、如何从一堆琐碎的数据中抽象出有品位的数学猜想;
-
研究状态表征(Research-state Representation):在长达数周的时空跨度中,精准维护动态演进的知识库,决定哪些中间结论必须保留,哪些未经验证的预设必须打上警告标记。
记录显示,AI 在“技术执行”层面的表现堪称顶级专家。面对复杂的分析不等式推演和工程量巨大的区间验证脚本编写,模型极少犯下低级逻辑错误,能够以惊人的速度突破具体的数学技术关卡。
然而,在“研究判断”和“研究状态表征”这两个全局功能上,AI 暴露出了惊人的脆弱性。最具代表性的事故发生在第 44 号 Session。在第 4 号 Session 中,系统曾编写了一个快速的浮点数评估脚本,并在当时的文件中明确打上了警告标签:“该评分器仅供粗筛探索,不能作为数学证明的依据”。但在后续经历了数十次由模型主导的“阶段状态总结与压缩重写”后,这个至关重要的限制条件(Caveat)在一次次的摘要精简中被系统当作“无关枝节”给丢弃了。
到了第 44 个 Session,模型重新读取了已经被压缩数次的陈旧状态,赫然将这个未经验证的粗糙评分当作正式记录,大张旗鼓地宣称发现了一个革命性的上界。该错误直到人类专家人工核查底层凭据时才被紧急叫停。同样,早在第 8 轮就已经证明的一个关键可行性准则,在后续的状态交接中由于缺乏人类那种“预见未来哪条性质有用”的前瞻直觉,被判定为低优信息而遗忘,导致系统在 25 天后又被迫从零重新推导了一遍。
研究团队指出,这种缺陷深植于当前大语言模型的预训练分布之中。人类存量的数学文献、教科书与论文,几乎全部属于“面向最终结果的产物叙事”。公开发表的论文只会呈现整洁优美的最终定理,隐去了推导过程中长达数月的盲目尝试、致命死胡同、直觉权衡以及对潜在漏洞的漫长怀疑。因此,当模型反复被要求“总结当前进展”时,其底层概率分布会本能地向“终稿论文”这一体裁发生强烈的均值回归——夸大漂亮的数据结果,过早丢弃充满不确定性的限定范围和怀疑前提。
人机协同的新范式
格罗滕迪克常数的这一战役,为未来人机协同探索严肃科学前沿提供了一幅清晰的行动拓扑图。
它否定了两种极端的想象:一种是认为当前的 AI 只能当个高级符号计算器,完全无法提供原创学术洞见;另一种则是盲目乐观地认为,只要给智能体配上工具链,扔进一个开放课题,它就能完全自主产出大一统的科学理论。
在这场耗时一个多月的远征中,人类与 AI 找到了高度互补的平衡点。人类学者从繁复易错的公式推导、高维边界积分以及验证脚本的编写中彻底解脱出来,转而退守到科研决策的核心高地:定义初始问题的边界、提供具备学术审美的启发式直觉、在关键的探索停滞期重塑抽象元目标,以及最为关键的——定期审视系统的动态记忆档案,强制纠正其因文本重写而发生的状态漂移。
当 AI 拥有了这种由人类高级经验守护的全局航标,其无与伦比的技术推演算力才得以摆脱局部震荡的泥潭,在跨越 240 轮的深邃推导网络中稳步前行。格罗滕迪克常数十分位的攻破证明,即使面对沉睡七十年的纯数学顽疾,人机紧密协同的长程科研范式,也已经具备了从深水区撕开一道裂口、建立全新定理的力量。