Rollplex:重叠视频前缀与推理,打破多模态RL串行墙提速1.3倍
Rollplex: Cross-Phase GPU Spatial Sharing for Vision Language Model Post-Training
在具身智能与大模型强化学习(RL)的研究重心逐渐向多模态转移的今天,视觉语言模型(VLM)在视频理解与物理环境交互中的后训练(Post-Training)成本正以惊人的速度膨胀。无论是让机器人学会根据连续视觉画面做出操作决策,还是在复杂长视频中完成长链条因果推理,采用可验证奖励的强化学习(RLVR,如 GRPO 等算法)都成了提升模型推理能力的标配方案。然而,当工程师们直接把为纯文本 LLM 设计的强化学习运行时架构(如 OpenRLHF、verl、ROLL 等)套用在 VLM 上时,会立刻撞上一堵无形的系统性能墙。
ArXiv URL:https://arxiv.org/abs/2608.14498v1
来自阿里巴巴与香港科技大学(HKUST)的研究团队在最新论文中揭示了一个关键症结:在传统纯文本强化学习中被视作理所当然的“串行分阶段执行”范式,在处理密集视频输入的 VLM 训练中造成了巨大的 GPU 硬件算力浪费。 为此,他们推出了名为 Rollplex 的全新强化学习运行时。该系统通过解构传统 RL 的执行边界,把原本被推迟到后续阶段的密集前缀计算,空间复用到当前响应生成的解码窗口中,并在严格维持同步 On-Policy 学习语义的前提下,实现了最高 $1.30\times$ 的端到端训练提速。
痛点根源:从“输出主导”倒退回“输入过重”的计算范式
要理解 Rollplex 的突破,首先需要审视当前主流 On-Policy 强化学习系统在执行层面是如何运转的。在单次迭代中,系统通常严格遵循四个按时间切分的原子阶段:
-
Rollout 采样阶段:使用当前策略权重快照 $\theta_k$ 处理 Prompt 输入并自回归生成多个动作或文本响应;
-
Reference 打分阶段:冻结的参考模型对完整序列打分,提供 KL 散度正则化约束;
-
Actor 训练阶段:策略模型执行前向与反向传播,根据优势函数计算梯度;
-
优化器更新阶段:更新策略参数并发布新权重 $\theta_{k+1}$。
在以往以 GSM8K、MATH 等纯文本推理为主的任务中,这种串行设计非常自然且高效。因为纯文本任务的 Prompt 极短,中位数通常只有几十个 Token,而生成的思维链(CoT)响应却长达数千 Token。由于自回归生成阶段(Rollout Decode)在总时间中占据了压倒性的统治地位,前置 Prefill 开销几乎可以忽略不计。
然而,当进入多模态与视频 VLM 领域后,数据特征发生了颠覆性的反转。以视频推理基准(如 Video-R1)为例,模型必须首先利用视觉编码器(ViT)将海量视频帧转化为高维视觉 Token,再连同文本指令一同送入语言模型主干。根据研究团队的统计,在四类典型视频任务中,Prompt Token(含视觉 Token)占整个序列总长度的中位数高达 $79\%$ 至 $98\%$,中位数输入长度普遍在 $470$ 到 $5900$ 个 Token 之间。
这就带来了一个系统级难题:输入侧的前缀(Prefix)计算开销,已经完全足以与自回归解码(Decode)分庭抗礼。 在传统的串行调度下,Rollout 需要走一遍密集的输入 Prefill,后续的 Reference 模型又要把同样的超长输入算一遍,紧接着 Actor 训练的前向和反向传播还要把长视频输入处理一遍。这三份极其耗时的大算力前缀计算,不仅本身就占据了整个迭代耗时的半壁江山,更要命的是,系统居然把 Reference 和 Actor 训练的前缀运算,硬生生压制在漫长的 Rollout 解码彻底结束之后才启动。
核心观察:剥离依赖,把前缀计算塞进解码间隙
为什么大家之前都选择干等?因为在串行管线的设计直觉里,只有拿到了 Rollout 生成的最终 Response,才能去打分和算 Loss。
但 Rollplex 团队精准地指出了这种直觉的盲区:无论是 Reference 模型的评估,还是 Actor 的前向反向,它们吃进的模型输入都可以被精准拆分为两半——独立于响应的前缀(Prefix),以及依赖于响应的后缀(Suffix)。
-
Prefix 仅由数据集提供的视频输入、指令 Prompt 以及当前迭代的参数快照 $\theta_k$ 决定。在 Rollout 生成第一个输出 Token 时,这些要素就已经全部确定且就绪。
-
Suffix 才是真正需要等待 Rollout 生成结果填入的部分。
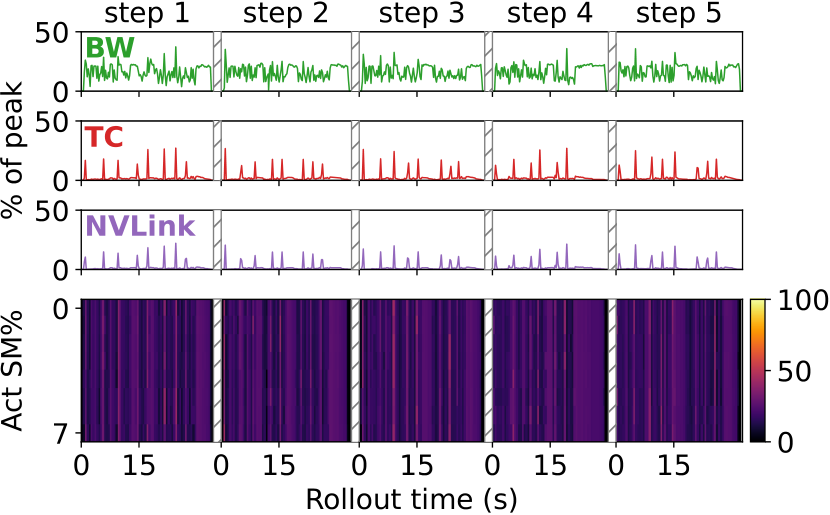
这意味着,Reference 模型的前缀打分、训练 Actor 的前缀 Prefill 和前向特征提取,完全没有必要等待 Rollout 解码完成。它们完全是“响应无关”的!更重要的是,在 Rollout 进行自回归解码时,GPU 的张量核心计算利用率其实非常低,显存带宽往往处于未饱和的受限状态(如上图所示)。如果能够把 Reference 和 Actor 的前缀计算直接搬到 Rollout 的解码窗口内并发执行,不仅不会破坏任何数学逻辑,还能将原本串行暴露在关键路径上的前缀耗时彻底“藏”在解码时间之中。
关键在于,这种重叠并不像异步 RL 那样依赖陈旧权重(Stale Policy),也不需要做投机采样。它使用的依然是当前迭代的严格参数 $\theta_k$,前缀状态(KV 缓存及边界激活)被完好保留,等待后续 Suffix 采样完成后无缝拼接。数学上,端到端关键路径缩减量直接取决于 $\min(T_{\mathrm{prefix}} - \Delta_D, T_{\mathrm{decode}})$,其中 $\Delta_D$ 代表并发带来的少量核函数争抢损耗。只要解码时间足够覆盖前缀,串行关键路径就能被直接削掉一大截。
工程拦路虎:165 GiB 显存压迫与 TP 并行度冲突
既然逻辑上完全可行,为什么现有的系统(包括 DeepSpeed-Chat、Megatron、vLLM、ROLL 等)都没有做这种跨阶段的空间并发?因为一旦真正落到工程实现上,两座巨大的物理大山会瞬间将系统压垮。
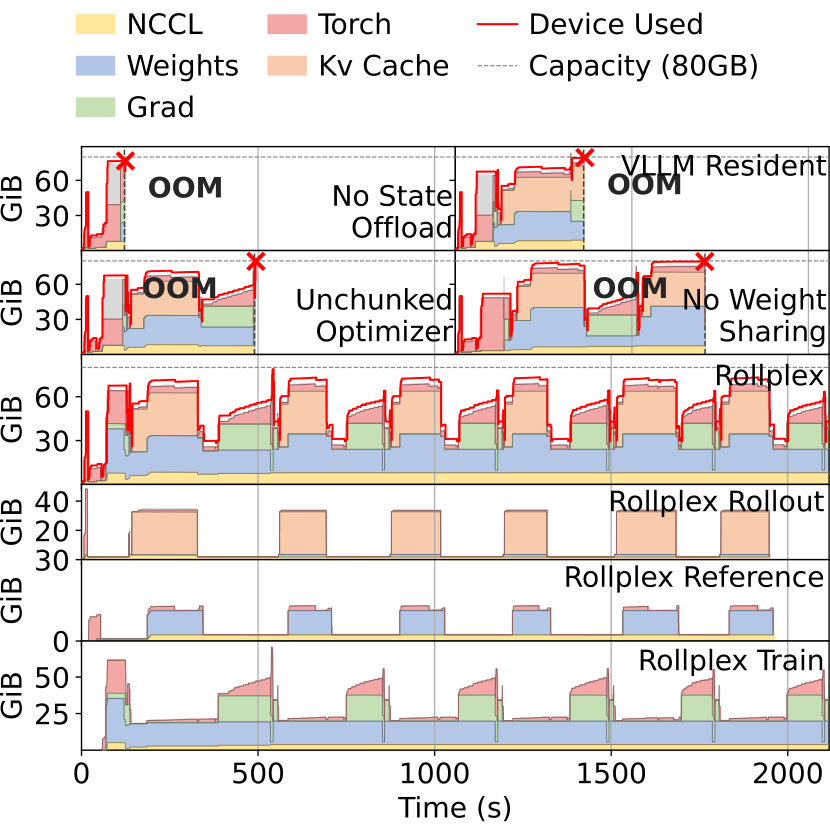
首先是跨阶段显存爆炸问题。在单张显卡串行跑任务时,阶段之间可以通过彻底释放内存空间来实现显存复用。但一旦要求 Rollout 解码与后续阶段的前缀重叠,系统就必须同时驻留:Rollout 自身的 KV 缓存与推理中间状态、Reference 产生的前缀 KV 缓存、训练 Actor 的前缀 KV 缓存、自动微分所需的庞大激活值(Activation Checkpointing)、模型权重、梯度,以及以 FP32 精度存储的优化器状态(如 Adam 的一阶与二阶动量)。根据论文实测,在 Qwen2.5-VL-32B 模型下,这种天真的空间共存会导致单张 GPU 的瞬时显存需求飙升至约 165 GiB!面对当前主流旗舰加速卡如 H800(80 GB 显存),系统在启动并发的瞬间就会触发 OOM(内存溢出)崩溃。
其次是张量并行(Tensor Parallelism, TP)维度的天然冲突。在工业级大模型训练与推理中,训练引擎和推理引擎对并行度的偏好是截然相反的:
-
训练引擎(如 Megatron-Core)偏好更宽的 TP(例如 TP=8):因为需要将巨大的权重、优化器状态和庞大的前反向激活值尽可能打散到更多显卡上,否则单卡塞不下;
-
推理引擎(如 vLLM)偏好更窄的 TP(例如 TP=4):在解码阶段,模型每生成一个 Token 都要走一次 Transformer 块内的全局通信(All-Reduce),TP 越宽,通信延迟占比越高。论文测试表明,强行将 Rollout 的 TP 从 4 提升到 8,会导致解码速度大幅放缓多达 $1.31\times$。
如果强行让训练和推理统一 TP,要么训练显存溢出,要么推理速度剧降;如果让两个引擎各起各的进程、各持一份模型参数,单卡上仅重复的参数权重就会额外吞噬 15 GiB 显存,且每次参数更新后跨引擎做权重重排同步又会带来高昂的延迟。
破局之道:Rollplex 的精巧双机制设计
为了在 80 GB 的物理边界内化解上述冲突,Rollplex 在开源强化学习框架 ROLL 的基础上,基于 Megatron-Core 与 vLLM 深度定制了两个核心系统子系统。
1. 生命周期感知的显存精细编排(Phase-Aware Memory Management)
Rollplex 没有采取粗暴的全量驻留或无脑释放,而是建立了一套严格的物理对象生命周期法则:任何张量对象,仅在其首个低延迟使用点与最后使用点之间的区间内占用 HBM。 系统将整个流程涉及的巨量状态划分为四种截然不同的资产:
-
边界状态(Boundary State):主要是 Reference 和 Actor 的前缀 KV 缓存。这部分数据是重叠并发的核心价值所在,为了保证后续 Suffix 能够零延迟直接衔接,它们必须在显存中锁定驻留;
-
永久状态(Permanent State):包括 FP32 主权重和 Adam 动量。Rollplex 采用了流式更新机制,将原本在训练结束时瞬间全量载入的庞大优化器状态,拆分为更细颗粒度的 Chunk 流式换入与更新,避免单点峰值撑破显存;
-
可重构快照(Regenerable Snapshots):如 BF16 格式的模型权重,在消费完成后即可被快速刷新或覆盖;
-
阶段局部状态(Phase-Local State):如 Rollout 自身的局部推理缓存、评分临时量以及训练反向传播中非关键的激活值,用完即弃或按需重算。
这一调度最精妙的地方在于对反向传播计算图的保真。将 Actor 前缀计算前移时,并没有切断 PyTorch 的自动微分跟踪链。Actor 前缀生成的边界 KV 依然携带着完整的计算图,当 Suffix 的 Loss 算出来后,梯度能顺畅地穿过边界,精准反向传播回 LLM 前缀、跨模态投影层(Projector)乃至视觉编码器(ViT)。借助底层的 CUDA 虚拟内存管理(CUDA VMM),Rollplex 实现了虚拟地址不变而底层物理页自由流转的高效状态流转,避免了重构 Python 张量对象带来的沉重开销。
2. 并行度感知的零冗余权重共享(Parallelism-Aware Weight Sharing)
针对 TP 维度的冲突,Rollplex 打破了“不同 TP 切分必须保存独立物理副本”的死结,实现了同一块底层物理显存在不同并行度视图下的共用。
在系统内部,研究人员对 Qwen2.5-VL-32B 的所有层级权重进行了数学几何分析,将其按切分兼容性划分为三类:
-
Case 1(完全对齐分片):参数在两种 TP 划分下逻辑顺序完全一致,仅存在分片范围的倍数关系。占模型参数总量的 $60.0\%$;
-
Case 2(转置兼容分片):可以通过简单的步长(Stride)转置或视图重塑(View Alias)实现映射,占总量的 $32.8\%$;
-
Case 3(布局不兼容分片):无法通过简单重塑映射的边缘参数(如部分复杂投影头),仅占少得可怜的 $7.2\%$。
通过这种细粒度的拓扑分类,全模型高达 $92.8\%$ 的参数直接实现了物理显存级别的完全共享!
在实际运行中,无论是 TP=8 的 Megatron 训练端,还是 TP=4 的 vLLM 推理端,底层指向的都是同一组由 CUDA IPC 共享的显存物理页。只有剩下那 $7.2\%$ 的不兼容张量,Rollplex 会在每次优化器更新后通过一个轻量级的异步流进行快速局部重构。在单卡层面上,这仅仅引入了 1.1 GiB 的微型临时缓冲区,相比于传统方案为推理端硬塞一份 7.6 GiB 的独立权重备份,显存占用暴降了 $85.5\%$。
实验评测:提速 1.3 倍,且不损耗一丁点训练质量
研究团队在配备 32 张 NVIDIA H800 GPU(80 GB 显存)的集群上,针对 32B 参数规模的 Qwen2.5-VL 模型进行了全方位实测,基准覆盖了 CLEVRER、STAR 等主流长视频推理评测集。
对比目前工业界最主流的两类部署模式:
-
经典共存部署(Colocate):单卡轮流执行 Rollout、Scoring 与 Training。Rollplex 在所有视频任务上稳定取得了 $1.23\times$ 至 $1.30\times$ 的整体端到端提速。这部分加速直接来源于隐藏了漫长的前缀计算,使 GPU 在原本松弛的解码阶段保持高饱和运作;
-
解耦独立部署(Disaggregate):即划分独立的 Rollout 节点池与独立的训练节点池。在这种设定下,由于各节点池在异构阶段存在严重的等待互锁(Rollout 池在打分和训练时空转,训练池在 Rollout 时空转),再加上跨机器同步权重的巨大通信开销,其整体耗时甚至明显落后于单池共存模式。在同等 32 卡的硬件预算下,Rollplex 相比解耦架构实现了 $1.57\times$ 到 $2.24\times$ 的巨幅性能优势。
更关键的一点是训练质量。许多针对 RL 的加速系统往往需要牺牲数学严谨性,比如引入单步延迟更新或者近似梯度。但 Rollplex 坚守了严格的同步 On-Policy 原则。评测结果显示,在数千步的 GRPO 训练全过程中,Rollplex 产出的可验证奖励曲线(Reward Curve)与基线串行系统几乎完全重叠,步间绝对误差在 0 附近极微幅震荡,没有任何系统性漂移,完全归因于浮点核函数执行次序的微小随机性。这扎实地证明了:系统抢出的时间,全凭精妙的流水线调度,没有向模型收敛性妥协半分。
针对计算争抢的消融实验同样提供了有趣的工程启示。当利用 NVIDIA MPS(多进程服务)让推理解码与前缀计算同卡混跑时,动态的默认 MPS 策略反而击败了各种生硬切分 SM(流式多处理器)的静态隔离方案(如 GreenCtx)。因为自回归解码的负载随步长动态变化,静态预留 SM 会造成明显的资源闲置;依靠硬件底层的细粒度时间片抢占,系统反而能以最小的核函数干扰开销,将空闲算力吞吐拉满。
总结与展望
在具身智能、空间计算与视频大模型不断推高输入长度的演进趋势下,计算重心的迁移必然要求底层算力调度逻辑的蜕变。Rollplex 的工作清晰地揭示了强化学习从“纯文本时代”向“多模态具身时代”演变时所暴露的系统失配。
它不仅给出了一套兼具高吞吐与严格数学一致性的高效工程解法,更通过生命周期显存管理与多并行度权重物理共享,重新定义了训练与推理共存部署的颗粒度边界。对于正在重金投入长视觉序列大模型 RL 后训练的企业和科研团队而言,这种不改动算法核心、纯靠系统深度编排即可直接白赚近 $30\%$ 吞吐的方案,无疑是加速下一代前沿物理世界基座模型研发极具价值的技术参考。