哈工大提出SEE:构建UI转移图,合成平均14.8步移动Agent长轨迹
SEE: Structure-aware Exploring \& Exploiting for Long-horizon GUI Agent Trajectory Synthesis
在图形用户界面(GUI)自动化领域,让以视觉语言大模型(VLM)为核心的智能体接管手机操作,一直被视为迈向通用数字助手的关键跳板。然而,在受控基准上刷榜的多模态 Agent,一旦被扔进真实的移动操作系统,往往迅速变得步履维艰。真实世界的 App 充满密集的图表、动态弹窗、需要特定前置状态的深层入口以及极其复杂的长程操作流。现有的轨迹数据收集方案陷入了两难境地:昂贵的人工演示无法跟上应用快速迭代的节奏,而单纯依靠模型在线逐步探索(On-policy rollout)又极易陷入高频“快乐路径”(Happy path)的无限死循环,错过稀有的深层功能跳转。
ArXiv URL:https://arxiv.org/abs/2607.18046v1
针对真实复杂界面与超长交互轨迹的数据匮乏困境,哈工大(Harbin Institute of Technology)的研究团队提出了名为 SEE(Structure-aware Exploring & Exploiting)的双阶段数据合成框架。该方法的核心转变在于:不再让大模型对着截图一步一算、盲目试错,而是将数据生成显式解耦为“探索建图”与“图上规划利用”两个阶段。通过感知驱动的探索构建出反映 App 屏幕与可交互元素的转移拓扑图,再基于图搜索与反思机制合成连贯、受控且无虚假死循环的多步交互轨迹。基于该框架构建的数据集将交互轨迹的平均长度推升至 14.8 步,显著填补了当前学界在高界面复杂度与长交互步数区域的数据空白。
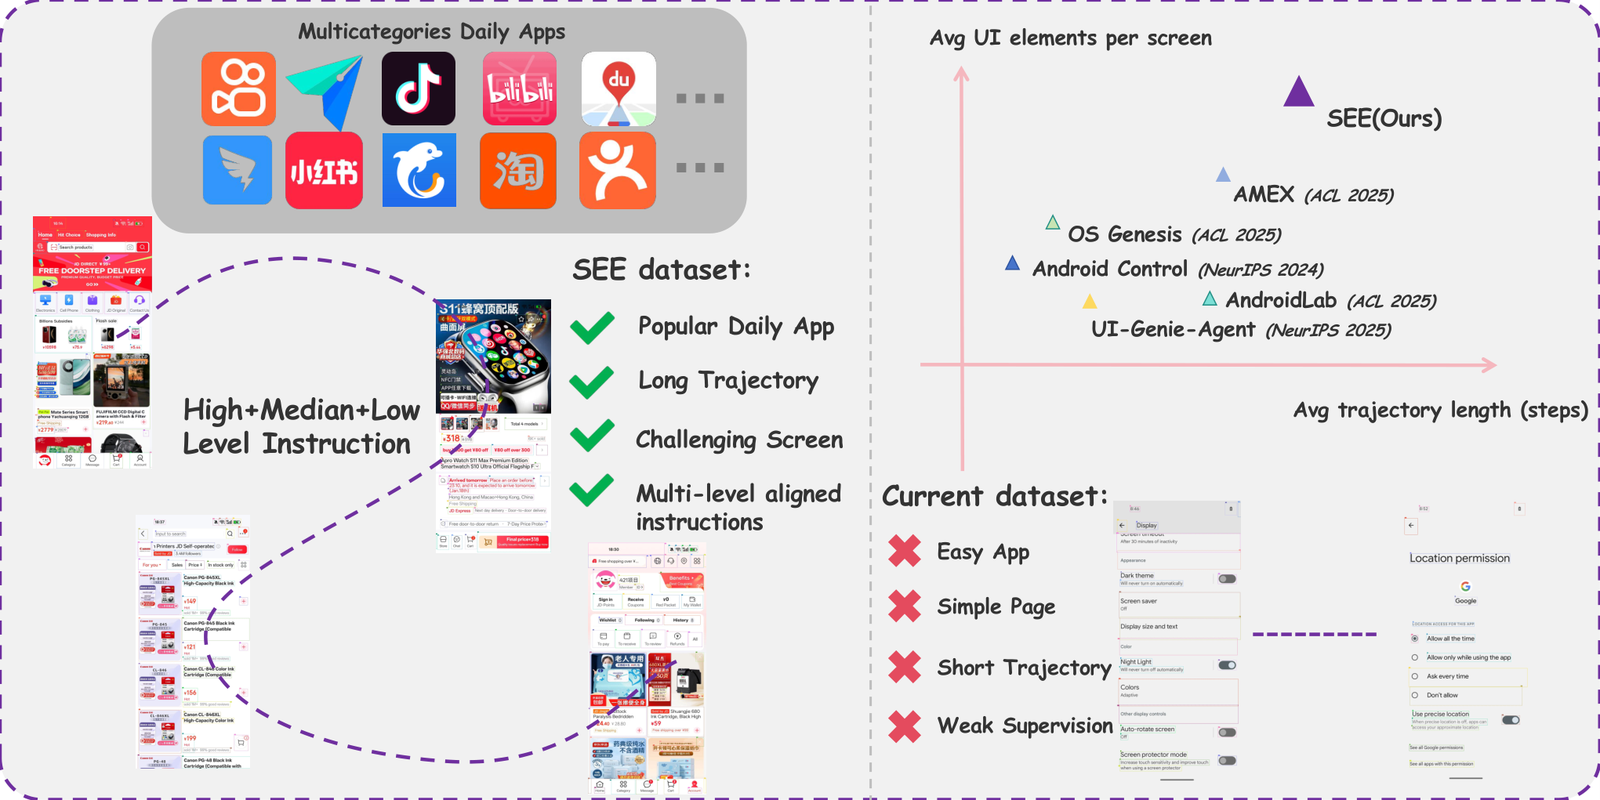
为什么现有 GUI Agent 数据管线难以应对长程真实任务?
长期以来,训练移动端 GUI Agent 的数据源主要依赖人工录制和在线试错生成。人工演示保真度高,但标注成本高昂,且难以穷尽庞大的长尾界面分支;自动化探索方法虽然具备扩展性,但往往面临严重的状态表征漂移和探索盲目性。
移动界面的本质是一个部分可观测的序列决策过程。由于界面元素通常极为密集且语义含糊,许多图标缺乏文本标签,模型在每一步决策时都容易产生视觉幻觉。更致命的是,多步长程任务往往包含“先到设置中开启某项权限,再返回主界面触发流程”这种具有前置依赖与回退(Back)动作的路径。如果直接让大模型端到端地逐步发散生成,智能体会反复在相似的顶层视图之间打转,形成大量冗余振荡和无意义的自环循环(Spurious cycles)。
从人类认知与人机交互(HCI)的经典视角来看,人类熟悉一款陌生应用从来不是一步登天的,而是先通过“探索性感知”理清应用有哪些可交互的界面与按钮,建立起心智模型,随后在“目标利用阶段”通过规划组合出达成目标的行动链。现有主流方法混淆了这两种认知模式,试图在单次采样中同时完成功能发现、逻辑规划与动作接地(Grounding),这正是轨迹普遍偏短(多集中在 3 到 5 步之内)且深层覆盖率极低的根本原因。
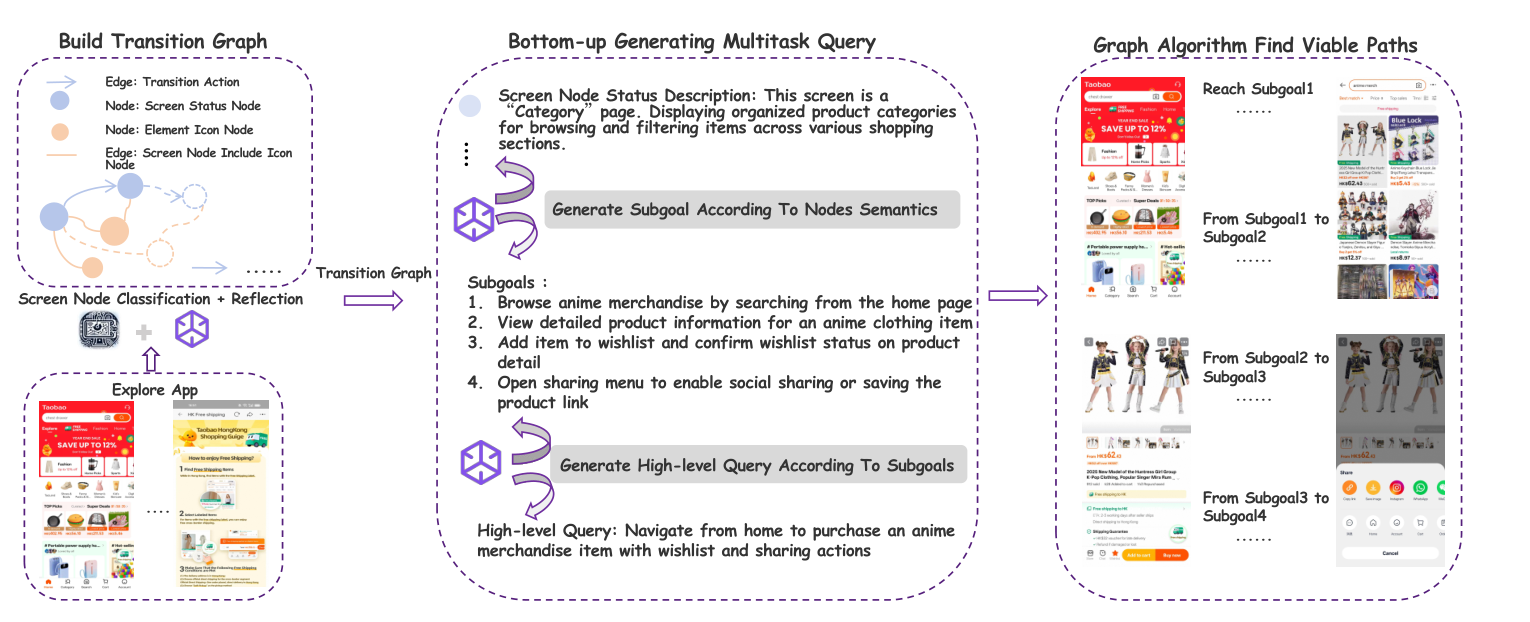
解耦探索与合成:SEE 框架的双阶段设计
SEE 框架顺应了这种认知分解,将其拆解为两个核心阶段:结构感知探索(Structure-aware Exploration) 与 基于图的轨迹合成(Graph-based Synthesis)。系统首先在真实环境中自主演进,构建出一个明确的屏幕-元素转移图 $G=(V, E)$;在这个图结构被提炼与修正后,所有长程任务的生成和语言指令的注入都在图拓扑之上高效展开。
1. 结构感知探索与屏幕状态抽象
在探索阶段,智能体必须高效勘测 App 的深层状态空间,而不是被困在浅层界面的细枝末节中。面对输入观测 $o_t$,框架首先调用 UI 解析工具提取候选元素集 $\mathcal{M}t={e{t,i}}_{i=1}^{N_t}$。考虑到移动端图标的歧义性,视觉语言模型会为每个候选元素打上轻量级的语义功能描述。
为了决定在当前界面触发哪一个交互,SEE 引入了综合评分机制来挑选最值得探测的操作候选。元素排名打分函数结合了三项先验:
\[s(e_{t,i})=s_{\text{sem}}(e_{t,i})+s_{\text{lay}}(e_{t,i})-p_{\text{hist}}(e_{t,i})\]其中,$s_{\text{sem}}$ 评估元素与当前 App 类别及导航先验的语义对齐度;$s_{\text{lay}}$ 是布局先验权重,倾向于优先探索顶部导航栏、底部 Tab 栏等结构性枢纽区域;$p_{\text{hist}}$ 则是历史惩罚项,用于抑制对高频或冗余元素的重复点击。结合少量的随机探索概率,系统既能抓住结构骨架,又能兼顾长尾界面的触发。
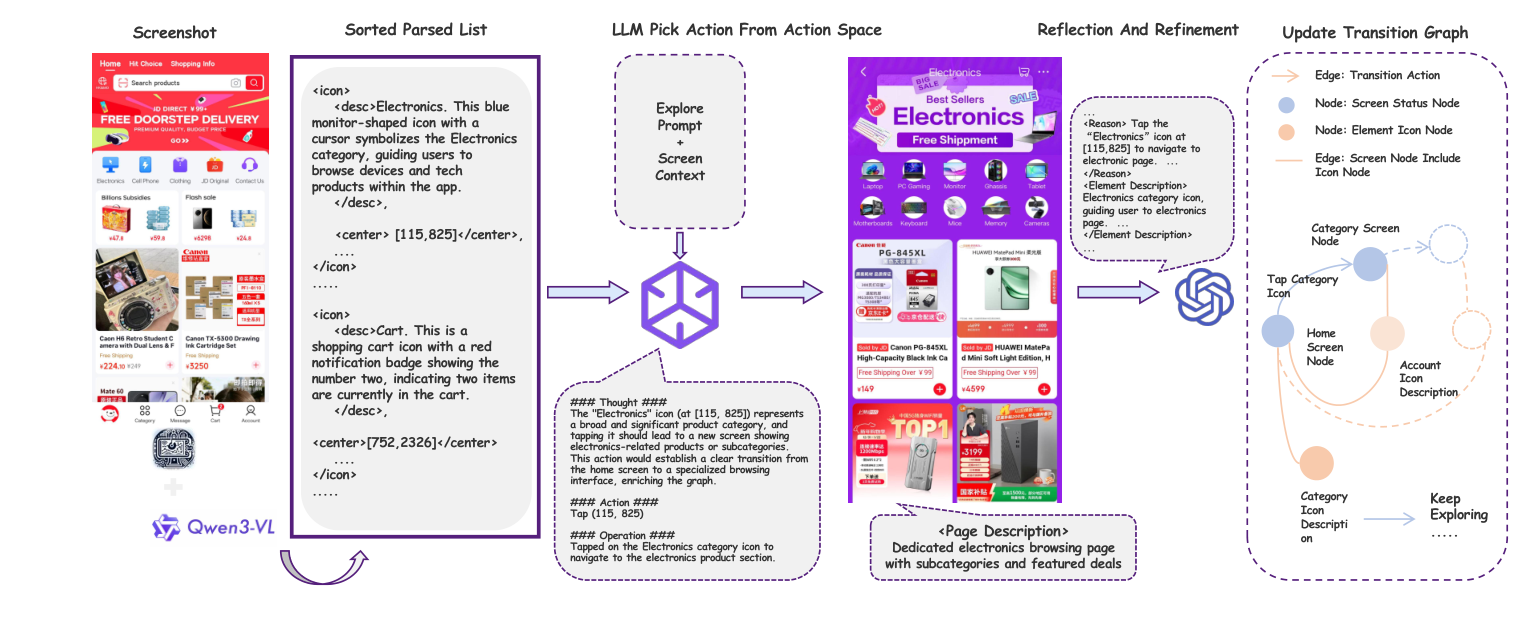
探索过程中的另一大技术难点在于屏幕状态判重(Screen Identification)。由于动态加载、轮播图或微小的视觉渲染差异,完全相同的系统页面在不同时间捕获的像素值并不一致。如果将每一次微小变化都视为新节点,图结构会迅速爆炸膨胀;反之如果粗暴合并,又会丢失关键界面。
SEE 采用了一种基于结构先验的抗噪对齐机制。系统在顶部栏、底部导航等高结构稳定度的兴趣区域(Regions of Interest, $\mathcal{R}$)提取出代表性元素原型 $\mathcal{P}(o)={p_i}_{i=1}^N$,每个原型记录其 MobileNet 视觉嵌入向量 $f_i$ 与归一化包围框 $b_i$。在比对当前屏幕 $o$ 与历史屏幕 $o’$ 时,二者元素间的对齐代价定义为:
\[C_{ij}(o,o')=\alpha\,d_{\cos}(f_i,f'_j)+\beta\,d_{\text{pos}}(b_i,b'_j)\]随后利用匈牙利算法(Hungarian matching)在多项式时间内求解最佳一对一匹配。只有当足够比例的骨干元素能够低代价重合时,新观测才会被折叠到已有的屏幕节点 $u$ 中。这种设计兼顾了视觉语义与绝对坐标分布,将杂乱的界面序列抽象为紧凑的二部图:包含界面状态节点 $u \in \mathcal{U}$、元素节点 $e \in \mathcal{M}$、动作引发的跳转有向边 $(u, a, u’)$ 以及界面包含边 $(u, e)$。
2. 带有反思修正的有向图提炼
探索过程难免遭遇无效操作,例如点击了无响应的空白区、触发了暂时性弹窗或发生了意料之外的系统跳出。如果在脏图上直接规划,生成的轨迹将充满断层。
因此,SEE 在每次动作执行后引入了反思与微调机制(Reflection and Refinement)。在探索推进的同时,局部验证模块会对转移前后的状态变化进行一致性审计:动作是否真的引发了预期中的状态迁移?界面的核心功能是否发生改变?系统在不破坏全局探索进度的前提下,为图中的节点与跳转边打上置信度标签并提炼紧凑的跳转总结。经过验证的图拓扑剔除了偶发性假转移,为第二阶段的无损合成提供了高纯度的结构底座。
3. 图驱动的层次化轨迹合成
一旦获得了高质量的应用状态转移图,合成超长轨迹的过程就不再需要直接控制真机一步步试错,而是转变为图上的路径规划问题。
首先,系统从图 $G$ 中采用特定策略采样一组具有功能相关性或跨层级的目标屏幕节点,借助大语言模型根据这些屏幕的功能摘要提炼出一个高层次目标任务(High-level Instruction),并将这些节点解析为有序的中层子目标列表 $\mathcal{L} = {l_j}$。
接着,对于子目标序列中任意两个相邻屏幕节点 $(u^{(j)}, u^{(j+1)})$,框架通过图搜索算法(如广度优先搜索 BFS)寻找最短或受约束的可行路径,并将它们缝合成一条完整的长序列:
\[(u_0 \xrightarrow{a_0} u_1 \xrightarrow{a_1} \cdots \xrightarrow{a_{L-1}} u_L)\]在这个规划过程中,系统能够显式施加约束以剔除无意义的环路与震荡;同时,轨迹的理论长度可以通过调节子目标的跳数与图距离进行精确控制。
最终,为了让训练出的 Agent 具备跨层次的指令理解能力,SEE 不仅提供整体任务目标,还依托图中沉淀的富语义节点与边属性,直接由大语言模型合成对齐到底层每一步的低级操作描述。这意味着,智能体无需反复渲染庞大的多模态历史上下文,就能在合成轨迹中获取从“宏观目标”、“阶段子目标”到“单步具体操作与预期结果”的三层监督信号。