MeMento:用偏好引导压缩多模态记忆,长程具身决策准确率提升7.18%且Token锐减85%
Long-Horizon Embodied Decision-Making via Multimodal Memory Compression
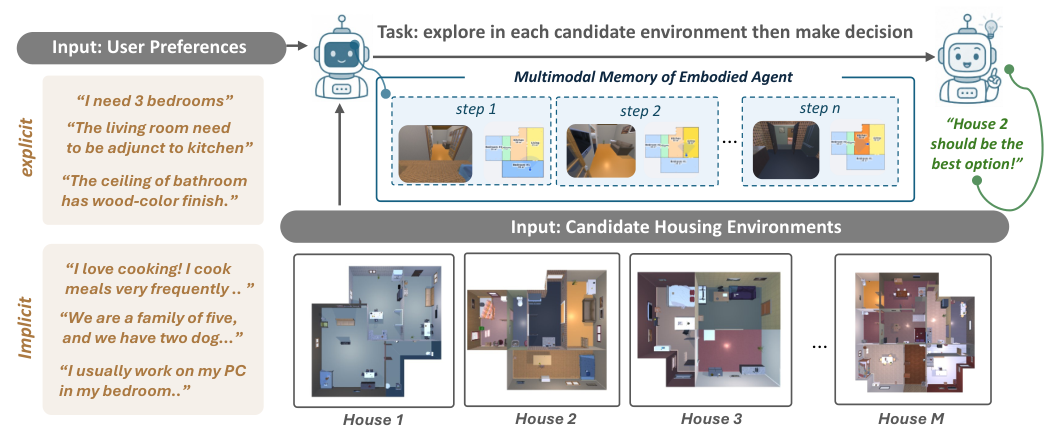
当前的具身智能体(Embodied Agent)正在经历一场关键的职责转变:学术界不再仅仅满足于让智能体充当听从单一指令的“执行器”(例如走过去拿起桌上的水杯),而是希望它们能够作为“决策代理”(Decision-Maker),代表真实用户在复杂环境中完成长程探索并做出深思熟虑的选择。
ArXiv URL:https://arxiv.org/abs/2608.01456
这种转变带来的技术挑战极为严苛。在现实世界中,代表用户做决策往往意味着智能体需要在部分可观测(Partial Observation)的环境中探索漫长的时间步,跨越多个候选场景积累证据,同时理解用户模糊、不成体系的隐式偏好。以最为典型的人本长程决策——租房与选房为例:用户需要在多个房源之间来回考察虚拟漫游,记下每个房屋的采光、空间布局、装修用料与陈设细节。随着看房数量的增加,人类自身极易产生决策疲劳(Decision Fatigue),而现有的多模态大模型智能体面对海量视觉与动作历史时,也暴露出严重的记忆管理失控与上下文噪声过载问题。
针对长程人本具身决策的核心瓶颈,最新研究提出了全新的评估基准 DunphyBench,以及一种由偏好条件引导的多模态记忆压缩框架 MeMento。该工作不仅系统性地揭示了“无节制堆砌多模态历史上下文反而导致智能体决策崩溃”的非单调现象,还通过将海量多模态轨迹按偏好压缩为固定数量的记忆 Token(Memory Tokens),在使决策准确率绝对提升 7.18%(相对提升 15.74%)的同时,将记忆 Token 消耗大幅削减了 85.38%。这一框架展示了如何以极紧凑的计算代价,让冻结参数的视觉语言模型(VLM)具备跨越长时程环境的审慎决策能力。
从任务执行到人本决策:DunphyBench 基准的构建
在现有的具身智能基准中,任务的交互步数通常局限于 15 到 60 步之间,评测核心集中在具身导航(如 VLN)或即时目标达成(如物体抓取、房间重置)。然而,在真实的跨环境决策场景下,智能体所面对的交互步长通常高达 1500 步左右。为了衡量智能体在超长时程下聚合多源多模态知识并对齐人类偏好的能力,研究团队构建了 DunphyBench。
在 DunphyBench 的设定下,智能体必须在多套房屋候选环境之间自主漫游,收集足够的视觉与空间信息,最终判定哪一套房屋最契合目标用户的偏好。该基准在机制设计上重点突破了两个维度:
-
偏好的欠规范性(Preference Under-Specification)与隐式推断:真实用户很少会提供一份条理严密的约束清单。为此,评测设立了显式(Explicit Track)与隐式(Implicit Track)两个独立轨道。在显式轨道中,偏好直接映射为结构化的可验证谓词(例如“至少有三间卧室”);而在隐式轨道中,用户的诉求被包装为生活习惯或角色画像(例如“我每天都要为很多朋友做大餐”或“我需要一个极其安静的工作角落”)。智能体必须自行推断这背后的空间结构与设施需求(如大面积厨房、独立书房),并将其落地到视觉观测中。
-
七大语义维度的偏好分类体系:为了防止模型走捷径或在单一特征上过拟合,评测系统涵盖了房间数量与类型、房间尺寸与面积、窗户与采光、特定物体存在性、物体数量、空间连通性、材质与硬装表面等七个层面的细粒度属性。
在数据生成与质量控制阶段,基准严格保证了唯一真实最优解(Golden Environment)完全满足全部偏好,而所有干扰候选房源(Distractors)均至少违反部分偏好,同时借助 Jaccard 相似度过滤消除实例间的冗余。这一严密设计使得 DunphyBench 成为首个能够隔离测试智能体“偏好推断”与“多候选长程视觉扎根”能力的具身决策平台。
诊断前沿智能体:长程多模态记忆为何失效?
评测团队评估了包括 GPT-5.4、Qwen3VL 系列以及 Gemma-4 在内的前沿多模态智能体。实验结果展示了显著的性能差距:即使是表现最好的闭源前沿模型,在 DunphyBench 上的准确率也仅为 58.3%,而经过相同协议测试的人类测试者准确率高达 83.3%。
更为深入的诊断分析揭示了具身决策智能体在长程探索中的三大关键软肋:
-
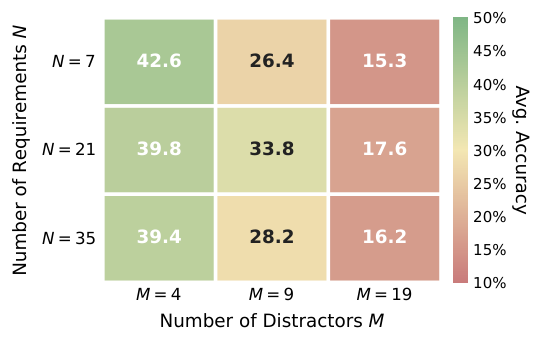
复杂度敏感度剧烈:当任务难度从简易向困难递增、候选干扰项与偏好约束增加时,模型的决策准确率骤降超过 20 个百分点。智能体在组合推理与拥挤的决策空间中极易发生混淆。
-
隐式偏好推断严重落后:在相同的基础难度下,模型在隐式轨道上的表现全面落后于显式轨道(例如在简易设置下,显式准确率为 49.1%,而隐式准确率仅有 26.7%)。智能体往往能看懂画面里有什么,却推导不出“做大餐”需要充足的台面与灶具。
-
记忆缩放的非单调性陷阱(Non-monotonic Scaling):长程多模态记忆是决定性能生死的关键驱动力。完全不具备记忆的 Agent 在面对长时程决策时几乎等同于盲人;当引入 10 个步数的历史上下文时,模型准确率跳升了 17%。然而,一旦将无过滤的原始历史进一步拉长到 15 步以上,决策性能非但没有继续提升,反而开始掉头向下。
失败案例分析显示,模型高达 21% 的错误来自丢失自身空间定位或遗忘哪些区域已探索,另有 13% 的错误表现为陷入死循环、在同一个环境中反复搜寻已看过的区域。这表明,单纯将更长序列的原始多模态历史塞进上下文窗口,不仅带来了巨大的计算与显存负担,更引入了大量无关的视觉冗余与噪声,破坏了跨时空聚合证据的能力。真正的瓶颈在于长程多模态记忆的管理机制。
MeMento 框架:偏好条件引导的层次化多模态压缩
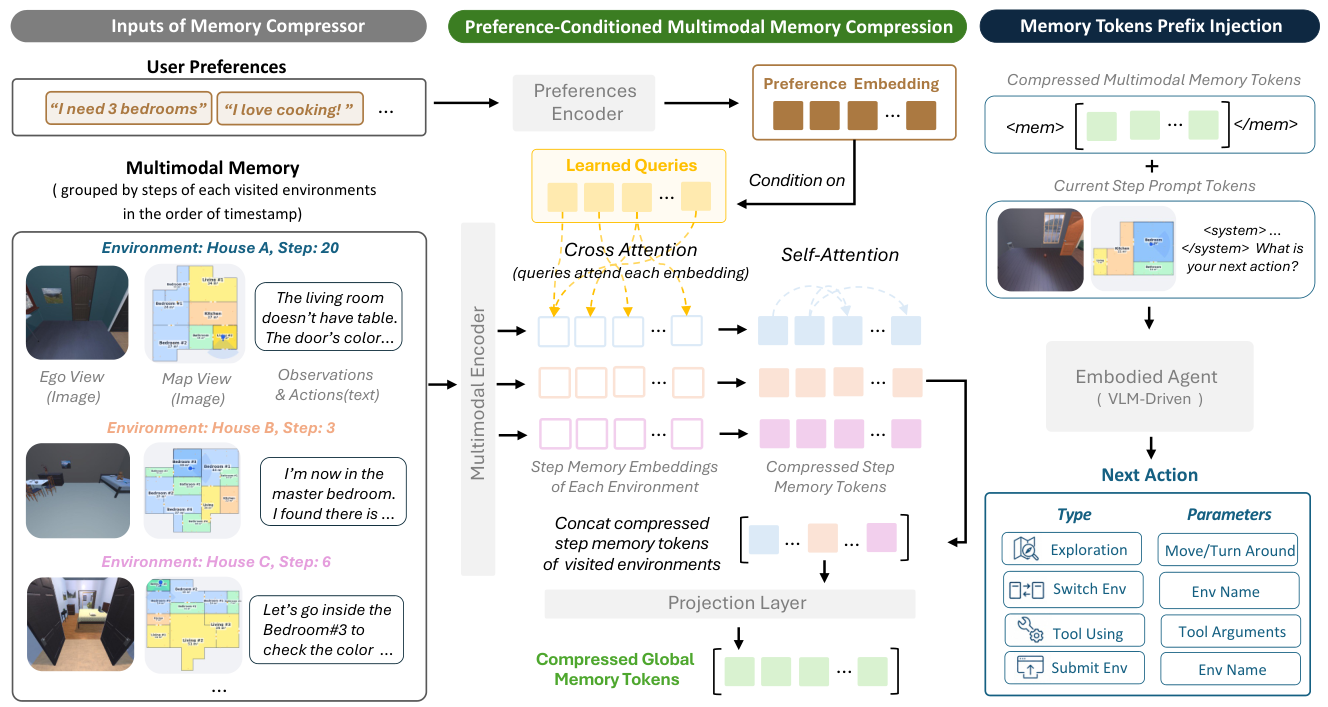
认识到无过滤历史的毒害之后,研究团队提出了名为 MeMento 的偏好条件多模态记忆压缩器。其核心设计理念在于:丢弃与决策无关的背景细节,让用户的偏好充当“注意力筛选器”,将分散在漫长交互历史中的多模态观测压缩为极少数高质量的全局记忆 Token。
MeMento 的系统架构可以划分为三个核心阶段:
1. 偏好与多模态交互编码
面对用户的需求陈述,系统首先利用冻结参数的视觉语言模型主干提取关键词,生成偏好 Token,随后经过池化形成统领全局的偏好表征向量 $\bar{\mathbf{z}}_{r}$。该向量将作为后续所有观测筛选的语义指导锚点。
在环境交互侧,每个时间步 $t$ 智能体所产生的状态由多模态元组构成:
\[x_{t} = \{\text{ego image}, \text{map image}, \text{observation}, \text{action}\}\]经过专用编码器 $f_{\mathrm{enc}}$ 映射后,得到稠密步表征 $\mathbf{e}{t}$。为了在压缩后依然能理清因果与空间归属,该表征与时间步索引编码 $\mathbf{p}^{\mathrm{time}}{t}$ 及候选房屋标识编码 $\mathbf{p}^{\mathrm{env}}_{k}$ 进行加和融合:
\[\tilde{\mathbf{e}}_{t} = \mathbf{e}_{t} + \mathbf{p}^{\mathrm{time}}_{t} + \mathbf{p}^{\mathrm{env}}_{k}\]2. 分层独立环境压缩
如果把所有候选环境的视觉历史混在一起压缩,极易造成证据在不同房间之间的“张冠李戴”(例如误将 A 房源的阳台记到 B 房源头上)。MeMento 采取了严格的分层隔离设计:在特定的环境 $\mathcal{E}{k}$ 内部,由偏好向量构建的学习查询 $\mathbf{Q}{r}$ 驱动交叉注意力机制,单独吸纳该环境内部所有时间步的表征:
\[\mathbf{H}^{(k)} = \mathrm{SelfAttn}\left(\mathrm{CrossAttn}\left(\mathbf{Q}_{r}, \{\tilde{\mathbf{e}}_{t}: t \in \mathcal{E}_{k}\}, \{\tilde{\mathbf{e}}_{t}: t \in \mathcal{E}_{k}\}\right)\right)\]各候选环境的记忆 Token 提纯完成后,再在环境级别拼接为全局记忆 Token $\mathbf{H}_{\mathrm{global}}$。这种层次化结构确保了候选房屋之间的独立可比性。
3. 记忆注入与主干模型无缝衔接
压缩后的全局记忆经过一个可训练的轻量适配层(Projection Adapter)$\psi(\cdot)$,被映射到冻结 VLM 的输入 Embedding 空间中,记为 $\tilde{\mathbf{M}} = \psi(\mathbf{H}{\mathrm{global}})$。随后,这些记忆 Token 作为结构化前缀,直接拼接到当前步的视觉与文本提示之前:$[\tilde{\mathbf{M}}; \mathbf{X}{\mathrm{current}}]$。
在这个过程中,基础大模型的主干权重全程保持冻结,压缩后的记忆扮演了类似连续型“软提示”(Soft Prompt)的角色,为主干模型在做最终决策和下一步动作预测时提供高密度的长程上下文支撑。
两阶段训练策略:如何教会压缩器读懂偏好与证据?
让一个小型压缩器学会从上千步的图像与文本中挑出关键线索,并让下游冻结的 VLM 能够读懂,需要精巧的监督策略。MeMento 采用了分阶段的解耦训练:
-
阶段一:偏好证据定位训练。该阶段重点训练压缩器自身的注意力机制,使其学会基于偏好向量 $\bar{\mathbf{z}}_{r}$ 从冗长的时空序列中准确定位具有判别意义的视觉帧。
-
阶段二:表征空间对齐训练。此阶段的目标是打通压缩器、投影适配层与大模型主干的语义鸿沟。研究人员利用偏好相关的问答对构建了微调任务(例如询问先前看过的某个房间内是否存在特定物品或特定空间关联,答案为 yes、no 或 unknown)。
在阶段二中,VLM 仅接收压缩后的记忆前缀 $\tilde{\mathbf{M}}$ 以及问题提示 $q$。由于主干网络处于冻结状态,预测目标答案 $a$ 产生的语言建模自回归损失 $\mathcal{L}_{\mathrm{stage2}}$ 的梯度将穿过冻结主干的反向计算图,直接反向传播至投影层与压缩器自身:
\[\mathcal{L}_{\mathrm{stage2}} = -\sum_{i \in \mathcal{T}_{\mathrm{ans}}} \log p_{\theta}(a_{i} \mid a_{<i}, \tilde{\mathbf{M}}, q)\]通过这种端到端的问答式驱动,压缩器生成的记忆 Token 被强制规整为 VLM 极易解析的语义格式,杜绝了无意义的表征漂移。
实验与深入验证:精度攀升与显存开销暴跌的双赢
实验基于统一的开源基底模型 Qwen3VL-8B-Instruct 展开,全面对比了五类代表性记忆范式:完全无记忆模型、仅保留近期文本观测的模型(Text Recent Memory)、保留近期图文观测的多模态滑窗模型(Multimodal Recent Memory)、利用模型自身生成文字摘要的历史压缩模型(Text Summarization Memory),以及基于工具的检索增强模型(RAG)。
各方案在 DunphyBench 上的核心性能与资源开销对比如下:
| 记忆策略 | 决策准确率(Accuracy) | 记忆 Token 开销(Tokens) | 机制特征与缺陷 |
|---|---|---|---|
| 无记忆(Memoryless) | ~30% | 0 | 缺乏历史追踪能力,长程完全随机 |
| 滑窗文本记忆(Text Recent) | 38.89% | ~20K | 缺乏精细视觉感知,无法验证材质与空间 |
| 文本摘要压缩(Text Summary) | 41.67% | ~26K | 摘要过程存在幻觉,且丢失大量未被转录的视觉细节 |
| 滑窗多模态记忆(Multimodal Recent) | 45.60% | ~60K | 算力消耗极高,包含大量无关帧,长程噪声严重 |
| MeMento(本文方法) | 52.78% | ~3.8K | 偏好引导层次化压缩,大幅降低噪声并保留关键视觉证据 |
在基准评测中,MeMento 取得了 52.78% 的最高决策准确率,较最强的多模态滑窗基线绝对提升了 7.18 个百分点。与此同时,由于 MeMento 将历史信息提炼为了固定长度的高效 Token,其占用的记忆空间从 baseline 的近 60K Tokens 暴跌至仅 3.8K 左右,实现了高达 85.38% 的 Token 开销缩减。
为什么有效?消融实验的剖析
为了厘清 MeMento 优越性能的来源,消融实验对系统内的三大模块逐一进行了剥离:
-
剥离偏好谓词引导($\text{MeMento}_{P}$):不将用户诉求转化为具体的偏好关键词,而是直接对原始文本进行稠密编码后作为压缩条件。结果显示,准确率直接断崖式下跌至 15.67%。这表明,缺乏显式、结构化的偏好聚焦,注意力压缩器根本无法在超长时空序列中大海捞针,偏好对齐是整套机制的灵魂。
-
剥离多模态视觉记忆($\text{MeMento}_{T}$):仅压缩文本记录而丢弃图像序列,准确率回落到 44.44%。这证明在复杂的物理环境中,仅凭语言描述无法完全表达空间连续性与细粒度质感,视觉维度的直接保留不可替代。
-
剥离层次化环境独立压缩($\text{MeMento}_{U}$):放弃按环境独立压缩的双层设计,将全局步历史混合进行单阶段压缩,准确率跌至 41.67%。这证实了跨候选房源的信息串扰是长程决策中的重大负面干扰源。
记忆探针任务:是否真正记住了细节?
为验证记忆 Token 中是否切实内嵌了环境细节,研究团队设计了一套记忆探针问答(Memory Probing QA),在交互结束后向模型询问诸如“刚才看过的厨房水槽旁是否有窗户”等细节问题。
评测结果显示,MeMento 达到了 0.719 的非 Oracle 最高 Macro-F1 得分,与直接提供真实观测图片的 Oracle 上界差距仅为 0.097,显著超越了纯文本摘要和滑窗多模态基线。更为关键的是,当人为将记忆 Token 替换为全零向量(Zero Memory)或随机向量(Random Memory)时,探针得分暴跌至 0.071 与 0.048。这强力证明,MeMento 训练出的前缀 Token 绝非充当了某种促使大模型胡思乱想的“通用激活指令”,而是真实编码了具身环境的高保真决策证据。
跨域迁移:从 3D 具身房源到复杂 Web 决策
MeMento 的通用性不仅限于物理 3D 模拟器。在由 100 项涵盖多轮价格、地理位置约束组成的 Embodied Web Agent 真实网络交互测试中,无记忆智能体仅能取得 34% 的成功率;滑窗多模态记忆以 4.5K Token 的代价达到 69% 成功率;而 MeMento 仅使用了区区 512 个 Token,便达成了 83% 的决策成功率,展现出从物理空间决策向数字工具决策无缝迁移的通用潜力。
总结与启示
DunphyBench 与 MeMento 的提出,指出了当前 Agent 技术在上下文扩展上的一个盲区:盲目拉长上下文窗口并不等同于获得了长程决策能力。在涉及多候选比较、部分可观测和隐式用户意图的人本任务中,未加筛选的原始观测历史更像是一种“高熵毒药”,它不仅迅速消耗有限的注意力预算,更容易用无关的视觉碎片稀释关键决策线索。
MeMento 所验证的路径表明:未来的具身决策智能体,必然需要一个轻量、敏锐且紧贴用户意图的“记忆海马体”。通过让用户的个性化偏好化身为主动过滤机制,在探索的同时对高维连续多模态信号进行分层蒸馏与动态定型,智能体才能在面对成百上千步的纷繁世界时,始终保持清醒的判断力。