Mirror Learning:无需遥操作,用视频扩散模型把“旁观”变成策略
Mirror Learning
在具身智能与自动驾驶领域,行为克隆(Behavior Cloning, BC)长期扮演着中流砥柱的角色。无论是无人车的大规模端到端驾驶模型,还是机械臂的多任务操作,其背后的工业级成功几乎都建立在一个极其严苛的前提之上:必须拥有大量来自第一人称视角的密集、干净且标注精准的专家轨迹。为了获得这些数据,研究团队通常需要投入昂贵的遥操作(Teleoperation)座舱、专业的人类操作员,或者让测试车队在真实道路上积累数百万公里的里程。这种强依赖不仅构成了高昂的数据采集成本,更成为具身系统泛化和扩展的核心瓶颈。
ArXiv URL:https://arxiv.org/abs/2607.28737
相比之下,生物界展现出了截然不同的学习范式。人类幼儿不需要由父母“遥控自身手脚”才能学会拿勺子,灵长类动物通过观察同伴就能快速掌握复杂的取食工具使用技巧。认知神经科学中的“镜像神经元系统”(Mirror Neuron System)揭示,生物的大脑在观察他人动作与自己亲自执行该动作时,会激活高度重叠的神经表征。如何让机器人或自动驾驶车辆跨越“旁观者视角”与“执行者视角”的物理鸿沟,仅仅通过观察其他智能体的被动行为就学会自主控制,一直是模仿学习领域悬而未决的难题。
针对这一瓶颈,一项名为 Mirror Learning(镜像学习)的研究提出了全新的解题思路。研究者没有遵循传统方法去依赖已知的相机外参标定或显式的几何重建,而是直接调用经过大规模预训练的视频扩散世界模型,让模型学会“站在对方的视角看世界”。该框架将观察学习解构为两个紧密耦合的生成过程:首先通过微调的视频扩散模型,将第三人称观察到的示范者行为无缝投射为示范者自身的第一人称视觉序列;随后利用逆动力学模型(Inverse Dynamics Model, IDM),从这段合成的“镜像视频”中反向推断出连续控制动作。
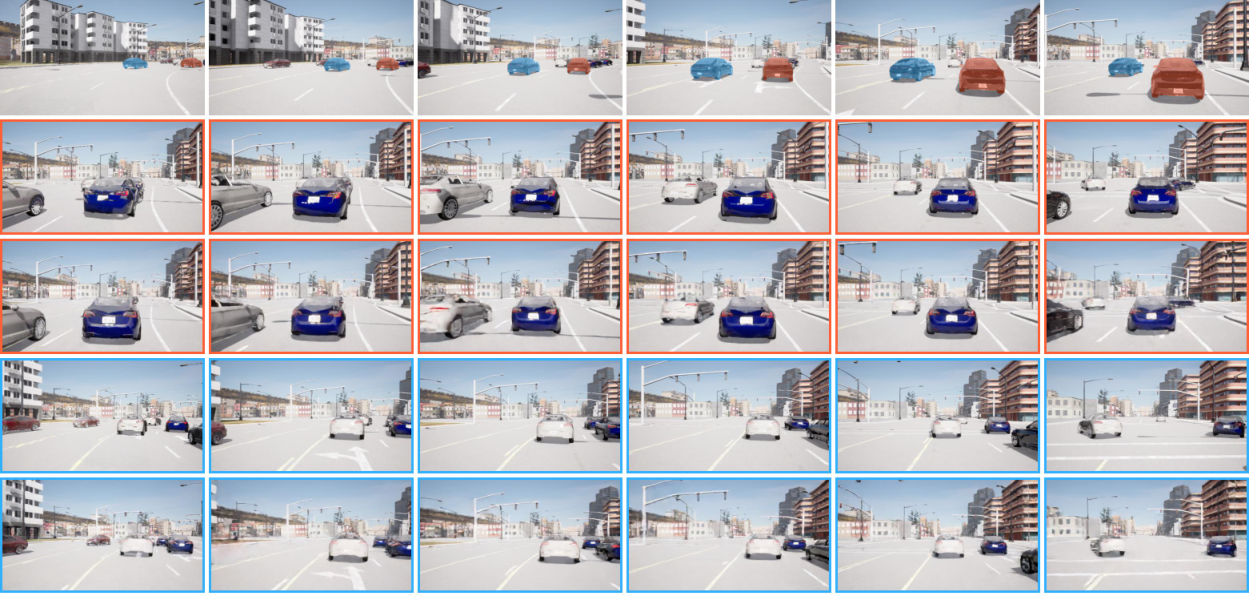
实验结果给出了极具说服力的结论:即便完全不给任何真实的第一人称专家数据,仅依靠这套系统无中生有合成的“镜像数据”(Mirror Data),就能训练出表现稳健的端到端控制策略;而将镜像数据混入已有的真实数据集中,更能大幅降低策略在未知环境下的位移误差($\text{minADE}_5$),其效果明显优于传统的跨域风格迁移。这项成果证明,现代视频世界模型内部蕴含的时空物理先验,足以支撑起无需遥操作的跨视角数据合成流水线。
视角与动作的双重鸿沟
要实现真正的“旁观学习”,算法必须同时解决两个维度的信息断裂:视角断裂(Perceptual Viewpoint Mismatch)与控制断裂(Action Gap)。
视角断裂是跨智能体模仿的首要障碍。在传统的第三人称模仿学习中,学习者看到的是外部世界中示范者身体的运动。然而,学习者最终要部署的控制策略,其输入只能是安装在自己身上的车载相机或头部传感器。过去的研究通常尝试在受限环境中学习视点不变的表征,或者通过几何多视几何(Epipolar Geometry)与神经辐射场(NeRF)进行视角变换。但几何类方法极其依赖精确的相对位姿,并且对视锥范围之外的盲区无能为力。当示范车行驶在学习者前方时,示范车车头前方的红绿灯、斑马线行人或路面障碍,完全处于学习者当前相机的视锥遮挡之后。缺乏对遮挡环境的语义“补全”能力,几何投影往往会产生大量空洞或撕裂拉伸。
控制断裂则更为致命。即使示范者恰好在视野中完成了精彩的避障操作,学习者也无法直接读取示范者体内的油门开度、刹车压力或方向盘转角。没有动作标签,传统的监督式行为克隆就无法立足。尽管学界曾探索使用逆动力学模型去预测动作,但此类模型原本只能在学习者自身的第一人称视频上工作;如果直接喂给它第三人称的旁观录像,模型输入与动作输出之间的因果链条便会彻底错乱。
Mirror Learning 的核心直觉在于,这两个看似独立的鸿沟,完全可以用现代生成式人工智能的工具链串联击破。视角转换本质上是一个条件视频生成与未见区域修复(Inpainting)问题,而这恰恰是视频世界模型的强项;动作推断则可以严格限制在转换后的第一人称视频域内运行。通过让扩散模型承担时空几何与盲区物理演化的重构任务,下游的逆动力学模型就能面对一份“看起来就像亲身经历”的连贯视频,从而从容推断出底层控制量。
换位思考:Mirror Video Model 如何重构第一人称
整个框架的前半部分是一个被称为 Mirror Video Model(MVM,镜像视频模型)的生成网络。它的任务可以精确形式化为:给定学习者 $i$ 自身的第一人称观测视频 $o^{(i)}{1:T}$,以及在视频中标识出示范者 $j$ 的连续二值注意力掩码(Instance Segmentation Mask)$m^{(j\leftarrow i)}{1:T}$,模型需要推断并生成示范者 $j$ 真实经历的第一人称视频序列 $o^{(j)}{1:T}$。这对应着条件概率分布 $p\theta(o^{(j)}{1:T} \mid o^{(i)}{1:T}, m^{(j\leftarrow i)}_{1:T})$。
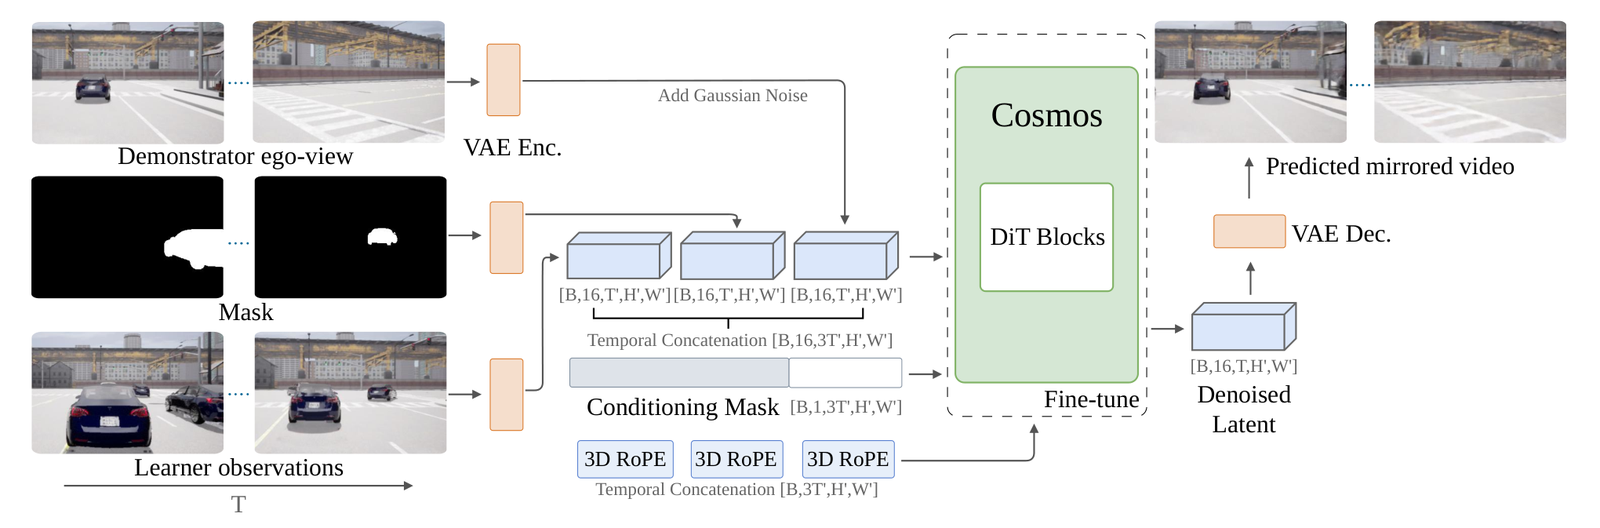
该模型基于英伟达开源的 Cosmos-Predict 2.5-2B 视频主干模型构建。Cosmos 是一套专为物理世界建模设计的 Diffusion Transformer(DiT)架构,具备极强的跨帧一致性和物理规律感知能力。为了让通用的视频生成模型适配跨视角的对齐任务,研究团队引入了一套精巧的多流时空编码方案。
学习者原视频、指示示范者位置的掩码序列,以及被加噪的目标示范者视角潜编码,首先通过一个共享的时空变分自编码器(3D VAE Encoder)被压缩为紧凑的潜在特征。为了保持不同视角之间的时序同步与空间对应关系,研究团队没有简单地把掩码作为额外通道拼接,而是将三者沿时间维度串联,并对跨视角相同物理时刻的 Token 赋予一致的 3D 旋转位置编码(3D RoPE)。同时,网络内部通过特殊的条件注意力掩码(Conditioning Mask)来严格隔离“已知观测 Token”与“待去噪预测 Token”。
在训练过程中,研究者完全冻结了文本编码器和 VAE 编解码器,仅微调中间的核心去噪 Transformer 参数,训练目标沿用了 Cosmos 原生的 Flow-Matching 目标。这种设计的精妙之处在于,模型在去噪过程中被隐式迫使去理解示范者的运动姿态、推导两台车之间的相对相机朝向,并在目标视锥超出原始视野时,调用预训练网络中关于道路、建筑和植被的世界常识进行物理自洽的像素“脑补”。
从论文展示的 CARLA 仿真生成样本中,可以清晰看到这种世界模型能力的体现。当学习者跟随两台示范车行驶时,右侧一栋棕褐色的建筑在学习者自己的视频里直到第五帧才出现在右边缘;但在 MVM 生成的示范车第一人称视频中,由于示范车位置靠前,模型在第一帧就必须渲染出该建筑。生成的镜像视频不仅准确无误地提早呈现了建筑物外观,甚至连对方车身反光、道路标志线以及前方红绿灯的状态都保持了惊人的时空连续性。
为了验证模型不仅仅是在狭窄的车载固定视角上“投机取巧”,研究团队还将 MVM 拓展到了高自由度的多智能体 Minecraft 环境中。与汽车近似平面、固定机位不同,Minecraft 角色具有极高维度的头部俯仰、身体旋转和工具摆动。
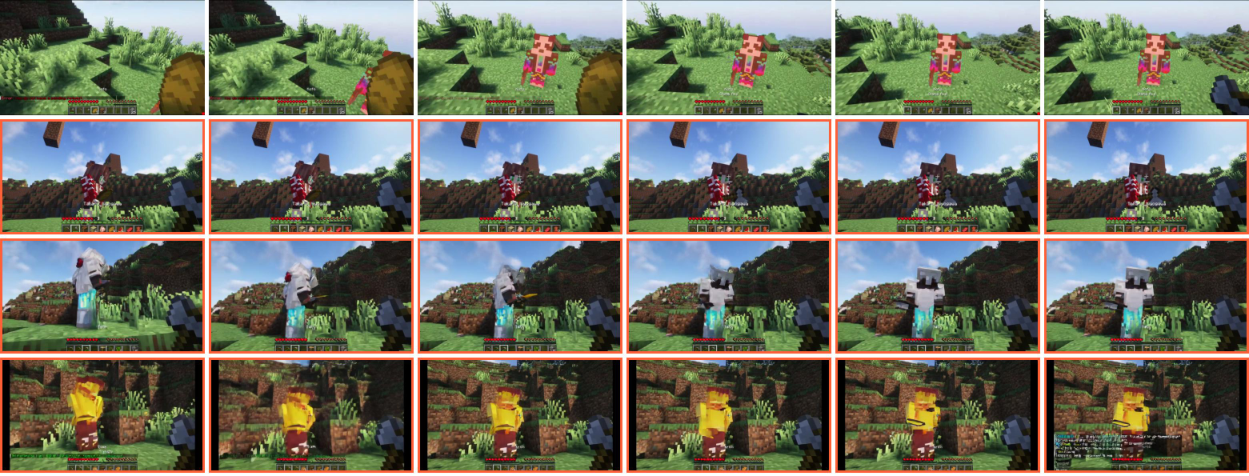
在 Minecraft 测试中,学习者只能在第三人称画面里看到一个持有斧头、注视远方的玩家角色。MVM 在将视角切换至该玩家的第一人称时,准确地在屏幕右下角渲染出了手持斧头的姿态,并根据玩家视线朝向,合成了逼真的雪山生物群系背景。更引人注目的是,由于学习者无法看到对方的角色皮肤,扩散模型表现出了合理的多模态生成特性:在不同的去噪采样分支下,模型分别合成了不同外观的双手皮肤,但周围物理环境的相对几何关系保持高度恒定。
逆动力学闭环:从生成画面到控制信号
让扩散模型吐出漂亮的视频只是走完了第一公里。对于自动驾驶或机器人而言,漂亮的像素不能直接输入到底盘的执行机构中。为了把视觉转变为行动,Mirror Learning 引入了闭环的第二步:逆动力学模型(Inverse Dynamics Model, IDM)。
在自动驾驶设定下,控制量被标准化为二维向量:转向角(Steering Angle)与纵向加速度(Acceleration)。研究团队构建并训练了一个轻量级的逆动力学模型 $p_\phi(a_{1:T-1} \mid o_{1:T})$。该模型在输入一段连贯的第一人称视频序列后,输出对应时刻的动作高斯分布参数(均值 $\mu_\phi$ 与方差 $\sigma_\phi$),其优化目标为最小化负对数似然:
\[-\log p_\phi(a^{(i)}_{1:T-1}\mid o^{(i)}_{1:T})=\sum_{t=1}^{T-1}\left(\left\lVert\frac{a_{t}^{(i)}-\mu_{\phi}(o_{1:T}^{(i)})_{t}}{2\sigma^{2}_{\phi}(o_{1:T}^{(i)})_{t}}\right\lVert_{2}^{2}+\log\sigma_{\phi}(o_{1:T}^{(i)})_{t}\right)\]至此,完整的镜像学习数据合成闭环得以确立:
-
学习者记录下视野中包含其他智能体的被动观察视频流;
-
利用目标检测与分割算法生成对应示范者的跟踪掩码;
-
将两者输入 MVM,采样生成目标示范者的第一人称伪视频 $\hat{o}^{(j)}_{1:T}$;
-
将伪视频输入 IDM,反推提取出对应的控制轨迹 $\hat{a}^{(i)}_{1:T-1}$。
最终生成的 $(\hat{o}, \hat{a})$ 配对元组被称为“镜像数据”(Mirror Data)。这些数据在格式和语义上与真实车队收集的第一人称遥操作数据完全一致,可以直接注入到任何现成的行为克隆或端到端驾驶模型(例如论文中选用的基于视频世界模型表征的驾驶策略 VaVAM)中进行监督学习。
实验评测:纯镜像数据究竟能达到何种水准?
为了验证 Mirror Learning 的实用价值,作者在 CARLA 模拟器中构建了一套跨越多个独立城镇(Towns)的严格评测基准。CARLA 中的不同城镇在街区布局、建筑风格和车道形态上存在显著差异,且彼此物理隔离,是检验具身策略泛化能力的理想试金石。评估的核心指标采用了自动驾驶领域广泛认可的开环位移误差:$\text{minADE}_5$(未来 5 秒内多模态轨迹预测中的最小平均位移误差,数值越低越好)。
实验首先直面一个最激进的假说:如果完全不给策略提供任何真实的第一人称示范,仅仅依靠第三人称观察合成的镜像数据,能否训练出可用的驾驶策略?
结果给出了肯定的答复。在仅使用镜像数据训练时,下游策略的 $\text{minADE}_5$ 表现出随数据量增加而持续稳步下降的趋势。虽然在相同样本数量下,完全真实的第一人称数据(Ground Truth, GT)因为没有任何生成伪影,依然保持着最佳性能;但当镜像数据扩充到一定规模时,纯镜像策略的轨迹预测精度已经能够追平较小规模真实数据训练出的模型。这证明逆动力学模型成功从扩散模型生成的伪视频中提取到了真实的驾驶物理意图,而不是在噪声中迷失。
随之而来的第二个关键问题是:在真实工业场景中,我们往往已有部分昂贵的实车采集数据,镜像数据能否作为一种高效的数据增强手段?
研究人员将数据集总规模严格控制在约 3.36 万条样本,通过逐步用镜像数据替换部分真实数据来观察策略表现。测试分为两个维度:与训练环境相同的城镇内测试,以及完全未见过的独立测试城镇(Zero-shot Held-out Town)。
测试表明,镜像数据的混入展现出了显著的正向增益。在相同的样本预算下,包含镜像数据的混合训练集在绝大多数配置下均跑出了低于纯真实数据的 $\text{minADE}_5$ 误差。尤其是在零样本泛化到全新城镇的测试中,加入镜像数据的策略表现出更强的鲁棒性。这是因为在多车交互场景中,学习者往往受限于前方车辆的阻挡,而镜像视频本质上让策略网络“提前预习”了前车在遭遇复杂路口、死角转弯时的视觉动态,从而在隐空间内极大丰富了极端场景的状态覆盖率。
第三个实验则切中了具身智能向新地域拓展(Geographic Expansion)的痛点。当自动驾驶系统部署到一个全新的城市时,采集当地数据的成本最高。作者对比了两种数据增强路径:一种是传统的图像风格迁移(Style Transfer),即用生成对抗或扩散模型改变既有数据的纹理;另一种则是利用 Mirror Learning 在新城市中收集前车观察并合成镜像数据。
在分别给入 1000 条和 2000 条新城镇本地真实数据的前提下,按不同比例追加增强数据。实验显示,镜像数据增强的收益全面超越了风格迁移。风格迁移仅仅改变了建筑色调和光影,无法提供新的交互因果信息;而镜像数据在提供新视觉特征的同时,输入了全新的驾驶轨迹因果流,数据倍率越高,策略在未知城镇的表现提升越显著。
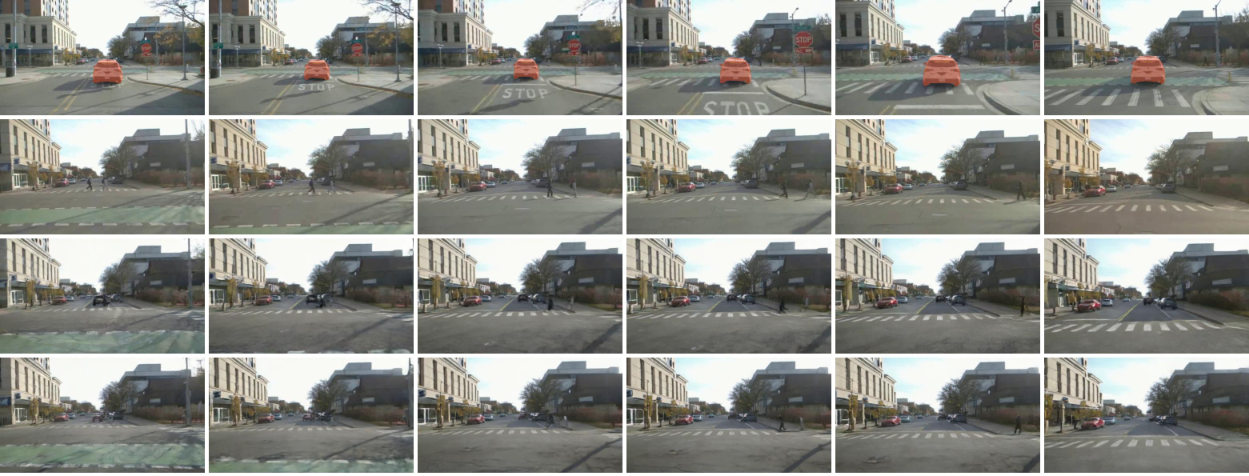
此外,为了排除系统是否只是在 CARLA 模拟器的渲染管线中“投机走捷径”,作者还将训练好的汽车 MVM 模型直接零样本部署在 May Mobility 真实自动驾驶车队的公开数据集上。面对真实的都市道路、复杂的真实路况光学反光和不同于模拟器的传感器畸变,模型依然稳定输出了结构完整的示范车第一人称视频,证实了预训练基础视频模型底层物理先验的跨域迁移韧性。
局限与未来:从“做视频”到“合成行为”
尽管 Mirror Learning 展现出惊人的端到端数据合成潜力,客观审视这项技术,仍能发现它所处的早期技术形态与局限性。
首当其冲的是动作空间的复杂度瓶颈。论文选择自动驾驶作为主要切入点,很大程度上是因为车辆底盘的控制空间相对规整——仅由连续的转向角和纵向加减速两个自由度构成。在这类低维动作空间中,逆动力学模型(IDM)可以通过连续几帧的视觉光流与场景相对运动,相当高置信度地反解出车辆动力学状态。然而,如果将该框架直接搬移到人形机器人或双臂协作场景,问题会急剧复杂化:机械臂末端执行器存在 6 个自由度的位姿变换,手指抓握存在高维欠驱动接触力,单纯依赖视角合成视频,IDM 极易在微小形变和自遮挡处遭遇动作歧义(Action Ambiguity)。
其次是视频生成模型内在的物理幻觉风险。当前的扩散模型虽然在感知层面上逼真,但在毫米级的严格物理因果上依然偶有失误。如果 MVM 在合成示范车前方视角时,错误地抹去了一个原本存在的深坑,或者幻觉出了一条不存在的车道虚线,IDM 推断出的控制量就会被注入隐形噪声。如何为扩散模型引入更强烈的几何几何约束与物理仿真反馈,将是该路线走向严苛安全级应用必须补齐的一环。
但无论如何,Mirror Learning 的深远意义在于它为具身智能的数据飞轮指明了一个完全不同的方向。长久以来,学术界与产业界普遍被困在“没有真机数据就无法训练策略,没有先进策略就无法安全采集数据”的死循环里,不得不依靠巨额资金搭建遥操作团队。而这项工作揭示了一个极具诱惑力的未来图景:视频生成领域取得的世界模型进展,不仅仅可以用来制作逼真的短视频,更可以在潜空间中扮演“视角翻译器”和“具身合成工厂”。
任何行驶在路上的普通车辆、任何在工厂车间巡视的巡检机器人,其原本被废弃的“旁观背景画面”,未来都可以通过镜像模型转化为高质量的第一人称专家级训练集。从“事必躬亲”的物理遥操作,走向“博采众长”的被动观察学习,具身智能可能正迎来属于自己的跨视角缩放定律(Scaling Law)。