CMU揭示AI科研“实现抽签”:换套实现代码,43.6%最佳想法直接反转
One Run Is Not an Idea: The Implementation Lottery in Automated Research
让 AI 自主搞科研已不再是天方夜谭。从提出假设、编写实验代码到跑出基准测试分数,像 The AI Scientist、Agent Laboratory 等自动化科研系统正试图将科研探索闭环全部交给智能体。然而,来自卡耐基梅隆大学(CMU)的一项最新研究泼了一盆冷水:在这类自动化闭环中,一次实验运行的成功或失败,根本无法作为评判该科学想法是否优秀的可靠依据。
ArXiv URL:https://arxiv.org/abs/2607.26587v1
当前几乎所有科研智能体都存在一个结构性偏差:系统用单次运行(One Run)的代码得分,去判定一个宏观机制或科学想法(Idea)的优劣,进而决定后续是顺着该方向继续探索,还是彻底将其剪枝淘汰。然而,一个科学想法在被翻译成可执行代码时,存在大量的自由度——比如超参数设定、验证集划分比例、库函数接口选择等。评测器最终打出的分数,测量的其实是这个想法的“某一次具体实现(Realization/Implementation)”,而非想法本身。如果换一次独立会话让智能体重新写一套代码,原先看似惊艳的想法可能立刻垫底,而原先被淘汰的方向反而可能名列前茅。研究团队将这种核心机制被实现细节随机绑架的现象命名为实现抽签(Implementation Lottery)。
通过严格控制科学想法语义、独立采样多次代码实现,并分离运行重跑噪声,研究团队在 13 项标准任务和两种智能体架构上进行了 312 次实验分配。结果令人震惊:在同一个任务内,由具体实现选择所带来的方差,是纯粹代码重跑方差的 5 到 10 倍以上;在单次运行中脱颖而出的“最优想法”,如果换成其他两次实现的均值去评估,竟然有 25.6% 到 43.6% 的概率直接被反转。这意味着,如果自动化科研系统仅凭一次运行就做决策,将有近半数的研究分支走向完全错误的道路。
从交付工件到评估机制:被混淆的两种目标
理解这项研究的核心,首先要划清一个长期被混淆的界限:系统到底是在寻找一个当下能用的工程工件(Artifact),还是在沉淀可以指导后续探索的科学认知?
如果目标纯粹是交付一个高分程序或模型,那么现行的“最佳 $N$ 选 1”($\text{Best-of-}N$)搜索策略完全有效。智能体针对一个方向尝试 10 种不同的代码实现,挑出在测试集上表现最好的那一份提交,此时系统关心的是得分分布的上尾(Upper Tail),即 $B_{N} = \mathbb{E}[\max_{j \leq N} Z_j$]。这种做法在工程落地中无可厚非。
但自动化科研系统的终极目标不仅是交付代码,而是实现持续的假设演化——它需要知道“这个机制是否真的有效”。当系统将单次实现的高分当作该机制成立的证据,并把这个结论写入研究记忆、指导下一轮假设生成时,灾难就发生了。此时我们关心的不再是上尾极值,而是该想法在所有合理实现下的平均表现期望 $Q$。
假设一个科研智能体提出了“在梯度提升树训练中引入早停机制(Early Stopping)”。这个科学机制规定了验证集划分、停止规则以及保存最优迭代。但在具体落地时,一个合理的实现仍然必须决定:验证集比例是取 10% 还是 20%?耐心轮数(Patience)设为 5 还是 10?监控指标用 LogLoss 还是 AUC?调用哪个库的 API?一个高分可能纯粹是因为这次实现碰巧选对了超参数,而不是早停机制本身带来了本质飞跃;反过来,一个极具潜力的想法也可能因为智能体写了一段欠佳的胶水代码而被误杀。单次运行的分数 $Z$ 被直接赋予给母体机制,正是“实现抽签”的根源。
为了形式化这一问题,研究者将一次实验观测到的效用 $Y_{siejk}$ 进行了方差分解:
\[Y_{siejk} = \mu_{e} + A_{se} + I_{sie} + M_{siej} + R_{siejk}\]其中 $\mu_e$ 为评测环境均值,$A_{se}$ 为任务效应,$I_{sie}$ 为科学想法自身的真实效应,$M_{siej}$ 为针对该想法的某次具体实现所带来的偏差,而 $R_{siejk}$ 则是代码固定后的纯重跑噪声(如随机种子波动)。自动化科研系统必须评估的是“想法可靠性(Idea Reliability)”,即在消除环境与重跑扰动后,想法本身方差占总波动比例的组内相关系数($\text{ICC}_{\text{idea}}$):
\[\mathrm{ICC}_{\mathrm{idea}} = \frac{\sigma_{I}^{2}}{\sigma_{I}^{2} + \sigma_{M}^{2} + \sigma_{R}^{2}}\]如果 $\sigma_M^2$ 极大,$\text{ICC}$ 就会断崖式下跌,说明实验分数的绝大部分波动都来自实现层面的运气,而非机制本身的优劣。
想法可靠性审计:如何把想法与实现彻底剥离?
以往关于智能体鲁棒性的研究,通常是重复输入同一个任务或同一个 Prompt,观察输出代码的波动。但 CMU 团队做了一件前人从未做过的事:保持机制级想法在语义上严格冻结,独立重复采样其代码实现,并分离后续的代码重跑噪声。为此,他们设计了“想法可靠性审计(Idea Reliability Audit)”流程。
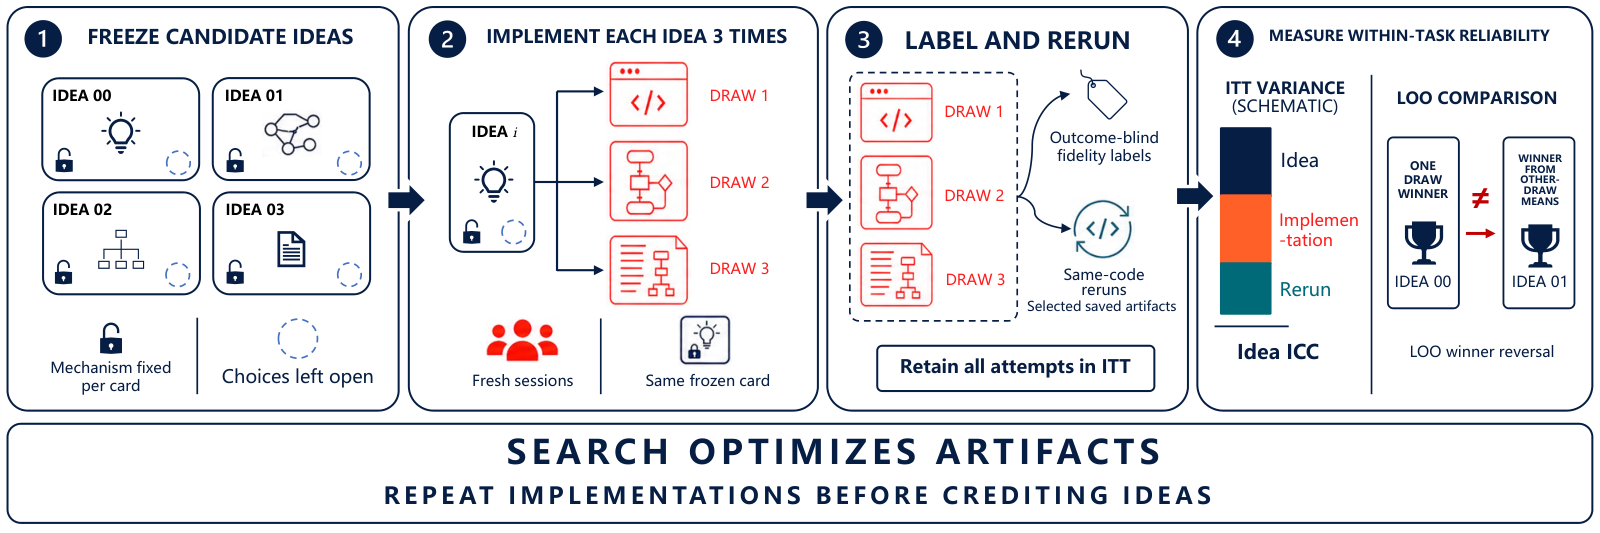
该审计流程包含四个极为严密的隔离环节:
第一,冻结机制级“想法卡片(Idea Cards)”。为了避免智能体因提示词含糊不清而自由发挥,研究者将想法固化为机制卡片。卡片必须明确记录:核心科学干预机制、必须满足的属性、允许留白自行决定的实现自由度、预期结果及反事实证据。但严禁出现任何代码行、固定超参数数值或特定构造函数——因为一旦把这些细节写死,它就退化成了一套固定菜谱(Recipe),失去了作为“抽象想法”的评估价值。在进入实现阶段前,卡片还要经历严格的无结果盲审(Outcome-blind Gate),剔除与 Baseline 语义重复、逻辑矛盾或无实际干预的无效卡片。
第二,完全独立的会话实现与盲审保真度标注。每个被批准的想法卡片,会被分发给全新初始化的独立会话环境,让模型写出 3 套互不相通的补丁代码(Patch)。为了防止模型阳奉阴违或跑题,研究引入了独立的大模型评审员对补丁进行无结果盲审,比对代码 Diff 是否忠实执行了卡片机制,同时注入控制组(如将 A 想法的代码安在 B 想法上,或使用空代码补丁)来标定评审员识别漂移(Drift)和无效实现的能力。
第三,保存工件并严格重跑,解耦实现方差与代码噪声。每一份成功生成且可运行的代码补丁,都会被原样保存下来,在完全一致的计算环境下使用 3 个固定随机种子重复运行 3 次。通过这种设计,相同代码多次运行的方差即为纯粹的系统重跑方差 $\sigma_R^2$;而同一想法卡片下 3 份独立代码补丁表现的差异,扣除重跑方差后,就精准剥离出了实现选择方差 $\sigma_M^2$。
第四,意向性分析(ITT)与留一(LOO)优胜反转率。为了真实反映一个想法在工程化落地时的潜在代价,审计采用严格的意向治疗(Intention-to-Treat, ITT)原则:哪怕某次实现因编译报错或严重偏离卡片机制而失败,也不能直接从样本中删去,而是施加预设惩罚后全量计入。最后,系统计算留一实现优胜反转率(Leave-One-Implementation-Out Reversal):对于给定的候选想法集合,如果依靠某一次实现抽样选出的最佳想法,在参考另外两次实现的平均得分时不再是第一名,即判定为优胜反转。
惊人数据:实现差异远超随机噪声,近半数最优结论被颠覆
研究人员在涵盖金融、生物、工程等领域的 13 个公开 OpenML 分类基准任务上进行了主审计,涵盖二分类到十分类、数百至数千行数据。所有任务统一采用带有严格约束的梯度提升树分类器(HistGradientBoostingClassifier)作为基线,以避免无上限的算力堆叠。
在实现智能体方面,评测对比了两种不同受控程度的配置:一种是 Bounded,限制最多 4 次模型调用、少量代码检查和固定 Token 预算;另一种是 Agentic,基于无外部修复介入的 SDK 交互会话,最大轮数可达 20 轮。卡片生成与代码编写均由 DeepSeek v4 Pro 承担,保真度评审则由 DeepSeek v4 Flash 配合抽检完成。
实验结果给出了清晰的方差分布:
在去除任务本身的背景方差后,在 Bounded 设置下,想法机制本身解释了 61% 的方差,实现选择方差占 33%,而代码重跑方差仅占 6%;而在交互自由度更高的 Agentic 设置下,实现选择方差进一步暴增至 45%,甚至逼近了想法机制本身所贡献的方差(51%),代码重跑方差则仅占 4%。
在两个设置中,由代码实现带来的波动幅度,分别是单纯重跑随机噪声的 5 倍和 10 倍以上。具体到数值标准差上,在相对准确率提升指标中,重跑标准差仅为 0.0087 左右,而实现的波动标准差高达 0.0202 至 0.0295。
这种剧烈波动直接瓦解了决策的稳定性。当模拟自动化科研系统“选出当前任务最优想法”时,Bounded 设置下的留一优胜反转率达到了 25.6%,而 Agentic 设置下的反转率更是飙升到了 43.6%。也就是说,系统在某一次运行中挑选出的所谓“突破性机制”,换个会话让同一个模型再写一遍代码,有四成以上的概率它根本不是最好的,甚至是拖累性能的劣解。
为了验证这一结论是否仅局限于表格机器学习任务,作者还在材料科学回归任务(基于成分预测钢材屈服强度、实验带隙,以及基于晶体结构预测声子频率)上展开了探索性实验。由于材料评测采用完全确定性的评估函数,代码重跑方差被强制归零($\sigma_R^2 = 0$)。即便在这个绝对没有测试噪声的物理领域中,实现方差依然霸占了全部干扰源:Bounded 和 Agentic 下的实现方差占比分别达到 71% 和 82%,优胜反转率同样高达 33.3% 和 55.6%。只要从机制到代码的翻译过程存在自由度,“实现抽签”就会如影随形。
一个典型微观样本:同一机制,从 +2.31% 到 -1.85%
宏观统计可能稍显抽象,论文中展示的一个具体任务案例生动展现了这一荒诞现象。
在 OpenML 任务 146822 中,智能体生成并冻结了一张关于“特征交互构建”的想法卡片(标记为 I02)。这张卡片完全合规,不涉及偷跑或违规操作,要求模型基于领域先验构建特定的交互特征以增强特征表征。在盲审评估中,模型在三个完全独立的会话中写出的 3 份补丁代码全部被判定为完全忠实于原始机制(Faithful),且都能完美编译执行。
这 3 份实现的原样代码在 3 个不同随机种子下重跑时,每一次重跑的得分都严丝合缝、完全一致,重跑方差为 0。然而,这 3 份同样忠于原意的实现,最终带来的相对性能提升却天差地别:
第一份实现斩获了 +2.31% 的优异提升;第二份实现仅获得了 +0.46% 的微弱增长;而第三份实现却跑出了 -1.85% 的负优化。不仅指标迥异,这 3 个可执行代码在测试集上的预测向量甚至在高达 4.76% 的样本上给出了截然相反的预测标签。
如果这个系统同时在和另一个性能极为平稳的机制 I00(得分稳定在 +0.46%)进行竞争:
-
如果抽签碰巧抽中了第一份实现,系统会大肆庆祝 I02 机制的巨大胜利,并将其确立为核心范式;
-
如果抽中了第二份实现,两两打平;
-
如果抽中了第三份实现,系统会毫不犹豫地认定“特征交互在这个数据集上彻底行不通”,并将该分支永久剪枝。
针对同一个科学想法,仅仅是因为智能体在编写代码时选择的特征缩放方式或处理次序略有差异,系统就能得出完全相反的科学推断。这种由单次运行建立起的因果信念,在统计学上是极其脆弱且失真的。
区分工件搜索与科学探索:对未来 Agent 的关键启示
这项工作不仅是对当前自动化科研狂热的一次理性纠偏,更为下一代科研智能体架构的设计指明了边界与改进方向。
首先,必须将“代码工件交付”与“机制假设筛选”彻底解耦。如果一个智能体平台的目标是打 Kaggle 比赛或完成具体算法工程交付,基于单次得分的贪婪搜索或 $\text{Best-of-}N$ 过滤没有任何问题,只要最终提交的代码在保留验证集上表现出色即可。但如果平台的定位是“科学家”,旨在自动探索未知规律、提炼跨领域可迁移的先验知识,那么就必须警惕单次高分带来的幸存者偏差。在将一个机制提升为系统长期记忆、或者用于论证某类科学假说成立之前,必须针对该机制采样多次独立代码实现。
其次,晋级检查点(Promotion Checkpoints)的经济学设计。要求科研系统对每一个微小的想法都采样多套实现显然是不切实际的,这会带来成倍的 Token 与计算开销。本文提出的务实建议是采用分层验证:在树搜索的初期粗筛阶段,可以允许依靠单次运行做快速探索;但当某个分支即将被提升为“核心发现”、获得大量后续计算预算倾斜,或者要被总结进学术报告时,系统必须强制触发可靠性审计,验证该分支的优胜地位是否能在多次实现重写中保持稳定。
自动化科研的蓝图宏大而诱人,但科学探索的本质是求真。单次跑通代码所获得的数字,充其量只是在代码空间中投掷骰子得到的一个幸运点位,它不等于一个经得起推敲的科学想法。正视并测量“实现抽签”,让实验证据的颗粒度真正配得上科学假设的高度,是 AI 从“写代码的打工人”迈向“真正科学家”的必经之路。