不是真反思,而是带条件的二次采样:大模型自我修正为何屡屡失效?
Reflection or Re-Generation? Why LLM Revision Fails Where Human Revision Succeeds
给大模型一段自己的输出,并在提示词里加上“请仔细审查并修改你的回答”,模型真的能像人类一样发现盲点并纠正错误吗?
ArXiv URL:https://arxiv.org/abs/2607.28908
在许多复杂的 Agent 工作流和 Prompt 设计中,“自我反思”(Self-Reflection)几乎被当成了提升模型准确率的标配技巧。很多系统设计者默认,让大模型多走一轮甚至多轮“思考-批判-修改”的闭环,性能总归能有些许提升。然而,由外部缺乏反馈闭环驱动的“反思”往往很不稳定,在某些任务上甚至越改越错。
针对这一长期争议,一项名为 HRF(Human–LLM Reflection Framework)的最新研究对“大模型反思”机制进行了深度诊断。这项研究设计了一个极其严格的双轮对比测试协议,在完全一致的输入与提示条件下,将非专家人类的修正过程与包括 Llama-3.1-405B、Claude-3.5-Sonnet、Mistral-Large、GPT-4o 以及推理模型 DeepSeek-R1 等主流先进模型进行了详尽比对。
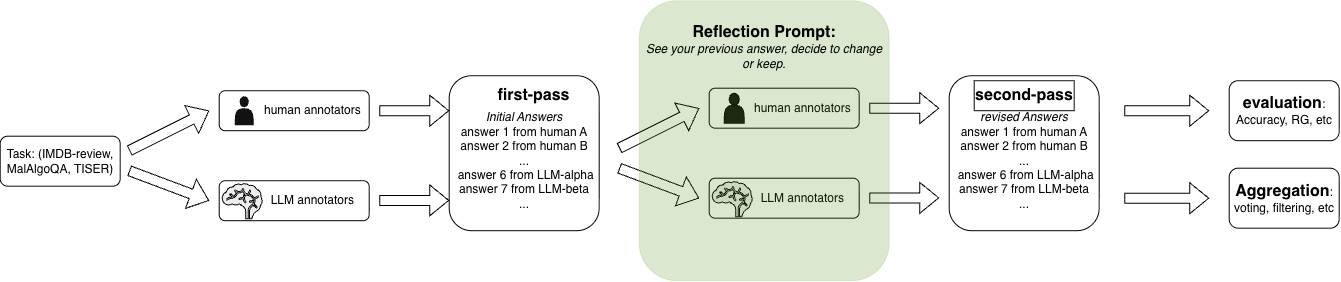
该论文得出的核心结论相当尖锐:从信息论视角来看,大模型在没有外部反馈条件下的“反思”,根本不是人类认知意义上的真反思,而只是以自身第一轮输出为条件的“二次采样”(Conditioned Re-Generation)。
严格对照下的认知分流:人类在提升,模型在空转甚至退步
为了真正剥离其他干扰因素,研究团队构建了 HRF 双轮协议。在第一轮中,模型或人类仅根据原始任务输入给出初代答案;在第二轮中,研究者将第一轮的回答连同任务一同呈现,要求其决定是“维持原状”还是“修正答案”。整个过程没有任何额外的参考答案或外部反馈注入。
测试覆盖了三类典型任务:具备严格数学逻辑的 4 选 1 客观题 MalAlgoQA、具有 1 到 10 档评级的影评情感评分任务 IMDb-Rating,以及涉及长程逻辑约束的时序推理基准 TISER。
实验结果呈现出强烈的对照。人类批注者在三类任务中均展现出稳定的正向修正收益:在主观评分任务上获得 $+17.8\%$ 的收益提升,在数学推理上提升 $+6.0\%$,在时序推理上提升 $+4.7\%$。人类的修正动作非常克制,改动频率远低于大模型,但一旦决定修改,绝大多数改动都带来了正向纠错。
大模型却完全是另一番景象。在客观推理任务上,所有模型的第二轮修正收益几乎全部在 $0\%$ 附近徘徊,即便是推理能力极强的 DeepSeek-R1,在数学任务上的反思收益也仅为 $+0.6\%$,在时序推理上甚至出现了 $-3.0\%$ 的倒退。
更剧烈的崩塌发生在主观评估任务(IMDb-Rating)上。所有被测模型在进行“反思”后,答案全线劣化,预测误差显著扩大。例如 Claude-3.5-Sonnet 的表现下降了 $-29.2\%$,Mistral-Large 下降了 $-5.1\%$。模型表现最好、最贴近真实标注的时刻,恰恰是它们未经反思的第一轮直觉输出。
两种失效模式:从“中性采样”到“向先验均值坍缩”
为什么大模型会在客观推理与主观评估上表现出完全不同的修正动态?论文通过条件互信息与交叉熵减幅($\Delta I$),对模型每轮修正带来的“信息增益”进行了度量。
\[\Delta I^{(k)}=I(y^{*};\,\hat{y}^{(k)}\mid x,\,\hat{y}^{(k-1)})\]如果一个反思机制有效,它应该在每一轮降低模型相对于真实目标答案 $y^*$ 的条件不确定性,即获得 $\Delta I > 0$。
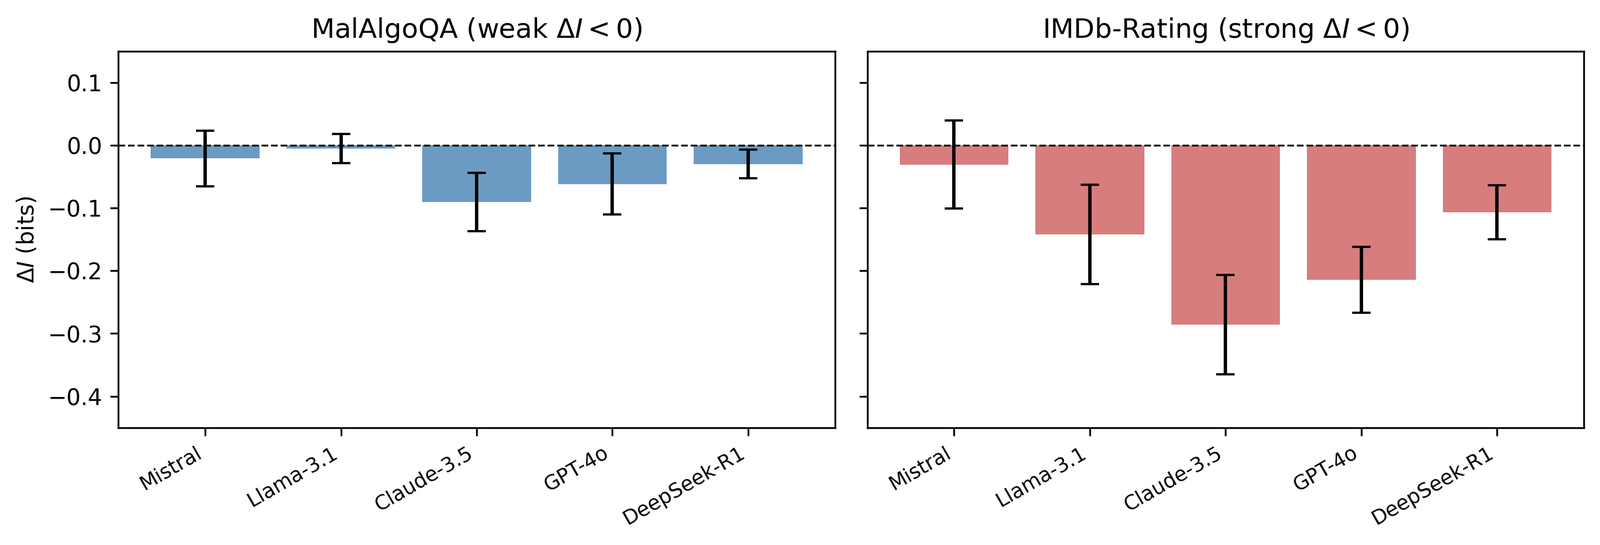
从测量结果来看,大模型的反思暴露了两种互不相同但内在归一的失效模式。
在以 MalAlgoQA 为代表的客观任务中,所有模型的信息增益 $\Delta I \approx 0$。模型把第一轮给出的错误答案带入上下文进行第二轮计算时,没有引入关于正确答案 $y^*$ 的任何新信息。统计学假设检验(配对 $t$ 检验)表明,大模型所谓的自我修正,在数学分布上与不看前轮答案、直接进行一次“随机独立重新采样”没有任何统计学差异。它不是在辨析逻辑,而只是在候选解空间里掷了第二次骰子。
而在主观评估任务(IMDb-Rating)中,信息增益彻底变成显著的负值($\Delta I < 0$)。当模型被要求“再看一眼自己的评分并修正”时,由于缺乏可供严格反证的硬逻辑约束,提示词中的反思请求反而诱发了注意力与概率分布的退化。模型第二轮的输出系统性地漂移回其内部无条件的平庸先验(Distributional Flattening)。第一轮输出原本捕捉到的细微情感极性特征被抹平,预测结果强行缩回更中庸的平均区间,导致与真实评分差距拉大。
瓶颈究竟在输入还是在修正机制?
有人可能会猜测,模型改不好是不是因为第一轮生成的草稿质量太差?
HRF 框架设计了跨主体交换修正(Cross-Agent Matrix)实验:让大模型去修改其他模型或人类生成的草稿,反之亦然。
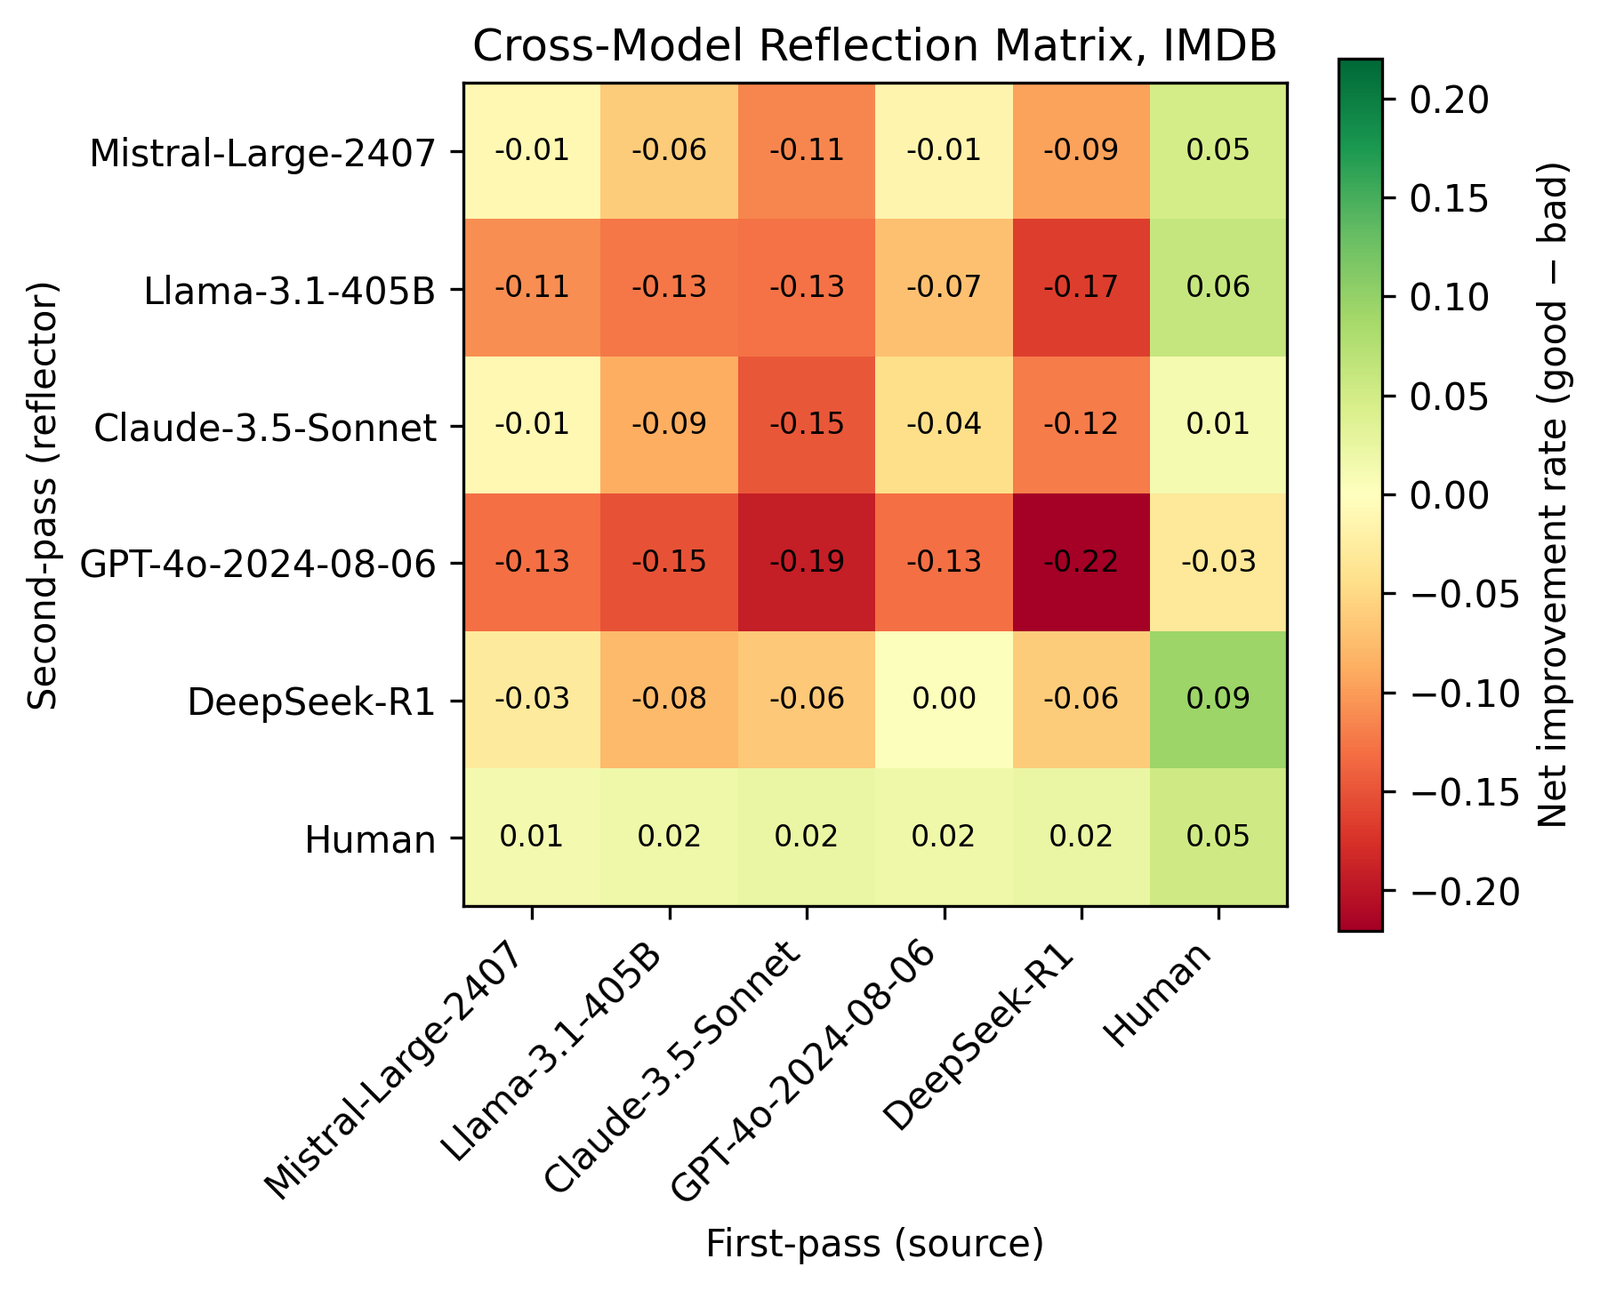
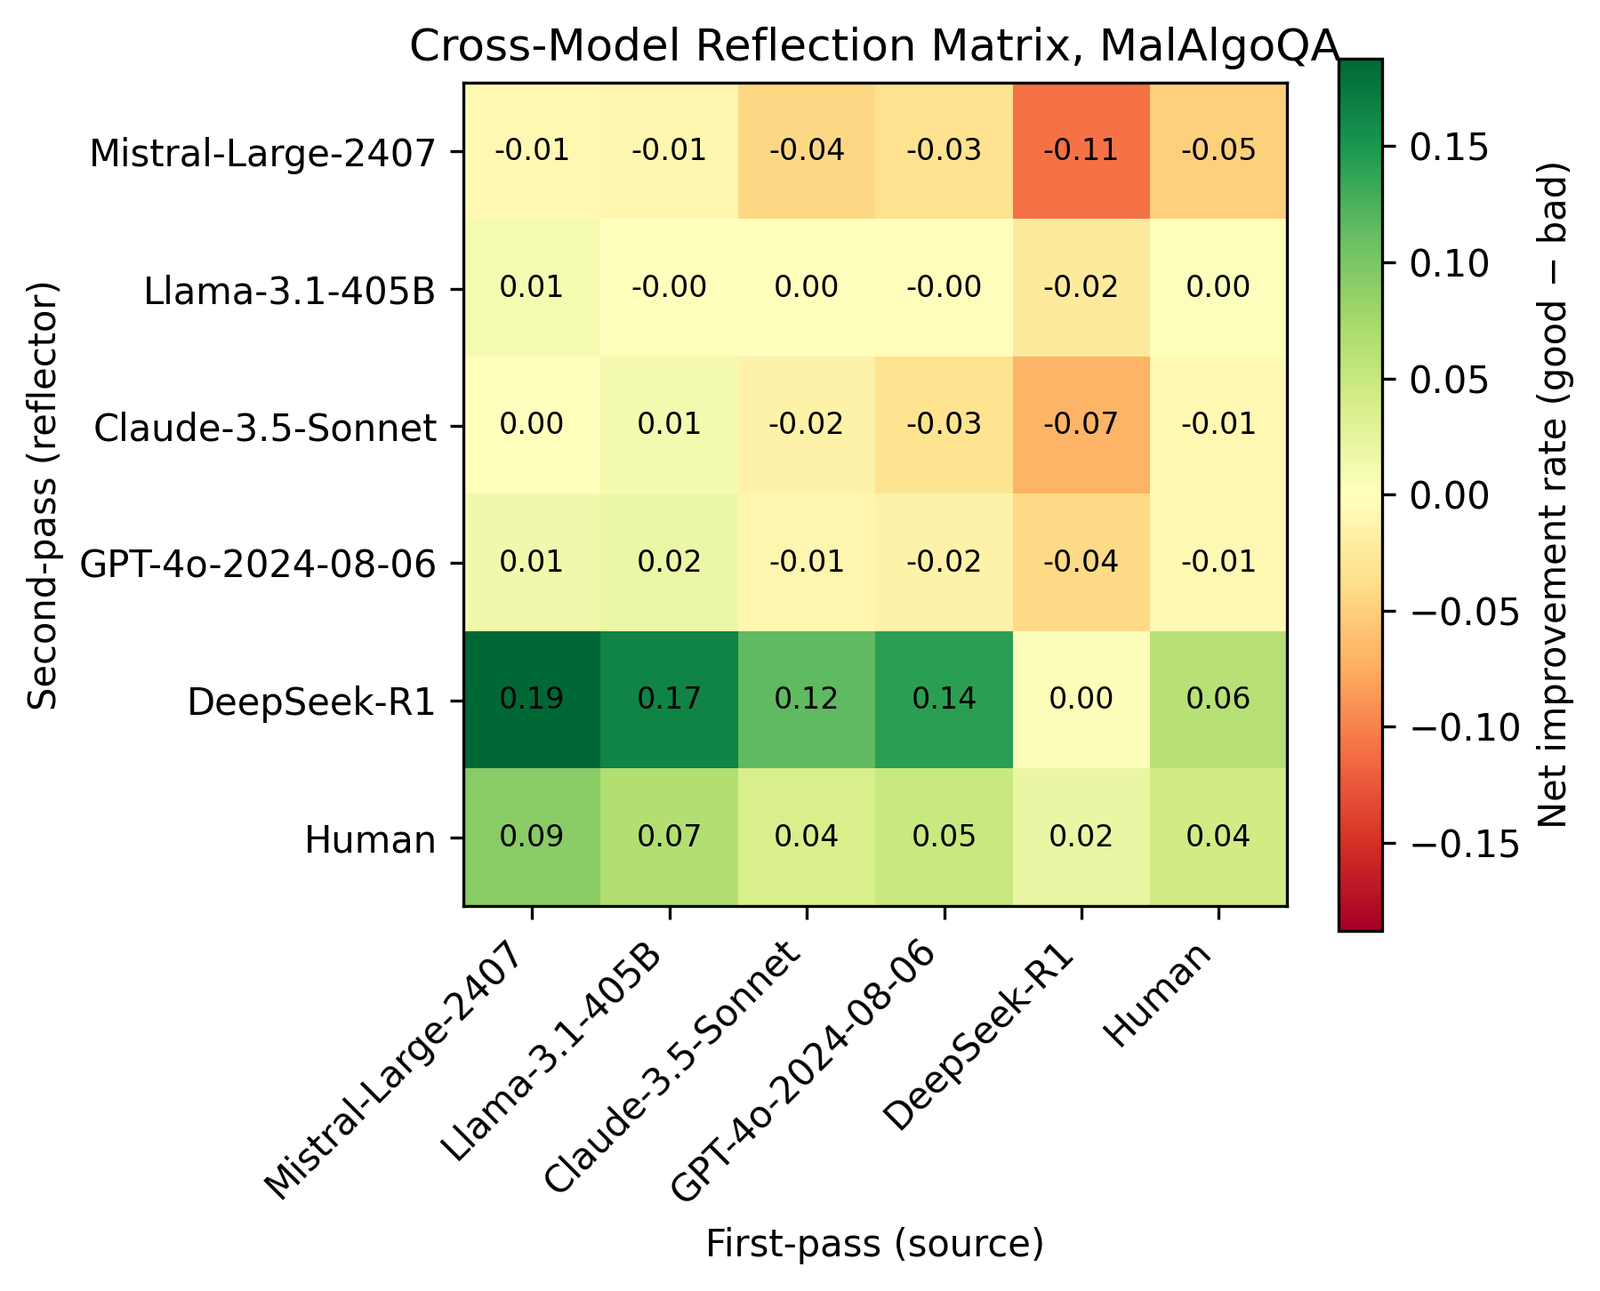
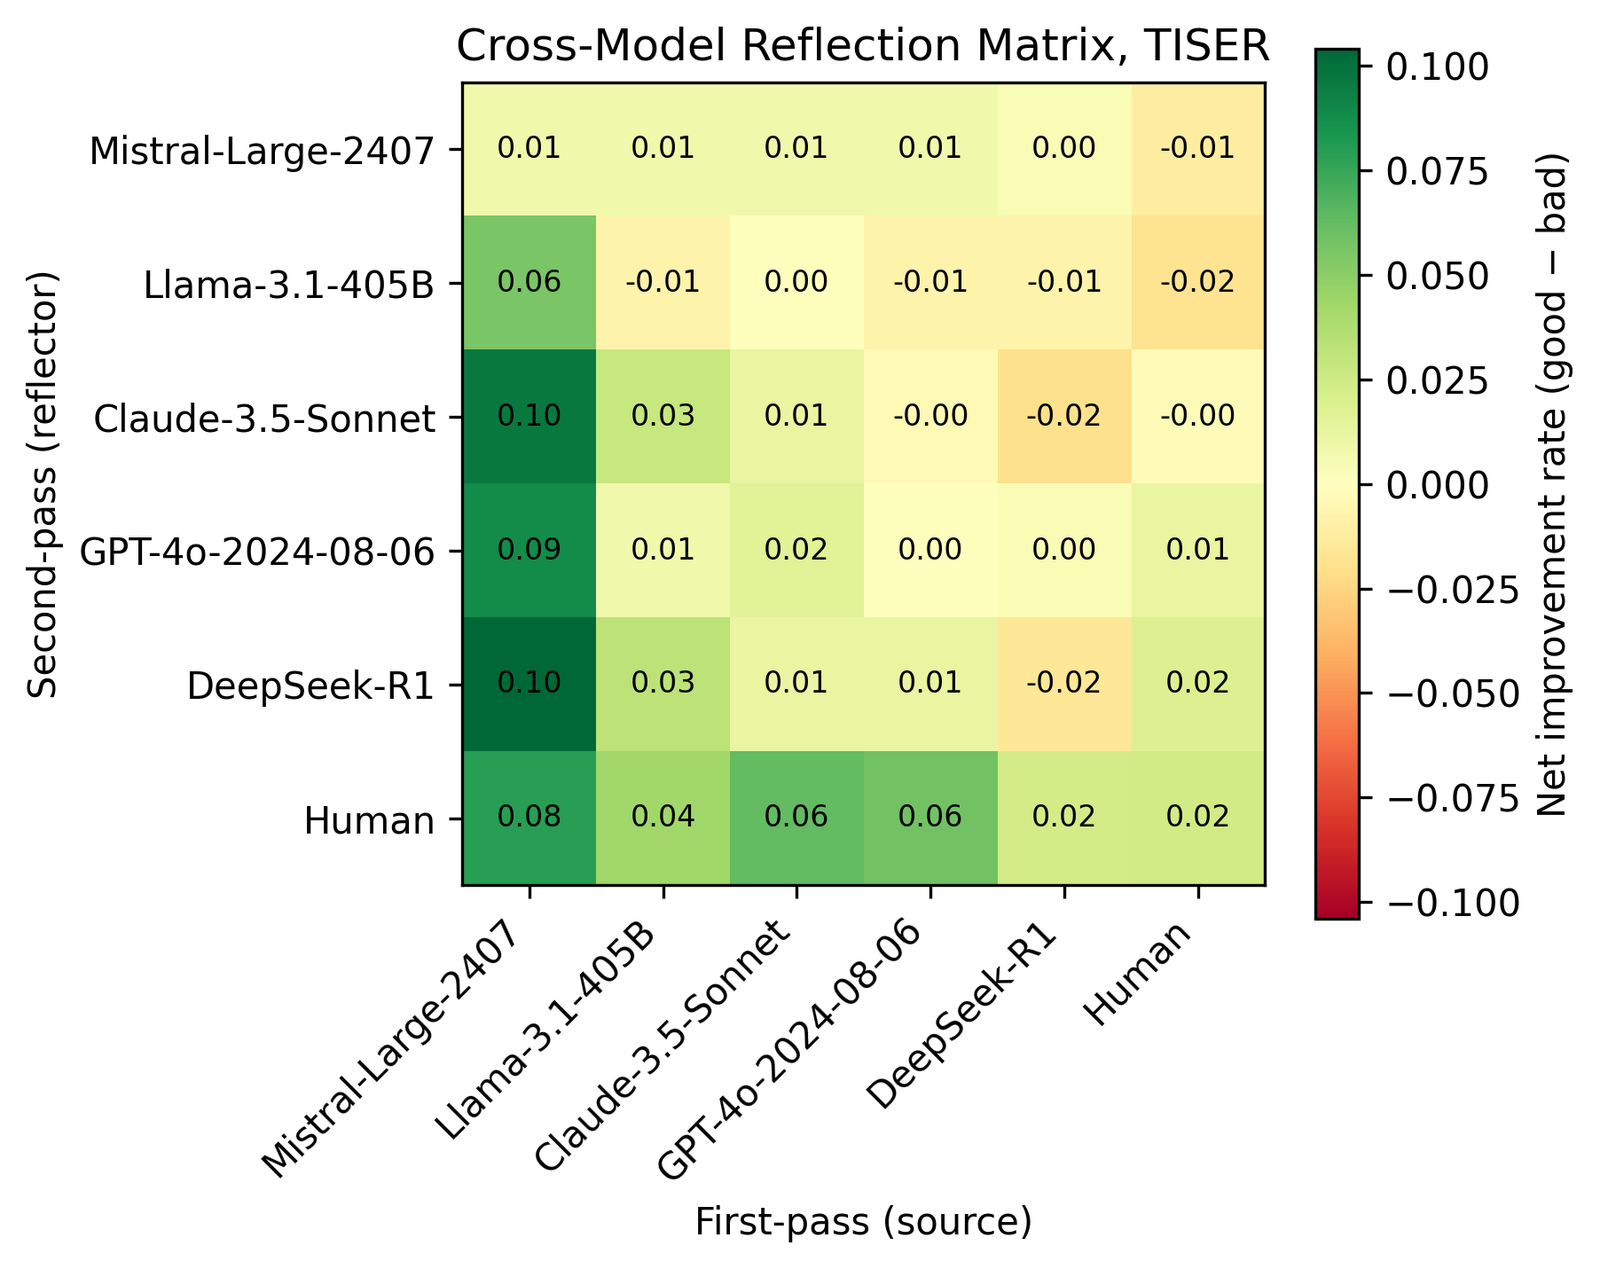
矩阵实验彻底击碎了“输入质量差”的假设。当把人类产出的高质量第一轮答案交给大模型去“反思修改”时,大模型不仅没能锦上添花,反而系统性地把人类答对的题改错了,把高水准答案拉低到模型自身的平均基线。相反,无论给人类输入哪种模型生成的瑕疵草稿,人类都能稳定地提升最终输出质量。
这证明问题完全出在修正机制本身。认知心理学中,元认知调节(Metacognition)包含两个独立阶段:
-
错误检出(Error Detection):意识到当前回答存在缺陷;
-
错误纠正(Error Correction):搜寻正确路径并产出正确替代方案。
针对这两个阶段的诊断实验揭示了一个复杂的异质性现象。在客观选择题上,模型其实具备相当敏感的“察觉能力”——模型对首轮错误答案发起修改的概率,是修改正确答案概率的 3 到 21 倍,表明模型并非完全“盲目”。然而,模型虽然能察觉哪里不对,却拿不出正确的替代解,最终在备选空间里胡乱抓取。
而当研究人员引入“预言机”(Oracle)直接告诉模型“你的第一轮答案是否正确”以剥离检出干扰时,不同模型的表现进一步分化:只有最顶级的大模型能在确定得知答案错误后修正得优于随机洗牌,中轻量模型在得知首轮答错后,即便重选依然弱于基线。在主观任务上,大模型则在检出阶段就已失效,对自己的对错毫无感知比率差。
为什么自我条件化无法带来“真知识”?
从信息论与统计学习的本质来看,大模型在无外部监督下的反思,其瓶颈是结构性的。
在封闭无交互的提示工程里,第二轮自反思过程严格依赖于任务上下文 $x$ 以及第一轮输出 $\hat{y}^{(1)}$。如果一个系统内部已经根据模型参数对 $P(y \mid x)$ 完成了一次最高概率密度的推断或合理采样,那么在不注入任何外部验证器、代码编译器执行结果、检索知识库或环境反馈的情况下,单纯将自身生成的 $\hat{y}^{(1)}$ 重新作为 Prompt 的一部分喂回输入端,系统的总信息量并没有增加。
正如论文所论证的那样,在数学上:
\[H(Y \mid x, \hat{y}^{(1)}) \ge H(Y \mid x, \text{External Signal})\]自我条件化无法凭空缩减关于真实目标分布的不确定性。人类之所以能完成有效的反思,是因为人类大脑具备分层的元认知监控网络,可以在反思阶段调用不同于前向直觉的更高阶认知策略或隐性规则;而现有的自回归语言模型,不论在第几轮,本质上依然是以静态权重在上下文空间中计算条件分布的同一个生成器。
这项研究对目前主流的复合 AI 系统设计提出了几项非常关键的工程警示:
-
警惕“纯文本自反思”的算力浪费:在没有外部反馈(如代码报错、测试用例、环境状态或知识库断言)的情况下,单凭 Prompt 要求模型反复“自我批评”并不能带来真实的逻辑纠错,在客观任务上它等价于重抽样,在多轮迭代中收益迅速归零;
-
在主观评分与复杂对齐任务中慎用反思:让模型重新审视主观打分或柔性语义判定,极易诱发均值回归与分布扁平化,不仅不会提高精准度,反而会破坏第一轮推理已经捕捉到的锐利特征;
-
将算力倾斜给“外部验证”而非“自言自语”:相比于增加 Agent 内部的思考反思轮数,更有效的方向是为模型配备独立的检测模块、异构判别器或环境沙盒,用结构化的外部信源来打破自回归生成的闭环信息茧房。