RRM:不记过往事实只学检索策略,长视频多模态推理最高涨点9.1%
RRM: Experience-Driven Reflective Retrieval Memory for Long-Horizon Multimodal Reasoning
在面对长达数小时的长视频或持续不断的机器人具身感知流时,即便是拥有百万级上下文窗口的多模态大模型(MLLM),也常常陷入“看得见却找不着”的困境。为了克服上下文容量与冗余信息的矛盾,近年的研究普遍引入外部长期记忆(Long-Term Memory),把视频流切解成事件并构建成图谱或向量数据库。
ArXiv URL:https://arxiv.org/abs/2607.28156
然而,现存的记忆 Agent 几乎都在解决“存什么”的问题——如何建图、如何抽事实、如何压缩视频帧。一旦模型发出的检索 Query 出现偏差,或者在大型记忆图谱里连续兜圈子、拿不到关键证据,现有系统往往束手无策。这类系统缺乏一种在过往失败中自我诊断、在后续任务中动态调整“检索策略”的机制。
针对这一症结,最新提出的 RRM(Reflective Retrieval Memory,反思检索记忆) 框架给出了破局思路。研究团队敏锐地捕捉到了长视频记忆系统的核心盲区:模型跨任务真正需要复用的,不是“上一段视频里发生了什么”,而是“为了找到某类证据应该如何去检索”的过程性程序知识(Procedural Knowledge)。
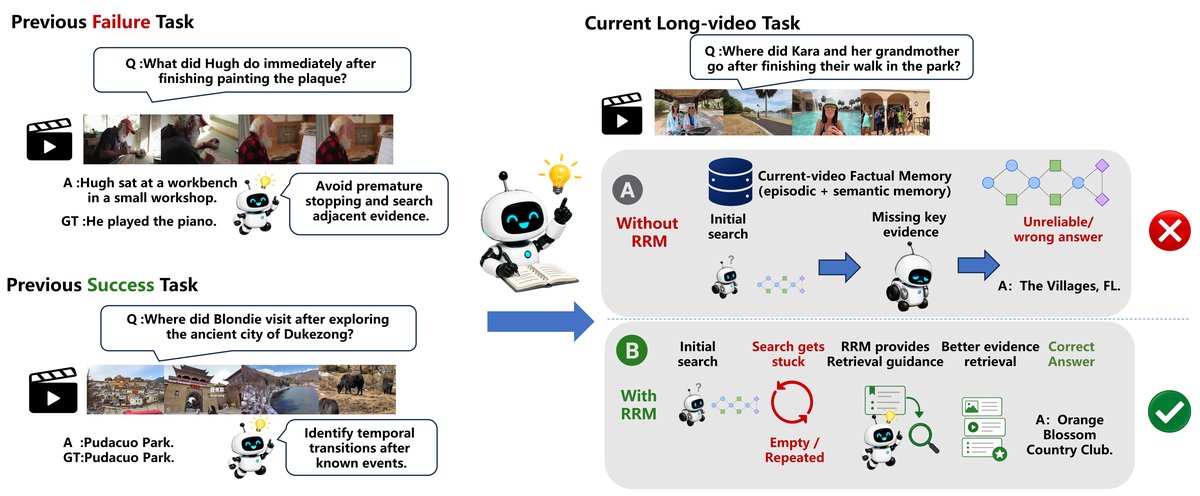
RRM 构筑了事实记忆与经验记忆的分离机制:历史任务中提炼出的反思经验,仅作为控制信号用于优化当前检索 Query,绝不直接喂进最终的回答生成上下文。这种“只指导检索动作、不污染事实推理”的设计,使 RRM 在 M3-Bench-Robot、M3-Bench-Web 和 Video-MME-Long 三大长视频推理基准上,相对强基线分别取得了 9.1、5.8 和 7.4 个百分点的显著提升,同时大幅降低了检索轮数。
核心痛点:长视频记忆里的“事实污染”与“盲目重试”
长视频多模态推理面临的根本障碍在于证据的极端稀疏与高度分散。例如一段家庭机器人的全天视角视频,关键动作往往只发生几秒钟。当 Agent 遇到复杂问题(如“某人离开古城后去了哪里”)时,通常会通过控制器(Controller)发起多轮“检索-回答(Search-Answer)”循环。
如果检索失败,现有的语言 Agent 通常会借助 Reflexion 等框架从错误中生成文本反思(Verbal Reflection)。但在长视频多模态场景下,直接沿用这一思路会引发灾难性的“事实污染”(Fact Contamination):
当模型把上一次任务的完整轨迹直接放进 Prompt 时,轨迹中充斥着具体的实体、地点和剧情(比如上一次任务提到的具体景点名称)。大模型极易被这些前序视频的实体误导,在分析当前视频时产生严重幻觉,甚至试图用旧视频里的事实来回答当前视频的问题。
另一方面,从过去的成功或失败中,究竟什么才是具备跨任务迁移价值的信息?显然不是“上个视频里的主角叫什么”,而是“当面临跨时间地点的状态转移问题时,应先锚定已知起始事件,再在时间轴后方切片寻找转移线索”这类元认知层面的检索战术。
如果不能把“检索过程”与“陈述性事实”在机制层面彻底解耦,引入历史经验往往弊大于利。RRM 的提出,正是为了建立一套既能让 Agent “越搜越精明”,又坚决避免事实记忆混淆的长程记忆检索体系。
三层记忆架构:程序性经验与事实证据的物理隔离
为了实现这种解耦,RRM 在基线模型 M3-Agent 的基础上,重构了一套清晰的三层记忆架构。
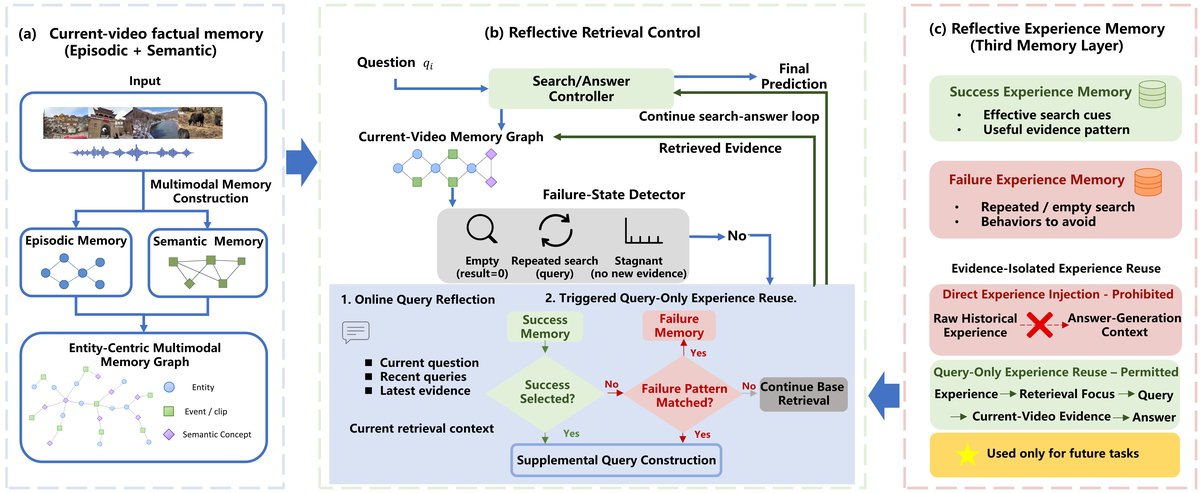
整体架构如图 2 所示,自左至右由三大部分协同驱动:
-
当前视频事实记忆(Current-Video Factual Memory):这是专属于当前处理视频的陈述性记忆,包含两层结构:以时间定位视频片段、音频及事件为核心的“情景记忆(Episodic Memory)”,以及抽离出高层实体属性与关联的“语义记忆(Semantic Memory)”。二者共同交织为当前视频的以实体为中心的多模态记忆图谱 $\mathcal{G}_i$。这个图谱完全是客观事实的容器,不包含任何跨视频的先验。
-
反思经验记忆(Reflective Experience Memory):这是独立于当前视频的全局第三层记忆。它不记录具体人名、地名或答案,而是从已完成任务的轨迹与反馈中,蒸馏提炼出抽象的检索模式:特定类型问题需要什么证据支持、什么 Query 模式更高效、遭遇什么失败应该如何纠错。
-
反思检索控制器(Reflective Retrieval Control):充当事实记忆与经验记忆之间的隔离阀门。控制器负责根据任务状态调用经验,但这些经验被严格约束为 Query 级的控制信号,绝不流入最终的答案生成环节。
这种架构设计在根本上切断了跨任务幻觉的链路。回答生成器(Answer Generator)在最终下结论时,眼前的输入只有由优化后的 Query 从当前视频事实图谱中刚刚打捞出来的客观证据,历史反思经验在完成引导检索的使命后便功成身退。
双轨反思与检索干预:从单任务自纠到跨任务借鉴
在检索执行层面,RRM 并不是盲目地在每一轮检索都去调用历史经验,而是设计了灵敏的状态监控与渐进式的反思干预链条。
1. 单任务内的在线查询反思(Online Query Reflection, OQR)
在一个具体的任务推理过程中,检索往往包含多轮循环。RRM 的规则状态检测器(Failure-State Detector)会持续盯紧检索状态。一旦发现以下三种异常,便会立刻激活局部修复:
-
最新的 Query 返回了空结果(没有击中有效证据);
-
连续多次发出的 Query 语义高度雷同,模型陷入复读机式的无效试探;
-
连续进行了数轮检索,图谱始终无法提供增量证据。
触发异常后,系统首先执行在线查询反思(OQR)。该模块不需要调取历史跨任务经验,仅仅站在当前任务的局部视角,重新审视初始问题、已发出的查询历史和已拿到的碎片证据,迅速生成一个中立的修复查询 $\widetilde{x}_{i,t}$。这相当于让 Agent 在“钻牛角尖”时先深呼吸一下,用替代性的提问方式打破僵局。
2. 跨任务的异常触发经验复用(Triggered Query-Only Experience Reuse)
如果单任务内的局部微调依然受阻,或者异常信号较为严重,RRM 便会叩响反思经验记忆库的大门。
值得注意的是,RRM 对待“成功经验”和“失败经验”采取了非对称的严苛策略。在经验库中,成功轨迹提炼的经验集 $\mathcal{M}^+$ 与失败轨迹提炼的经验集 $\mathcal{M}^-$ 是严格分立的:
-
成功经验因为经过了正确结果的验证,具备直接的正向参考价值,只要适用场景(问题类型、证据需求)匹配,便会被优先选用。
-
失败经验则只是一种“诊断假说”——历史任务失败了,记录的是“当时的错误 Query 模式与纠偏建议”,这些假设并不天然具备普适性。因此,RRM 规定:只有在没有可用的成功经验、且当前发生的检索异常特征与失败记录中的诊断条件高度契合时,系统才会谨慎采纳失败经验中的纠偏策略。
最关键的步骤在于经验的控制化转换。被选中的历史经验会被“经验选择器”剥离一切可能残留的具体情境,重塑为一个中立的“检索焦点指示(Retrieval Focus)”,再与 OQR 的修复查询结合,生成下一轮针对当前图谱的全新 Query:
\[\mathcal{C}_{i,t}^{\mathrm{ref}}=\operatorname{Dedup}_{L}\left(\left(\left\{\widetilde{x}_{i,t},f_{i,t}^{\mathrm{ref}}\right\}\cup\mathcal{K}_{i,t}^{\mathrm{base}}\right)\setminus\mathcal{Q}_{i,\leq t}\right)\]通过这套机制,经验被降维成了单纯的“搜寻方向指引”,彻底与事实推理隔离。
经验的动态生态:全生命周期管理
任何自我演进的 Agent 都会面临一个隐蔽的陷阱:随着执行的任务越来越多,外部经验库会急剧膨胀,大量过时、无效甚至偶发性的错误经验会逐渐沉淀为噪声,反而严重拖慢检索效率。
RRM 为此设计了一套严谨的在线记忆生命周期管理机制(Online Memory Lifecycle Management):
-
使用与复用有效性追踪:经验被写入库中并不等于一劳永逸。只有当一条经验指导生成的 Query 真正从当前视频图谱中检索到了此前未曾发现的有效增量证据时,该经验的实用计数和正面反馈才会被累加。
-
时间衰减(Temporal Decay):长期未被命中或虽然命中但从未带来实质证据收益的经验,其调用优先级会随着时间步平滑衰减。
-
分化合并与去重:对于成功经验,系统会持续计算语义相似度,将策略趋同的成功模式合并,并将其正面权重合并归纳;但对于失败经验,系统则倾向于保留其独立的细分特征,因为不同的失败往往对应着微妙且不可替代的边界条件。
-
冷启动保护与定期修剪:新写入的经验会获得一定的冷启动豁免期,避免其尚未得到验证就被误删。在容量达到阈值时,低效、衰减过甚的条目会被硬性剔除。
这一机制确保了反思经验库始终像一个精简利落的高级参谋团,规模受控且招招致命。
实验评测:不仅答得更准,而且找得更快
为了严密检验 RRM 的真实性能,研究团队采用了流式测试期学习(Streaming Test-Time Learning)的严谨评测协议:测试过程中,针对同一视频的所有问题被聚在一个 Mini-batch 中,必须在所有预测完成且固定后,才给出延迟的真实标签反馈;反馈生成的经验只能用于后续的视频任务,从制度上彻底杜绝了同视频内的信息泄漏。
评测覆盖了三大极具挑战性的多模态长视频基准:第一人称视角的真实机器人具身数据集 M3-Bench-Robot、涵盖多达 920 个开放域长视频的 M3-Bench-Web,以及超长视频权威基准 Video-MME-Long。
1. 主流基准全线突破
在与 Qwen2.5-VL-7B、Gemini-1.5-Pro、GPT-4o、MovieChat 等长视频模型,以及 Gemini-Agent、NS-Mem 等前沿 Agent 方法的横向对比中,RRM 展现出了极高的上限。
与共享相同图谱底层架构的直接基准 M3-Agent 相比,RRM 展现出了压倒性的优势:
-
在 M3-Bench-Robot 上,整体准确率提升了 9.1 个百分点,在多事件(ME)、多跳推理(MH)、跨模态(CM)、人物理解(PU)和常识推理(GK)全部 5 个细分维度均斩获第一。
-
在视频分布极其多样的 M3-Bench-Web 上,RRM 实现了 5.8 个百分点 的增长,在多跳与跨模态等复杂任务上均位居榜首。
-
在极度考验超长上下文检索的 Video-MME-Long 上,RRM 更是取得了 7.4 个百分点 的显著代差优势。
这充分证明,长视频推理的真正天花板,往往不在于模型底模的单轮视觉识别力,而在于面对海量图谱节点时, Agent 究竟能不能把正确的证据“掏出来”。
2. Query 级复用 vs. Prompt 级硬塞:关键设计的消融印证
为了验证“经验必须与回答生成隔离”这一设想,研究团队进行了一项极其关键的对比实验:Prompt 级直接注入(Prompt-level Injection) vs. Query 级受控复用(Query-only Reuse)。
在 Prompt 级方案中,检索出的历史经验被像传统 Agent 那样直接挂载到最终大模型的上下文提示词中;而在 Query 级方案中,经验严格作为查询生成控制,答案上下文只接受新检索的客观证据。
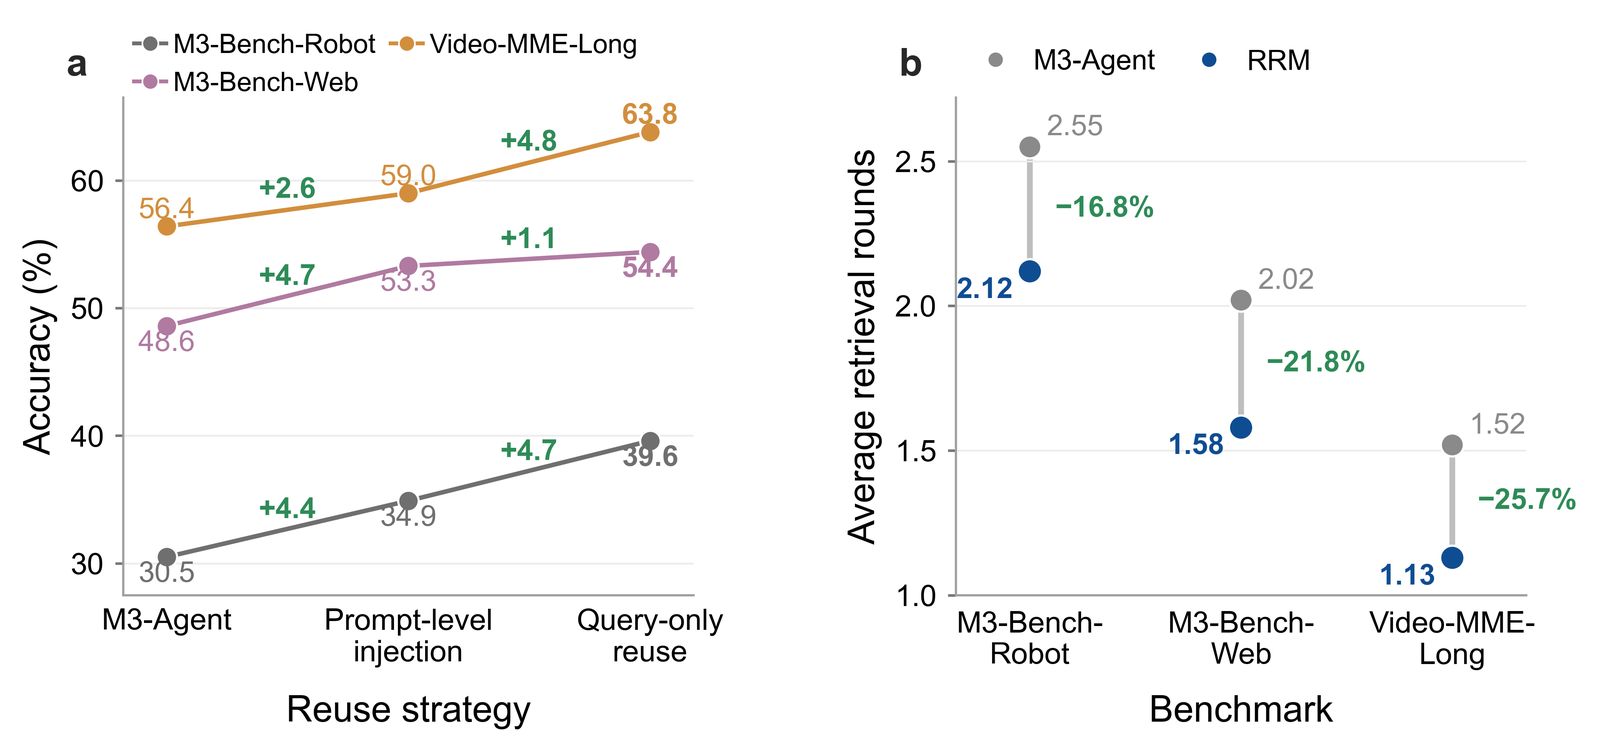
如图 3(a) 所示,虽然 Prompt 级注入相比朴素基线有一定改善,但 Query 级复用在三大基准上均大幅碾压了 Prompt 注入方案。特别是在机器人视角和超长视频场景下,Query 级复用比 Prompt 级注入分别高出了 4.7 和 4.8 个百分点。这一数据为“跨任务历史经验不应污染最终证据链”提供了无可辩驳的实证依据。
3. 检索效率的跃升
除了准确率的飙升,图 3(b) 还揭示了一个令人振奋的现象:RRM 显著减少了检索轮数。
长视频 Agent 最为人诟病的就是为了找一个证据,来回检索四五轮,导致 API 调用成本和端到端延迟急剧增加。从图 3(b) 的统计可以看出,M3-Agent 在各个数据集上的平均检索轮数普遍较高,频繁逼近上限预算。而配备了反思检索记忆的 RRM,由于能在异常发生的第一时间通过先验策略精准修正航向,其平均检索轮数在所有基准上均出现明显下探。
换言之,RRM 不仅把题目答对了,而且凭借老练的“检索手腕”,用更少的试探步数就命中了靶心。
总结与技术启示
回顾大模型 Agent 的演进历程,记忆机制的研究经历了两个重要阶段:早期大家关注如何把对话做长、把上下文窗口扩充;随后大家意识到必须引入外部 RAG 与结构化图谱,开始死磕多模态记忆的高保真压缩与储存。
而 RRM 带来了一个极具价值的范式转向:在存储机制相对完备之后,决定 Agent 智能上限的,是驾驭记忆的“元能力”。
RRM 告诉我们,面对复杂现实世界流媒体数据的持续冲击,Agent 不能仅仅被动地记录“发生了什么”,而必须学会在一次次检索成功与碰壁中,把那些不可名状的“找证据技巧”结晶成程序性知识。更为难得的是,它通过严格的控制解耦,优雅地避开了长视频历史信息可能带来的幻觉隐患。
对于具身智能、长视频复杂质询乃至连续软件工程 Agent 等长期受制于检索低效与幻觉的领域而言,这种“经验只改动作、事实决定结论”的极简控制哲学,无疑指明了一条兼具实用性与泛化力的新路径。