CAM-DF:得分不等于决策!北大清华等将Agent工具暴露减少37%
Scores Are Not Decisions: Cost-Aware Stopping for Tool Acquisition in LLM Agents
在大模型智能体(LLM Agent)逐步接管复杂工作流的今天,一个长期被忽视的工程痛点正在浮出水面:面对庞大的外部工具箱——从高延迟的网页检索、高昂的商业 API,再到涉及敏感数据的企业私有数据库,智能体到底应该获取多少工具才算“刚刚好”?
ArXiv URL:https://arxiv.org/abs/2607.27083v1
现有的主流做法通常依赖检索器(Retriever)或路由模块(Router)对候选工具打分排序,随后设置一个固定的相关性阈值,或者机械地截取前 $k$ 个工具推给模型。然而,相关性得分并不等于决策本身。北京大学、清华大学、麦吉尔大学与上海财经大学的联合研究团队在论文《Scores Are Not Decisions: Cost-Aware Stopping for Tool Acquisition in LLM Agents》中指出,获取太少会导致智能体因信息不足而失败;获取过多不仅会导致模型上下文膨胀、调用费用飙升和隐私暴露风险激增,还可能引入噪声干扰。更致命的是,真实世界中的工具调用成本差异巨大,当工具成本异质化(Heterogeneous Costs)时,单纯依赖相关性分数的截断规则在数学上被证明是次优的。
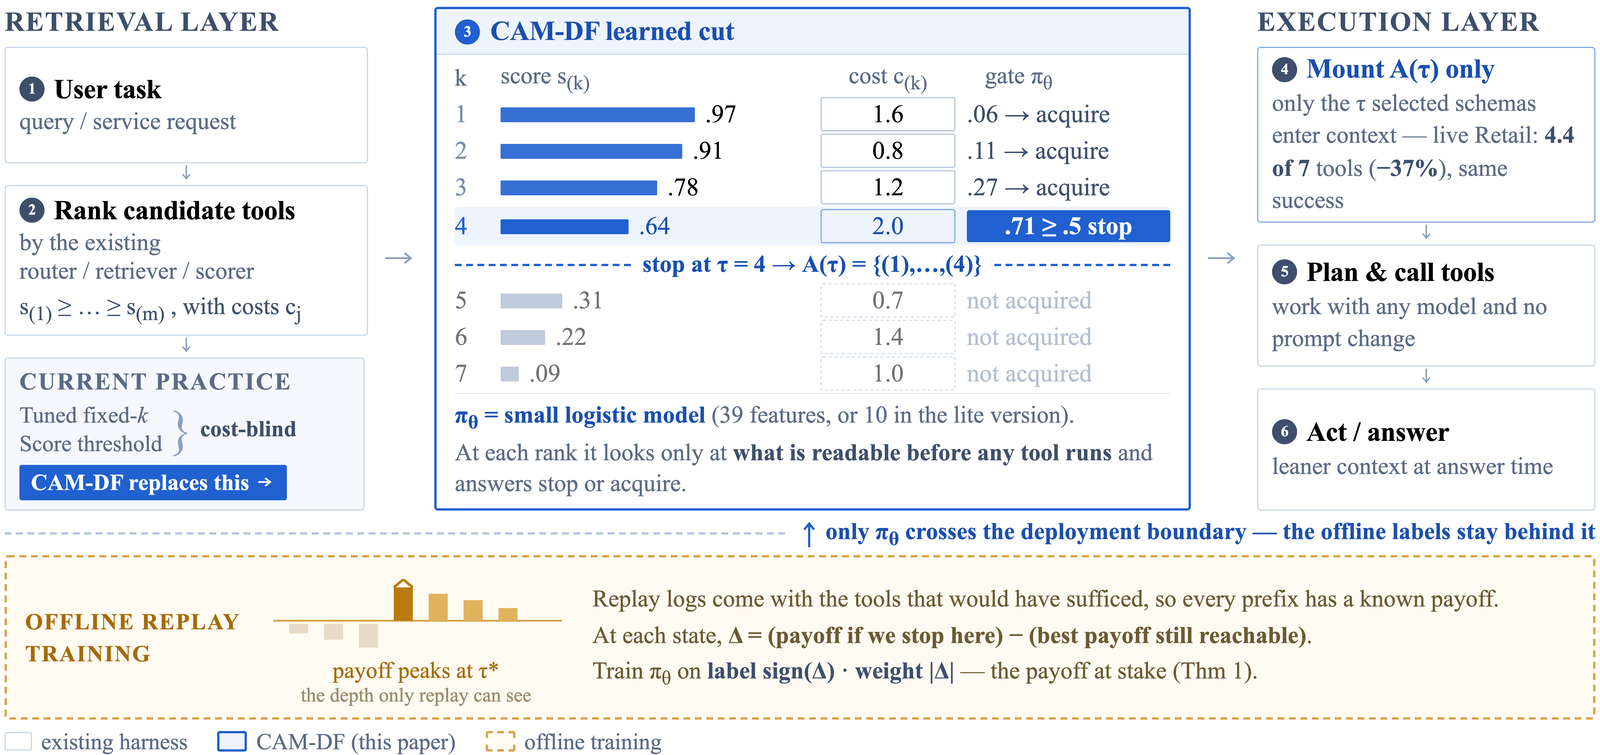
为了攻克这一瓶颈,该团队提出了成本感知边际决策停机框架(Cost-Aware Marginal Decision-Focused Stopping,简称 CAM-DF)。这是一种极为轻量的执行前插件,无需对底座大模型或上游检索器进行微调,仅依靠离线学习到的真实收益差(Payoff Gap)来指导前缀截断。在 $\tau$-bench Retail 等 5 个领域的 1,343 个任务评测中,CAM-DF 在高成本压力和异质成本环境下展现出显著优势;在端到端真实智能体执行中,它在保持同等任务成功率的前提下,将智能体的工具暴露量直接减少了 37%。
为什么说“得分高不等于该获取”?
构建 Agent Harness(智能体调度外壳)的核心考量,始终绕不开效率与能力的平衡。当前工业界对工具路由的优化,大多停留在“排得准不准”的维度:给定用户 Prompt,检索器输出每个工具的相关性打分。但很多开发者默认了一种潜意识假设——只要工具相关性超过某个阈值,或者取前 Top-$k$ 个工具,就能保证任务效果。
这种假设忽略了两个根本性的机制冲突。
其一是工具之间的任务互补性与冗余性。一个复杂的退货任务可能需要“查询订单”和“发起退款”两个工具同时存在才能完成,两者缺一不可;此时哪怕第三个工具“查询物流轨迹”的相关性评分同样极高,只要前两个工具已经足以闭环任务,拉入第三个工具就只会带来纯粹的成本浪费与上下文干扰。反之,如果系统只拿到了“查询订单”,即便它的得分再高,若缺失了后续关键工具,智能体依然无法完成任务,前面的开销全部沦为沉没成本。
其二是成本的极端异质性。在企业真实落地场景中,本地轻量正则工具的调用成本接近于零,而单次企业级信用查询或高精度检索 API 的调用成本却极为昂贵。如果一个次要工具相关性得分略高于某个便宜工具,但调用费用是后者的十倍甚至百倍,无脑按分数排序截断必然导致严重的资源浪费。
论文从数学上严格论证了这一困境。假设存在两个候选工具 $i$ 和 $j$,工具 $i$ 的相关性价值高于工具 $j$(即 $p_i(x) > p_j(x)$),但工具 $j$ 的性价比(单位成本收益)却远高于工具 $i$(即 $p_i(x)/c_i < p_j(x)/c_j$)。在这种情况下,任何只依据相关性分数由高到低进行前缀截断的策略,都无法达到最优决策边界。换句话说,排序负责建立候选工具的调用优先级,但它从物理机制上就无法决定“究竟停在哪里最划算”。
边际决策停机:以真实收益差为尺
针对上述问题,研究团队将工具获取形式化为一个沿着排序前缀进行的成本感知序贯停机问题(Cost-Aware Stopping over Ranked Tool Prefixes)。
在智能体进入实际执行步骤之前,上游模块(无论是检索器、Prompt 评分器还是规则路由器)会给出一个按优先级排好序的候选工具列表。CAM-DF 的任务不是重新打乱这个列表,而是在正式调用前“虚拟地”从前往后扫描这个前缀列表,在每一个候选深度 $t$ 处做出二元裁决:究竟是立刻停在当前包含 $t$ 个工具的前缀集合 $A_t$,还是继续探索更长的前缀?
为了让停机策略真正面向业务结果,研究团队定义了下游净收益函数(Payoff):
\[U(A, x) = v(A, G_x) - \lambda \sum_{j \in A} c_j\]其中 $x$ 代表当前任务,$G_x$ 为该任务真正需要的潜工具集合,$A$ 为获取到的工具前缀集合。函数 $v(A, G_x)$ 刻画了任务满足度——在精准充分性(Exact Sufficiency)设定下,只有当获取的集合完全覆盖所需工具($G_x \subseteq A$)时其值才为 1,否则为 0;在部分覆盖(Partial Coverage)设定下,则按覆盖所需工具的比例线性给分。参数 $c_j$ 是工具 $j$ 的调用成本,而 $\lambda > 0$ 则是全局成本惩罚系数(Cost Pressure),反映了业务系统对成本消耗的容忍底线。
在任何一个前缀状态 $S_t$,立刻停机获得的收益是 $Q_{\mathrm{stop}}(S_t) = U(A_t, x)$,而如果选择继续,未来可能达到的最优收益则是 $Q_{\mathrm{continue}}(S_t) = \max_{k > t} U(A_k, x)$。二者的差值即为决策差距(Decision Gap):
\[\Delta(S_t) = Q_{\mathrm{stop}}(S_t) - Q_{\mathrm{continue}}(S_t)\]当且仅当 $\Delta(S_t) \ge 0$ 时,选择停止才是全局最优的,因为后续任何更长的前缀都无法创造超越当前净收益的价值。
如果直接用离线策略硬套分类器,通常容易陷入“预测充分性再卡阈值”(Predict-then-Threshold)的俗套。但这项研究揭示了一个关键理论洞见:哪怕你训练了一个能够完美预测“当前前缀是否充分”的分类器,它在异质成本场景下依然会频繁停错。因为边际停机不仅取决于“现在够不够”,更取决于“下一步的工具能否以极低的成本补齐闭环”,抑或是“后续工具成本太高,继续获取根本得不偿失”。
理论突破:贝叶斯对齐与遗憾加权目标
CAM-DF 的理论核心在于巧妙化解了序贯决策中的误差累积问题,建立了路径遗憾分解定理(Pathwise Prefix-Regret Decomposition)。
研究证明,对于任意一个停机分类器 $g$,由于其在各个状态 $S_t$ 上的局部决策失误而在整条路径上累积的真实后悔值(Regret),可以精确分解为各个失误状态上决策差距绝对值 $\lvert \Delta(S_t) \rvert$ 的加权和。基于这一性质,团队推导出了贝叶斯对齐定理(Bayes Alignment): 任何最小化下述遗憾加权风险的分类器 $g^*$:
\[\mathcal{R}(g) = \mathbb{E}\bigl[\,\vert{}\Delta(S_t)\vert{}\cdot\mathbf{1}\{g(X_t) \neq Y_t^*\}\,\bigr]\]在条件期望 $\mathbb{E}[\Delta(S_t)\mid X_t] \neq 0$ 的集合上,几乎处处满足:
\[g^*(X_t) = \operatorname{sign}\bigl(\mathbb{E}[\Delta(S_t)\mid X_t]\bigr)\]其中 $Y_t^* = \operatorname{sign}(\Delta(S_t))$。这个定理的工程含义极其深刻:它证明了将离线计算出的真实收益差 $\lvert \Delta(S_t) \rvert$ 作为样本权重嵌入到常规的加权 Logistic 损失函数中,分类器学出的决策边界在数学上将自然收敛到真实的期望净收益最优拐点。
这种“决策聚焦”(Decision-Focused)的学习模式,跳过了繁琐且容易失真的中间概率校准,直奔最终业务收益。在离线训练阶段,系统利用带有标注的问答日志计算真实的 $\Delta(S_t)$ 并生成带权标签;而在实际部署推理时,系统完全不需要知道未知的目标工具集合 $G_x$,仅利用线上公开可见的特征——包括当前工具与剩余工具的分数阶梯、边际成本、分数断崖差值以及获取进度,就能极快地进行前向推理并输出停机信号。
除了完整的特征模型 CAM-DF 之外,团队还提炼出了极简版本 CAM-DF-lite。它仅仅使用了 10 个具有明确经济学解释的边际特征(例如下一个工具的得分/成本比、剩余工具的总预期盈余等),大幅降低了计算开销,同时为系统运维人员提供了极佳的可解释性。
实验印证:三大假设在基准评测中的落地
为了验证这套理论的鲁棒性,研究团队在涵盖零售、客服、系统调度等 5 个领域的 1,343 个任务上展开了详尽评测,并重点针对理论给出的三项核心假设进行了压力测试:
-
P1(打分模糊度):检索器或排序模型的能力越弱(AUC 越低),CAM-DF 带来的收益提升越显著;
-
P2(成本分散度):不同工具间的成本差异越大,CAM-DF 相较于传统纯分数截断的超额收益越大;
-
P3(成本压力系数):当系统施加的成本惩罚系数 $\lambda$ 越高,随意盲目获取工具招致的惩罚越重,CAM-DF 的优势越不可替代。
实验结果完全印证了上述推断。在主要的 $\tau$-bench Retail 评测基准中,面对 5 种不同的冻结大模型检索基座(从较弱的提示排序到高精度的路由模型)以及两种不同的成本惩罚设定,CAM-DF 在全部 10 种组合配置下均拿下了部署型方法中的最高平均净收益(Payoff)。在 95% 成对 Bootstrap 置信区间检验中,有 9 个设置明确排除了零增益,证实其性能跃升具备极高统计显著性。
消融实验进一步证实,如果在特征中剔除边际成本相关指标,模型在异质成本场景下的收益会出现断崖式下跌;而如果将遗憾加权训练目标替换为传统的“预测当前前缀是否充分”,策略往往会在复杂任务中过度早停或过度获取。这表明直接学习收益差绝对值的符号与幅度,是实现最优停机的关键技术抓手。
真实执行下削减 37% 工具暴露
学术指标之外,工业落地更关心端到端调用的综合损耗。在真实的 $\tau$-bench Retail 闭环评测中,研究团队将 CAM-DF 挂载到全功能智能体系统的前端,作为只读工具获取的门控层。
测试表明,如果不设防或采用常规的全量工具暴露策略,智能体在每次调用中平均需要加载多达 7 个只读工具的定义与调用接口;而在引入 CAM-DF 进行执行前动态停机后,平均工具暴露量被直接压缩到 4.4 个,工具暴露数量锐减 37%。
最为难得的是,在工具大幅瘦身的同时,智能体的端到端任务最终达成率几乎没有产生统计意义上的损失。这意味着那被砍掉的 37% 的工具,绝大多数都是被传统检索机制“虚高”拉入上下文的无关或冗余组件。削减这些工具,不仅直接降低了 Agent 在交互循环中的 Token 消耗与计费成本,还将由于工具语义混淆导致的调用幻觉扼杀在了执行之前。
轻量级变体 CAM-DF-lite 同样交出了亮眼的答卷。尽管只依赖 10 个轻量级特征,它依然保留了完整策略 85% 以上的超额收益,其正负系数表现出极强的经济直觉:下一个工具的性价比越高,模型越倾向于继续探索;而当前累积的固定成本越高,系统就越倾向于果断止损。
对未来智能体架构的启发
CAM-DF 的提出,实际上对当前 Agent 基础设施的演进路线给出了一个清晰的修正信号。
过去一年多,学术界和工业界习惯于将资源投入到“训练更强、参数更大的统一路由模型”,试图让单一模型同时兼顾意图识别、工具相关性排序与调用预算控制。然而这种端到端的黑盒尝试往往成本高昂,且一旦下游 API 成本或业务考核指标发生变动,整个模型就需要重新微调或打补丁。
CAM-DF 证明了一条截然不同的模块化演进路径:
-
解耦优先级排序与获取裁决:让前置检索器专注于语义相关性,输出工具的拓扑排序;
-
将动态成本与决策逻辑外置:在执行前引入具备严格理论保障的停机层,专门负责依照实时成本与业务容忍度做预算截断;
-
保持底层执行零侵入:底层 LLM 既不需要感知停机策略的存在,也不需要为了适应不同的成本约束而反复进行指令微调。
随着企业级智能体调用的工具库走向千级乃至万级规模,高昂的商业 API 与私密数据连接器将变得日常化。在这样的异质成本时代,“得分不等于决策”应当成为每一个 Harness 架构师的基本设计常识。通过一个只有几兆字节大小、基于决策遗憾对齐的轻量分类层,在 Agent 扣动调用扳机的前一毫秒做出精确止损,或许正是破解当下大模型落地成本瓶颈的一把关键钥匙。