MCTS-Report:把多模态报告生成做成树搜索,MMRBench综合得分达到77.9
Monte Carlo Tree Search for Table-to-Multimodal Report Generation
把复杂的结构化数据表交给大模型,让它自动撰写一份图文并茂的分析报告,是目前数据智能领域最受期待的应用之一。然而,现实中的系统往往表现欠佳:要么图表画得漂亮但与文字结论互相矛盾,要么数字计算张冠李戴,甚至陷入“一眼看穿”的浅层废话。这类失败的根源并非模型能力不足,而在于主流方案普遍采用“解析表格 $\rightarrow$ 绘制图表 $\rightarrow$ 撰写正文 $\rightarrow$ 润色总结”的固定单向流水线。一旦前面的环节出现理解偏差,后续步骤根本无法回溯修正,最终导致图文脱节和洞察冻结。
ArXiv URL:https://arxiv.org/abs/2608.04071v1
香港科技大学(HKUST)的研究团队在最新论文中提出了 MCTS-Report。该方法完全颠覆了预设的线性流水线,将表格生成多模态报告的过程重新形式化为结构化搜索空间中的树构建问题。通过引入经典而强大的蒙特卡洛树搜索(Monte Carlo Tree Search, MCTS),系统能够在章节规划、图表构建与深度洞察之间进行全局试错、探索与回溯。配合多维自监督验证奖励函数,MCTS-Report 在包含金融、医疗、制造等六大领域的真实基准 MMRBench 上斩获了 77.9 的综合得分,显著拉开了与现存主流多模态系统及深度研究智能体(Deep Research Agents)的差距。
从固定流水线到树形搜索空间
传统的报告生成 Agent 架构大多把流程切分为若干独立角色,例如“数据分析师”“制图专家”和“写手”。这种设计看似符合人类分工,却容易引入两大硬伤:一是误差在环节间单向放大,下游无法推翻上游的错误;二是图表与文字分别追求局部最优,缺乏交叉验证机制。
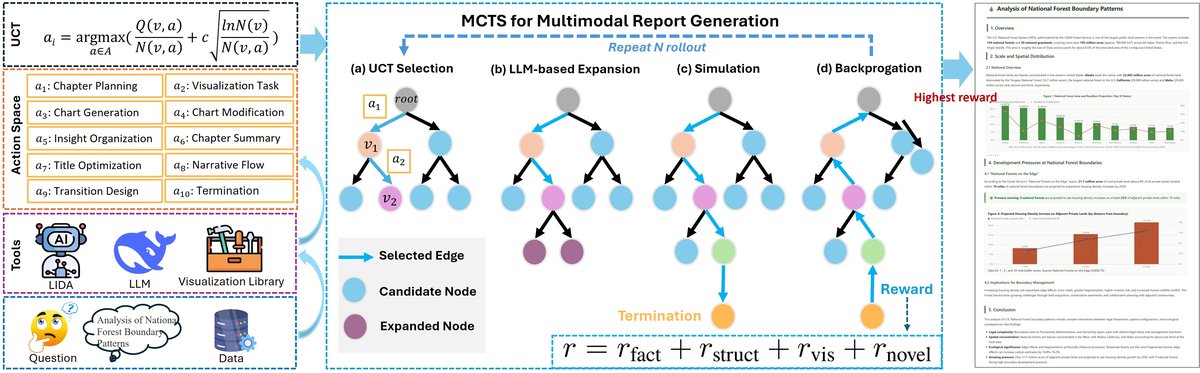
MCTS-Report 选择将整篇多模态报告的构建拆解为原子动作序列,把生成任务定义在一棵部分报告搜索树 $\Psi=(V, E)$ 上。树的根节点 $v_0$ 对应一份空报告大纲,叶子节点 $v_t$ 则代表完整的多模态报告,而每条边对应一次具体动作。本文定义了一个覆盖报告完整生命周期的动作空间,包括章节拆解、图表任务识别、图表代码生成与渲染、关键洞察归纳以及叙事精炼等。为了保证逻辑递进,研究团队设定了动作转移约束矩阵,杜绝跳过数据理解直接输出结论等非法状态。
更为关键的是系统实现上的减法:整个树搜索并未引入复杂的 Multi-Agent 协调协议,而是采用单一大型语言模型(LLM)作为统一的“动作-评估”引擎。模型根据当前节点累积的推演轨迹上下文,动态决定下一步的最优原子操作。这种架构有效规避了多智能体之间脆弱的通信瓶颈,将系统的重点转向更高质量的路径规划与状态评估。
蒙特卡洛树搜索如何驱动深度研报生成
要在组合爆炸的动作树中快速收敛至高质量报告,MCTS-Report 依托经典的四阶段搜索机制展开循环推演:
选择(Selection)阶段自根节点向下遍历,利用经典的上限置信区间算法(Upper Confidence Bound for Trees, UCT)平衡“探索”与“利用”:
\[\mathrm{UCT}(v,a)=\frac{Q(v,a)}{N(v,a)}+c\cdot\sqrt{\frac{\ln N(v)}{N(v,a)}}\]其中 $Q(v,a)$ 为累计奖励值,$N(v,a)$ 为访问频次。这一公式确保系统既优先深挖已被验证的高潜力报告框架,又不会遗漏可能产生独到商业见解的新颖分析切入点。
在扩展(Expansion)阶段,系统针对未探索的合法动作调用大模型生成候选子节点;随后在模拟(Simulation)阶段,模型基于扩展出的部分状态快速推演,草拟出一份完整的临时报告 $\mathcal{R}_{\text{draft}}$。模拟路径不被树结构长期记忆,其核心价值在于支持回溯(Backpropagation)阶段的质量打分。
为了避免“LLM-as-a-judge”带来的自我欺骗与奖励黑客(Reward Hacking)风险,MCTS-Report 设计了完全基于规则和确定性验证的自监督复合奖励:
\[r = r_{\text{fact}} + r_{\text{struct}} + r_{\text{vis}} + r_{\text{novel}}\]这四项奖励分别精准对应商业报告的核心痛点:
-
事实准确度 $r_{\text{fact}}$:系统自动抽离草稿中的数值陈述(如“营收环比增长 15%”),反向生成针对原始表格的验证 SQL 并执行查询,在 1% 容差内比对真实计算结果。
-
结构完备度 $r_{\text{struct}}$:硬性校验核心章节结构与段落充实度。
-
视觉真实度 $r_{\text{vis}}$:通过 OCR 与图像解析提取已渲染图表中的核心数据点,与原表底层数值交叉校验,确保图表没有出现虚标数据或截断误导。
-
洞察新颖度 $r_{\text{novel}}$:建立高频平庸表达模板库(如单纯复述“总额上升”),利用语义嵌入相似度过滤浮于表面的陈词滥调,惩罚浅层浅显聚合。
模拟计算得到的奖励值 $r$ 随后沿搜索路径逆向回传,更新沿途所有节点的访问次数与价值期望,使后续 Rollout 能够越走越准。
MMRBench:填补表格多模态报告的评测空白
为了公正衡量报告生成质量,研究团队构建了专用基准评测集 MMRBench。现有的数据集如 WikiTableQuestions 和 TabFact 局限于单句回答或浅层表格推理,而更近的 T2R-Bench 则不支持图表融合。MMRBench 收集了来自金融、制造、医疗、教育、零售、IT 运维六大行业的 185 张真实复杂表格(涵盖 79 个英文表格与 131 个中文表格),包含 386 项分析任务(其中多表联合关联推理任务达 107 个)。
所有任务均由资深分析专家基于商业分析场景模板提炼,经由多轮交叉审核生成参考研报与 1834 个经由严格验证的关键洞察点(平均每任务 4.75 个),标注一致性 Fleiss’ $\kappa$ 达到 0.85。基准评测采用与 MCTS 内部奖励机制完全解耦的独立评估流程,以杜绝评测闭环中的评价偏差。
在与 GPT-4o、Claude-3.5-Sonnet、DeepSeek-R1(搭配代码解释器)以及 Gemini / ChatGPT Deep Research 智能体等 12 种前沿方案的同台竞技中,MCTS-Report 取得了 77.9 的综合总分,各细分维度均处于领先位置。
消融验证与核心实验发现
系统表现的全面领先,核心归功于树搜索机制对报告逻辑空间的充分探索。消融实验清晰揭示了各个模块对最终成效的贡献度。
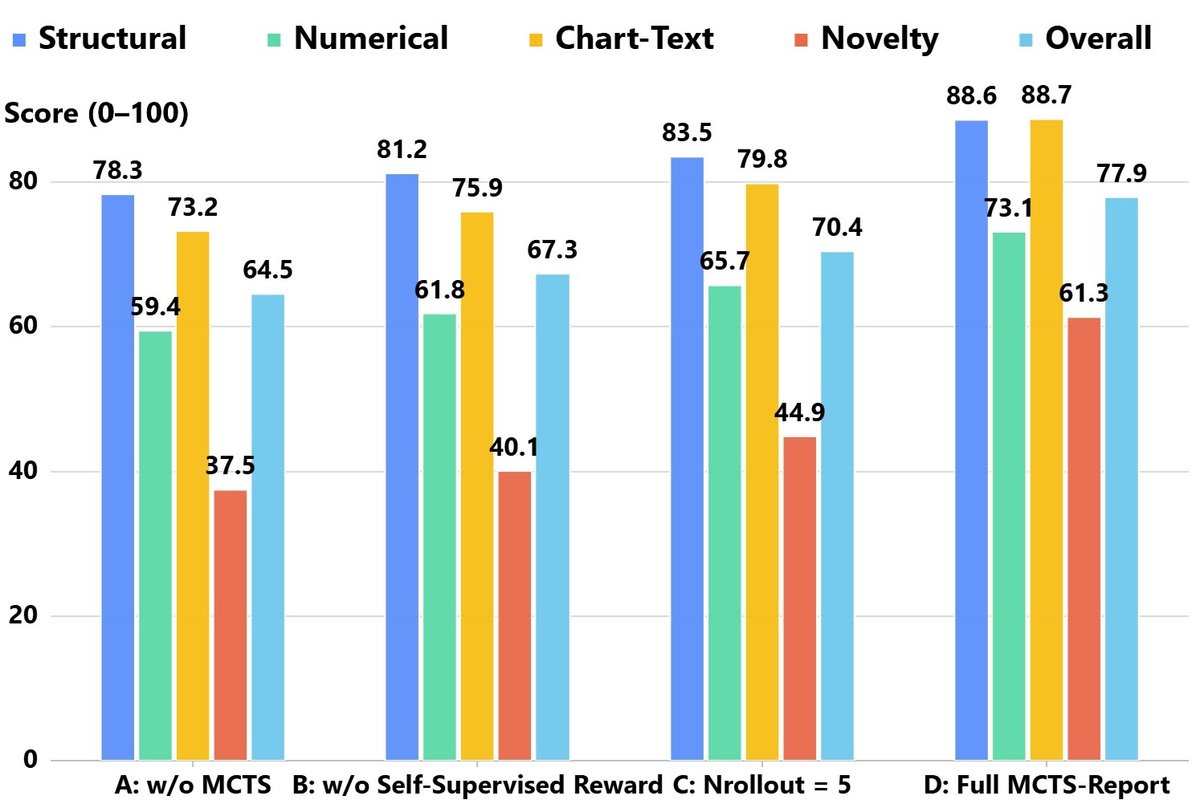
消融对比显示:
-
完全去掉 MCTS 机制(Variant A):退化为单次 Rollout 的顺序执行,综合得分出现断崖式下跌,证实固定推理路径会严重扼杀报告的全局一致性。
-
去除自监督奖励机制(Variant B):改用随机探索而非 UCT 指引,系统退化为无目的随机展开,事实准确性与图文对齐度受损尤为严重。
-
缩减搜索轮次(Variant C):将 Rollout 频次从 10 轮压减至 5 轮,模型虽然依然保持可用状态,但在复杂逻辑和洞察新颖性上均有退缩,表明一定的计算探索预算对于产出高水平商业洞察是不可或缺的。
缺陷归因:当前多模态生成的瓶颈何在
研究团队进一步对 MCTS-Report 随机抽样的 200 篇生成报告进行了细粒度错误归因分析。
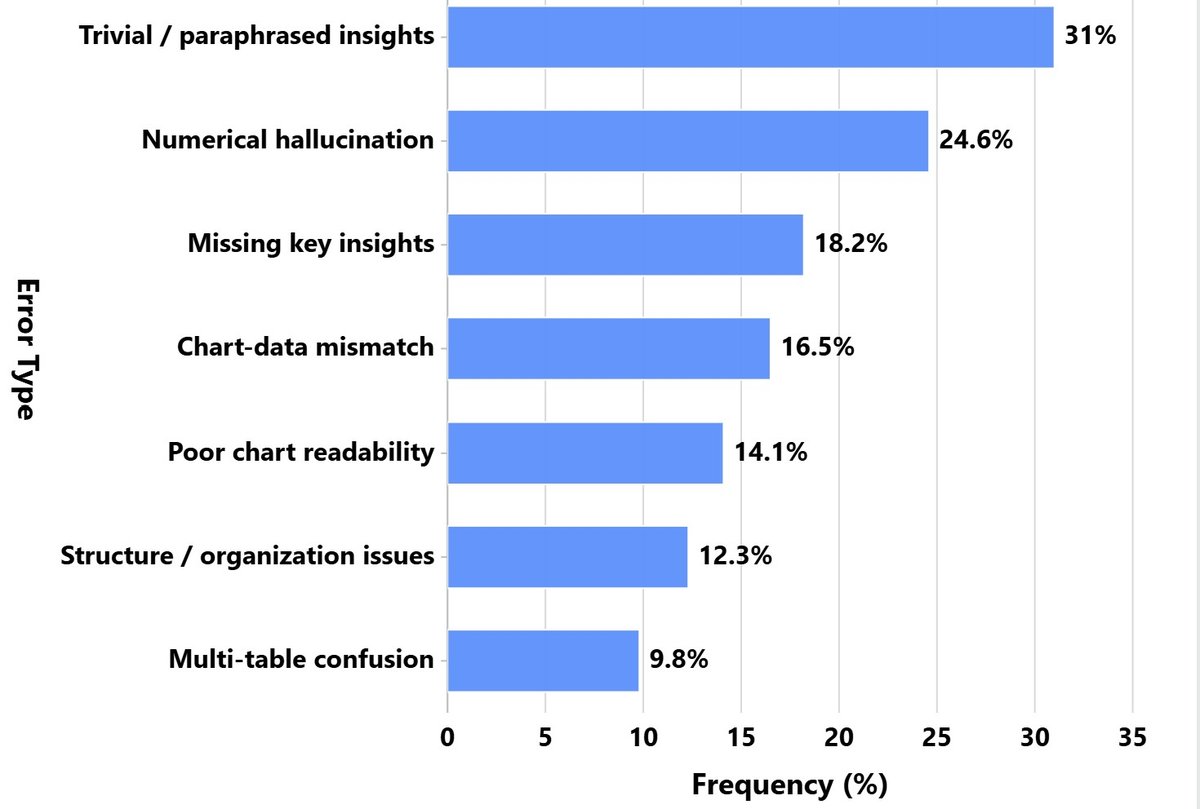
统计数据显示,得益于底层的 SQL 自动化验证奖励机制,MCTS-Report 的数值幻觉率(24.6%)显著低于最强基线 DeepSeek-R1 的 38.5%。这表明基于真实数据库引擎的闭环验证机制,是解决数据密集型任务“信口开河”的有效手段。
然而,平庸或复述型洞察依然占据了 31.0% 的错误比例。这一数据与基准评测中所有模型在新颖性维度的低迷表现相吻合(全行业模型的新颖性得分均在 60 分上下,而人类分析师基准高达 88.5)。这说明树搜索算法能够通过拓扑展开纠正结构和事实逻辑,但底层 LLM 对复杂业务领域深层机理的理解深度,依然构成了自动化分析质感的上限瓶颈。此外,在涉及多表关联的金融与医疗场景中,跨模式关联的混乱率(9.8%)也暗示了复杂的表结构 Join 仍然是亟待深化的方向。
结语
MCTS-Report 为数据驱动型内容生成提供了从“线性流水线工程”向“结构化状态搜索”演进的范例。它表明,面对长程、多模态且容错率极低的工业级生成任务,单纯叠加 Prompt 或构建角色混乱的 Multi-Agent 系统容易遇到上限。将大模型置于严格定义的动作约束与自监督可验证奖励之中,借力经典启发式搜索算法进行全局路径优化,不仅能压低幻觉发生率,也为后续开发人在回路(Human-in-the-Loop)的交互式商业研报系统打下了坚实的技术基础。