MT-Web2Code:从单轮整页生成走向多轮局部迭代修复
MT-Web2Code: Benchmarking Coding Agents on Multi-Turn Regional Reconstruction and Localized Modification
在前端开发与大模型代码生成领域,给一张网页截图让多模态大模型从零生成完整 HTML 与 CSS,早已成为各大视觉语言模型(LVLM)秀肌肉的标配操作。然而,真实业务场景中的前端开发几乎从不采取这种“推倒重来”的工作流。工程师日常处理的往往是基于已有庞大代码库的演进:在现有布局中补齐一个缺失的语义模块,调整某个组件的对齐偏差,或者修改局部的配色与文字,同时必须保证其余无关代码与页面渲染丝毫不被破坏。
ArXiv URL:https://arxiv.org/abs/2608.03474v1
针对这一长期被基准评测忽视的现实需求,来自哈尔滨工业大学、美团与鹏城实验室的研究团队提出了 MT-Web2Code。这是首个专注于多轮宏观区域重构(Macro-Level Regional Reconstruction)与微观局部微调(Micro-Level Localized Modification)的多模态代码智能体评测基准。
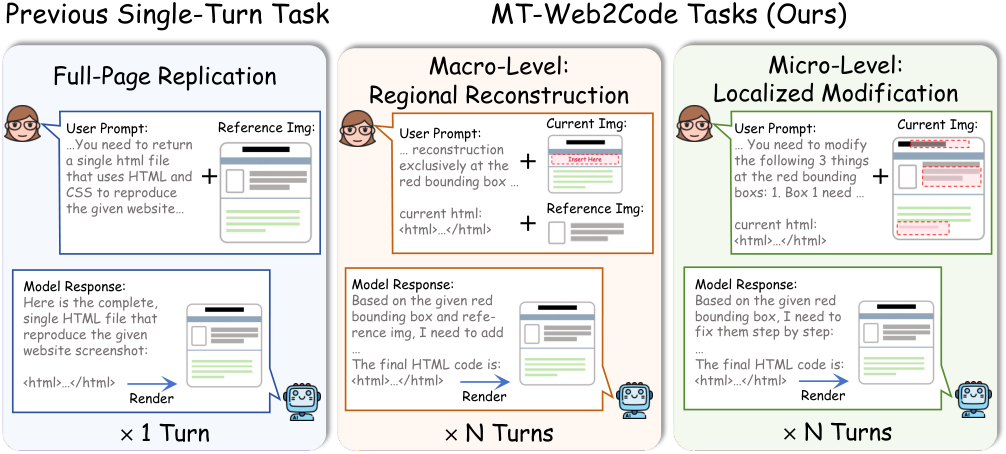
该基准覆盖 16 个垂直领域的 102 个真实网页任务。为了在不需要昂贵人工逐轮标注的前提下构建确定性的评估轨迹,研究团队设计了一套“逆向损坏轨迹引擎”(Reverse-Corruption Trajectory Engine)。通过对 13 款前沿代码智能体的广泛测试,研究揭示了当前模型在多轮迭代前端编程中的三大核心软肋:宏观重构时的“改动越界”、微观微调中的视觉代码弱对齐,以及多轮交互中尤为显著的“错误滚雪球”效应。
从单轮整页复刻到真实多轮迭代
现有的 Web UI 生成基准(如 Design2Code、WebGen-Bench 等)大多采用单轮测试架构,即输入一张静态图,输出完整代码,最后对比整体截图的 CLIP 相似度或块级匹配度。这种模式隐藏了两个关键盲区:
-
全局掩盖局部:整页相似度极易稀释局部区域的严重错误,无法评估细粒度的视觉样式修正。
-
缺乏多步上下文演进:无法衡量模型在连续多轮修改中,能否保持未修改区域(Out-of-box)的绝对稳定,更无法检测多轮交互导致的误差累积。
真实的前端工程既包含大刀阔斧的区域补全,也包含绣花针式的样式修正。MT-Web2Code 正是通过将任务解构为两种互补颗粒度来解决这一割裂:
宏观层面的区域重构要求智能体基于局部视觉参考图,在指定的 DOM 锚点间重新生成完整的语义模块(例如一个完整的导航栏或功能区块),并将其无缝嵌入到现有网页中;微观层面的局部修改则在不提供目标参考图的情况下,要求智能体依靠设计直觉和上下文资产,修复诸如布局对齐、文字、颜色、间距等细微缺陷,同时严禁波及无关区域。
逆向损坏轨迹引擎:如何构建可复现的多轮金标?
构建多轮交互基准的最大痛点,在于如何低成本且可复现地获取每一轮的“标准答案”(Ground Truth)。如果全靠人工逐轮编写与审核,不仅成本极高,而且多轮代码之间极易出现非确定性的风格漂移。
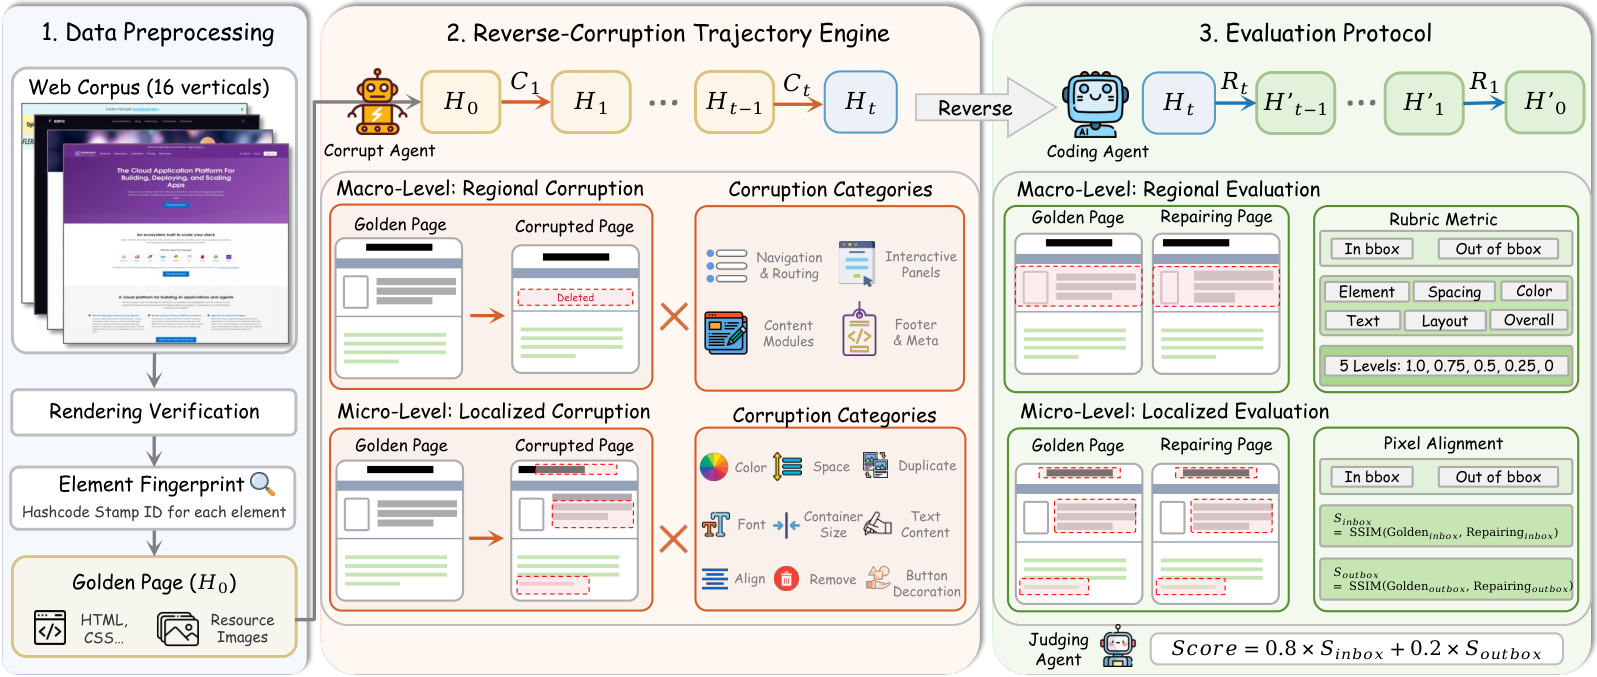
MT-Web2Code 另辟蹊径,提出了逆向损坏轨迹引擎。其核心理念是:从完全正确的“黄金页面”(Golden Page, $H_0$)出发,通过受控的正向注入损坏操作生成状态序列,随后将其逆转为模型需要执行的修复轨迹。
具体实现依赖于以下几个核心技术设计:
1. 元素指纹(Element Fingerprint)
在多轮 DOM 树操作中,传统的节点索引会因上层结构的增删而失效,CSS 重排也会导致绝对像素坐标漂移。引擎在初始化阶段遍历 DOM 树,为每个节点生成位置无关的唯一哈希指纹:
\[\mathrm{ID}(e) = \mathrm{hash}(\mathrm{tag}(e), \mathrm{text}(e), \mathrm{attr}(e))\]该指纹使得引擎在页面结构发生剧烈变化后,依然能无歧义地追踪到目标节点及其相邻的幸存兄弟节点(Surviving Siblings, $a^-, a^+$),以此确定待插入或修改区域的精确边界。
2. 拓扑无关性与可见性约束
在微观局部修改中,每一轮通常会同时注入涵盖布局、元素、文本、颜色、间距 5 个感知维度的组合缺陷。为了防止因父节点变动导致子节点样式失效的连锁干扰,引擎强制要求任意两个目标节点必须满足拓扑独立性:若两节点存在祖先-后代关系,则其注入的操作维度必须严格正交。此外,所有注入操作都必须通过可见性校验($\Delta(H, o) \ge \tau_{\mathrm{vis}}$),过滤掉肉眼不可见的无效扰动。
3. 确定性逆向轨迹
正向注入过程每前进一步,相当于给代码引入一处或多处缺陷;当所有步数执行完毕后,逆向回推即构成了一条标准的修复轨迹。由于起点是黄金代码,每一轮修复都有明确且唯一的代码参照与渲染状态。
双轴评估协议:既要改对,更要不添乱
以往评测多采用整页打分,导致模型即便把未受影响的区域改得面目全非,只要目标区域做对了,依然能拿到高分。为此,MT-Web2Code 提出了统一的双轴评估协议,严格将评分拆解为目标区域内的保真度($\mathbf{S_{inbox}}$)与目标区域外的保全度($\mathbf{S_{outbox}}$),并以 $0.8 : 0.2$ 的权重融合为最终得分:
\[\textbf{Score} = 0.8 \times \mathbf{S_{inbox}} + 0.2 \times \mathbf{S_{outbox}}\]针对两类任务的特点,具体的度量实现也有所区分:
-
宏观区域重构:由于生成完整语义区块的 HTML/CSS 实现方式多样,无法采用纯文本比对。评测利用指纹锚点裁剪出生成区域,交由视觉语言模型(以评测表现严格的 Kimi-K2.6 作为裁判)根据 5 维量规进行打分;同时将重构区域完全遮盖后,对比整页未受影响区域的视觉一致性,对因排版塌陷或全局重绘导致的连带破坏施加严厉惩罚。
-
微观局部微调:由于细粒度缺陷具备确定性的视觉真值,评测直接转入像素级比对。在像素差异掩码 $\Omega$ 内计算生成图与黄金参考图的结构相似性(SSIM)作为 $\mathbf{S_{inbox}}$,在掩码外计算未受影响区域的 $\mathbf{S_{outbox}}$,并额外叠加敏感的像素色差惩罚,彻底杜绝全局意外变色或位移。
这种确定性且密集的单轮反馈,不仅提供了科学的评测标尺,也为未来多模态代码模型的强化学习(RL)训练提供了免人工标注的可验证奖励信号(Verifiable Rewards)。
评测发现:前沿智能体的多轮前端能力短板
研究团队在 MT-Web2Code 上对涵盖 Gemini、Claude、GPT、Kimi、GLM、Qwen、豆包等系列的 13 款前沿模型进行了详尽评测,得出了一系列颠覆直觉的结论:
| 模型 | 宏观重构得分 (Macro) | 微观微调得分 (Micro) |
|---|---|---|
| Gemini-3.5-Flash | 65.5 | 76.5 |
| Kimi-K2.6 | 63.7 | 81.3 |
| Claude-4.7-Opus | 55.4 | 80.8 |
| Doubao-Seed-2.0-Pro | 61.1 | 83.5 |
| GLM-5V-Turbo | 60.9 | 78.4 |
1. 大模型在局部重构时极易“越界破坏”
在宏观重构任务中,表现最好的是轻量级模型 Gemini-3.5-Flash(65.5 分),某些超大规模参数模型(如 Claude-4.7-Opus,仅获 55.4 分)的表现反而不如小模型。原因在于大模型更倾向于按照自己的先验去“重写全局”,即便提示词明确要求只修改指定区域,它们也常常引发无关区域的 CSS 样式错位或全局排版塌陷,从而在 $\mathbf{S_{outbox}}$ 上遭遇重大失分。
2. 微观定位精度不足,但未动区域保护良好
在微观修改任务中,多数模型的 $\mathbf{S_{outbox}}$ 保全分普遍达到了 0.95 以上,表明模型已经学会了“不乱动其他代码”。然而其箱内修复得分($\mathbf{S_{inbox}}$)波动剧烈,最高的 Doubao-Seed-2.0-Pro 达到 83.5 分,而部分模型则完全无法准确将视觉提示映射到底层具体的 CSS 属性(如特定的 flex 间距、字体行高或透明度值),暴露出当前多模态模型在细粒度“视觉-代码映射”上的能力欠缺。
3. 文本描述有时反成“视觉毒药”
直觉上,如果在提供参考截图的同时附带详细的文本描述(Caption),模型的重构质量应该提升。但消融实验显示,文本描述带来的影响并不稳定:Gemini-3.5-Flash 得分提升了 6.3 分,但 Kimi-K2.6 与 Claude-4.7-Opus 的表现却分别下降了 4.5 分和 4.4 分。原因在于语言描述往往带有强烈的语义抽象,可能会冲淡精确的视觉空间布局与组件层级关系,导致模型过度信赖文本提示,进而与真实视觉结构发生冲突。
误差放大效应:被低估的“错误滚雪球”
多轮代码编辑中最致命的隐形杀手是“错误累积”(Error Snowballing)。为了证明这一现象,研究团队对比了“链式编辑”(当前轮基于上一轮模型的实际输出修改)与“独立编辑”(每一轮都重置为黄金代码状态)的性能差异。
实验结果清晰地展示了这种断崖式下跌:如果每一轮都给模型一个干净的起点,模型在各轮次的修复质量高度稳定;但在真实的链式多轮交互中,前一轮留下的轻微排版瑕疵或多余标签,会在下一轮被模型继承,并在后续修改中被持续放大,导致页面渲染迅速劣化。这证明单轮代码生成能力完全不能等同于多轮长程维护能力,如何在长交互链路上控制熵增,是下一代 Coding Agent 必须逾越的鸿沟。
从整页生成迈向局部修复与多轮迭代,是代码大模型真正融入前端工业研发管线的必由之路。MT-Web2Code 不仅揭开了现有模型在精细控制、边界感与多轮容错上的不足,其自动化的轨迹构建机制与确定性双轴评测体系,也为未来利用强化学习训练能够自省、纠错并保持长程一致性的前端代码智能体指明了技术路径。