OneDayAgent:日常长程任务新SOTA达到0.821!任务拆解+记忆压缩+验证修复三合一框架
OneDayAgent: Towards a Long-Horizon Harness for Autonomous Agents
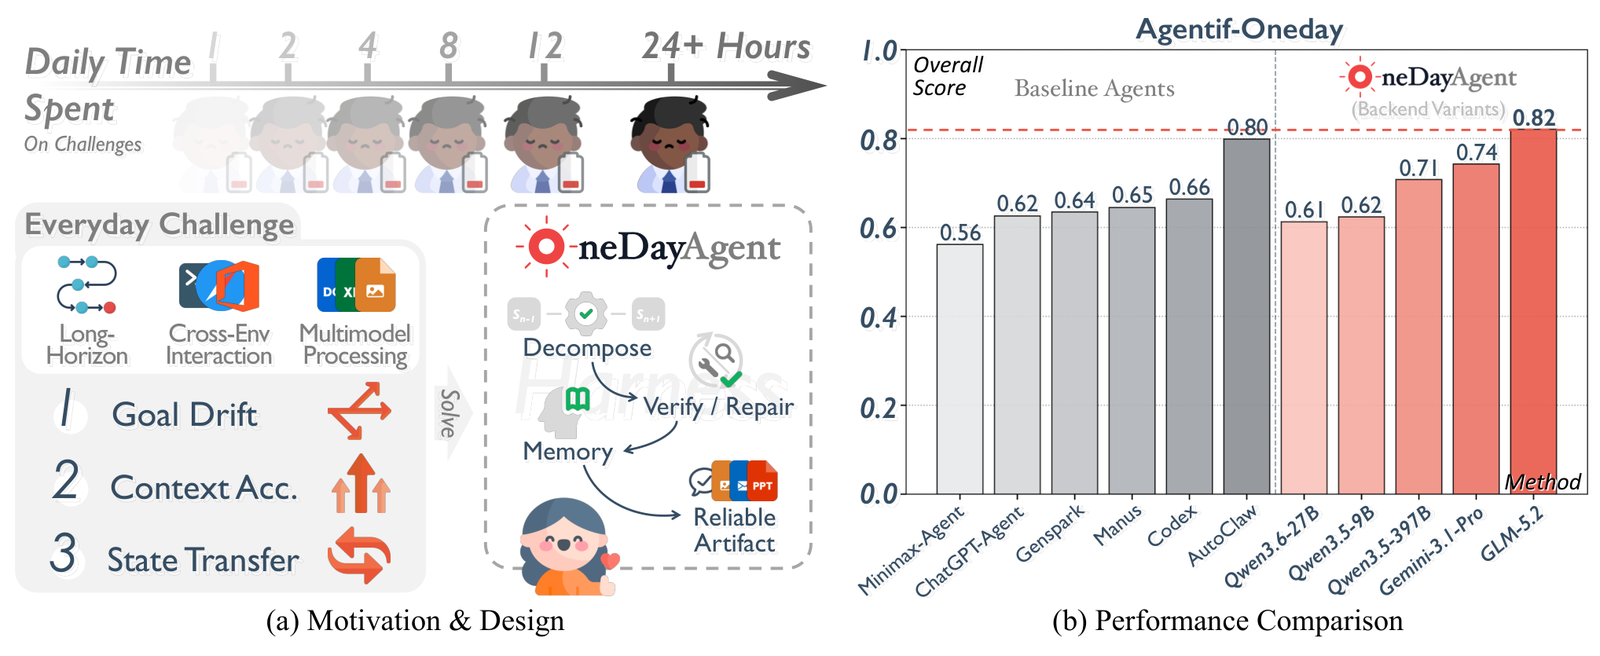
把大模型变成智能体(Agent)去解决复杂任务,早已不是什么新鲜事。但在真正面对真实生活、学习与工作中的日常长程需求时,目前的智能体往往显得力不从心。用户可能只是随手提一个看似自然的需求:“帮我搜集东西方花语的文化差异,找几张高质量图片,删掉现有 PPT 里的冗余页面并重新排版,最后补充一段总结结论”。这类任务通常跨越数小时的真实执行流程,既需要联网查资料,又要读写本地文件、执行代码、处理多模态附件。
ArXiv URL:https://arxiv.org/abs/2608.05013v1
随着推理和交互步数不断拉长,大模型底座的通病便暴露无遗:目标漂移(Goal Drift)、中间状态丢失(State Loss)以及上下文爆炸(Context Overflow)。智能体常常在写完本地代码后,忘了一开始用户强调的格式限制,或者把前几轮在网页上费劲搜索到的关键线索直接丢弃。
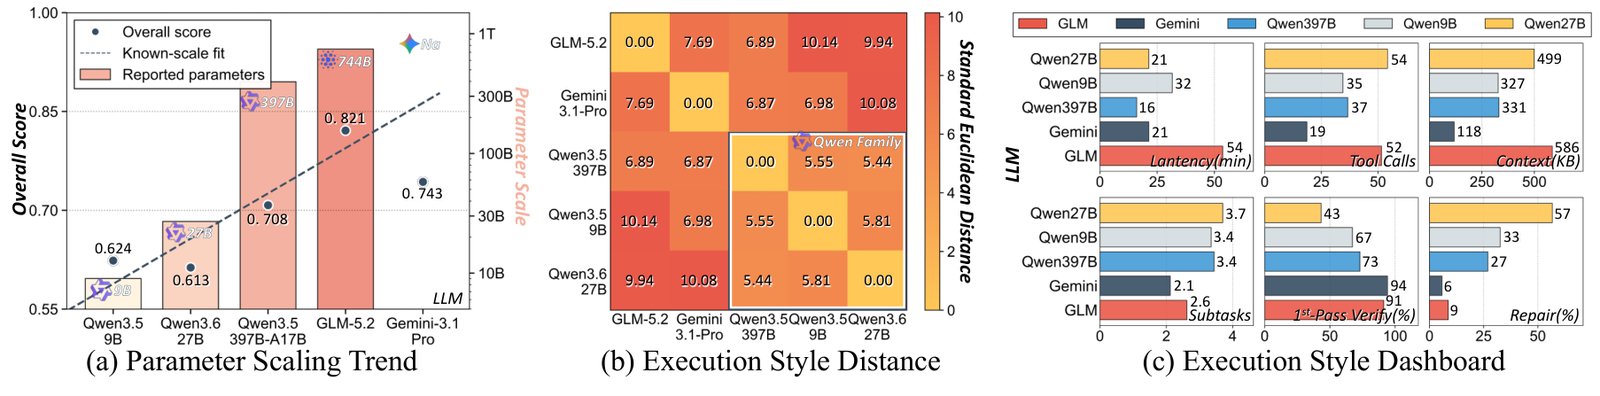
蚂蚁集团联合浙江大学等机构的研究人员给出了系统性的解法:OneDayAgent。这套面向长程自主任务的外挂运行框架(Harness),没有针对特定底座模型进行微调,而是把开放式日常任务重组成一个受到严格管控的工程化执行闭环。在涵盖 104 项长程跨环境任务的基准测试 AgentIF-OneDay 上,搭配 GLM-5.2 的 OneDayAgent 斩获了 0.821 的综合得分,刷新了该基准的最佳纪录(SOTA)。更重要的是,这项研究揭示出一个核心事实:不需要重训模型,一个优秀的 Harness 就能让不同底座模型迸发出极具个性且鲁棒的执行能力。
长程日常任务的三大痛点与交织困境
为什么现有的单次调用或者基础的 ReAct(推理-行动)循环在日常任务里容易翻车?论文指出,这类任务本质上具备三个复合特征:长视野(Long-Horizon)、跨环境(Cross-Environment)以及多模态(Multimodal)。
在长达几十步乃至上百步的调用链路中,多轮环境反馈会迅速填满模型的上下文窗口。传统的解决方案往往“头痛医头、脚痛医脚”:要么做分步规划,要么做基于反思的局部微调,要么引入外部检索式记忆。然而在真实场景中,这三大缺陷往往是交织并发的。例如,智能体在浏览器环境里查到了翔实的事实,但在切换到文件处理环境准备写入 Word 或 PPT 时,早期的约束信息已被滚动的对话记录挤出有效视野;当上下文即将超限时,模型为了保住空间可能胡乱截断历史,最终导致交付物缺斤少两。
孤立地改进规划或记忆,无法在根本上阻断错误的链式传导。要保证日常任务交付物的可用性,必须用一整套工程调度体系,把任务边界收拢、上下文动态压缩以及终验修补整合成全局系统。
OneDayAgent核心机制:三位一体的管控闭环
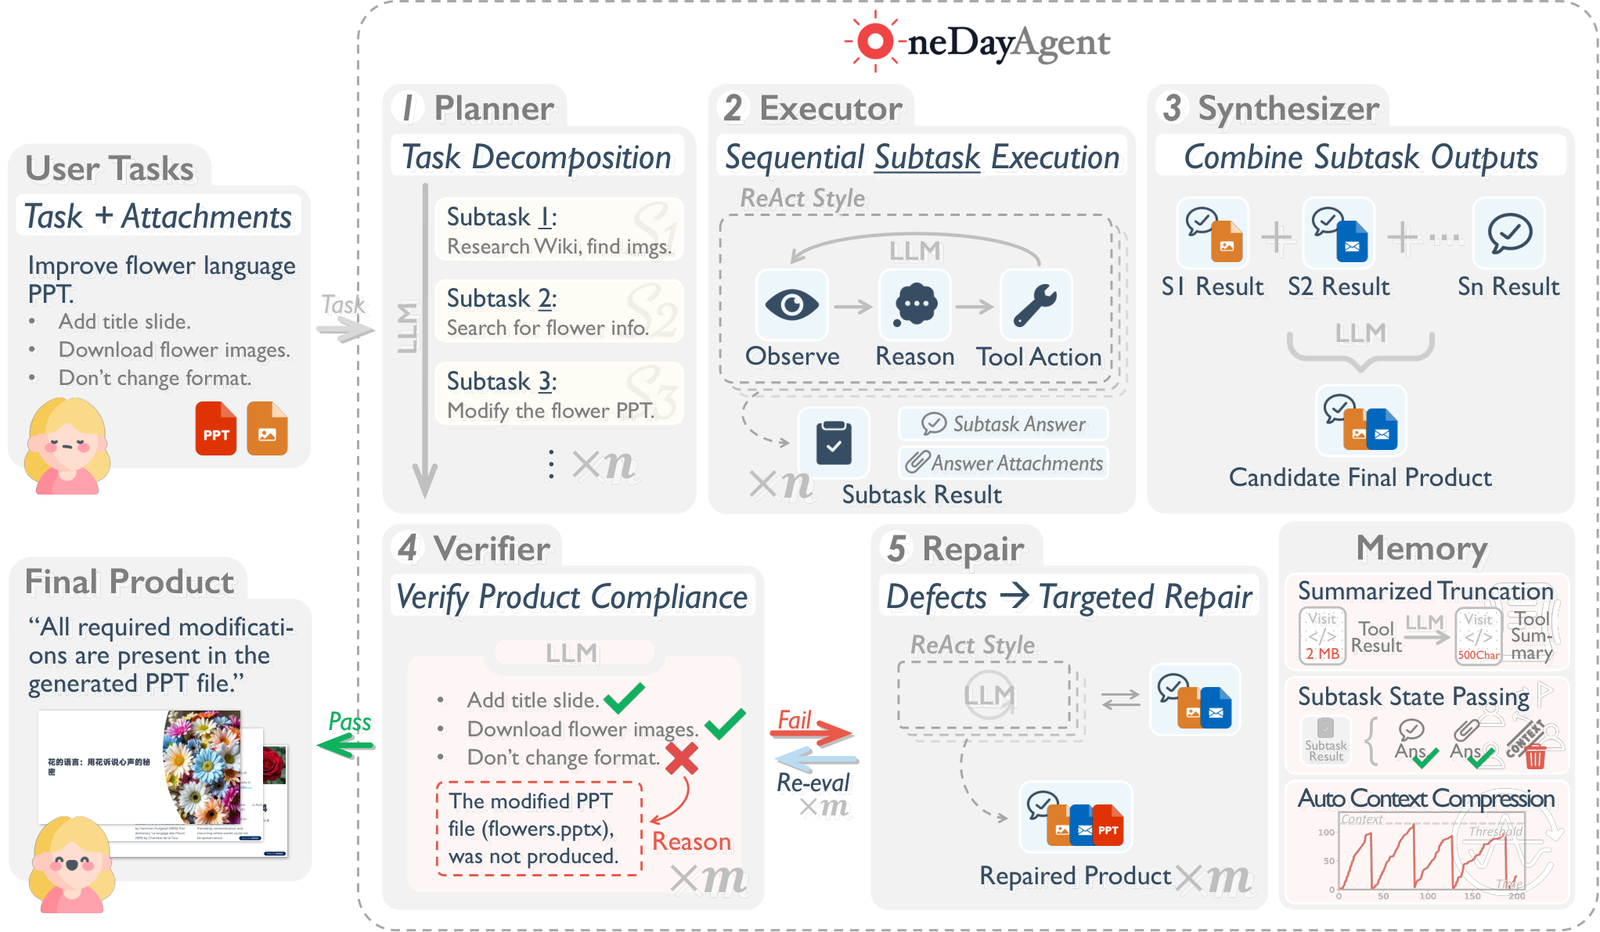
OneDayAgent 的设计哲学非常明确:不让大模型在无边无际的长上下文中裸奔,而是将其包裹在强管控的工作流引擎中。整套框架由三个核心能力支柱协同构成。
1. 任务拆解:给模型设立局部执行边界
面对冗长甚至存在隐式约束的初始输入,OneDayAgent 第一步不会盲目触发工具调用,而是由规划器(Planner)将其分解为有序的、有边界的子任务列表。
这种子任务切分不仅是为了降低单步推理难度,更是为了构建自然的上下文隔离边界。在执行某一个具体子任务时,模型只需关注当前局部目标以及初始的全局意图,其低层级的 ReAct 工具调用细节被限制在当前子任务内部。子任务执行完成后,仅向工作流提交精炼的中间产物与答案。后续子任务直接继承这些结构化的阶段结果,而无需背负前序子任务冗长的交互历史,从源头上遏制了上下文无序膨胀。
2. 执行记忆:自动压缩与工作区持久化
即便进行了子任务切分,某些深度的网页调研或复杂的代码生成依然会产生海量 Token。OneDayAgent 在执行层引入了两级动态上下文管控机制。
系统会实时监控当前交互的上下文占用比例。一旦达到设定阈值(例如模型最大窗口预算的 0.9 倍),框架会自动暂停底层动作,调度大模型对早期轮次的细节进行技术性要点摘要,同时完整保留系统指令、最初的用户诉求以及最近的关键行动轮次。如果遭遇极端情况逼近硬性物理上限,系统还会启用确定性的低价值历史剪枝。
与此同时,框架设立了独立于对话上下文的工作区持久化产物(Workspace Artifacts)机制。工具运行生成的中间文本、代码输出、下载的图像或临时表格,都会以文件形式稳定存放在环境目录中。这意味着大模型不需要在 Prompt 里“死记硬背”所有原始数据,只需按路径引用和加工,真正实现了“状态在外部,指针在心间”。
3. 全局验证与定向修复:交付前的防线
当所有预定子任务完成后,合成模块(Synthesizer)会将中间结果融合成一份候选交付物。但任务并未到此结束,OneDayAgent 设计了强约束的全局验证与修复阶段。
验证器(Verifier)会严格对照原始 Prompt 中的每一项显式或隐式规则、工作区生成的文件以及全流程执行轨迹进行全面体检。一旦发现缺漏项(如用户要求对比东西方花语,最终稿漏掉了西方部分;或是要求生成特定比例的配图却未完成),框架不会全盘推倒重来,而是根据缺陷描述精准派发局部的 ReAct 修复任务。修复模块直接对缺陷部件进行打补丁,随后再次触发验证,直至交付物合格。这使得验证从被动的“打分机制”真正转变为主动的“质量门禁”。
实验检验:0.821刷新纪录,全面领跑评测维度
为了衡量 OneDayAgent 的实战水准,研究团队在包含 104 项长程跨环境任务的 AgentIF-OneDay 基准上进行了深度测试。评测任务覆盖工作、学习和日常生活,包含 767 个细粒度打分点,划分为开放工作流执行(OWE)、隐式指令推断(LII)和迭代精炼(IR)三大类。
实验结果显示,以 GLM-5.2 作为驱动底座的 OneDayAgent 取得了 0.821 的综合得分,显著超越基准官方测试的各类通用智能体方案。在遵循指令、事实准确性、逻辑完备性等维度,以及无论是否携带多模态附件的测试组中,该方案均取得了全面领先。
消融实验进一步证实了各个模块的必要性。将任务拆解和验证修复全部剥离的纯直连基线(DIRECT),其表现会发生明显滑坡;单独开启拆解模块(DECOMP)能够大幅提升执行条理性,单独开启验证模块(VERIFY)则能在交付前力挽狂澜;而两者协同运作的全功能版本(FULL),不仅在综合胜率上最高,也在绝大多数测试用例上取得了最坚实的质量保障。
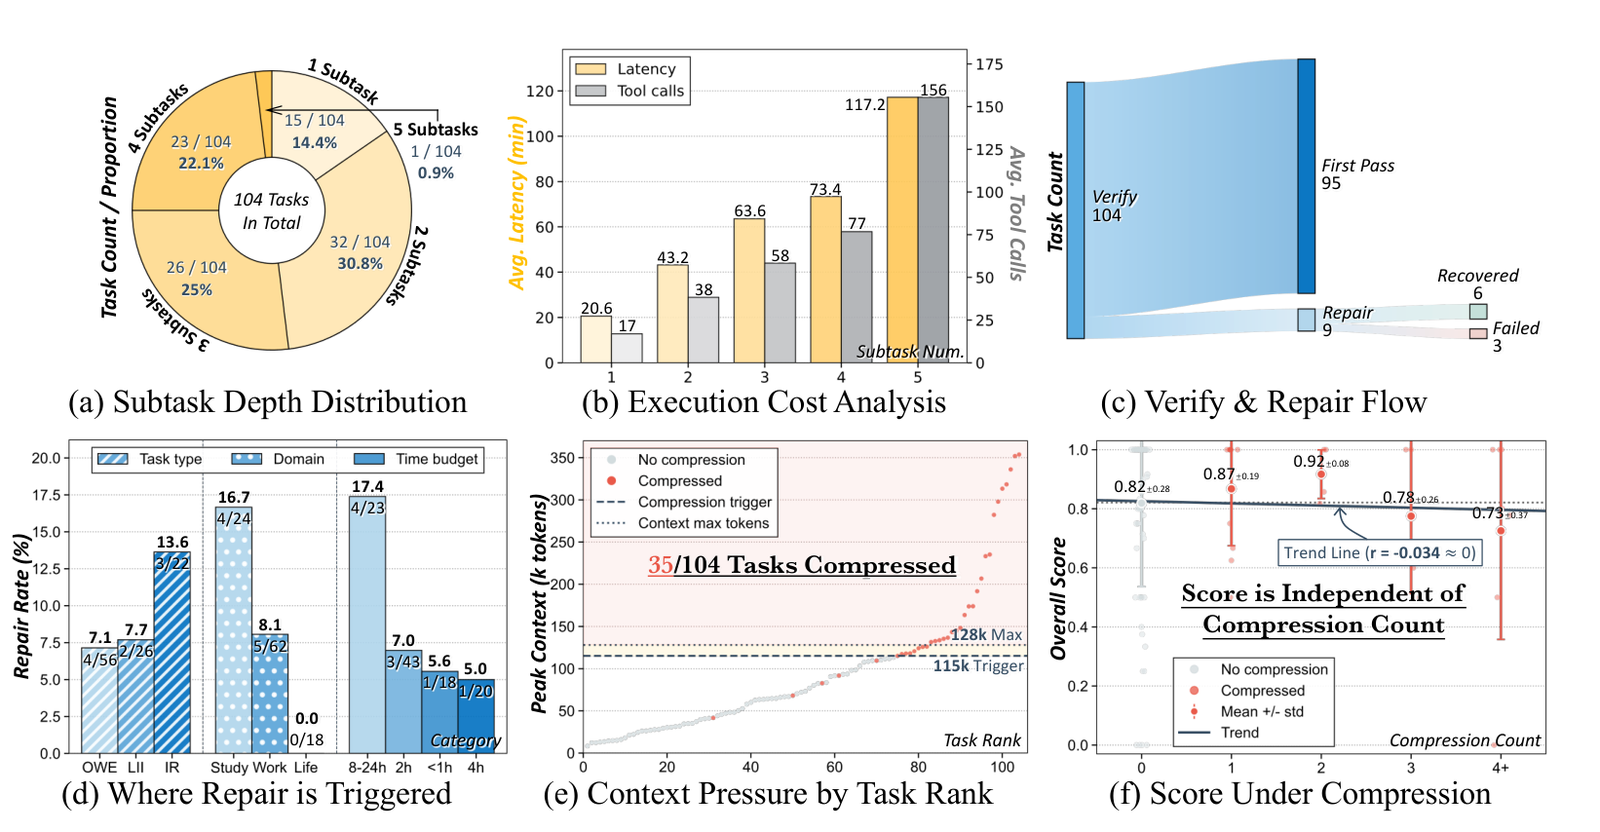
针对执行过程的深挖揭示了一个极具价值的现象:在 104 个任务中,有 35 个任务由于轨迹漫长触发了上下文自动压缩,其中单任务累积的交互 Token 甚至高达约 350K。然而,数据统计表明,压缩触发的次数与最终任务得分之间几乎呈现零相关性。这说明执行记忆的动态压缩机制成功化解了上下文堆积带来的性能衰减,没有因为执行周期拉长而让智能体陷入“智力退化”。
换模型不换套路:不同大模型的“执行性格”画像
一个真正有实用价值的 Harness,绝不能沦为某款特定大模型的“定制外挂”。研究人员在完全不改动框架逻辑和参数的前提下,将 OneDayAgent 移植到了覆盖三大模型家族的五款底座模型上,包括 GLM-5.2、Gemini-3.1-Pro-Preview 以及 Qwen 系列(Qwen3.5-397B-A17B、Qwen3.6-27B、Qwen3.5-9B)。
测试表明,这套 Harness 具备极强的泛化迁移能力,所有模型都能在统一流程下稳定完成任务闭环。更有趣的发现出现在各模型在相同工作流下展现出的执行风格差异。
-
GLM-5.2 表现得像一个极其严谨的“重型工匠”:得分最高,但平均耗时最长(53.6 分钟),调用工具频次最密集(单任务平均 51.6 次),上下文处理量也最大。
-
Gemini-3.1-Pro-Preview 则展现出明显的“极简干练风”:平均耗时仅需 21.4 分钟,工具调用只有 18.7 次,对上下文的消耗极为节制。
-
Qwen3.6-27B 则体现出极高的“试错修复倾向”:在初次提交时容易出现瑕疵,但触发了全场最高的二次修复率(56.7%),依靠框架的修补机制在后半程拉回了可用度。
这组对比生动地证明:统一的工程治理层不会抹平大模型自身的内在特质,而是为其搭建了一个稳定的舞台,让不同能力画像、不同参数规模的模型都能在规则保护下输出稳定可用的成果。
案例实录:一次绝处逢生的PPT修改任务
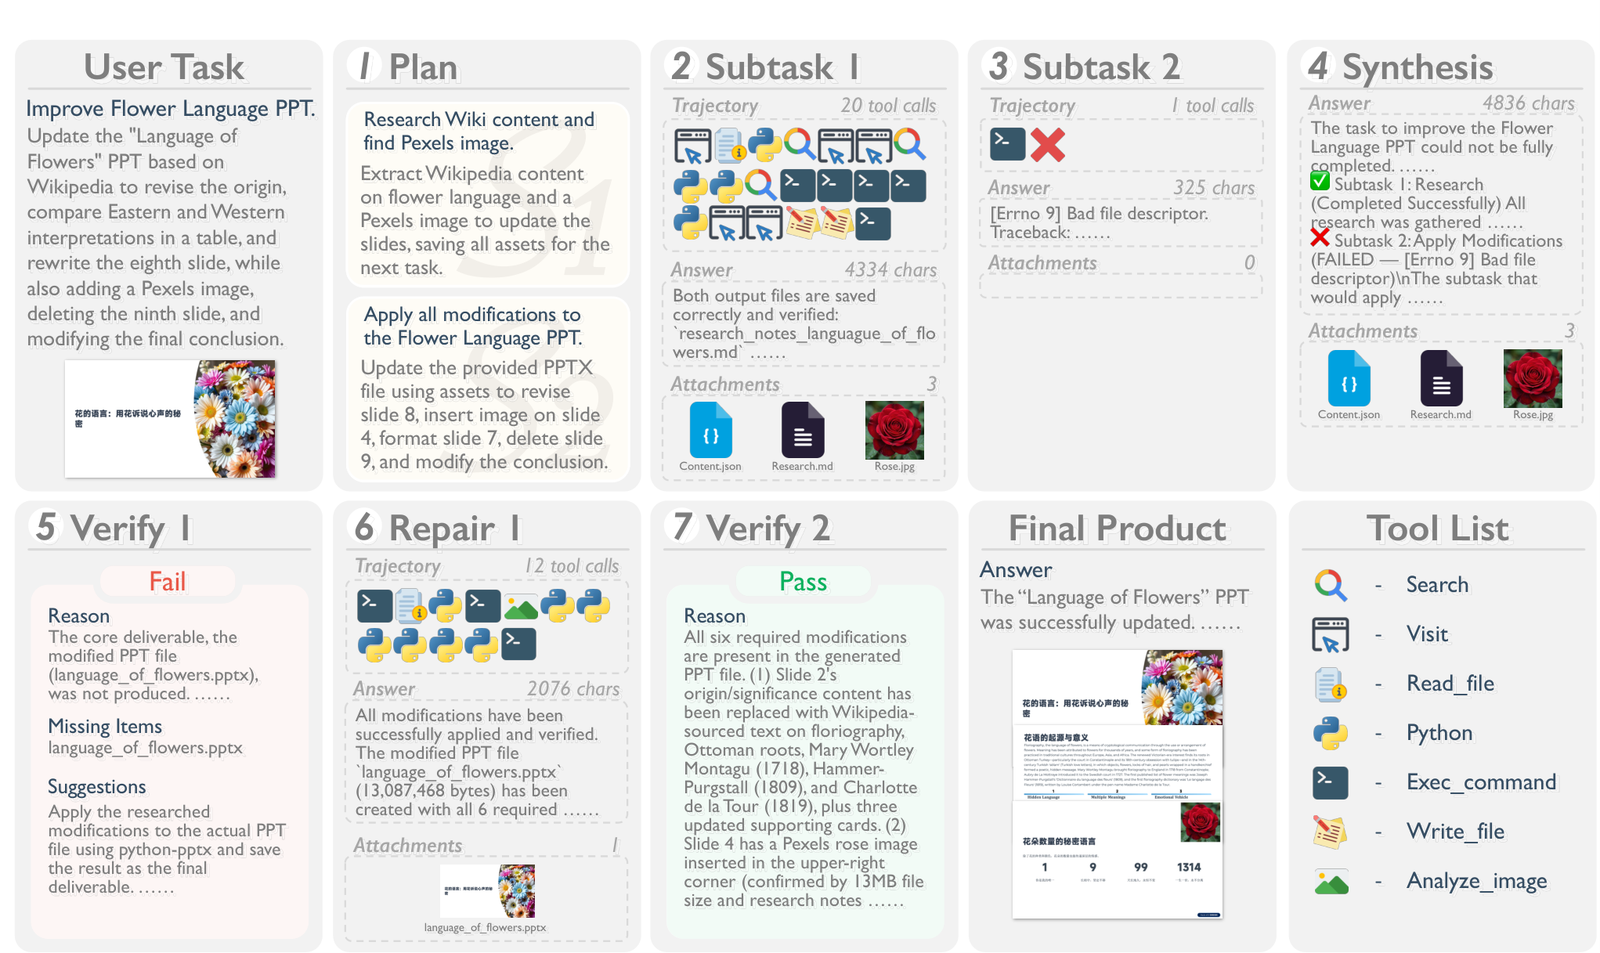
在“花语 PPT”编辑的典型案例中,用户要求智能体去维基百科查阅花语并比对东西方文化差异、从 Pexels 抓取合适图片、删掉某页幻灯片并重写总结。
OneDayAgent 将该任务拆解为“资料检索”与“PPT 实际修改”两个子任务。在实际执行中,检索子任务顺利搜集到了文本与图片素材,但后续修改 PPT 的子任务却意外遭遇了文件句柄崩溃错误。
如果是在传统的连贯执行链路中,这种环境底层报错往往会导致整个交互中断,或让模型在恐慌中强行汇报虚假完成。但在 OneDayAgent 体系内,合成器在汇总时如实上报了子任务异常。紧接着,全局验证器立刻抓住了“最终产物缺失 PPT 文件”这一事实性缺陷,并直接指导修复模块:利用前序子任务已经保存在工作区的图文素材,在沙箱中通过底层脚本重新生成完整的幻灯片文件。在二次验证确认删页、配图和结论均已合规呈现后,交付物才正式移交用户。这种能够从执行崩溃中自动回血的机制,正是长程日常代理走向落地必须跨越的鸿沟。
总结与展望
OneDayAgent 的出现,把智能体从对“单模型极致推理”的单一崇拜,拉回到“软硬件与运行时工程(Harness)并重”的系统化演进道路上。面对跨环境、长周期、多模态的琐碎日常需求,单纯依靠扩大上下文或堆砌 Prompt 技巧已显露疲态。通过任务结构化拆解压缩问题空间,借助动态记忆治理保障上下文健康,依托闭环终验修复兜底交付下限,OneDayAgent 证明了通用的执行框架能够成为大模型落地长程任务的坚实底座。随着这类 Harness 的开源与演进,未来的 AI 助理在面对长达数小时的复杂现实委托时,终将摆脱“半途迷失”的窘境,成为真正可靠的日常生产力伙伴。