CUDAPerf:打破黑盒测速!融入并行结构奖励,CUDA生成最高提速5倍
Multi-turn RL with Structural and Performance Aware Rewards for CUDA Kernel Generation
在高性能计算(HPC)和深度学习基础设施的工程实践中,手写低级别并行算子一直是最昂贵、门槛最高的工作之一。尽管大语言模型(LLM)在常规代码合成上展现出了惊人的效率,但在面对底层 GPU 编程(特别是 CUDA)时,常常显得力不从心。写出一段能通过编译的 CUDA 代码并不算太难,但要让它在吞吐量、访存延迟和计算单元利用率上达到甚至超越人类专家的调化水平,则需要对 GPU 微架构有极其深刻的理解。
ArXiv URL:https://arxiv.org/abs/2607.20908
近期兴起的可验证奖励强化学习(Reinforcement Learning with Verifiable Rewards, RLVR)为大模型代码优化提供了新路径。已有方案通常将代码生成置于“沙盒编译—测试用例比对—测速”的反馈回路中,依靠黑盒运行结果进行策略梯度更新。然而,这种仅仅依赖“是否正确”与“耗时缩短了多少”的黑盒结果奖励,忽略了决定算子性能的底层结构特征。
针对这一瓶颈,研究人员提出了 CUDAPerf 框架。该方案打破了仅凭执行耗时做强化学习的传统思路,将访存合并(Memory Coalescing)、算力利用率(Occupancy)、算术强度(Arithmetic Intensity)和同步分支等 GPU 并行程序的核心结构属性显式建模为结构化奖励。结合两阶段排序学习与多轮在线强化学习,CUDAPerf 在 C $\rightarrow$ CUDA 与 PyTorch $\rightarrow$ CUDA 两个核心翻译基准上取得了显著突破,相比 Qwen-3-32B 和专门的 CUDA-Agent 实现了最高 5 倍与 3.32 倍的执行加速比,同时在生成正确率上取得了显著提升。
为什么大模型写不好高效 CUDA?
大模型生成 GPU 算子的根本困境,在于“表层语法正确”与“底层硬件契合”之间的巨大鸿沟。常规的软件逻辑往往遵循串行思维,只要时间复杂度合理、逻辑分支无误,代码就能在 CPU 上良好运行。但现代 GPU 是高度并行的流式多处理器(SM)架构,一个核函数要想跑得快,必须迎合硬件的设计约束。
例如,当同一个 Warp 内的 32 个线程访问连续的全局显存地址时,硬件能够触发合并访存(Memory Coalescing),单次事务即可完成数据搬移;一旦访问模式离散,原本一次请求就会退化为几十次独立的内存事务,导致访存流水线严重阻塞。再如分支分化(Divergence),当条件分支导致同一 Warp 内的不同线程执行不同的代码路径时,硬件只能通过串行掩码执行各分支,计算吞吐直接腰斩。此外,每个 SM 上活跃的线程块(Thread Block)数量受限于寄存器和共享内存(Shared Memory)的用量,过高的局部资源消耗会导致硬件占用率(Occupancy)骤降,无法隐藏内存访问延迟。
以往采用强化学习训练代码生成模型的系统,往往把执行环境当成不可窥视的“黑盒”。模型给出一段代码,评测环境回传“编译失败”“错误输出”或者“耗时 2.5 毫秒”。这种粗粒度的标量奖励对高维策略空间而言极其稀疏。模型可以观测到结果好坏,却不知道“为什么好”或“坏在哪里”。为了跳出局部最优,模型往往退化为在随机排列组合中撞大运,难以学到如分块加载到共享内存、向量化访存(float4)等专家级优化模式。
CUDAPerf:从黑盒测速到白盒并行结构感知
CUDAPerf 的核心洞察在于:优化 CUDA 算子不能仅看输出指标,必须把体系结构领域的白盒特征直接引入奖励机制,让模型不仅知道“最终跑得快不快”,更理解“什么样的并行结构会导致更快的执行”。
整个框架由两大部分协同驱动:离线的成对排序模块(Offline Pairwise Ranking Module)与在线的强化学习训练阶段(Online RL Training Phase)。
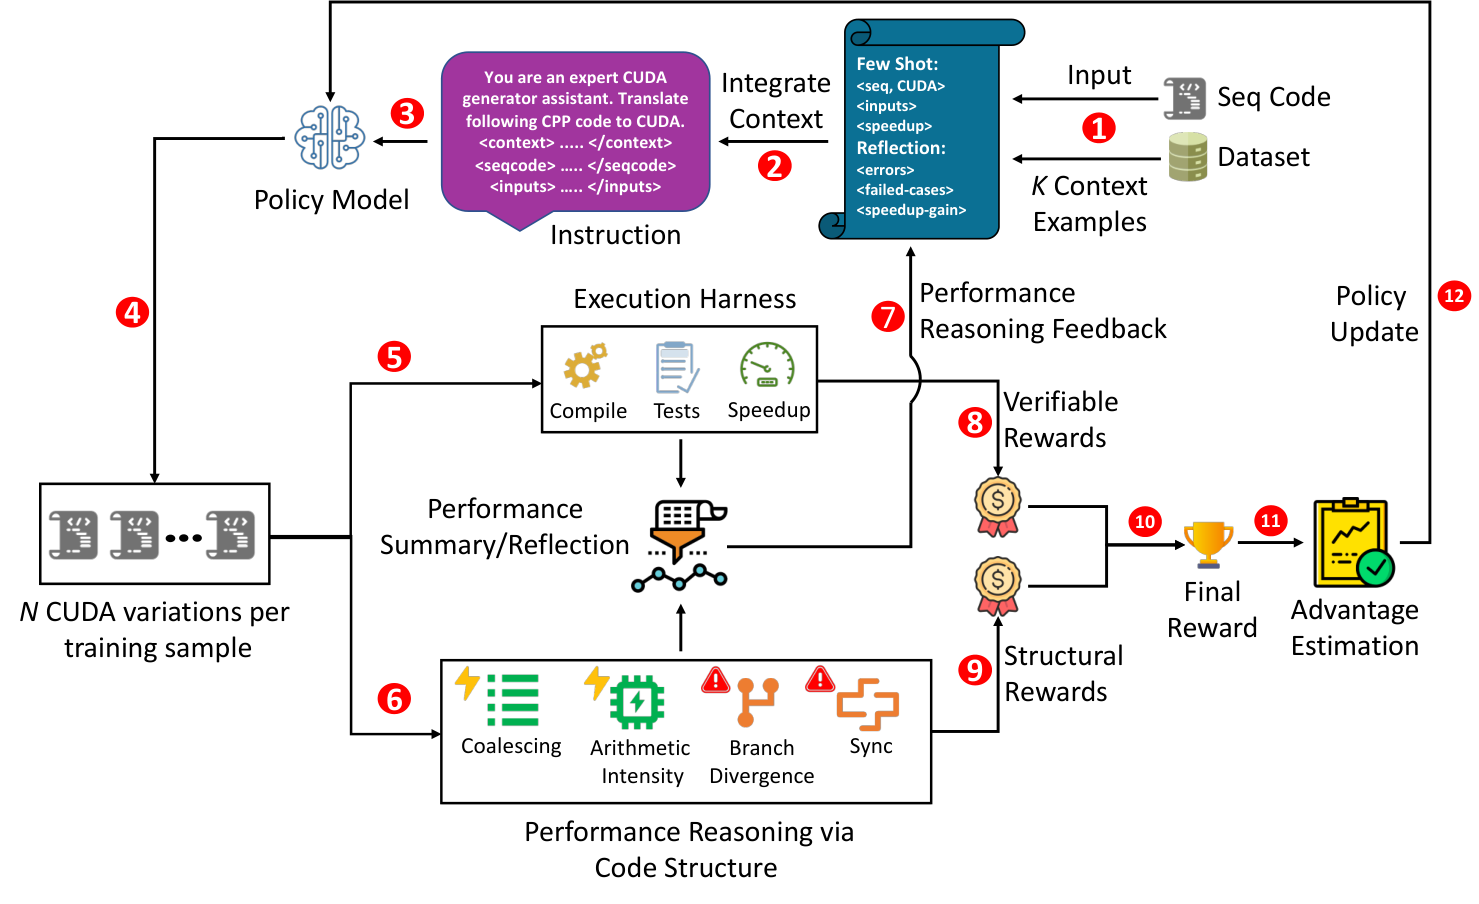
框架首先通过静态分析与剖析工具提取候选 CUDA 算子的关键特征向量 $\phi(y)$。这组特征涵盖了影响 GPU 效率的核心维度:
\[\phi(y)=[\texttt{coal},\texttt{ai},\texttt{occ},\texttt{div},\texttt{xfer},\texttt{atomics},\texttt{syncthreads},\texttt{kernels},\texttt{tpb},\texttt{gmem\_access},\texttt{ops}]\]在这些特征中,$\texttt{coal}$ 刻画了内存访问的合并程度;$\texttt{ai}$ 代表算术强度,即每字节内存传输对应的浮点运算量;$\texttt{occ}$ 表示理论与实际的 Warp 占用率;$\texttt{div}$ 追踪控制流分支的分化情况;$\texttt{xfer}$ 和 $\texttt{atomics}$ 则分别监控主机与设备间的数据拷贝开销以及原子操作频率;此外还包括块内同步屏障调用($\texttt{syncthreads}$)、启动的核函数数量、每个块的线程数($\texttt{tpb}$)以及底层运算指令统计。
在离线阶段,研究团队利用这些特征构建了一个轻量级评分模型 $s_\psi$。给定同一串行程序的两个不同 CUDA 实现 $(y^+, y^-)$,其中 $y^+$ 在执行剖析中展现出更优秀的性能与硬件契合度,模型通过成对排序损失进行对比训练:
\[\mathcal{L}_{\mathrm{rank}}(\psi)=\mathbb{E}_{(y^{+},y^{-})}\left[\log\left(1+\exp\left(-(s_{\psi}(\hat{\phi}(y^{+}))-s_{\psi}(\hat{\phi}(y^{-})))\right)\right)\right]\]经过充分对比学习的 $s_\psi$ 模型,本质上凝练成了一个面向 GPU 微架构的“软性评审员”。在后续的在线强化学习阶段,它可以针对任意新生成的候选算子给出结构先验得分 $R_{\mathrm{str}}(y) = s_\psi(\hat{\phi}(y))$。这种设计为强化学习策略引入了强烈的结构诱导偏置(Structured Inductive Bias),在代码甚至未进入微基准测试之前,就已经对糟糕的访存与线程分配施加了抑制信号。
复合奖励驱动的在线强化学习
在在线训练阶段,目标是为给定的串行输入程序 $x$(如 C 语言循环或 PyTorch 模型算子)学习条件策略 $\pi_\theta(y \mid x)$。该策略需要最大化复合奖励函数的期望:
\[\pi_{\theta}^{*}=\arg\max_{\pi_{\theta}}\;\mathbb{E}_{y\sim\pi_{\theta}(\cdot\mid x)}\left[R_{\text{ver}}(y,x)+R_{\text{str}}(y,x)\right]\]在线优化采用了基于组相对策略优化(GRPO)的形式,在多卡环境下对候选算子集合进行相对优势计算,从而省去了维护昂贵价值函数网络(Critic Network)的内存负担。生成代码在沙盒环境中的执行验证反馈被形式化为可验证奖励 $R_{\text{ver}}(y,x)$,由四个层次递进的子项构成:
-
编译奖励 $R_{\text{comp}}(y)$:如果 CUDA 代码存在语法错误导致
nvcc编译崩溃,直接施加固定惩罚 $-\alpha_{\text{comp}}$(实验取 3.0);编译通过则为 0。 -
正确性奖励 $R_{\text{corr}}(y)$:代码即使能编译,其多组随机测试输入的数值输出必须与基准实现吻合。以测试用例通过率 $p(y) \in [0, 1]$ 为基础,施加比例惩罚 $-\alpha_{\text{wrong}} \cdot (1 - p(y))$(实验取 $\alpha_{\text{wrong}} = 2.0$)。
-
性能加速比奖励 $R_{\text{speed}}(y)$:只有当所有测试用例 $100\%$ 通过(即 $p(y)=1$)时,性能奖励才被激活。设相对于原始实现的加速比为 $S$,通过截断的对数函数进行平滑放缩:$\alpha_{\text{speed}} \cdot \text{clip}(\log_2(S), s_{\min}, s_{\max})$。参数中 $s_{\min}=-0.5$(容忍轻微降速),$s_{\max}=4.0$(防止极端情况下的异常高奖励主导梯度,限制在最高 16 倍加速)。
-
性能稳定性惩罚 $R_{\text{cv}}(y)$:GPU 运行时受调度抖动、缓存热身等因素影响,测试时间存在波动。设计引入变异系数惩罚 $-\alpha_{\text{cv}} \cdot \mathrm{cv}(y)$,强迫模型生成的代码不仅跑得快,而且多次运行的延迟方差极低。
这种组合形成了一个阶梯式的门控反馈逻辑:无法编译的代码只承受编译惩罚;算错结果的代码在正确性上扣分;唯有功能完全正确的代码,才会将加速比、方差稳定性和基于白盒特性的结构奖励 $R_{\text{str}}(y)$ 叠加结算。
为了支撑上述算法的高效收敛,作者构建了一个规模可观的高质量专用数据集,包含 2.9k 个 C $\rightarrow$ CUDA 任务与 1k 个 PyTorch $\rightarrow$ CUDA 任务。每个任务不仅配有不同维度的测试输入配置,还覆盖了从基线版本到高度分块(Tiling)、共享内存缓存等多样化策略的人工优化实现,为成对排序和离线微调打下了坚实基础。
基准实测:多任务下的加速突破
评测实验以 Qwen-3-32B 作为基座策略模型,在两张配备 40GB 显存的 A100 GPU 上采用 QLoRA 进行在线强化学习微调。为了避免测试测速与反向传播的资源冲突,系统严格将 CUDA 测试执行隔离在独立的单卡物理环境中。
在 C 语言串行循环向 CUDA 核函数翻译的任务中,CUDAPerf 分别在团队自建测试集以及经典的 BabelTower 基准上进行了系统测试。对比对象既包括商业闭源顶尖推理模型 OpenAI o4-mini、开源基座 Qwen-3-32B,也涵盖了学术界此前针对该领域定制的 QiMeng-MuPa 框架。
实验数据表明,在 CUDAPerf 自建数据集上,该方案的代码生成正确率相比闭源的 o4-mini 高出 48 个百分点,几何平均加速比提升达 9.72 倍;相比基座模型 Qwen-3-32B,正确率提升了 17 个百分点,获得了 4.82 倍的额外加速。在 BabelTower 数据集上,即便与同样强调翻译与验证协同的专门系统 QiMeng-MuPa 相比,CUDAPerf 在保持相当正确率的同时,生成的算子运行速度也达到了后者的 3.01 倍。这说明显式的硬件特征奖励确实在驱动模型摆脱浅层循环展开,走向更深层次的访存重排。
在更贴近工业界深度学习部署的 PyTorch $\rightarrow$ CUDA 任务上,评测选用了包含丰富张量变换的 KernelBench 基准。面对目前在该领域处于领先水平的专用代理系统(Agentic Systems),如 Kevin 以及 CUDA Agent,CUDAPerf 展现出了更为强悍的性能表现。在 pass@5 指标下,CUDAPerf 相比 Kevin 和 CUDA Agent 分别取得了 11% 与 7% 的正确率优势,而在最为关键的核函数加速比上,CUDAPerf 较强基线 CUDA Agent 实现了 3.32 倍的跃升;若与未做该专项 RL 的 Qwen-3-32B 相比,加速比提升更是达到了 5.88 倍。
结构特征奖励到底起到了多大作用?
许多关注 RLVR 的研究者常常会提出疑问:仅仅依靠大规模采样和纯执行测速,模型难道不能自行学会访存合并吗?消融实验清晰地给出了否定回答。
为了量化不同奖励信号的实际贡献,研究者设计了严格的剥离实验:分别在关闭结构奖励(仅保留执行 harness)以及关闭可验证执行奖励(仅保留结构评分)的环境下重训模型。
当屏蔽结构奖励 $R_{\text{str}}$、仅依靠黑盒执行耗时与正确率打分时,模型在 CUDAPerf、BabelTower 和 KernelBench 三个基准上的通过率分别下滑了 8%、7% 和 9%,而最终代码的加速比则骤降了 1.72 倍、2.92 倍和 2.11 倍。这一现象揭示了一个事实:黑盒执行测速虽然能提供结果,但在庞大的代码搜索空间中,纯依靠耗时反馈很难引导模型形成规范的访存排布模式;而结构特征就像一个连续的梯度指引,持续将模型推向硬件友好的局部空间。
反之,如果彻底关闭沙盒执行奖励 $R_{\text{ver}}$、仅凭代码结构特征来优化,系统的性能滑坡更为剧烈:正确率直接暴跌 13% 到 17%,加速比下降 2.71 至 4.42 倍。原因在于静态或经验特征模型无法捕捉运行时的动态竞争和数值精度漂移,缺乏沙盒的绝对验证会导致模型产生严重的“高维幻觉”——生成一堆看似高级但根本跑不通或算不准的死代码。两者深度咬合,才是系统能够逼近专家手写性能的根基所在。
此外,基座模型容量的消融对比(从 8B、14B 到 32B)也印证了代码领域的一个普遍规律:更强的基础语义理解能力是吸收复杂系统工程先验的前提。32B 模型在学习线程层次映射、指针运算改写等复杂指令交织任务时,表现出了远超小尺寸模型的吸收效率。
总结与未来展望
CUDAPerf 提供了一种范式转变思路:在大模型探索复杂底层系统软件生成时,不能再将“环境”视作单薄的输出终端,而应当把领域知识(Domain Specific Knowledge)和计算机体系结构度量体系深度嵌入强化学习的闭环之中。
这项工作虽然取得了亮眼的速度提升,但不可否认也面临着所有可验证代码 RL 面临的共性瓶颈。由于在线阶段需要频繁调用 nvcc 进行编译并跑满物理评测用例,大规模并行采样会给硬件集群带来沉重的计算与时间负担。同时,多轮自省微调目前的探索边界依然在很大程度上受限于先验知识所定义的特征集,如何在未知架构(如自研 NPU 或特定 ASIC)上自动诱导并发现全新的硬件特征维度,是未来实现完全自主算子演进的关键命题。
从黑盒端到端猜测到白盒结构感知协同,CUDAPerf 证明了一条清晰的演进道路:让大模型真正理解 GPU 架构的物理机理,AI 在底层基础设施工程中接管专家手写算子的时代,正在比预想中更快地到来。