DynaMAC:样本少20倍胜率高35%,静态示范如何零样本搞定双臂动态协同?
One Hand Watches The Other: Dynamic Multi-Agent Cooperation for Sample-Efficient Bimanual Manipulation in Dynamic Environments
让两只机械臂像人类双手一样天衣无缝地协作,一直是具身智能(Embodied AI)领域的硬骨头。尤其在非结构化或动态环境中,不仅环境中的物体会随时移动或被外界扰动,两只手臂之间的空间相对位置更是时刻在变。一旦某只手在轨迹中遭遇微小推挤,另一只手必须立刻做出毫秒级的动态重规划,否则物品就会脱手掉落或发生硬性碰撞。
ArXiv URL:https://arxiv.org/abs/2607.22119
为了在少量示范样本下快速学会复杂的抓取和操作,机器人学习领域发展出了多流策略(Multi-Stream Policy Learning)。这类方法将机械臂末端的动作解耦并投影到不同物体的局部坐标系(Local Reference Frames)中分别建模,凭借极高的归纳偏置(Inductive Bias),取得了远超传统端到端策略的数据利用效率。然而,传统多流策略建立在一个致命的前提之上:它默认所有的环境参考坐标系都是严格外生(Strictly Exogenous)的,即物体的位置独立于机器人的动作。一旦进入动态环境,或是双臂协同操作时,左臂的运动构成了右臂的动态环境,右臂的位姿变化又反过来牵制左臂,这种相互因果依赖直接击穿了传统多流策略的数学基底,引发严重的“因果崩溃”(Causal Collapse)。
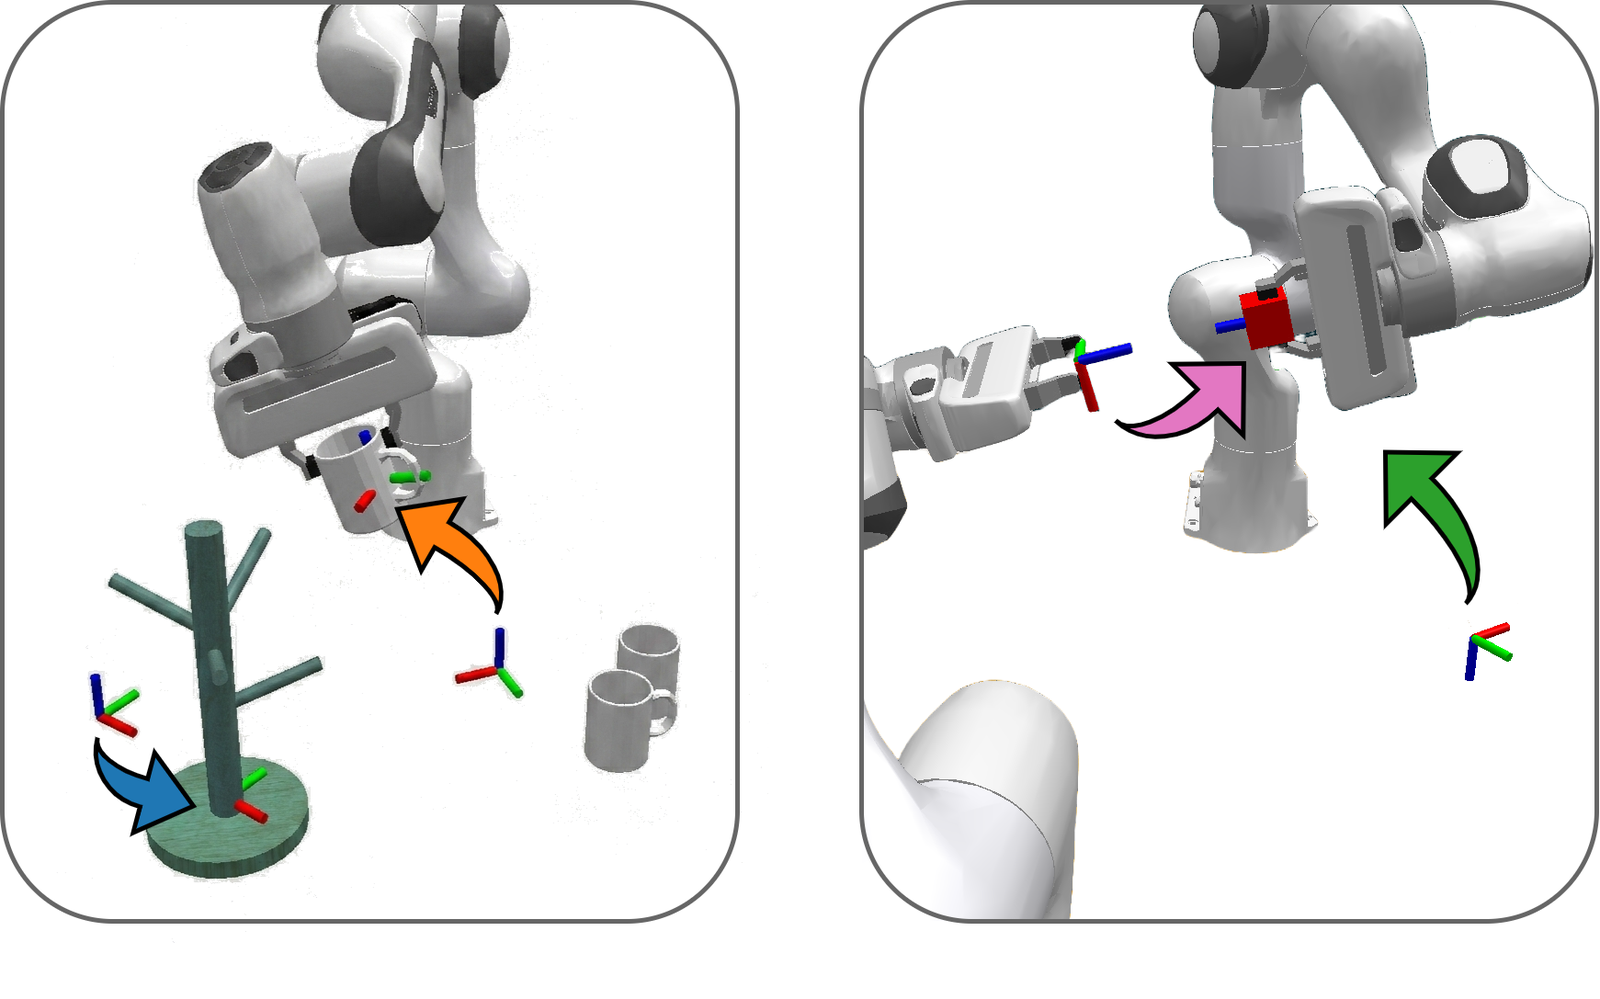
针对这一瓶颈,弗赖堡大学团队提出了一套轻量级且与底层策略无关的全新框架 DynaMAC(Dynamic Multi-Agent Cooperation)。该方法巧妙地将对侧手臂的末端执行器建模为一个动态任务参数(Dynamic Task Parameter),既没有强行指定固定的“主从从属”(Leader-Follower)关系,也不需要训练极其消耗算力的高维全连接策略。实验表明,在论文同步推出的动态基准 DynaBench 以及多项双臂操作任务中,DynaMAC 仅用主流生成式策略 $\frac{1}{20}$ 的样本量,就在成功率上反超最强基线 35 个百分点以上。更具工程价值的是,它完全支持零样本迁移(Zero-Shot Transfer)——在纯静态环境中采集的少量示范数据,部署后可以直接对抗动态移动的目标和机械臂外力扰动,甚至无缝泛化到真实的人机交接场景。
困局:主从架构的僵化与单体模型的低效
在双臂具身操作中,现有的模仿学习方案主要分为三大路线,但各自带有难以调和的工程妥协。
第一类是单体式策略(Monolithic Policies),典型代表是直接用高容量模型(如基于 Transformer 的 ACT 或 Diffusion Policy)联合预测两只机械臂的所有动作。这种方法将动作空间维度直接翻倍,导致样本复杂度呈指数级上升。虽然引入动作分块(Action Chunking)能缓解轨迹发散,但在没有强归纳偏置的前提下,通常需要数百次昂贵的示教才能掌握长程双臂交接任务。
第二类是主从架构(Leader-Follower Architecture)。开发者人为规定一只手为“主手”(Leader),另一只手为“从手”(Follower),从手的策略条件化在主手预测的动作上。这种结构虽然把动作空间解耦,却带来了三大内生缺陷:其一,固定的从属关系无法适应复杂长程任务,现实中主导权往往随阶段动态交替(比如左手递茶杯时左手主导,右手接稳茶杯后转移给右手主导);其二,从手必须等待主手完成推理才能动作,推高了推理延迟;其三,若主手在物理交互中被外界轻微碰撞偏离预设轨迹,级联效应会导致从手彻底丧失纠偏能力。
第三类则是分层架构(Hierarchical Approaches),通过顶层调度器分别协调两只单臂。但这类方案通常只能预测稀疏的关键位姿(Keyposes),在需要精细连续接触控制的受限轨迹(如双臂擦桌子或沿特定轨迹倾倒液体)中显得力不从心。
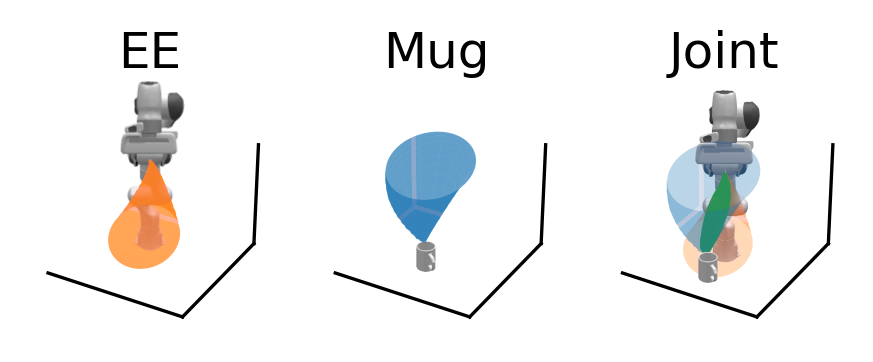
多流策略原本是解决数据瓶颈的极佳选择。如上图所示,在多流学习中,机械臂末端执行器的位姿 $\boldsymbol{\xi}_{\mathrm{ee}} = [\boldsymbol{x}, \boldsymbol{q}]^T$ 会被投影到各个候选参考系 $f$(如桌子边缘、杯子把手、碗口等)的局部坐标系中:
\[\boldsymbol{\xi}_{\mathrm{ee}}^{(f)} = \begin{bmatrix} \boldsymbol{q}_{f}^{-1}(\boldsymbol{x}_{\mathrm{ee}} - \boldsymbol{x}_{f})\boldsymbol{q}_{f} \\ \boldsymbol{q}_{f}^{-1}\boldsymbol{q}_{\mathrm{ee}} \end{bmatrix}\]每个局部流独立学习末端位姿的概率分布,推理时再利用专家乘积(Product of Experts, PoE)根据各参考系的精度矩阵(Precision Matrix)进行加权融合:
\[p\left(\boldsymbol{\xi}_{\mathrm{ee}} \mid \{f\}_{f=1}^{F}\right) \propto \prod_{f=1}^{F} p(\boldsymbol{\xi}_{\mathrm{ee}} \mid f)\]这种机制天生对环境杂物具备鲁棒性,因为与任务无关的背景物体的局部流精度极低,会在融合阶段被自然过滤。但问题在于,一旦这些参考系 $f$ 自身是动态运动的,抑或是另一个具有因果反馈的机械臂,上述公式直接失效。
破局点:把另一只手视作“动态任务参数”
DynaMAC 的核心洞见在于:打破主从架构的人为设定,将双臂协同退化为两组并发运行的“动态多流策略学习”。
从左臂的视角来看,右臂并非需要显式通信或严格服从的主管,而只是外部环境中一个能够自主移动、带有空间位姿的动态实体。反之亦然。DynaMAC 将对侧手臂末端的位姿直接纳入候选任务参数池(Candidate Task Parameters)。
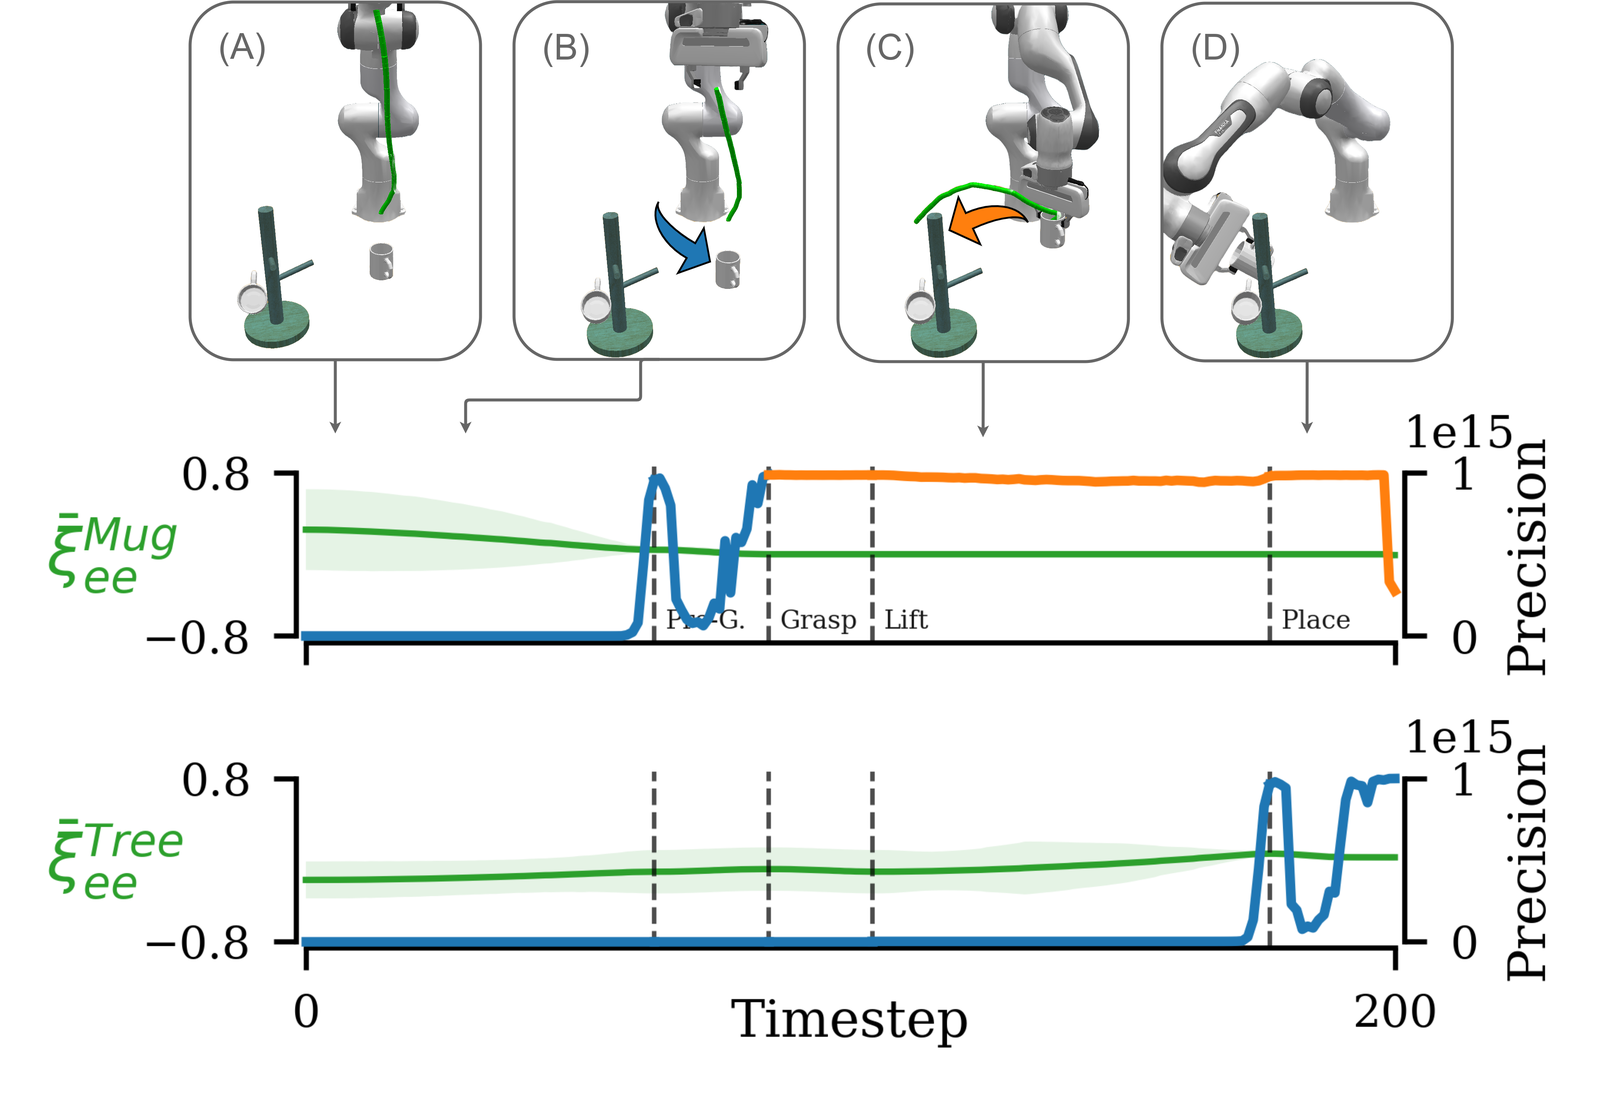
这样一来,“谁是主导者”不再是一个静态写死的超参数,而是变成了一种随任务阶段动态涌现的统计特性。在物品交接阶段,接收臂的多流模块会检测到对侧末端位姿处的精度极高,于是对侧手自然成为局部空间的主导吸引子(Attractor);当物品抓取完毕、各自分工搬运时,对侧手参考系的精度迅速下降,两臂又各自以工作台或目标容器为核心坐标系展开作业。
然而,要让这套机制在动态环境中稳定运作,必须解决动态坐标系下的运动学因果问题。如果目标物体或对侧手臂突然发生加速或突跳,简单的局部坐标变换会导致末端执行器产生不符合物理定律的速度跳变。
为此,DynaMAC 引入了运动学分析校准与虚拟参考系机制。在多流选择阶段,算法依据观测协方差计算各任务流的相对确定性:
\[M_{t}^{(f)} = \left\lvert \det\left(\boldsymbol{\Lambda}_{t}^{(f)}\right) \right\rvert^{-\frac{1}{2d}}\]并定义全轨迹上的时间窗口权重:
\[\omega(f) = \max_{t=1}^{T} \frac{\det\left(\boldsymbol{\Sigma}_{t}^{(f)}\right)^{-1}}{\sum_{c=1}^{C} \det\left(\boldsymbol{\Sigma}_{t}^{(c)}\right)^{-1}}\]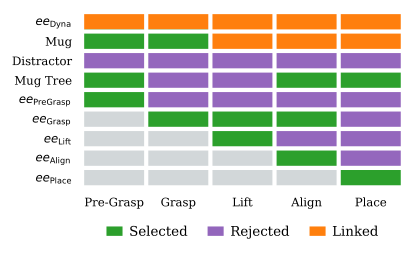
如上图所示,DynaMAC 在执行双臂交接等动作时,能够精准在时间轴上完成流的无缝切换。前半段逼近被抓取物,后半段则完全对齐对侧机械手。整个过程既维持了高精度的密集轨迹控制(Dense Trajectory Control),又保留了高斯流或流匹配(Flow Matching)的轻量计算特性。
DynaBench:严苛的动态操作基准
为了系统化评估具身策略对抗物理世界动态扰动的能力,现有的静态基准(如标准 RLBench)已经捉襟见肘。为此,本文构建了专门的动态评测基准 DynaBench。
在动态场景中构建评测集最大的挑战在于:如何让目标物体的运动轨迹既具备随机多样性,又绝不超出机械臂的可达运动学范围(Kinematic Reachability)。如果随机生成的物体轨迹飞出工作空间,那么失败归咎于策略还是环境本身将无法厘清。
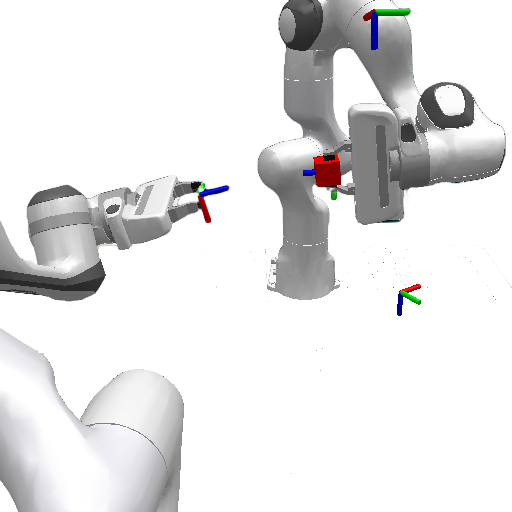
DynaBench 提出了一种精巧的解法:在每一个仿真回合(Episode)开始前,先在工作空间内独立采样并校验两个合法的静态初始配置 $C_1$ 和 $C_2$。随后,环境在任务执行过程中沿着流形将目标状态从 $C_1$ 插值移动到 $C_2$。这种插值可以是平滑的空间连续运动(Smooth Dynamics),也可以是模拟剧烈突变或外部抓取破坏的瞬移式跳变(Teleportation)。由于起点和终点状态都预先通过了运动学可行性反解检验,DynaBench 在确保 $100\%$ 任务可行性的同时,自动覆盖了极其丰富的位移方向、移动距离和变速度组合。
实验决胜:以 1/20 样本实现全维度压制
评测涵盖了单臂静态与动态操作、静态双臂协作、以及带有突发外力扰动的动态双臂协同任务。基线模型涵盖了单体 Transformer 策略、ACT、Leader-Follower 变体、生成式扩散策略(Diffusion Policy)以及高斯流基准 MiDiGaP。
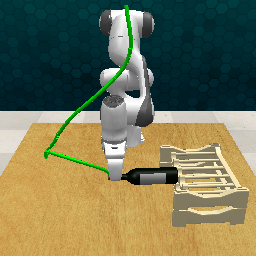
(涵盖红酒堆叠、茶杯精准放置、微波炉开门、擦桌子、物品存储、动态交接、协同托盘提升和双臂扫尘等任务)
在单臂动态测试中,传统多流策略在移除 DynaMAC 的运动学纠偏后遭遇了彻底的“因果崩溃”,擦桌子和开微波炉等任务成功率瞬间归零;而搭载了 DynaMAC 的模型在平滑位移和瞬移扰动下,成功率几乎不受影响。
在更严苛的双臂协同基准上,DynaMAC 展现出了断层式的性能优势:
首先是样本效率的质变。像 ACT 或 Diffusion Policy 这类主流策略,通常需要 100 条以上的完整示教轨迹才能勉强收敛到可用水平;而 DynaMAC 仅需 5 条演示就能在长程协同任务(如双臂开抽屉储物 StoreBottle、托盘平举 LiftTray)中达到极其稳定的动作输出。
其次是动态重协调能力。在 HandOver(空中交接)任务中,研究团队特意加入了动态随机化——交接点的三维坐标在任务开始后随机移动,并且在推理过程中人为给其中一只手臂注入轨迹偏移扰动。实验结果显示:
-
静态多流策略(如原版 MiDiGaP)在遭遇动态干扰时全线崩溃;
-
单体 Diffusion Policy 依靠闭环视觉感知虽然能勉强跟踪物体位移,但只要其中一只手臂遭遇物理推挤偏移,整套协同动作就会严重错位脱节;
-
DynaMAC 在面对手臂受扰时,另一只手在无任何显式指令的情况下自适应跟踪补偿,综合成功率超出现有最佳基线 35 个百分点以上。
消融实验进一步证实,若去掉将对侧手建模为动态任务参数的机制,双臂策略立刻退化为彼此独立的盲目开环系统;虚拟参考系的补充则是保证接触类任务(如擦拭或放置)平滑度、防止控制指令剧烈抖动的核心基石。
落地验证:真机零样本迁移与人机协作
仿真环境下的出色表现能否平移到现实物理世界?研究团队在一台配备双 Franka Emika 机械臂、仅使用单台 RealSense D405 RGB-D 相机的物理工作站上进行了真机验证。
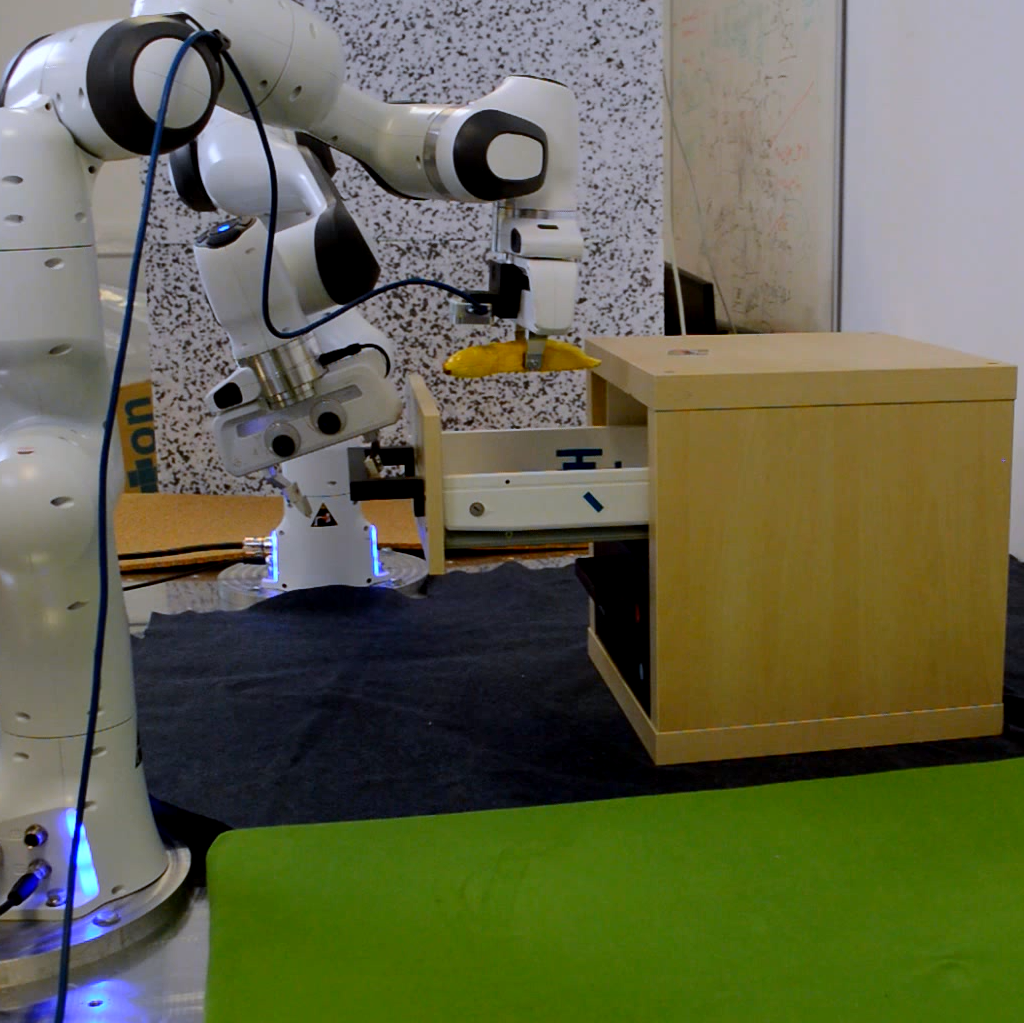
真实环境的任务参数并不依赖真值,而是利用 DINO 视觉特征从 RGB-D 点云中自监督提取关键点作为候选坐标系。在每项任务仅给模型提供 5 次人工示教的极苛刻设定下,DynaMAC 在静态场景、物体动态移动、以及外力推拽手臂三种场景下均展开了 25 轮重复测试。
测试表明,当操作人员在半空中强行挪动物体、或直接用手阻碍某一只机械臂前进时,DynaMAC 能够瞬时降低该流的置信度,由另一只手臂快速前伸迁就补偿,平稳完成托盘举升和空中积木交接。
更令人惊喜的是其向人机协作(Human-Robot Collaboration)的自然延伸。在交接实验中,研究人员将原本给对侧机械臂下发的示教策略屏蔽,让人类实验员用手拿着积木递向机器臂。
由于 DynaMAC 的数学本质是“追踪高置信度的局部动态参考系”,当人类手持物体进入视野范围后,策略立刻自适应将人手及物体识别为主导动态参数。即便人类每次递送积木的高度、角度和伸出速度各不相同,机械臂依然能像预知意图一般准确接应,实现了真正意义上的“静态离线示教,在线零样本自适应人机协同”。
局限性与具身智能的新范式
尽管 DynaMAC 取得了极佳的样本利用率与鲁棒性,但作为多流架构的产物,它仍存在特定的结构性局限:
-
技能分段依赖:长程复杂任务依然高度依赖前端能够将任务合理切分为若干原子技能(Skill Primitive);
-
感知模组解耦:系统需要依赖高质量的目标位姿估计或视觉特征追踪器(如 DINO)。在极端遮挡或剧烈光照突变导致视觉跟踪失效时,策略会出现动作停滞。
然而从系统工程的角度看,这种模块化解耦恰恰是 DynaMAC 相比黑盒端到端大模型的独特优势。它无需每次都端到端重训极其昂贵的百亿参数多模态动作模型,而是可以随时将计算机视觉领域的最新目标跟踪器、零样本分割模型作为即插即用的前端接入。
DynaMAC 用扎实的数学推演证明了一件事:让机器人理解多手协同与动态世界,未必需要堆砌海量算力与百万次示教。通过合理的几何参考系建模与动态参数因果矫正,“一只手注视着另一只手”的优雅机制,足以让机器人在复杂动态交互中展现出媲美生物本能的敏捷与默契。