OpenVisTool:答对不等于学会!商汤与南大提出因果过滤,视觉搜索涨超23分
OpenVisTool: An Open Recipe for Synthesizing Instructive Visual Tool-Use Trajectories
在多模态智能体(Multimodal Agents)的研发中,让模型学会“使用工具主动探索图像”被视为跨越视觉瓶颈的核心能力。受限于固定的图像编码分辨率,传统视觉语言模型经常被小文字、密集符号或复杂的空间几何细节所蒙蔽。为了克服这种“看不清”的生理缺陷,以 OpenAI o3 为代表的系统掀起了“以图像辅助思考”(Thinking with Images)的潮流:模型不再被动接受单次编码,而是像人类一样主动调用工具,对局部区域进行动态裁剪、放大、重绘比对或结构化提取。
ArXiv URL:https://arxiv.org/abs/2608.08557v2
然而,如何教会小模型掌握这种高效的工具调用策略,业界一直依赖一套存在隐性漏洞的流水线。通行的做法是让能力强大的“教师模型”(Teacher VLM)在工具环境中生成轨迹,再通过拒绝采样(Rejection Sampling)筛选出最终答案正确的样本,作为监督微调(SFT)的数据集。来自南京大学与商汤科技的研究团队指出,这种“以结果成败论英雄”的筛选逻辑存在根本性的因果缺陷。一个强大的教师模型即便不看工具返回的新画面,单凭自身强大的参数化记忆、语境推理捷径或模糊全局轮廓,往往也能碰巧蒙对答案。强行让学生模型模仿这种“画蛇添足”的调用,只会教会模型一种虚假的表面相关性:在给出正确答案的同时顺便摆弄几下工具,而从未真正学会依赖工具观察来纠正视觉盲区。
针对这一本质矛盾,研究团队提出了全新的视觉工具轨迹构建框架 OpenVisTool。该工作的核心见解在于:一条有价值的教学轨迹,必须同时满足结果正确性(Outcome Validity)与因果效用(Causal Utility)两个硬性条件。通过三阶段的因果级联筛选,团队构建了覆盖五大核心视觉推理领域的通用工具数据集 OpenVisTool-42K,并在新设立的评测基准 OpenVisTool-Bench 上进行了系统验证。实验证明,在 4B 到 27B 的开源基座上,基于该方法微调的模型均取得了稳健的性能跃升,其中视觉搜索(VisualSearch)任务的绝对增益高达 23.8 分,开源 9B 模型甚至在整体表现上逼近了顶级闭源系统的工具调用水平。
为什么答对的轨迹未必具有教学价值?
在传统的代码解释器或网页检索任务中,中间的工具调用通常直接承载了逻辑演算或信息检索,答案往往直接来自外部环境。但在多模态交互中,工具返回的是新模态的“视觉证据”(Visual Observations)。这带来了一个极为隐蔽的评判难题:模型在最终回答时,到底是因为“看到了”放大的细节,还是单纯凭借强大的先验知识在“背答案”?
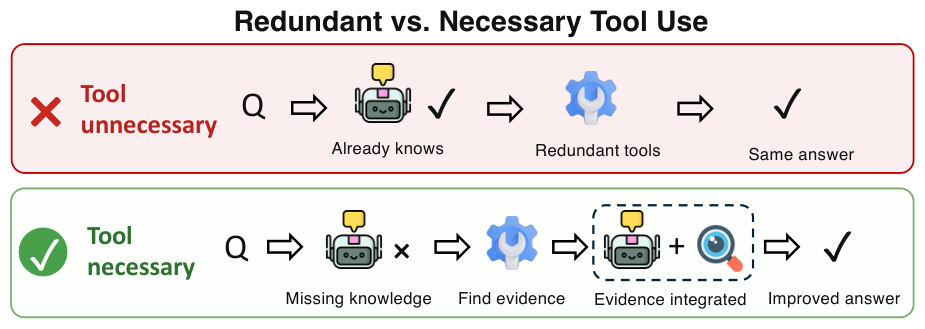
上图清晰地揭示了两种轨迹的本质分歧。在不需要工具的轨迹中,模型被提示词催促着执行了一次裁剪操作,但裁剪出的细节并未真正参与最终决策,教师模型即便把原图输入也能得出完全相同的结论。一旦将这种数据喂给学生模型,学生学到的只是一套仪式化的“空调用动作”;只有在工具真正必要的轨迹中,答案才严格依赖局部放大后的全新视觉细节。
研究团队通过统计现有代表性开源数据集(如 Thyme-2round)发现,如果把教师模型调用工具的权限剥离、仅凭原图重新回答,竟然有高达 60.1% 的训练轨迹依然能够给出正确答案。换言之,现有开源数据集中超过六成的工具调用轨迹很可能并不具备实质性的信息增益,它们充斥着“假性努力”的虚假监督信号。要彻底打破这种知行脱节,监督信号的筛选逻辑必须发生根本性转向:不再仅仅追问“轨迹的结果是否正确”,而是严肃检验“如果把工具返回的视觉观测剥离掉,模型是否就无法可靠地得出该答案”。
检验因果效用:OpenVisTool 的三阶段合成管线
为了将这一因果假设落地为可工程化执行的数据合成管线,OpenVisTool 被划分为三个层层递进的处理阶段:难例筛选(Difficulty Screening)、特定领域轨迹合成(Domain-Specific Trajectory Synthesis)与监督验证(Supervision Verification)。整个管线贯穿了图表分析(Chart)、表格推理(Table)、图形用户界面定位(GUI Grounding)、视觉搜索(Visual Search)以及网页前端还原(Web-to-HTML)五大典型场景,并在底层采用统一的视觉操作工具箱。
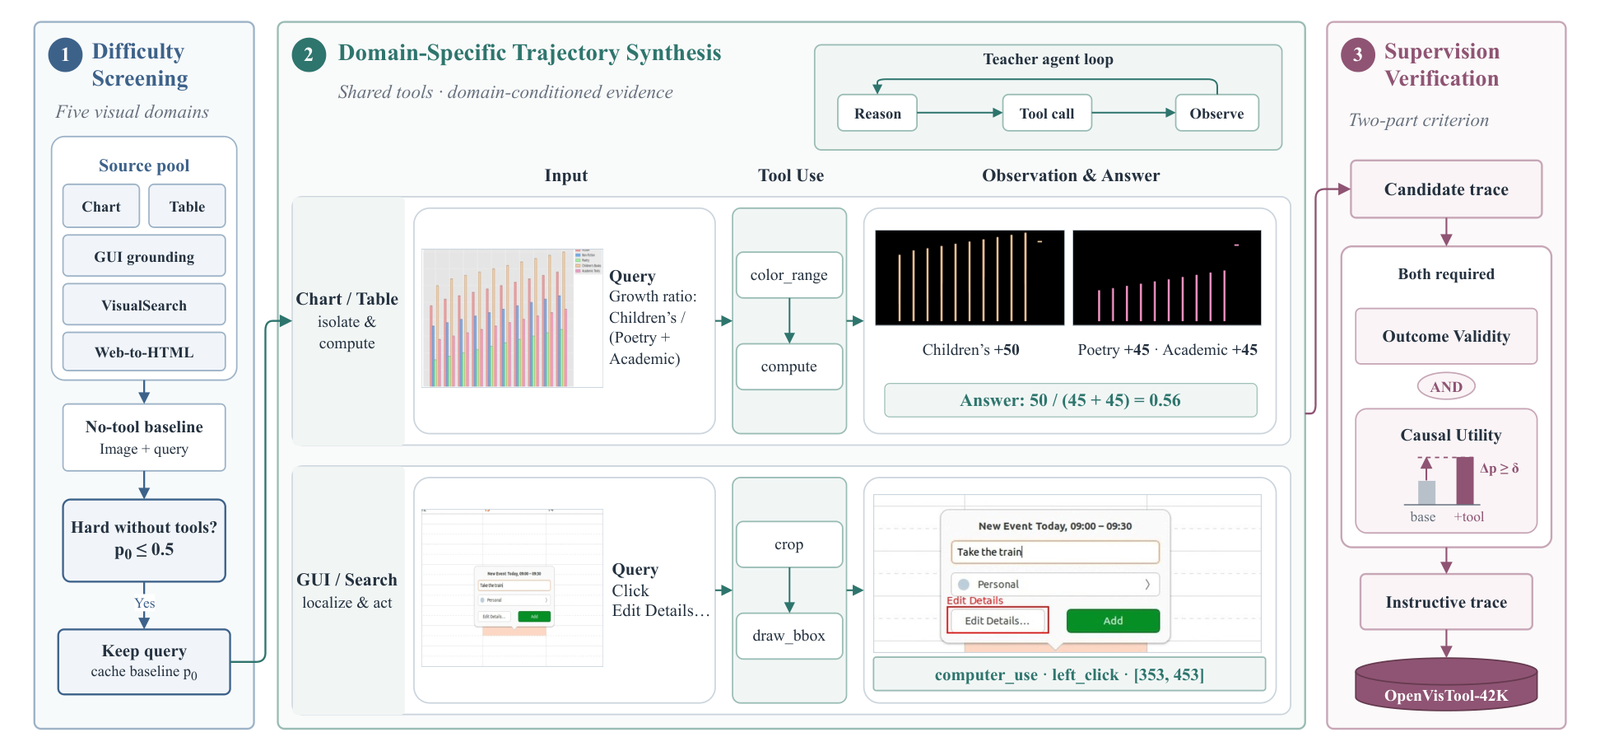
第一阶段是难例筛选(Difficulty Screening)。如果一道题目模型靠原本的低分辨率全图就能轻松做对,那么让其强行调用工具就容易滋生冗余操作。为了从源头截断无用样本,团队引入了一个固定的探针模型 $\pi_0$(具体采用 Qwen3.5-9B),在没有工具接口的环境下对每个候选样本 $x=(I, q, y^\star)$ 进行 $K=4$ 次独立的随机采样测试,计算无工具成功率:
\[\bar{p}_{0}(x)=\frac{1}{K}\sum_{k=1}^{K}E_{d}\left(Y_{\pi_{0}}^{(k)}(I,q),y^{\star}\right)\]只有当探针模型的答对率低于特定阈值(设定 $\gamma = 0.5$,即 4 次独立尝试中至多做对 2 次)时,该问题才被认定为“确实存在视觉感知瓶颈”,从而获准进入下一阶段。
第二阶段是特定领域轨迹合成(Domain-Specific Trajectory Synthesis)。对于幸存的难例,系统选用能力更出色的 Qwen3.5-Plus 充当教师模型 $\pi_{\text{teacher}}$ 进行环境交互。然而,若仅提供一句宽泛的“需要时请使用工具”,强大的教师仍极易产生散漫无序的盲目调用。OpenVisTool 针对不同领域视觉瓶颈的物理特性,设计了具象化的结构引导提示:在图表领域强调整合图例对比与局部序列数值分离;在复杂表格中引导模型先进行行列锚定再检索单元格;在视觉搜索与 GUI 场景中强制执行“粗定位—局部裁剪放大—二次精确定位”的级联策略;而在 Web-to-HTML 任务中则贯彻“生成代码—渲染比对—迭代修正”的闭环反馈。关键在于,尽管各领域的交互逻辑有所差异,底层依赖的却是一套标准化的底层 Python 图像处理 API,确保所习得的交互策略具备跨任务迁移的底层一致性。
第三阶段是整个管线的核心杀手锏:监督验证(Supervision Verification)。在剔除语法崩溃、执行超时或路径失效的格式错误轨迹后,候选轨迹必须同时经受两道严苛的裁判:
-
结果有效性判定:通过各领域严谨的评测器 $E_d$(包括规则答案匹配、目标框包含度检测以及多模态大模型评判等),必须满足 $E_{d}(\hat{y}_{\tau}, y^{\star}) = 1$,直接剔除一切推理中断或结果偏离的死路。
-
因果效用判定:为了量化轨迹中工具调用是否“立了大功”,系统将记录好的工具动作与返回图像 $Z_\tau$ 作为上下文补充线索,喂给此前的基准探针模型 $\pi_0$,在完全不提供教师思考过程与最终答案的前提下,让探针重新回答 $K$ 次,获得增量成功率 $\bar{p}_{\mathrm{tool}}(x,\tau)$。
最终只有同时满足下列联合条件的轨迹,才会被永久收录入微调集:
\[E_{d}(\hat{y}_{\tau},y^{\star}) = 1, \quad \bar{p}_{\mathrm{tool}}(x,\tau) - \bar{p}_{0}(x) \geq \delta\]其中 $\delta$ 为正向增益容差。这一准则确保了每一条保留下来的轨迹,都必须在实验意义上可证明:正是因为工具拿到了清晰的视觉证据,才让一个本来搞不清楚状况的模型有了做对这道题的能力。经此层层淬炼,团队最终沉淀出了高质量训练集 OpenVisTool-42K。
实验评测:全域提升与小模型跨越
为了对模型的工具调用能力做真正纯粹的因果拆解,研究团队同步构建了覆盖同等五大维度的评测集 OpenVisTool-Bench。它与常见通用多模态榜单最大的区别在于,该基准经过了精密的难度标定,剥离了那些“不用工具也能靠语义联想猜中”的廉价测试例,专注于评估模型通过裁剪、锐化、多轮对齐等动作获取新线索带来的绝对增量(Performance Gain Enabled by Visual-Tool Access)。
研究团队使用 SWIFT 框架,在 Qwen3.5-4B、9B、27B 以及 Qwen3-VL-8B-Instruct 等四个主流骨干上进行了全参数微调。评测数据呈现出一组极具说服力的趋势。
在所有模型尺度与五大评估领域上,OpenVisTool-42K 的训练带来了系统性的跨越。4B 到 27B 模型的总体平均得分相比其无工具裸模型基线平均提升了 10.7 分。尤其引人注目的是,基座尺寸越小,对盲目调用工具的消化能力往往越差:在没有经过优质 SFT 训练前,直接给 Qwen 系列小模型接入工具,其表现往往因为被冗余观察干扰而发生灾难性负迁移;而经过 OpenVisTool-42K 淬炼后,各模型迅速展现出了极其稳健的工具感知策略。
最为震撼的爆发点出现在极度考验空间辨别与几何细微特征的 VisualSearch(视觉搜索) 领域。Qwen3.5-9B 在经过因果微调后,该单项成绩实现了高达 23.8 分 的绝对增长。这直接证实了研究团队的理论预期:当任务在原生低像素下几乎无法被模型先验猜中时,真正具有因果价值的裁剪放大动作,才能为模型带来立竿见影的增量突破。
更值得关注的是其逼近闭源天花板的实战表现。在没有微调的情况下,GPT-5.5 在 OpenVisTool-Bench 上的无工具得分为 41.9,即便接入共享视觉工具箱也仅能达到 49.0。而参数量仅为 9B 的 Qwen3.5-9B 在接受了 OpenVisTool-42K 的因果教学后,总分直接攀升至 45.8,全面逆转了 GPT-5.5 的无工具基线,并显著缩小了与顶级闭源智能体之间的代际鸿沟。相比之下,此前基于常规正确性构建的开源工具模型(如 Thyme 和 DeepEyes V2)由于训练集单一且充斥伪调用,在五大领域的宏观平均分上甚至落后于没有任何工具接口的基准模型,出现了严重的局部过拟合与全域崩溃。
探针重放:剥离逻辑后的行为级验证
为了排除“模型只是在微调中背下了更多难例思维链文本”这一潜在质疑,研究人员设计了一场极具创意的轨迹重放分析(Trajectory Replay Analysis)。
在这项实验中,评估团队将基于不同数据策略训练出的 Qwen3.5-9B 模型生成的所有工具调用参数及其环境返回的真实图像观测抽取出来,彻底抹去模型的一切中间推理文本(CoT)与最终答案。随后,将这套纯粹由“工具调用指令 + 工具返回画面”构成的交互记录,塞给最初的探针模型 Qwen3.5-9B,观察这个从未经过微调的探针能否仅仅靠着这些新视觉线索,把原本做错的题目做对。
实验结果给出了清晰的答案:虽然只依靠最终正确性(Correctness-Only)训练出的模型生成的轨迹也能带来一定的增益,但由 OpenVisTool 经过因果效用过滤后训练出的模型,其生成的轨迹在纯视觉重放中带给探针的准确率增幅显著更高。这直接击穿了表象:OpenVisTool 并没有教会模型背诵花哨的辩解词,它实打实地培养出了模型在空间探索上的“摄影师眼光”——模型知道什么时候该截取哪个关键坐标、以多大比例放大、捕获哪一部分有效特征,这些操作产生的视觉线索具备极高客观信息价值,即便让第三方“瞎子探针”戴上这副眼镜,也能瞬间看懂原本模糊的现实。
在消融实验方面,单纯依赖“结果正确性”过滤的数据在总体基准上落后完整方案 1.7 分,而单纯依赖“因果效用”却不卡死答案正确性的数据更是落后了 3.4 分。两者的有机交织构成了完美的互补闭环:前者坚决摒弃将错误归纳过程当作正样本的毒化风险,后者则毫不留情地清退所有滥竽充数的“无效工具表演”。
跨域迁移:从单一死记到通用元技能
模型究竟是学会了各领域的具体调参技巧,还是习得了泛化的视觉探索策略?研究团队对单领域切片训练与全领域混合训练展开了深入的跨域迁移分析。
一方面,视觉工具的探索机制表现出了显著的跨域元技能(Meta-Skill)特性。例如,仅仅让模型在 GUI 界面定位任务上进行工具微调,该模型在完全未见过的 VisualSearch 任务上的表现竟然直接跳涨了 14.1 分。这表明,在操作系统界面寻找微小图标所训练出的“坐标感知与逐步逼近裁剪”直觉,能够无缝平移到自然图像中寻找隐蔽物体的视觉逻辑中。
另一方面,迁移效应也揭示出了交互范式之间的不对称对抗。例如,只在 VisualSearch 上训练的模型,迁移至 Web-to-HTML 评测时表现大幅滑坡,从原本基础的 42.0 暴跌至 21.6 分。其根源在于交互策略的内在冲突:在密集的自然视觉搜索中,策略倾向于高频切割极其细碎的局部微图;但要复原一张网页的 HTML 代码,模型必须时刻关注全局栅格、版面排布与整体视差,过度陷入局部碎片的视野直接摧毁了全页面的连贯感知。
这一发现凸显了 OpenVisTool-42K 全域混合训练的核心价值。面对多模态环境纷繁复杂的需求,混合训练不仅超越了所有单领域训练的平均表现(斩获 45.8 的最高总分),更重要的是促使模型进化出了环境条件反射式的策略调度能力(Context-Conditional Tool-Use)。模型学会了审时度势:面对密集大图自动激活宏观栅格与结构对齐,面对细微几何扰动则精准触发微距放大镜,彻底摆脱了单领域死记硬背导致的路径依赖。在 Agentic-MME 和 VTC-Bench 这两个完全脱离训练分布的未知域基准测试中,OpenVisTool-42K 训练的模型也稳定优于原生骨干,进一步证明了因果视觉工具学习的广阔泛化空间。
总结与展望
OpenVisTool 的核心贡献不仅在于开源了一套 42K 规模的跨领域数据集与严谨的评估基准,更重要的是它向整个多模态 Agent 社区提出了一个关键警示:在多模态工具学习中,答案正确绝不能等同于有监督价值。
过去盲目依赖教师模型输出进行拒绝采样的做法,不可避免地让学生模型继承了大量伪因果的“工具杂耍”。通过引入探针模型的反事实对比,OpenVisTool 确立了以“因果效用”为核心的轨迹评价新范式,将真正能打通信息瓶颈的有效视觉获取过程沉淀为高质量微调资产。对于追求更高推理深度、更强自主视觉探索能力的下一代具身与多模态智能体而言,摆脱形式主义的工具模仿,学会“在必要时为关键线索按下快门”,正是通向真正视觉智能的关键一步。