DyLaR:视频问答告别千字长CoT,不到20个Token准确率提升4.2分!
Perception Before Reasoning: Dynamic Latent Reasoning for Video Understanding and Question Answering
在多模态长视频理解任务中,让模型“一边思考一边输出”已经成为主流范式。从各种基于强化学习的视频推理模型,到最新的全能推理大模型,几乎都在依赖显式的思维链(Chain-of-Thought, CoT)。模型往往需要先生成成百上千个文本词,巨细靡遗地描述画面里发生的时间、人物、动作细节,随后展开一步步推理,最后才给出那几个字母的选项答案。
ArXiv URL:https://arxiv.org/abs/2608.04124v1
这种做法虽然有效,却带来了巨大的推理代价。在真实场景下,回答一个视频问题常常要耗费上千个生成的 Token。更关键的矛盾在于:视频问答真的每个问题都需要这么冗长的推导吗?很多时候,用户只是问“视频第 3 秒桌上的杯子是什么颜色”或者“最后是谁推开了门”。这类感知主导的问题,一旦模型在视频帧中定位到了目标物体或动作,答案就已经确定了;把看到的画面用自然语言重新描写一遍,完全是无效的算力空转。
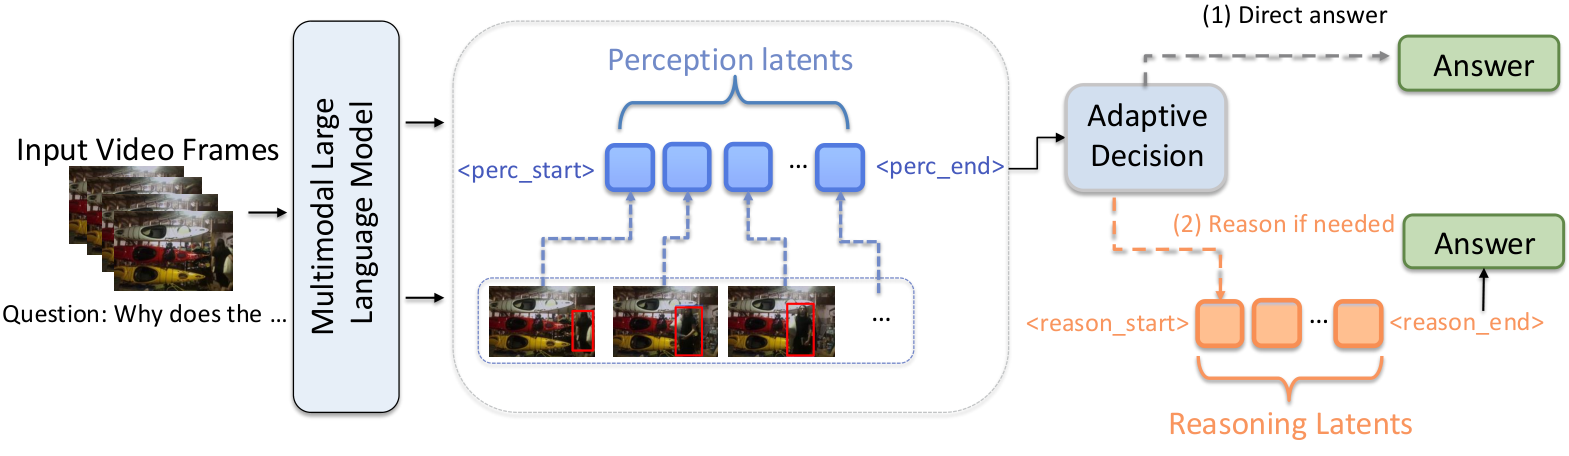
针对这一核心痛点,来自佐治亚理工学院(Georgia Institute of Technology)与莱斯大学(Rice University)的研究团队提出了名为 DyLaR(Dynamic Latent Reasoning,动态隐式推理)的全新框架。他们改变了“遇事不决先写一段小作文”的暴力推理机制,让多模态大模型先在连续的隐状态(Hidden States)中完成视觉感知对齐,再自适应决定是否需要调用隐式推理步骤。
该方案在保证甚至超越长文本思维链精度的同时,将每个问题生成的平均 Token 数量压缩到了 20 个以内。以开源前沿模型 Qwen3-VL-4B 为例,DyLaR 在九大视频基准上的平均准确率从 Qwen3-VL-4B-Thinking 的 54.0% 提升至 58.2%,而每个问题平均生成的输出长度直接从 1220.7 个 Token 骤降到 18.5 个 Token。
为什么长视频问答不该默认写“小作文”?
显式文本思维链在视频领域的泛滥,暴露出多模态模型现阶段的一种机制浪费。文本思维链的本质优势,在于模型利用自回归逐步计算时产生的隐层连续状态(Hidden States),而不是最终解码出来的那串具体的英文字符。既然有效计算发生在隐空间,那么将这些思考步骤直接留在连续表征中进行计算,本就是兼顾效果与效率的合理方向。
现有的隐式推理方法多集中在静态图像领域,并且往往为所有输入分配完全相同的固定隐式计算预算。但视频数据有着强烈的异构属性。研究团队指出,视频问答至少可以划分为两类截然不同的需求:
-
感知主导型问题(Perception-oriented):模型的核心任务是跨多帧时序进行证据定位(Evidence Grounding)。只要抓住了对应的帧和目标区域,答案显而易见,任何显式的文本转述都是冗余的。
-
推理主导型问题(Reasoning-oriented):仅定位到视觉线索还不够,模型必须在不同时间段的线索之间做关联、对比因果或逻辑聚合。此时才需要真正的多步推演。
也就是说,在视频问答中,“先感知定位”是每一个问题都绕不开的前提,但“后续是否要复杂推理”却因问题而异。DyLaR 的设计哲学正是由此确立:先感知,后按需推理(Perception Before Reasoning)。
显隐融合:动态隐式推理的具体架构
DyLaR 的序列生成由常规文本 Token 与连续的隐式状态片段(Latent Segments)交织而成。文本 Token 负责充当结构定界符和输出最终答案,而耗费计算的感知与推理过程则完全在连续的向量空间中闭环。
在解码时,模型先通过特殊的占位符 <|latent_pad|> 预留位置。在隐式片段内部,解码器不再从词表中采样词向量,而是直接将上一拍的解码器隐层输出反馈为下一拍的输入 Embedding。这一被称为“隐式片段解码(Latent-segment Decoding)”的机制,彻底省去了自回归投影到大词表上的开销。
整个响应的结构被严格组织为三种核心模块:
-
感知片段 $\mathcal{P}{K_p}$:包含固定数量 $K_p$ 个连续隐状态向量 $\mathbf{z}^{p}{1:K_p}$,被结构定界符
<perc_start>与<perc_end>包裹。这些隐状态专门用来提取并压缩与问题强相关的跨帧视觉线索。 -
推理片段 $\mathcal{R}{K_r}$:包含 $K_r$ 个推理隐状态 $\mathbf{z}^{r}{1:K_r}$,位于
<reason_start>与<reason_end>之间。这部分被称为连续思维(Continuous Thoughts),负责在隐空间内对已经感知的视觉证据做聚合与推导。 -
答案字段 $\mathcal{A}(a)$:标准文本生成的
<answer> a </answer>。
最精妙的设计在于两段式之间的自适应路由分支。当模型自回归生成完 <perc_end> 之后,它来到了决策分水岭。如果当前问题仅凭感知到的线索就能直接作答,模型会直接吐出文本 Token <answer>,走直连路径:
若模型判断当前线索需要进一步组合推理,它就会在下一个位置生成 <reason_start>,触发推理片段追加 $K_r$ 步隐式思考,随后再给出答案:
这一设计将计算开销变成了按需分配的动态流程,避免了无差别加载思考链造成的计算堆叠。
两阶段对齐:如何教会隐向量“看清”与“思考”
连续的隐状态本身是不可控的高维向量,如何确保感知片段学到的是真正的视觉线索,而推理片段学到的是严谨的推导逻辑?DyLaR 提出了监督微调(SFT)配合基于可验证奖励的强化学习(RL)两阶段训练流程。
在 SFT 阶段,训练目标被拆解为文本损失、感知对齐损失与推理蒸馏损失:
\[\mathcal{L}_{\mathrm{SFT}} = \mathcal{L}_{\mathrm{text}} + \lambda_g \mathcal{L}_{\mathrm{ground}} + \mathbb{I}[s=\textsc{reason}]\left(\lambda_e \mathcal{L}_{\mathrm{exp}} + \lambda_d \mathcal{L}_{\mathrm{distill}}\right)\]1. 显式视觉证据对齐(Perception Grounding)
对于感知片段,研究团队利用大模型配合强独立验证模型(Kimi-K2.5),从视频中筛选出经过验证的目标包围盒(Bounding Box)。针对每个定位框,提取对应区域内视觉 Patch 的投影特征并取均值,构建出目标视觉向量 $\mathbf{u}i$。随后,通过余弦相似度损失 $\mathcal{L}{\mathrm{ground}}$,强制约束生成的感知隐状态 $\hat{\mathbf{z}}^p_i$ 与真实画面中的线索表征靠近。在推理测试时,模型完全无需任何人工或外部辅助框,便能自主将注意力和感知隐状态聚焦在关键视觉区域。
2. 思维链到隐向量的自蒸馏(Rationale Distillation)
推理隐状态没有直观的物理坐标可以监督。DyLaR 借鉴了 CODI 的自蒸馏思想:对于需要复杂推理的样本,同一个模型执行两次前向传播。教师通道用常规自回归生成详尽的文字推理链,而学生通道则将这段文本替换为 $K_r$ 个推理隐向量。蒸馏损失 $\mathcal{L}_{\mathrm{distill}}$ 使用 Smooth L1 损失,约束学生通道在走完隐式推理后到达的各层解码器表征,逼近教师通道生成完长篇大论后到达的表征状态。学生模型不需要模仿具体的文本词汇,它学到的是思考完成后的思维切片。
3. 强化学习微调自适应路由(RL with Latent Replay)
SFT 阶段是在固定标签引导下学习表征,但模型在实际推理时必须自己决定“要不要开启推理分支”。为此,研究团队引入了基于 GRPO(Group Relative Policy Optimization)的强化学习阶段。在采样完整 Rollout 时,之前生成的隐状态被缓存并作为固定的输入 Embedding 回放(Latent Replay)。奖励函数设计得极其干净克制,由格式有效性奖励与最终答案正确性奖励相乘构成:
\[R(o_i) = \mathbb{I}_{\mathrm{form}}(o_i) \left(\alpha_{\mathrm{form}} + \alpha_{\mathrm{acc}} \mathbb{I}_{\mathrm{acc}}(o_i)\right)\]强化学习的介入,让模型在探索中学会了在何时收敛输出、何时主动开启推理以提高命中率。在 Qwen2.5-VL-7B 骨干网络上,仅通过 2500 步 GRPO 微调,跨九个基准的平均准确率就从 SFT 后的 56.0% 进一步冲上了 57.5%。
实验评测:少写 98% 的词,拿到更高的分
评测覆盖了包含 Video-MME、LVBench、LongVideoBench、MVBench 等在内的 9 大视频问答基准,测试跨越感知理解与长时序深度推理两类场景。测试时默认仅均匀采样 16 帧,感知与推理的隐预算分别设为精简的 $K_p=4$ 和 $K_r=6$。
从整体对比来看,DyLaR 展现出了惊人的效率压缩比:
-
在 Qwen3-VL-4B 骨干上,基准模型 Qwen3-VL-4B-Thinking 虽然具备强大的显式思考能力,但平均每个回答要输出 1220.7 个 Token,全套基准平均分只有 54.0%;而搭载了 DyLaR 后,平均 Token 消耗骤降至 18.5 个,不仅推理开销降维,平均准确率更是逆势提升到 58.2%,实现了 4.2 个百分点的绝对增益。
-
在主流的 Qwen2.5-VL-7B 基准线对比中,DyLaR 同样以 18.2 个 Token 的极低开销,击败了包括 Video-R1、VideoRFT、Open-o3-Video、VideoAuto-R1 以及同属隐式表征方案的 Mull-Token 在内的诸多同级别强模型。
-
该范式在 InternVL3.5-4B 和 LLaVA-OneVision-7B 架构上也表现出稳定的可迁移性,证明其并非绑定某单一结构工程特异性的 trick。
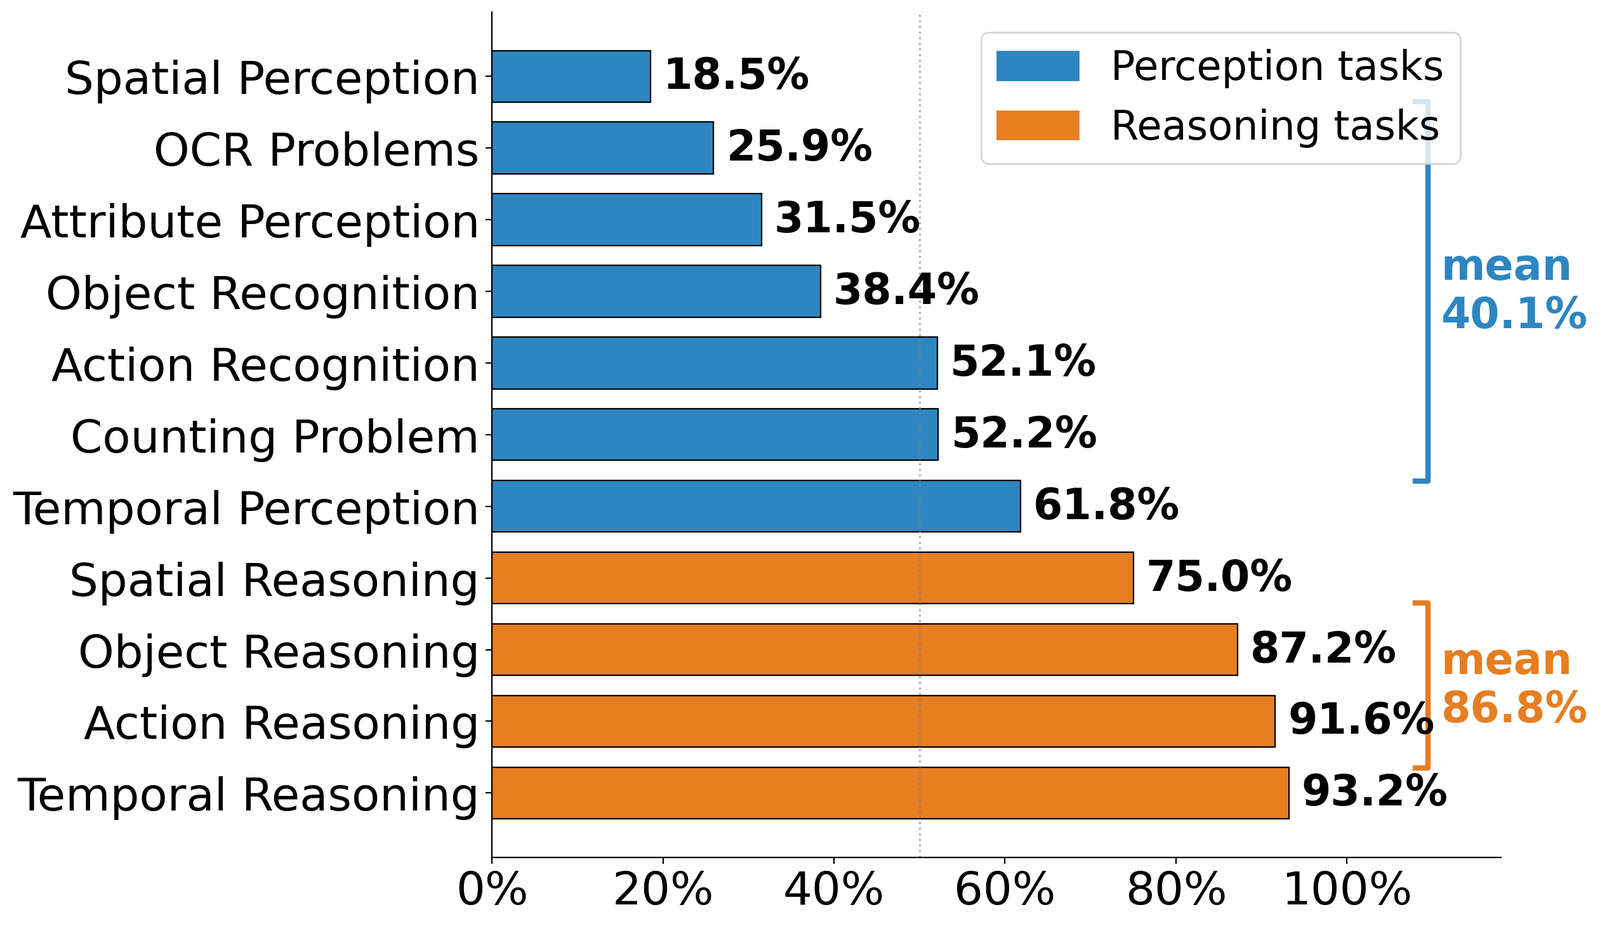
上图揭示了 DyLaR 内部自适应机制的合理性。在 Video-MME 官方细分任务的测试中,面对 7 个纯感知类目(Perception Categories),DyLaR 的推理分支触发率仅为 40.1%,六成左右的问题通过感知隐状态直接出具了答案;而面对 4 个强推理类目(Reasoning Categories)时,推理分支的触发率自发爬升到了 86.8%。模型确实学会了该看的时候看、该想的时候想。
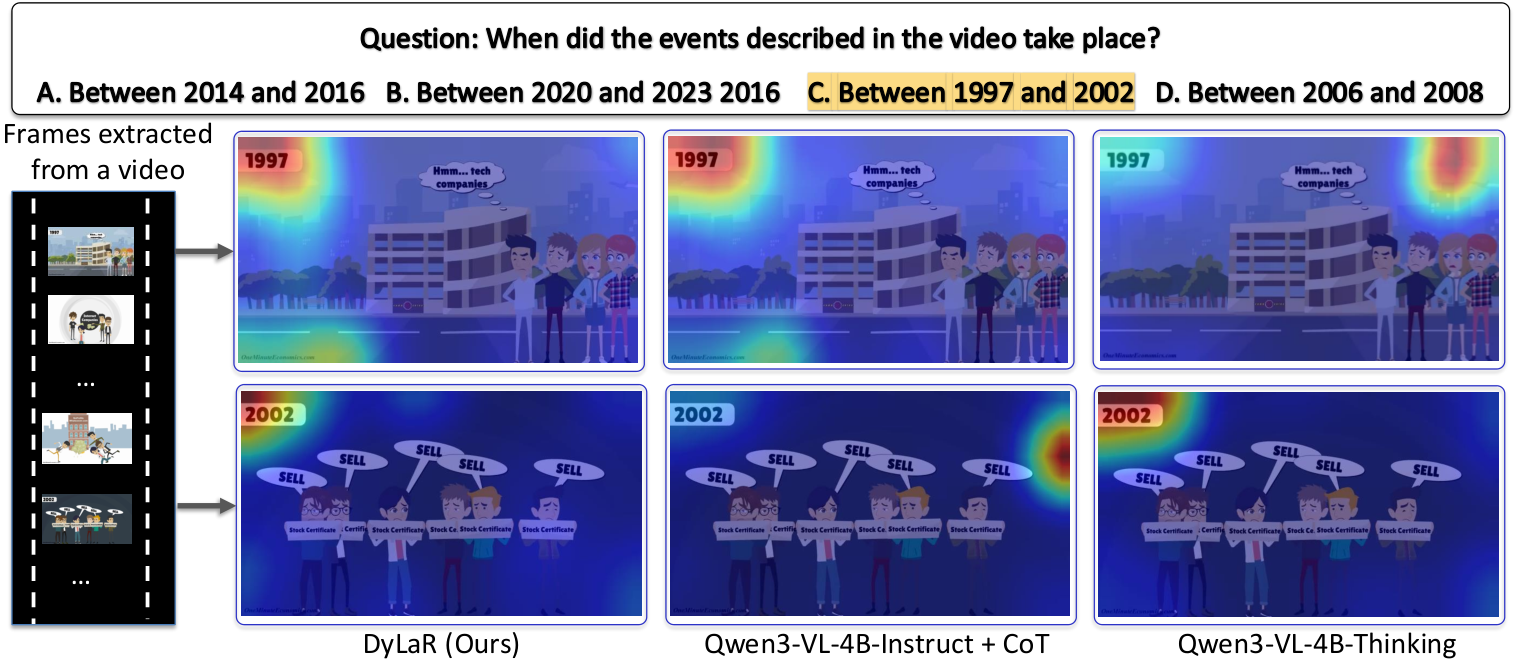
上图展示了一个具体的时序问答案例分析。题目要求从视频画面的细微线索中精准识别“1997”与“2002”两个时间标记,从而判断事件区间。可视化聚合热力图显示,基于文本 CoT 的基线模型注意力出现了大范围的发散与时序漂移;而 DyLaR 在隐式感知阶段通过显式监督,注意力被牢牢锁死在具有诊断价值的文字和物体局部。这种隐式表征机制不仅让模型思考更快,反而提供了一种更干净的视觉可解释性。
结语与思考
当整个大模型行业都在追逐更长、更慢的 Test-Time Compute(测试期计算扩展)时,DyLaR 给出了一条反潮流却极具启发性的技术路线。
它证明了一件事:多模态大模型的推理能力并不天然等同于“文本吐字量”。在视频这种富含时空冗余度的模态中,将高密度的视觉证据直接压缩在感知隐向量里,并让模型掌握“何时思考、何时闭嘴”的自适应能力,远比无脑生成上千字的画面描述更为经济、高效。对于未来面向端侧落地、低延迟交互的长视频分析与具身智能系统而言,这种“感知在先、按需深思”的隐式推理范式,无疑展现出了更为实用的工程想象力。