Patch Policy:仅用0.7%参数反超VLA,密集视觉特征如何重构机器人控制?
Patch Policy: Efficient Embodied Control via Dense Visual Representations
在机器人学习领域,如何高效处理视觉观察一直存在着一条明显的技术裂缝。一侧是深植于经典强化学习与模仿学习的轻量策略,它们习惯将环境图像高度压缩为单一的全局向量(例如通过 ResNet 池化或 Vision Transformer 的 CLS Token),这种极端的空间降维直接抹杀了精细操作必需的几何与位置细节;另一侧则是近年来大行其道的视觉-语言-动作模型(Vision-Language-Action, VLA),它们虽然保留了多尺度的图像 Patch 特征,却必须绑定数十亿参数的大型视觉语言模型(VLM)基座,无论是端侧推理延迟还是训练成本都极其昂贵。
ArXiv URL:https://arxiv.org/abs/2607.18236v1
来自 AMI Labs、Meta-FAIR 与纽约大学(NYU)的研究团队提出了一套优雅而高效的替代方案:Patch Policy。该研究的核心论点十分清晰:具身控制真正需要的并非庞大的自回归语言模型,而是未经粗暴压缩的密集视觉特征(Dense Visual Representations)。这些细粒度空间表征早在互联网级别预训练的通用 ViT 中就已完备存在。
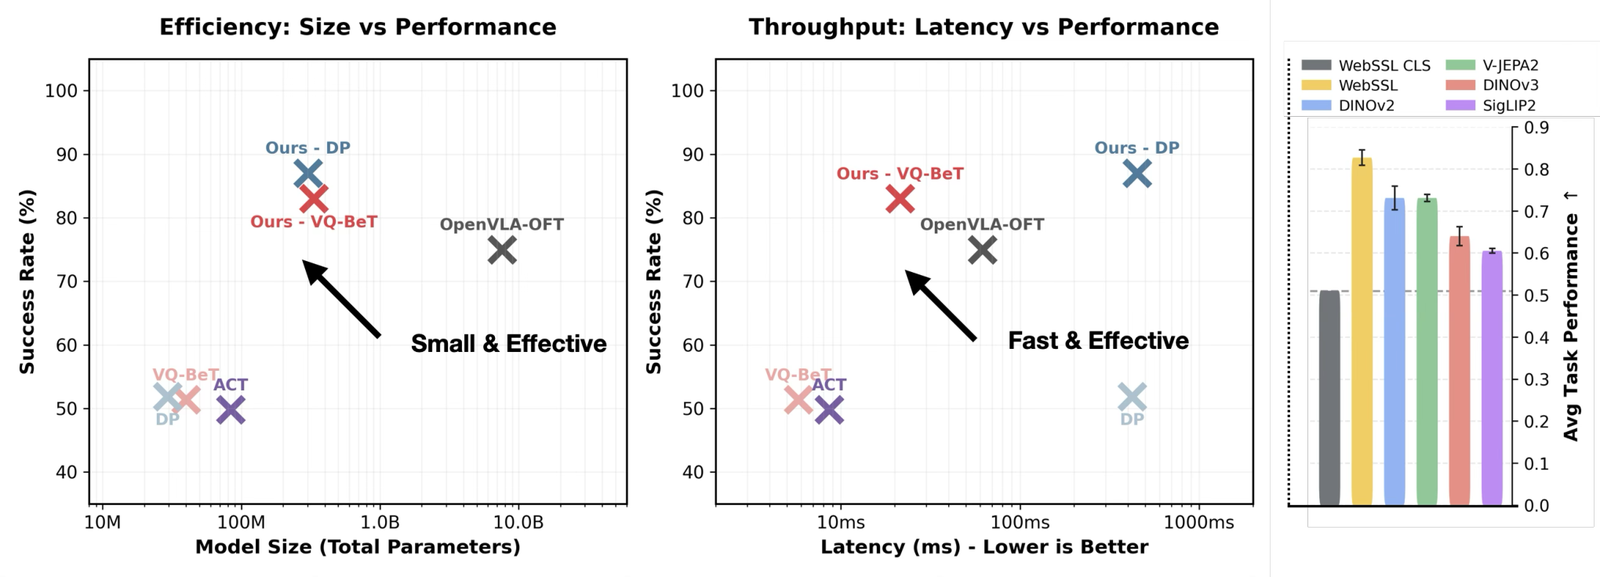
Patch Policy 几乎没有引入冗余结构,而是通过一个最小化的架构扩展,直接让 Transformer 策略消化预训练 ViT 抽取的密集 Patch Token。实验表明,在多项模拟与真机控制任务中,Patch Policy 相较于当前最先进的全局表征策略取得了 40% 的相对性能提升;更重要的是,它以大约 0.7% 的极小参数量,在综合成功率上反超了经过微调的 70 亿参数大模型 OpenVLA-OFT 达 18%,且单步推理延迟最低仅约 11 毫秒。
空间压缩的代价与大模型的虚火
精确的操作任务对物体的边缘、朝向、夹爪间隙以及接触点高度敏感。当传统算法将一张 $H \times W$ 分辨率的观测图像强行压平为一个全局特征向量时,大量高频几何信息与局部的相对空间关系在池化过程中不可逆地流失了。使用 CLS Token 同样面临困境:自监督预训练赋予 CLS Token 极强的整图全局语义抽象能力,但机器人在抓取镊子或插入线缆时,迫切需要的恰恰是局部的精确像素锚定,而非高度概念化的抽象语义。
为了找回空间细节,学术界转向了 VLA 架构。以 OpenVLA 为代表的方案将图像打碎为 Patch Token,并交由 LLaMA 等大语言模型进行跨模态推断。这种架构的确带来了显著的空间感知提升,但也带来了严重的工程副作用:高达数十亿参数的自回归计算使得控制频率难以提升,下游任务微调往往需要动用昂贵的 GPU 集群,难以适配需要高频反应式控制(Reactive Control)的机械臂系统。
研究团队指出了一个长期被忽视的事实:利用密集特征并不等同于必须部署 VLA。互联网规模预训练的视觉骨干网络(例如 DINOv2、WebSSL)在无需针对特定机器人数据进行微调的前提下,其深层 Patch 已经内蕴了极高质量的局部几何与对应关系。机器人策略要做的不是重新发明轮子,而是拆除人为设置在策略输入端的特征瓶颈。
极简架构:块状因果掩码释放密集表征
Patch Policy 的结构设计体现了极强的即插即用属性。它主要由两部分构成:负责提取特征的观察主干(Observation Trunk)和负责预测动作轨迹的策略头(Policy Head)。
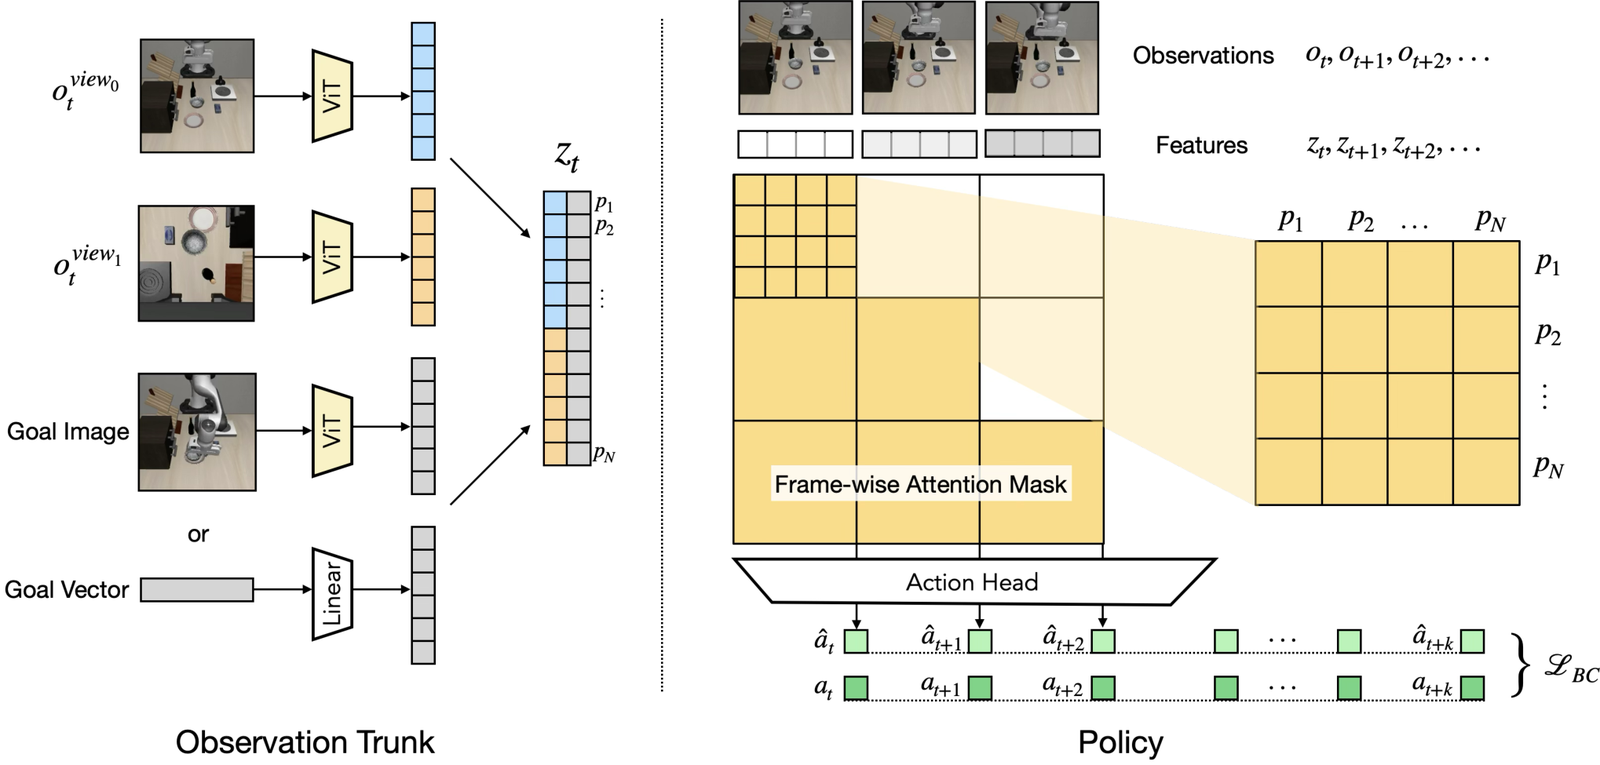
在观察端,对于任意输入观测图像 $o_t \in \mathbb{R}^{C \times H \times W}$,系统直接利用冻结的预训练 ViT 编码器将其映射为形状为 $P \times D$ 的 Patch 特征序列,其中 $P$ 为 Patch 数量,$D$ 为嵌入维度。若包含长度为 $T$ 的历史时间窗口,所生成的特征张量维度即为 $T \times P \times D$。如果任务需要目标引导,输入若是目标图像,则使用同一编码器提取特征后沿通道维度拼接,形成 $T \times P \times 2D$ 的特征;若目标为低维状态向量 $g \in \mathbb{R}^G$,则直接复制并拼接到每个 Patch Token 上,构成 $T \times P \times (D + G)$ 的输入。这种设计甚至向后兼容纯状态输入或全局向量:只需将 $P$ 设为 1 即可退化为传统方案。
为了在 Transformer 策略头中兼顾单帧内的丰富交互与跨时间步的物理因果性,研究团队设计了核心机制——块状因果注意力掩码(Block-Causal Attention Mask):
-
帧内双向互通:将形状为 $T \times P$ 的扁平化 Token 序列输入策略网络时,同一观察时间步 $t$ 内的 $P$ 个 Patch Token 之间拥有完全的双向注意力(Bidirectional Attention),允许模型在单帧画面内部充分整合物体与背景、机械臂与操作目标的相对空间关系。
-
跨帧严格因果:不同时间步之间施加严格的单向因果掩码,当前时间步 $t$ 的所有 Token 只能检索自身及历史步 $t’ \le t$ 的特征,绝不泄露未来帧的信息,严格遵循物理动力学的时间先后次序。
在每个时间帧的最后一个 Patch Token 位置,策略头通过轻量级动作解码器(例如扩散策略 Diffusion Policy 或矢量量化行为 Transformer VQ-BeT)输出一段未来动作块(Action Chunking),并在推断阶段配合后退地平线控制(Receding Horizon Control)平滑执行。整个网络中,庞大的视觉骨干完全被冻结,真正参与梯度更新的仅有轻量级策略头与序列位置编码。
模拟与真机实验:全方位的控制能力跃升
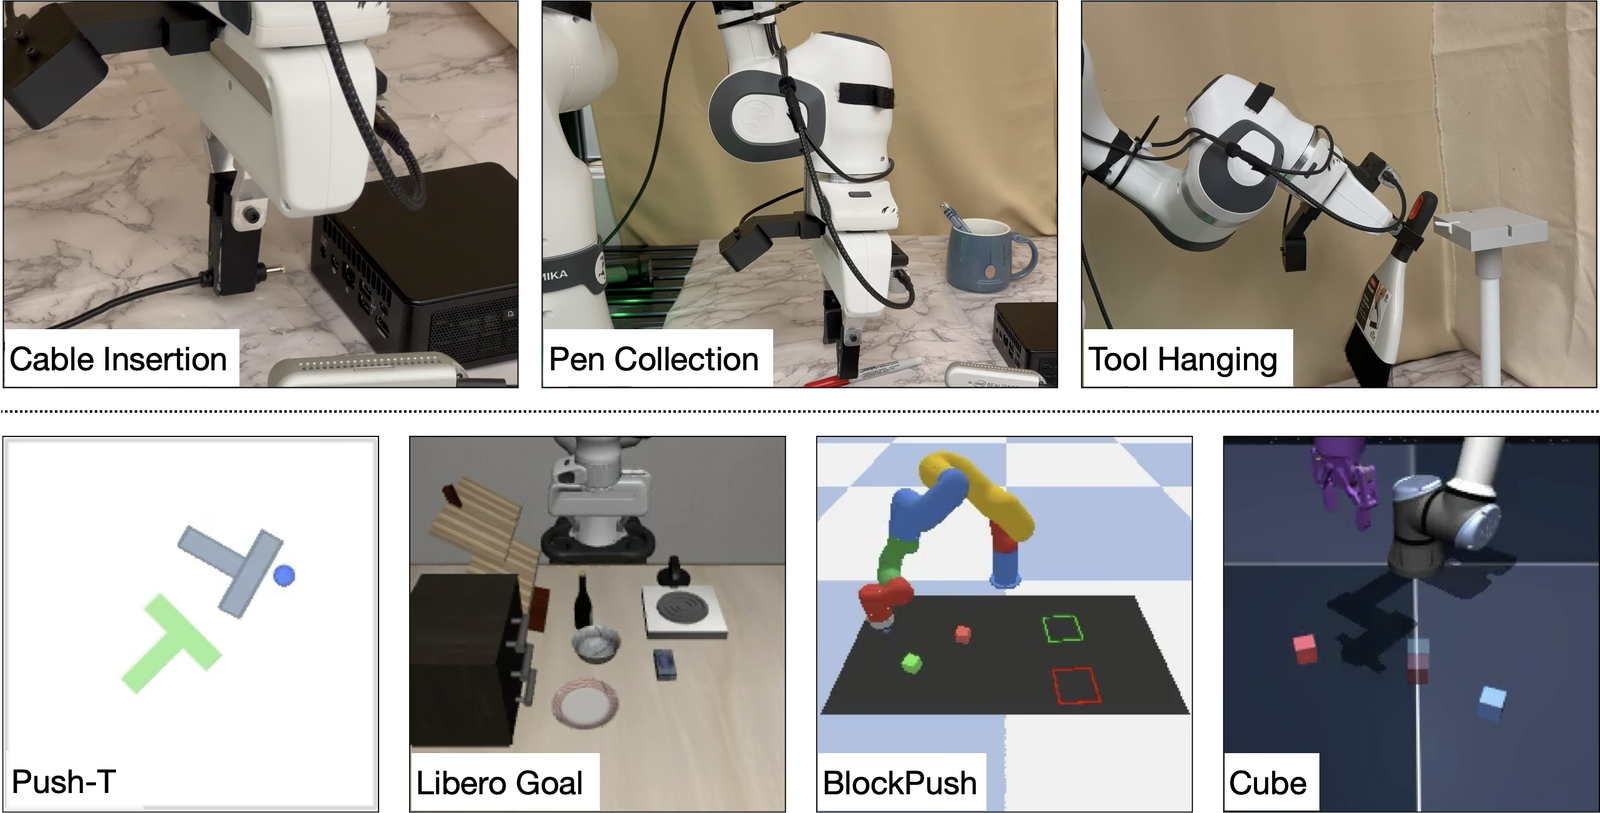
为了检验密集 Patch 特征在不同控制自由度下的通用性,研究团队在涵盖 2D 到 7D 动作空间的四个仿真环境(Push-T、LIBERO Goal、BlockPush、Cube)以及使用 7 自由度 Franka 机械臂的三个真机长时程任务中展开了全面评估。
在仿真基准的横向评测中,Patch Policy 展现出对全局特征策略的压倒性优势。在涉及多物体相对位姿与接触面精确对齐的复杂任务(如 BlockPush 与 Cube)上,采用全局平均池化(Avg Pool)或 CLS Token 的策略表现大幅下滑,而搭载 WebSSL Patch 特征的 Patch Policy 则表现稳健,整体相对性能提升超 40%。这是因为平均池化冲淡了局部高频信息,CLS Token 则过度偏向高层类别语义,二者都丢失了精确的毫米级几何线索。
更为惊艳的是与重量级基线 OpenVLA-OFT 的跨量级对决。OpenVLA-OFT 依靠微调包含 DINOv2 和 SigLIP 双特征输入的 7B 语言大模型,在此类操作任务中展现过出色的表现。然而,参数量仅为其约 0.7% 的 Patch Policy(搭载 Diffusion Policy 头部)在所有四个仿真测试中全线胜出,综合成功率超出了 18%。这强有力地证实:对于感知动作映射而言,高分辨率的局部视觉表征起决定性作用,LLM 提供的文本推理参数在低层运动控制中并没有带来不可替代的优势,反而可能成为性能发挥与推断速度的累赘。
在真实物理世界中,研究团队设置了三项高难度操作挑战:
-
线缆插入(Cable Insertion):要求夹爪拾取细软线缆并对准狭小的电源孔洞插入,高度依赖接触对齐与亚厘米级定位;
-
挂置工具(Tool Hanging):要求将不规则工具挂在支架上,涉及三维空间多自由度的避障与悬挂平衡;
-
拾笔入筒(Pen Collection):长时程序列任务,需要连续将散落的画笔精准拾起并投入笔筒。
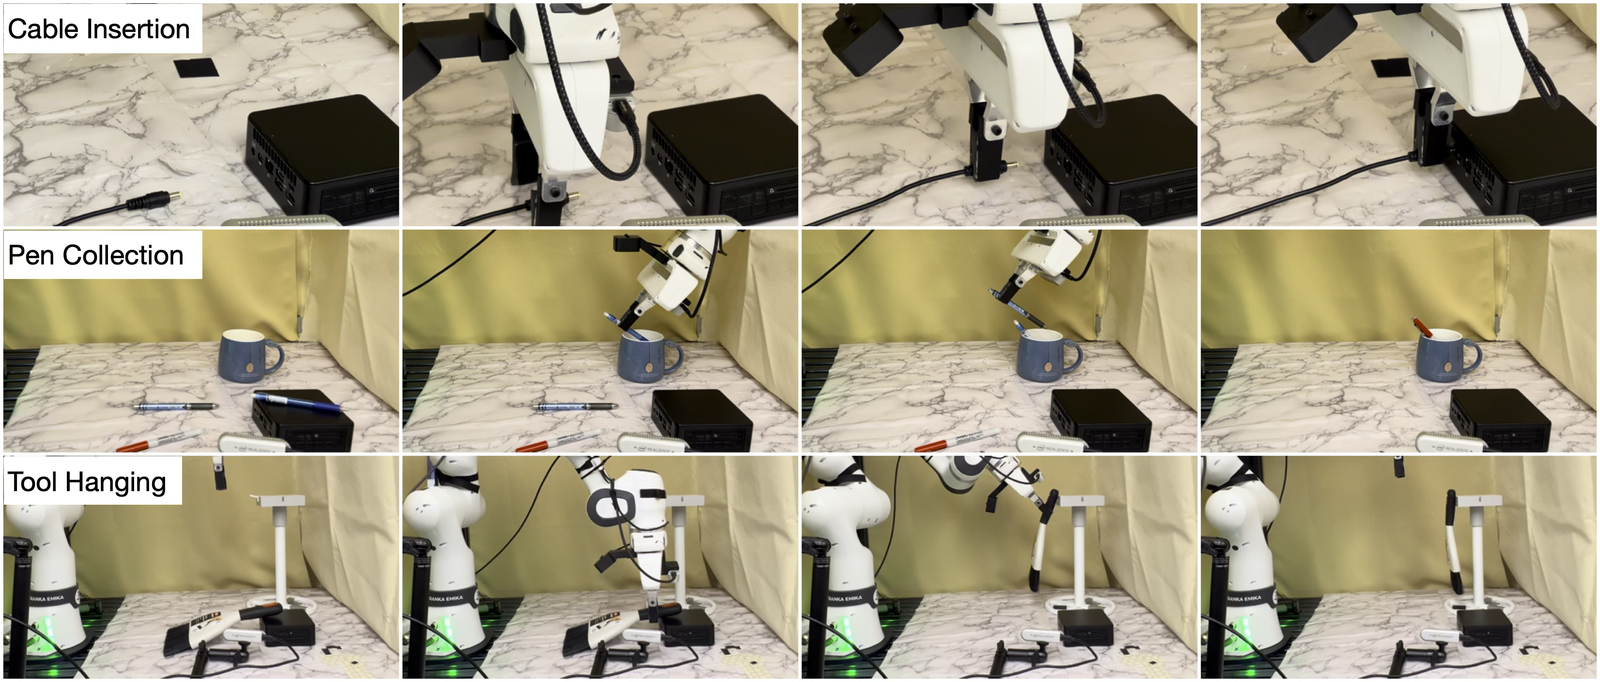
真实实验全部采用紧凑的 DINOv2 (ViT-S) 作为冻结骨干。如实验统计所示,传统采用全局特征的策略在线缆插入的第一阶段(接触孔洞)成功率便断崖式下跌至 20% 以下,而 Patch Policy 在保持动作流畅的同时,顺利完成了长时程的连续插入和收集操作。真机测试证明,直接利用预训练 Patch 特征不仅在模拟器中有效,更能零样本泛化至复杂光照与反光干扰的真实场景。
深入解构:Patch 该压缩吗?哪家表征最强?
在确立了 Patch Policy 的有效性之后,研究人员进一步通过控制变量实验,回答了具身智能工程落地中两个最迫切的实际问题。
第一,既然 Dense Patch 效果好,那是否可以在输入策略前做一次适度的空间降采样,换取更短的序列长度?
直觉上,对 Patch 做轻量级卷积下采样似乎能平衡精度与效率。研究团队在 Push-T 任务上训练了一个轻量卷积编码器,与策略端到端联合训练以压缩冻结的 DINOv2 Patch 特征。结果显示,任何形式的空间降采样(无论是步长为 2 的卷积还是池化)都会直接导致控制成功率呈阶梯式下降。在硬件算力允许的前提下,保留原始且未压缩的 Patch 空间分辨率是保持高精度控制不可动摇的前提,任何中间层的压缩瓶颈都会损伤操作策略的上限。
第二,在五花八门的预训练视觉骨干中,谁才是机器人控制的最佳底座?
研究团队将 Patch Policy 分别接入五种当前顶尖的自监督与多模态视觉模型:DINOv2、DINOv3、WebSSL、V-JEPA 2 与 SigLIP 2。
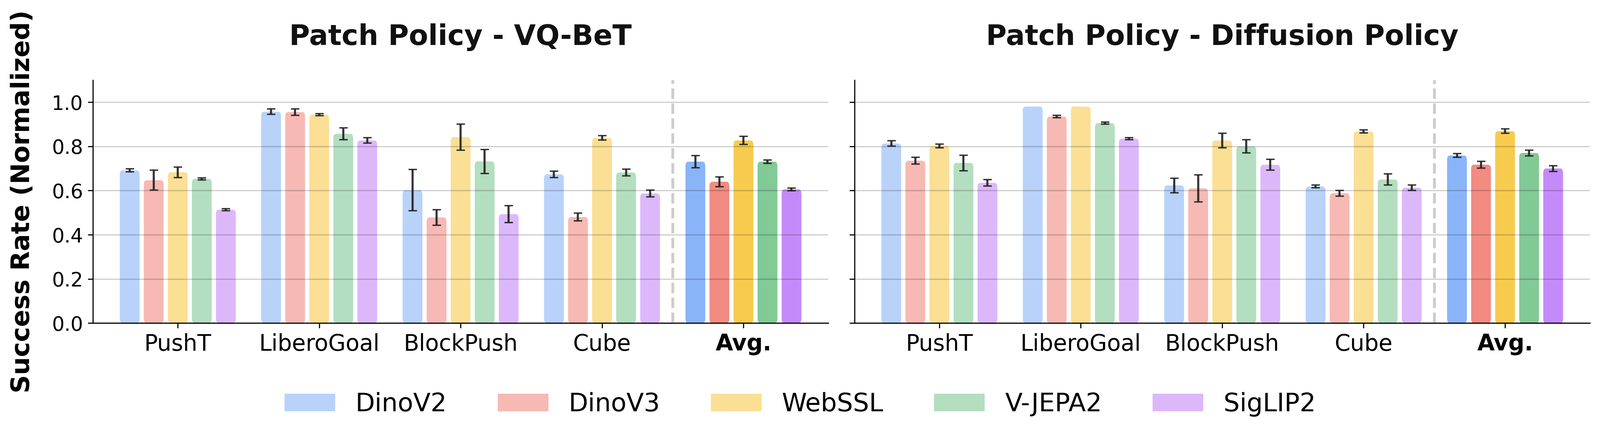
评测揭示出一个极具指导价值的现象:不同视觉表征在下游控制任务中的性能排名高度一致,且与下游采用何种策略解码头无关。在所有测试环境中,基于海量互联网数据自监督训练的 WebSSL 和 DINOv2 始终稳居前两位;相比之下,偏向图文对比学习的 SigLIP 2 在单纯的精确几何控制任务上表现偏弱。这表明下游动作头的表达能力虽然重要,但输入视觉表征本身的几何致密性与对应质量才是决定机器人模仿学习成败的首要瓶颈。
效率革命与具身智能的新路线
除了精度之外,Patch Policy 最具颠覆性的价值在于其无与伦比的计算能效比:
在配备单个 NVIDIA L40S GPU 的普通工作站上,搭载 DINOv2 的 Patch Policy 仅需 6.5 个 GPU 小时 即可完成完全收敛;反观 OpenVLA-OFT,即便经过并行动作解码优化,在 4 卡 L40S 上依然消耗了 16 个 GPU 小时;而从零训练 ResNet 骨干的 ACT 策略则需要 24 个 GPU 小时。在推断阶段,Patch Policy 在单张 NVIDIA H200 上的端到端延迟低至 11 毫秒 左右,完全满足百赫兹级高频工业闭环控制的严苛时延预算。
这项工作给当下狂热的具身大模型浪潮带来了一剂冷静的思考。当整个领域都在将参数规模从 7B 堆向数十甚至上百亿时,Patch Policy 证明了在绝大多数机械臂操作场景下,我们并不需要让控制器去重新学习一套通用的“视觉语言世界常识”。现有的静态通用视觉大模型已经在 Patch 级别沉淀了足够精细的世界表征。
将繁重的常识感知与敏捷的动力学控制解耦,冻结通用视觉大底座、全量摄取稠密 Patch,并用轻量 Transformer 维持因果时序,这种“小巧但击中要害”的设计范式,不仅大幅拉低了具身智能高精度操作的研究门槛,更为低延迟、低算力消耗的工业级端侧机器人部署指明了一条极具性价比的新路径。