COC架构:定长窗口打破规划魔咒,小Transformer解出百万步汉诺塔
Planning with Transformers: Chain of Computation and Structured Context Windows
在深度学习的理论研究中,基于 Transformer 架构的大语言模型早已被证明具备图灵完备性(Turing-complete)。理论上,只要给足上下文或外挂读写机制,模型足以模拟通用图灵机,执行任何算法。但在工程现实中,大模型的规划能力(Planning)却经常被诟病为“空中楼阁”。无论是 OpenAI 的 o 系列等强推理模型,还是经过思维链强化训练的开源模型,一旦面对积木世界(BlocksWorld)、汉诺塔(Tower of Hanoi)这类需要严格状态转移和多步推演的经典任务,都会在问题规模越过某条阈值后发生断崖式崩溃。
ArXiv URL:https://arxiv.org/abs/2607.17710v1
这种理论上限与经验表现之间的鸿沟,引发了学术界持久的争论:大模型到底能不能真正学会规划?阿尔伯塔机器智能研究所(Amii)与阿尔伯塔大学的研究团队在最新论文《Planning with Transformers: Chain of Computation and Structured Context Windows》中给出了一个反直觉的答案——阻碍模型完成复杂规划的,并不是 Transformer 的表征能力不够,而是当前让大模型“单次前向直出完整规划”或“无节制累积上下文”的交互模式存在结构性缺陷。
为了从根本上解决这一问题,研究团队提出了 Chain of Computation (COC) 计算架构,并引入了 Structured Context Window (SCW)。该方法不再强求模型通过庞大的自注意力机制在不断膨胀的上下文里“大海捞针”,而是将一个规模极小的 Transformer 放置于外部迭代循环之中,配合定长指令窗口与动态寻址指针。实验证明,即便是从零训练的小模型,在 COC 架构下也能在 BlocksWorld 与煎饼排序(Pancake Puzzle)中取得超过 99.89% 的泛化成功率;结合下推自动机(PDA)设计后,模型甚至能稳定完成高达 20 层盘子、跨越 100 万步动作序列的汉诺塔极端规划任务。
为什么大模型做不好多步规划?
要理解 COC 的设计初衷,必须先看清大模型在规划任务中真正卡在哪一步。当前主流的 LLM 规划方案通常分为两派:一派依赖单次生成(Single-pass)或思维链(Chain of Thought, CoT),让模型直接输出完整的动作序列;另一派则通过树搜索(如 MCTS、RAP)或外部规划器反复调用模型生成状态与动作。
然而,这两种范式在长程规划中都会遭遇严重的“上下文崩塌”。根据“大海捞针”(Needle In A Haystack)的相关研究,随着生成步数增加,上下文窗口线性膨胀,自注意力机制在检索早期变量与局部约束时的信噪比急剧下降。像 Searchformer 这样的模型试图在整个 A* 算法轨迹上训练 Transformer,但随着迷宫规模扩大、状态堆积,模型不可避免地出现早期误差累积(Error Accumulation)与捷径学习(Shortcut Learning)——它不再推导状态转移的底层逻辑,而是依赖表面 Token 序列的统计关联胡乱猜测。
正如论文作者所指出的关键洞见:Transformer 很难在极长序列中稳定维持和更新自己的“内部隐状态”,但它极其擅长作为模式匹配引擎,精确更新“外部状态”。
传统 CoT 实际上就是把计算过程写在上下文中的一种外化机制。但 CoT 的致命伤在于它是无序且无限追加的,模型每一轮不仅要计算当前一步,还要背负过去所有思考步骤的注意力开销。随着规划步数从数十步扩展到成千上万步,任何纯自回归架构都会被这种无序的全局上下文拖垮。
核心机制:计算链与结构化上下文窗口
COC 架构的核心思想十分明确:将复杂算法解耦为极简的局部转移步骤,把 Transformer 当作一个确定性的状态转移转移器(Transition Kernel),让外部存储结构承担状态持久化任务。
整个 COC 架构由两个关键组件构成:
1. 结构化上下文窗口(SCW)
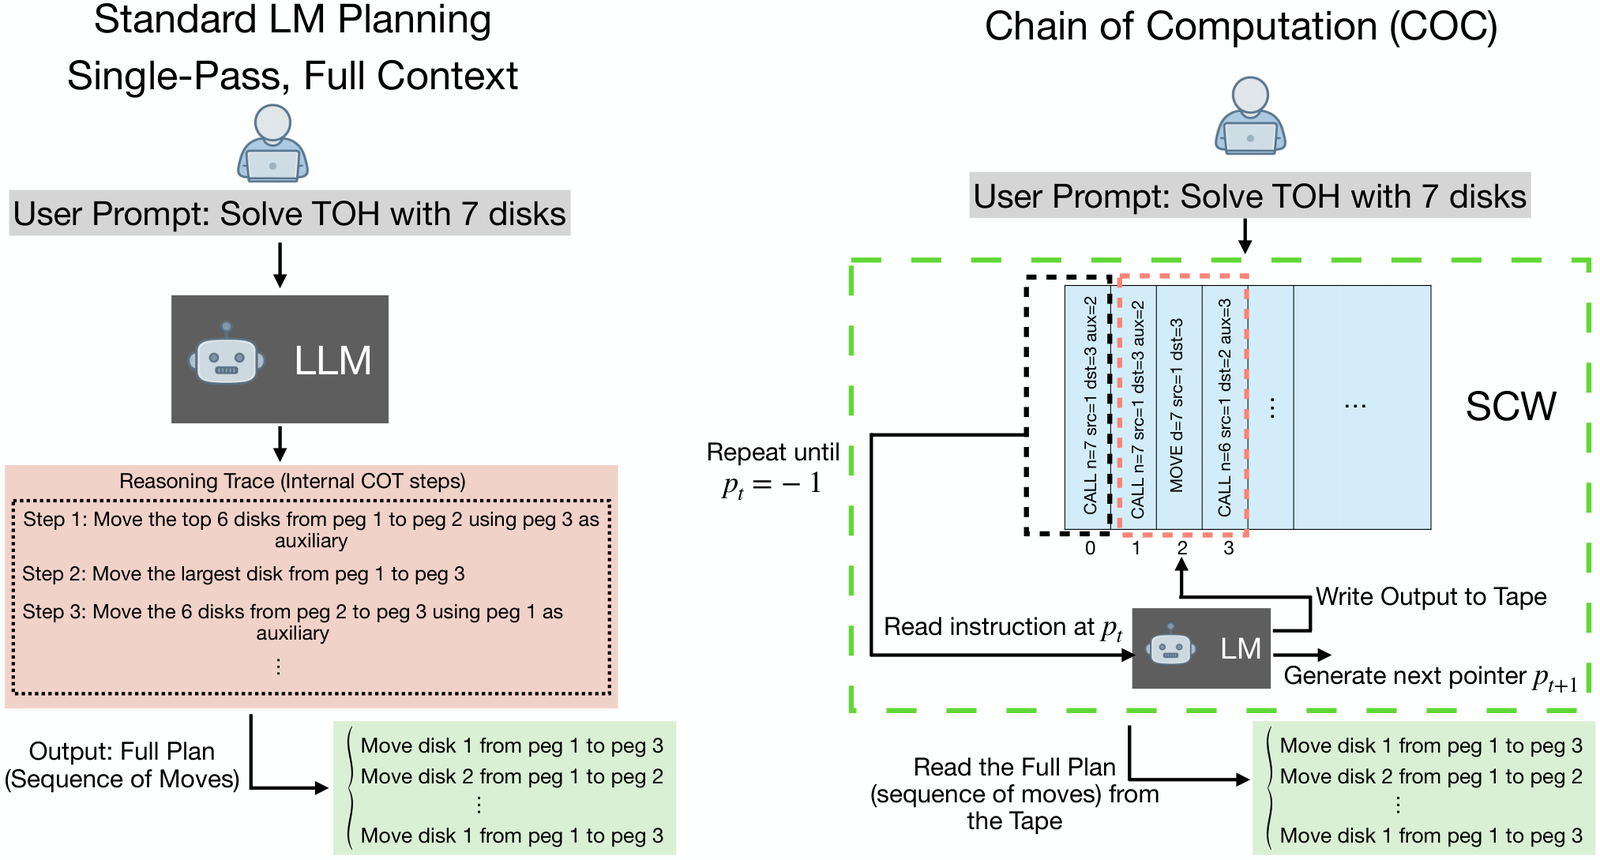
SCW 不再是一个无限向右追加的单一线性文本流,而是一个被划分成离散单元的定长外部存储系统(可类比为图灵机的纸带,或是由指令块构成的内存数组)。在每一个计算步 $t$,模型不需要感知历史上所有的规划轨迹,它只被允许查看 SCW 中的某一个特定窗口内容。这意味着输入给 Transformer 的 Token 数量是常数级别的,彻底消除了由于上下文暴增带来的计算复杂度与检索干扰。
2. 自主指针机制(Pointer Mechanism)
既然模型每次只能看一个局部窗口,那么下一个计算步该看哪里?COC 并没有引入复杂的外部调度启发式,而是把“寻址权”交给了模型自己。
在每一个时间步 $t$:
-
模型接收当前指针 $p_t$ 所指定的 SCW 单元内容(即当前需要执行的子指令或局部状态);
-
模型执行局部的模式匹配与转移预测,生成对应的计算结果或物理动作,并将这些输出追加写入到 SCW 的新条目中;
-
模型同时预测出下一个指令指针 $p_{t+1}$,以此决定下一步跳向 SCW 的哪个内存槽位;
-
循环持续进行,直到模型主动输出终止指针 $p_t = -1$,规划流程宣告结束,系统直接从 SCW 中提取出最终的完整动作序列 $\Pi$。
这种设计将算法的递归与迭代逻辑物理化了。在传统提示词下,模型需要在大脑中“维持递归调用栈”,这超出了固定层数前馈计算的承载能力;而在 COC 架构下,递归调用被显式地转化为对 SCW 的指针跳转与出入栈记录。模型只专注于最简单的单步操作:读取局部变量、变换、写回、跳到下一步。
三大经典基准的严苛考验
为了验证 COC 是否真正掌握了规划算法的执行本质,研究人员在三个对状态约束极其严苛的经典规划领域进行了从零训练(Train from scratch)的全面评估。
积木世界(BlocksWorld):不仅是解题,更学会了分治
在 BlocksWorld 中,任务要求将一组打乱的积木堆叠恢复成目标构型。传统的解法策略通常分为两阶段:先将所有积木全部搬到桌面上解包(Unstacking),再按照目标拓扑从底向上重新搭建(Stacking)。
在测试中,研究人员先在 $n=5$ 到 $40$ 个积木的尺度下各随机采样 500 个样本进行训练,然后在完全未见过的 50 个随机实例上测试,模型取得了 100% 的求解成功率。为了排除小样本测试的偶然性,团队在 $n=8$ 的全部排列空间($8! = 40,320$ 种可能状态)上进行了全量穷举评估,COC 依然斩获了 100% 的惊人战绩。
更具挑战性的是包含多堆杂乱初始构型的“扩展积木世界”(Extended BlocksWorld)。即使训练集中从未出现过某些特定堆叠数目的组合,COC 面对 $n=5 \sim 40$ 的复杂测试集,整体成功率依然高达 99.89%(仅在 $n=35$ 和 $n=36$ 上各出现一次罕见失效)。这充分说明模型并不是机械记忆了某条路径,而是真正内化了“解包-重组”的通用算法状态机。
煎饼排序(Pancake Puzzle):处理高阶置换状态
煎饼问题具有更复杂的非线性状态转移:系统只能通过前缀翻转(Prefix Flip)来逐步将大小不一的煎饼按升序排列,状态空间随规模呈阶乘级暴增。学习该领域不仅需要模型作为策略预测出当前最大的未就位煎饼,还需要其精准充当环境世界模型(World Model),在内部正确模拟出前缀翻转后的序列逆序。
面对 $n=8$ 全状态空间的 40,320 种测试实例,COC 取得了 99.99% 的准确率,仅有 1 个样本被判定为“瑕疵”。深入分析发现,该失败用例实际上是初始状态本身就已经排好序的情况。由于训练数据全是无序样本,模型在面对已完成状态时误判其仍需调整,多执行了两次无效的单煎饼翻转,但随后立即纠正并终止,最终依旧到达了目标态。这种鲁棒性在传统的端到端大模型生成中是极为罕见的。
汉诺塔(Tower of Hanoi):长程指数级动作的试金石
如果说前两个领域的多步规划依然是多项式级步数,那么汉诺塔则是长程规划的终极试炼——$n$ 个盘子的最优解步数呈指数级增长,达到 $2^n - 1$ 步。
研究人员采用了一种极为苛刻的泛化测试协议:针对 $n=1$ 到 $15$ 的盘子,将所有的指令-目标对生成出来,但随机扣留(Hold-out)其中 5% 到 50% 的样本不参与训练,只用来评估模型对未见指令的泛化表现。
-
当扣留 5% 时,COC 在 1 到 15 个盘子的平均求解成功率达到 92%;
-
即便大幅扣留 35% 的核心计算样本,模型依然保持了 70% 的平均成功率。
对比以往基于超大预训练推理模型(如强化学习微调后的顶级模型)在类似长程任务上接近 0% 的惨淡收场,COC 展现出了算法级别的高度稳定性。
失败归因与终极演进:迈向下推自动机(PDA)
在汉诺塔的极端泛化实验中,模型为什么会犯错?团队对错误样本进行了细致入微的逐步归因,发现了两大致命诱因:
-
数值算术失效:当盘子数量变大或指令索引跨度变长时,模型遇到了从未见过的数字 Token,导致基于自回归预测的指针计算或层级递减($n-1$)出现算术幻觉;
-
位置索引偏移:在追加式的 SCW 中,模型需要自主计算出很远的跳转地址,纯文本生成在此处容易产生微小错位。
这一发现指明了一条清晰的改进路径:既然规划的核心是逻辑控制流,就不该让模型将宝贵的参数容量浪费在多位数加减法上。
团队提出了两种进一步增强的解法:
其一是符号算术增强,将单纯的数字加减交由确定性的符号逻辑工具处理,模型仅负责算法调度的语义匹配;
其二是下推自动机(PDA)架构重塑。团队直接将 SCW 的纸带结构改造成一个确定性的栈(Stack)。在 PDA 设定下,指针永远默认指向 SCW 的栈顶,模型只需发出最基本的 Push 和 Pop 动作,而无需再自主计算复杂的绝对内存地址。
这一进化带来了质的飞跃。在融合了符号算术或 PDA 架构之后,COC 消耗的训练数据量大幅骤降,且成功攻克了高达 $n = 20$ 的汉诺塔问题。这意味着一个小规模 Transformer 能够在没有累积误差崩溃的前提下,毫厘不差地连续执行超过 1,000,000 步($2^{20}-1 = 1,048,575$ 步) 的极长动作流。这是以往任何大语言模型单体架构都无法企及的深度。
对未来智能体架构的技术启示
阿尔伯塔团队的这项工作不仅提出了一个高效解决规划任务的具体框架,更为当前大模型与智能体(Agent)的技术路线选择敲响了警钟,提供了三点极具价值的思考:
首先,“参数换智能”存在明确的结构边界。 盲目扩大模型参数量或无脑拉长有效上下文,并不能自然涌现出鲁棒的严谨算法能力。面对具备强状态约束的任务,决定上限的往往不是模型的体积,而是外部计算拓扑的设计。
其次,模式匹配与算法状态机必须解耦。 Transformer 的最大优势在于高维特征的模式识别与软性关联,而经典图灵机或下推自动机擅长确定性的状态存储与回溯。COC 的本质就是“Transformer 作 CPU 内核控制器 + 结构化外部存储作内存”,这种经典计算架构的回归,远比让自注意力机制在单一大文本框内自我纠缠来得高效。
最后,长程 Agent 的形态正在发生重构。 未来的高可靠自主智能体,很可能不再依赖动辄数万 Token 的粗暴 Prompt 全文回传,而是转向类似 SCW 的局部化、模块化内存交互规范。唯有让模型在每一步只处理信噪比极高的局部定长指令,才能真正消除误差累积,让复杂规划落地于工业级的确定性系统之中。