ProEvent:仅26.7%正确率,主动Agent为何频频过度反应?
ProEvent: An Event-centric Benchmark for Proactive Agents
在人机协作的愿景中,一个真正理想的个人助手绝不该仅仅是一个“戳一下动一下”的问答机器。当我们在即时通讯软件里与朋友商量周末露营,或者在工作群里反复推敲会议时间时,用户最渴望的往往是一个能够默默感知上下文、自动把敲定的日程同步到日历,并在出行前适时推送天气预警与路线规划的主动型智能体(Proactive Agent)。
ArXiv URL:https://arxiv.org/abs/2607.17701v1
然而,现实与理想之间存在着巨大的技术鸿沟。北京大学的研究团队在最新论文中指出了一个关键缺失:过去学术界针对主动 Agent 的评测,大多局限于浏览器操作或即时单步动作预测,严重忽视了以事件为中心(Event-centric)的长期动态追踪能力;同时,开放式主动响应的评估标准也长期受困于语义相似度或主观评判的模糊性。为此,研究团队推出了首个以事件为中心的主动智能体评测基准 ProEvent。实验给出了一个令人大跌眼镜的结论:即便强如前沿的商业模型 GPT-5.1,在多步真实交互环境下的日程表维护正确率也仅仅只有 $26.7\%$。绝大多数大语言模型在面对未明确下达指令的聊天环境时,普遍表现出严重的“过度反应”,陷入频繁误判与自作多情的困境。
从被动应答到主动感知:日程表维护究竟难在哪?
要理解 ProEvent 的初衷,首先需要看清当前大模型 Agent 落地时的隐形瓶颈。现有的智能体范式本质上是被动的,高度依赖用户明确给出的 Prompt。当用户在聊天软件中与多人进行复杂的日程协商时,如果每一步都要求用户专门召唤助手、整理背景、下达指令,这种交互成本本身就会扼杀智能助手的实用性。
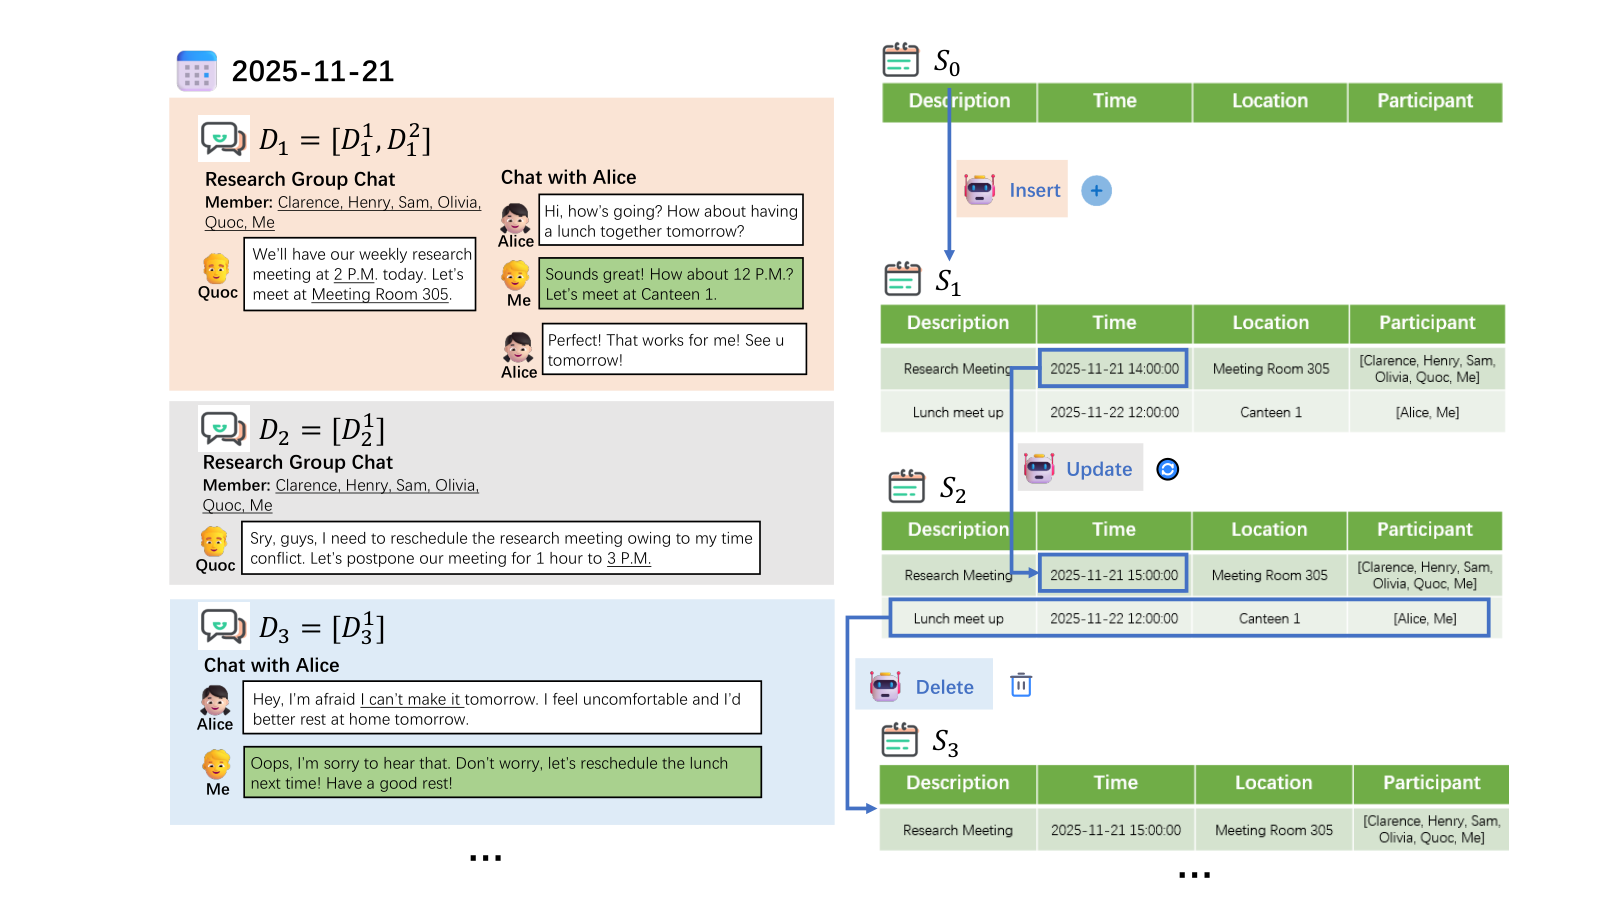
ProEvent 巧妙地将主动助手的核心能力落地为一个客观且高频的现实任务:基于即时通讯(IM)的多方聊天流,自主维护用户的日程表(Timetable Maintenance)。如图 1 所示,随着时间推移,智能体周期性地接收新产生的消息窗口 $D_t$,并结合上一时刻的日程表状态 $S_{t-1}$,自主决定是否需要输出原子操作序列(如新增事件 Insert、更新属性 Update、删除事件 Delete),从而演进得到当前时刻的最新日程表 $S_t$。
这项任务之所以远比传统任务型对话(TOD)苛刻,原因在于真实聊天场景具有三大“恶劣”特征:
其一是动态交互(Dynamic Interactions)。一次活动的敲定往往伴随多轮协商、改期、推拉与妥协。时间与地点可能在短短几分钟内变换数次,智能体必须动态跟踪最终达成的共识,而不是捕捉到时间碎片就立刻盲目触发。
其二是并发会话(Concurrent Threads)。在真实世界中,用户往往同时与同事对接工作、与家人商议晚餐、与朋友探讨聚会,多条时间线交叉推进,模型极容易混淆不同事件的上下文。
其三是无处不在的噪声(Pervasive Noise)。群聊里的闲聊打趣、与目标事件无关的旁系讨论,甚至是彻底取消但语义逼真的活动,都会成为极强的干扰源。
此外,这一任务最核心的技术价值在于构建了具备客观真值的评估闭环。以往的主动交互评测往往采用大模型打分或句向量相似度比对,主观性强且极不可靠;而在 ProEvent 中,每一次操作是否必要、最终日历状态是否与客观事实一致,都可以通过离散的状态比对与严格的操作集合实现无歧义的量化。
逼真即时通讯环境的逆向推导与构建
构造一个高质量的主动交互基准,最大的阻碍在于真实用户隐私聊天数据难以大规模获取与开源。直接利用大模型自由生成整段对话,往往又会产生逻辑扁平、缺乏波折且千篇一律的机械文本。针对这一矛盾,ProEvent 提出了一套“先定骨架、逆向推导、层层加噪”的数据合成流水线。
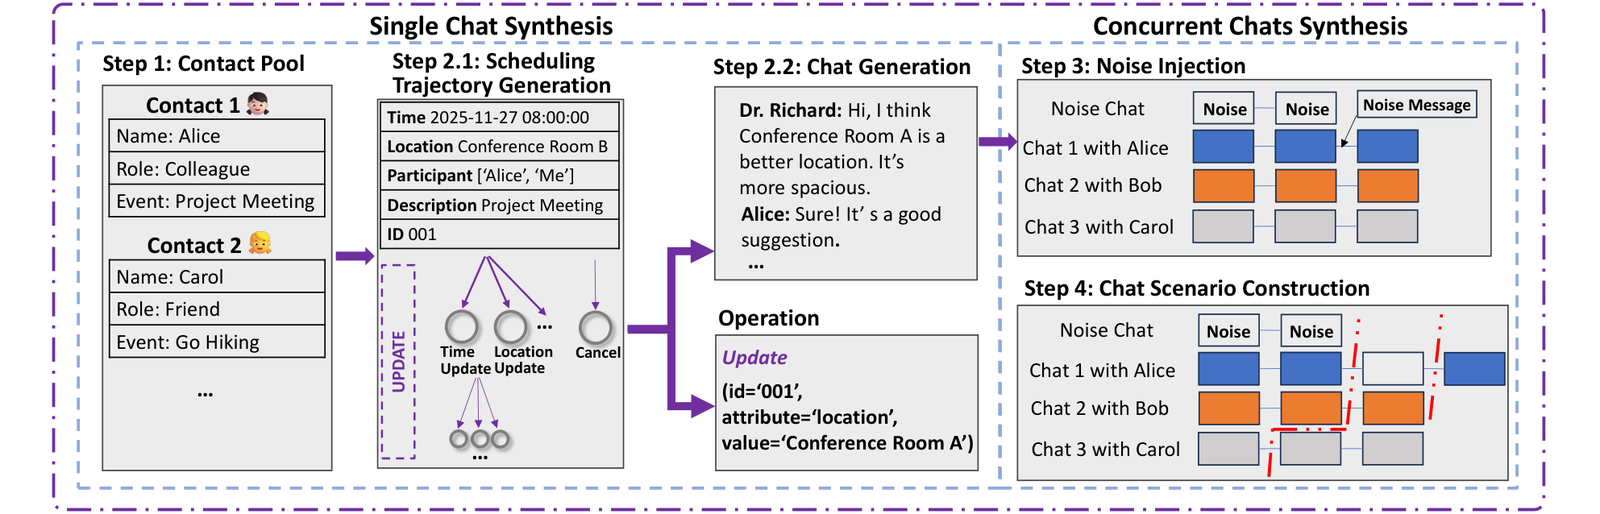
整个流程如图 2 所示,主要划分为四个系统化阶段:
第一阶段是联系人画像池构建。为了保证对话主体的长期一致性与语义合理性,研究者预先定义了 56 种涵盖不同社会关系的人物画像(例如工作上的产品经理、生活中的运动爱好者),使对话的发起更契合现实逻辑。
第二阶段是调度轨迹指导的对话合成。研究团队并没有让大模型随意发挥,而是首先生成一条严谨的“底层调度轨迹(Scheduling Trajectory)”。例如先设定初始时间为周五下午,随后某一方因故提出调整至周六上午,最终双方达成一致。有了这条精确的状态转移轨迹作为蓝本,系统再提炼出对话骨架,并调用开源高参数量模型生成贴合人类口语习惯的多轮多方对话,确保语言表象下有强约束的逻辑真值兜底。
第三阶段是现实级噪声注入。为了严防大模型靠词法特征“走捷径”,ProEvent 设计了三重噪声体系:
-
消息级噪声:在讨论目标事件的关键对话之间穿插无关闲聊;
-
会话级噪声:引入与日程无关的完整独立聊天流(例如纯技术讨论或八卦);
-
事件级噪声:在用户现存日程表中故意填充其他相似历史事件或待定事项,考验模型在检索与更新时的定位抗噪能力。不仅如此,对话中还特别融入了网络俚语、语气助词和表情符号,极大地提升了口语化真实度。
第四阶段是并发时序切片。系统将不同联系人维度的独立会话按时间轴交叉合并,并划分为固定的感知时间窗口。通过对比相邻窗口之间的事件真值差异,自动推导出当前步的标准操作集合。
最终产出的基准包含了 1249 场高质量对话,衍生出 2463 个单步决策问题与 1279 个多步复杂测试场景,全面覆盖了 7 大核心活动领域及 56 个细分子类。在双盲测试中,即便让裁判模型对 ProEvent 生成的对话与 MultiWOZ 等经典真实对话进行辨析,也几乎无法有效区分,证明了该数据集卓越的拟真度。
三维评测体系:当“不作为”与“乱作为”被量化
为了全面诊断主动智能体,ProEvent 确立了兼顾响应时机、单步精度与长期终态的立体评估体系。
在响应时机(Response Timing)维度,本文提出了两个互补指标:误触发率(False Detection Rate, FDR)与漏响应率(Missed Need Rate, MNR)。在真实世界中,用户绝不希望手机在毫无变化时整天乱弹通知,也不希望在确实敲定事情时被助手漏记。FDR 衡量了本该静默等待时模型却“过度反应”强行修改日历的比例;而 MNR 则度量了真正需要操作时模型的“失职”程度。
在单步准确性(Single-step Correctness)维度,采用微观的精确率(Precision)与召回率(Recall),直接对当前时间窗口内模型预测的操作集合与真实操作集(增、删、改)进行对齐校验。
在多步终态正确率(Multi-step Correctness)维度,研究设立了事件成功率(Event Success Rate, ESR)与日程成功率(Timetable Success Rate, TSR)。这两个指标旨在绕开单步执行路径的表层歧义。举例来说,若某个属性变更,模型选择“先删后增”与直接“原位更新”,虽然单步预测的操作符号不同,但最终沉淀在日程表里的状态是完全一致的。TSR 极其严苛:只有当某个场景中包含的所有事件在经过多轮交互推进后,其名称、时间、地点、参与者等全部属性分毫不差,该日程才被算作成功。
实验揭秘:大模型为何普遍变成“惊弓之鸟”?
研究团队在 ProEvent 上全面测试了主流的开源与闭源前沿大模型,包括 Qwen-3 系列、DeepSeek-V3.2、DeepSeek-R1、GPT-5.1,以及两种特定的主动提示策略:鼓励积极响应的 Proactive 流水线,和强调反思必要性的 ProCoT(Proactive Chain-of-Thought)流水线。
实验结果呈现出令人深思的规律:
首先是令人担忧的过度反应倾向(Overacting)。在近乎所有的基础模型中,误触发率 FDR 都远远高于漏响应率 MNR。以性能强劲的 DeepSeek-V3.2 为例,其漏响应率仅为 $21.9\%$,表现出敏锐的嗅觉;但其误触发率却飙升到了惊人的 $96.5\%$。这意味着,当聊天记录里没有任何日程操作需求时,模型几乎每一次都无法忍受“什么都不做”,偏要画蛇添足地捏造一条日程操作。大模型似乎形成了一种根深蒂固的被动任务思维惯性:只要有输入文本,就必须产出显式的执行动作。
其次,推理能力是压制“过度反应”与解决“事件取消”的核心解药。强化推理模型 DeepSeek-R1 与引入反思推理的 ProCoT 架构展现出巨大的优势。ProCoT 明确迫使模型在行动前自主辩证“当前是否真的需要响应”,直接将模型的误触发率压低了 70 个百分点。在最棘手的“删除(Delete)”操作评测中,普通模型的 Precision 往往在 $30\%$ 左右徘徊,频繁把暂时的延期误判为彻底取消;而引入深度推理的模型,在删除操作上的 Precision 均跃升到了 $77\%$ 至 $99\%$ 的极高水准。这表明,辨别隐式否定与虚假取消,极度依赖深层次的上下文因果推断。
最后,单步到多步的性能雪崩极其剧烈。即便是在单步评测中召回率与精确率都达到不错水平的模型,一旦进入长周期的多步交互累积,误差便呈指数级放大。在最关键的完整日程成功率(TSR)上,商业顶尖模型 GPT-5.1 也仅仅交出了 $26.7\%$ 的答卷,DeepSeek-R1 仅有 $27.2\%$。这意味着在接近四分之三的多轮复杂场景中,当下的主流模型最终交出的日历都充斥着脏数据。
现实复杂度的严峻考验:会话越长,并发越高,模型越盲
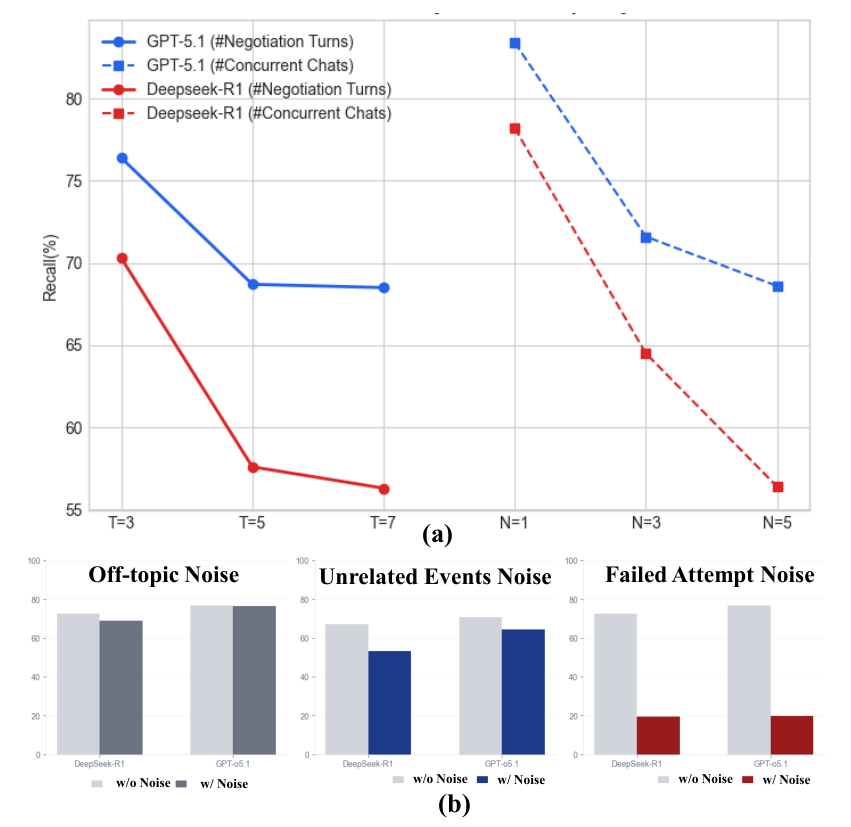
深入分析消融实验,可以清晰看到现实世界中三项核心变量对前沿模型的系统性削弱(如图 4 所示):
-
协商轮数的影响:随着双方敲定事件的推拉轮次($T$)增加,GPT-5.1 与 DeepSeek-R1 的操作召回率呈现出近乎单调的下降趋势。多轮改口会让长上下文中的时间实体发生漂移,模型极难锁定究竟哪一次陈述才是最终达成的定论。
-
并发聊天流的冲击:当并行的聊天线程($N$)从 1 扩展至 4 时,各模型的召回率出现断崖式下跌。在跨越不同联系人、不同事件主题的多线程消息交织下,模型处理上下文路由与注意力分配的能力被严重分散,频繁发生“漏跟”现象。
-
噪声语义的致命误导:传统的离题闲聊并不会让模型严重失常,真正让智能体崩溃的是“与用户无关但包含日程的讨论”以及“最终宣告流产的尝试性协商”。图 4(b) 显示,这类具有极高语义混淆度的噪声,会直接诱导模型在不该行动时强行落盘,使模型原有的精确率与召回率双双受挫。
质性分析:主动智能体暴露出三大认知死穴
为了探明底层失效的根本原因,研究人员深入剖析了 GPT-5.1 和 Qwen-3 等模型的典型错误案例,提炼出了当前大语言模型作为主动 Agent 时的三大内在认知缺陷。
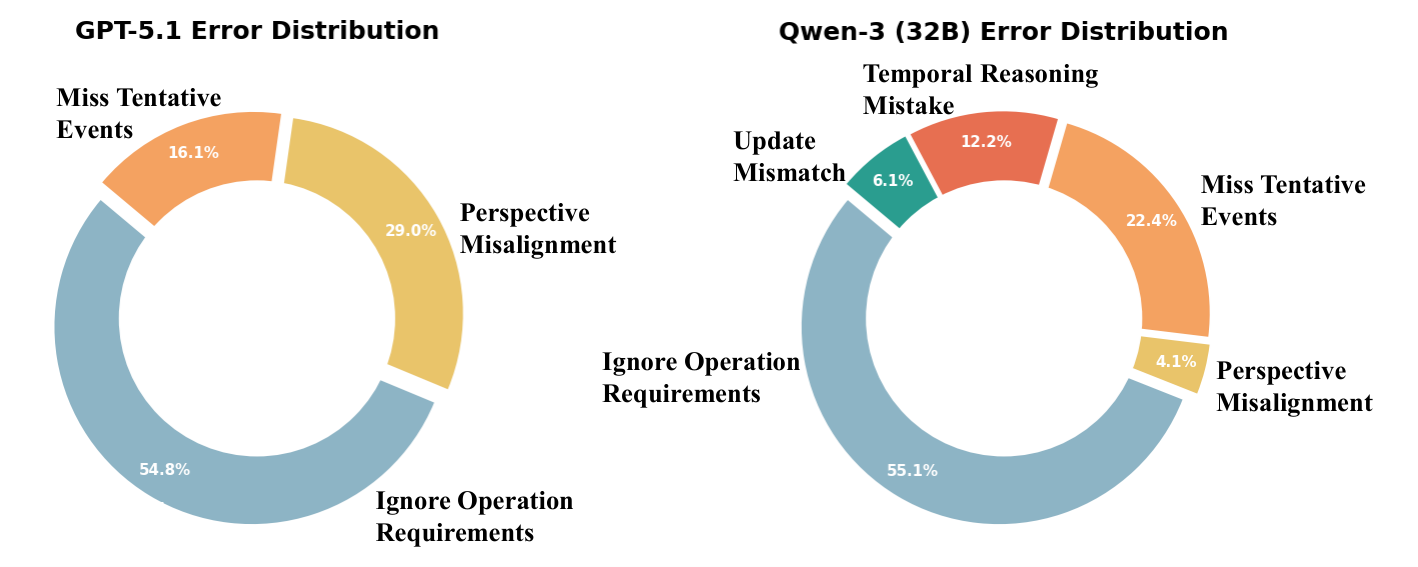
第一项缺陷是第一人称视角的严重缺失(Lack of First-person Perspective)。这是全篇最具洞察力的一项发现。如图 6(a) 所示,在真实的日程管理中,助手服务的是特定用户(例如 Jerry)。当聊天记录中出现“Jerry 明确表示自己无法参加派对”时,从 Jerry 的第一人称视角来看,该事件在其个人日程表中已经毫无意义,正确的动作是执行 Delete(将整个事件从日程表剔除)。然而,模型却机械地以“全知上帝视角(第三人称)”来决策:它保留了这项活动,仅仅在参与者名单(Participants)里将 Jerry 的名字删去(执行了 Update 操作)。模型完全未能将自己锚定在“个人随身助手”这一利益相关的主体视角上,导致生成的日程完全违背了用户的实际需求。
第二项缺陷是对叙事型隐式表达的感知盲区(Blindness to Implicit Narratives)。如图 6(c) 所示,在即时通讯中,人们经常使用富含代词或指代性的口语表达,例如“把上次那拨人叫上”或“跟上周一样的地点”。GPT-5.1 在面对明确带有“请添加参与者”这类结构化指令时表现优异,但一旦这类需求隐藏在自然叙述的对话细节中,模型就会发生感知偏差,直接跳过该操作。后续的消融实验证明,若人为将隐式口语改写为结构化显式指令,模型的召回率能大幅攀升超过 40 个百分点。这表明模型并不缺推理逻辑,而是在主动感知层面上存在严重的“显式指令依赖症”。
第三项缺陷是时间推演与多事件记忆错位(Temporal and Memory Mismatch)。在参数规模相对偏小的模型(如 Qwen-3-32B)中,普遍存在将“下周四”与具体公历日期换算错误的底层推理 Bug;而在复杂多事件交织的环境下(如图 6(b)),模型还频繁发生“张冠李戴”的更新错位,将针对事件 B 的地点修改错误地应用到了早先记录的事件 A 上,暴露了记忆检索与实体对齐能力的薄弱。
主动 Agent 的下一程何去何从?
ProEvent 的提出,打破了过去主动智能体评估长期依赖表面语义匹配与主观打分的温吞局面,用一个高度拟真、抗噪极强且拥有严密状态机校验的基准,给全行业敲响了警钟:我们距离一个真正可用、省心、不添乱的主动个人助理,依然有相当遥远的距离。
这项工作为未来的主动 Agent 研究指明了几个极具价值的演进方向:
首先,未来的 Agent 架构必须从根本上戒除“有输入就必须有输出”的过度反应机制。在强化学习或对齐训练中,应当针对“克制与静默”赋予更高的奖励权重,让模型学会深思熟虑地“等待”共识达成。
其次,需要将“第一人称主体性”作为核心对齐目标植入交互逻辑中。智能体必须始终明确“我是谁的助手、站在谁的利益与视角思考问题”,防止在多方会话中发生主客体混乱。
最后,面对并发长会话,单纯依靠长上下文暴力塞入已经显现出疲态,融合结构化日历工具、显式时间运算模块与基于实体的局部记忆对齐,将是打破多步成功率瓶颈的必由之路。