算力全浪费在重复Debug?哥大等重构科研Agent:金牌数翻倍至38枚
Recovering Wasted Compute in Autoresearch Agents
近年来,由大语言模型(LLM)驱动的自动化科研智能体(Autoresearch Agents)与机器学习工程智能体(MLE Agents)成为人工智能前沿的研发重点。从自动化特征工程、模型选择到全自动撰写研究报告,工业界与学术界投入了巨量资源,寄希望于让 Agent 替代人类完成昂贵且枯燥的算法研发。主流开源框架如 AIDE 和 ML-Master,在行业基准 MLE-bench 上展现出了令人侧目的解题能力。
ArXiv URL:https://arxiv.org/abs/2608.10424v1
然而,表面的高光掩盖了一个严重的系统性隐患:当前科研智能体的大量计算资源处于极度浪费的状态。在两小时的标准计算预算内,智能体往往把大把算力花在不同分支间重复解决同一个环境报错上;一旦跑通一个平庸的 baseline,便因粗糙的收敛判定草草结题,将大半预算弃置不用;甚至陷入死循环的搜索路径无法自拔。
来自哥伦比亚大学、乔治城大学与 Capital One 的研究团队在深入解剖这一现象后,提出了一套全新的系统性解决方案。在底层大模型完全固定为 GPT-5-mini、不改动任何模型权重的严苛前提下,仅通过对智能体架构(Scaffold)的系统重构与算力回收,就将 AIDE 在 9 项严肃机器学习竞赛中的金牌总数从 22 枚大幅提升至 38 枚,几近翻倍,并将基线原本 19% 的完全崩溃率彻底压缩归零。这项工作向社区揭示了一个关键事实:当前科研智能体的能力瓶颈并不全在底层语言模型,糟糕的脚手架架构正在吞噬大模型本该释放的研究潜力。
算力黑洞:自动科研智能体的四大原生缺陷
在标准的树搜索(Tree Search)范式下,代码生成的每个节点代表一个候选代码库,边代表一次代码修改与迭代。智能体不断评估节点的验证集分数,决定下一步是全新起草(draft)、修复报错(debug)还是渐进式优化(improve)。研究团队通过大规模日志追踪,精确锁定了造成算力大量浪费的四大缺陷:
首先是严重的上下文孤岛(Context Isolation)。在并行或深度的树搜索中,各个探索分支彼此完全隔离,没有共享的失败记忆。这意味着只要运行环境存在某个隐式约束(例如特定库的版本不兼容或特定 API 签名的变动),分支 A 花费三轮交互才踩坑摸索出的修复规则,分支 B 根本无从知晓,只能从头把同样的错误重新踩一遍、重新消耗算力 debug。
其次是超参数优化的完全缺位。人类算法工程师在搭建完基本模型骨干后,会投入大量算力通过网格搜索或贝叶斯优化仔细打磨超参数。但现存智能体往往缺乏全局预算意识,通常在生成几个可运行的简单 baseline 后,就因为局部未报错而错误触发终止逻辑,将剩余的充足算力弃之不用。
再次是盲目而脆弱的树搜索回溯。当分支陷入不可自拔的代码死循环时,目前的智能体大多依赖极其简陋的随机回溯机制。这导致智能体频繁在相似的死亡节点之间反复横跳,无法跳出低效搜索陷阱。
最后是令人啼笑皆非的数据分析“形式主义”。智能体在提示词驱动下,往往会机械模仿人类写出一长串探索性数据分析(EDA)脚本并打印统计结果,但在后续的特征工程和建模决策中,这些分析结论却被直接抛掷脑后,没有任何下游逻辑真正采纳这些数据洞察。
全局 Debug 顾问:把局部的教训固化为全树常识
针对上下文孤岛所导致的算力内耗,研究团队设计了名为上下文感知调试顾问(Context-Aware Debug Consultant)的核心机制。
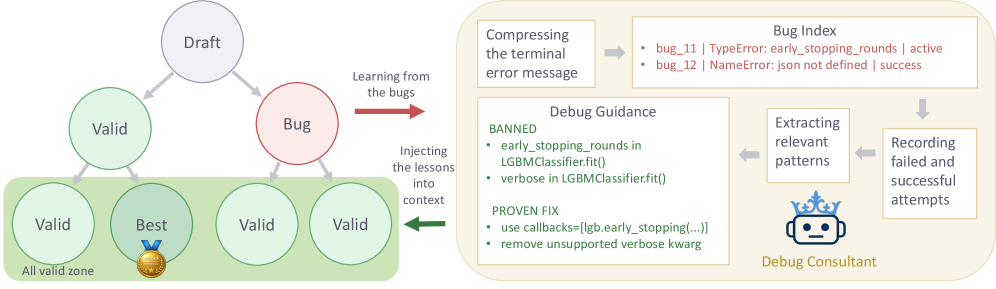
这一机制打破了树搜索分支之间互不相通的壁垒。如图 1 所示,一旦某个节点运行崩溃并成功完成修复,调试顾问便会介入,将崩溃调用栈、失败修复尝试以及最终生效的补丁进行提炼,压缩进一个全局共享的 Bug 索引库中。该索引库提炼出两项关键产物:一是当前执行环境中绝对禁用的代码模式(Banned Patterns),二是经过验证的正确修复方案(Proven Fixes)。
当任何分支下一次准备生成或修改代码时,调试顾问会在生成前将这些环境硬约束动态注入到提示词上下文中。通过这种设计,智能体对运行环境的认知从“每条分支各学一遍”转变为“全树一次性掌握”。不仅如此,调试顾问还引入了确定性的控制规则:针对特定类型的执行超时与空日志输出,直接判定为不可挽救的死胡同分支,实施硬性熔断,防止智能体在缺乏有效信息的盲区里白白耗费推理预算。
机制层面的统计印证了这一设计的威力:在 AIDE 的运行记录中,全树重复遭遇相同 Bug 的比例从原本的 46% 断崖式下降到 7.8%,无报错顺利执行的节点比例则从 54.7% 提升至 79.0%。原本用于反复“擦屁股”的算力被彻底置换为探索优质代码的有效算力。
引导与控制双管齐下:逼迫智能体榨干算力做调参
为了解决智能体“有算力却不调参”的惰性,研究团队探索了从提示词约束到搜索控制循环的不同干预层级。
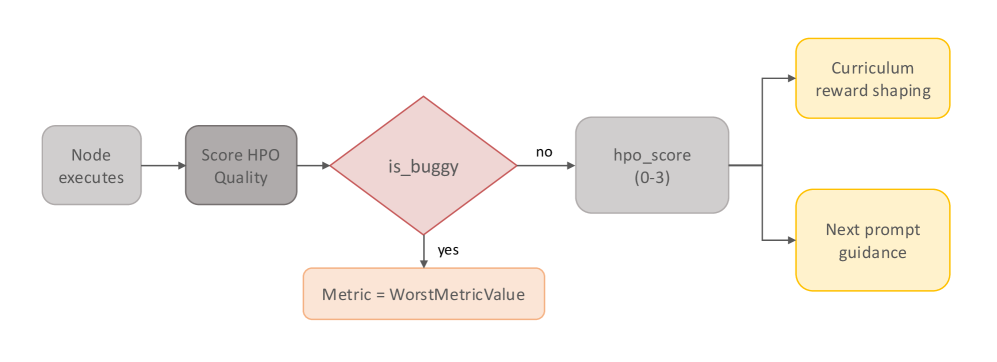
如图 2 所示,干预由浅入深分为三个层次:
-
提示词级指令(Prompt-level Directive):明确在系统指令中告知智能体当前的剩余算力预算,并在探索后期强行要求其将精力集中于学习率、正则化系数、树模型深度等超参数的调优,明确禁止在有效模型出现后继续漫无目的地大幅重写骨干结构。
-
控制循环级强制机制(Control-Loop Level Enforcement):在搜索奖励层面实施干预。系统引入专门的评估模块,对盲目的局部收敛实施惩罚,同时重奖那些基于严谨交叉验证开展细粒度参数微调的行为;当监控到算力充裕而候选池已有可用模型时,强行切断粗粒度探索接口,将状态转移死死限制在超参数调优模式中。
-
软硬结合的联合干预(P&C):将上述提示词引导与控制回路约束深度耦合。
这种强制将算力向精细化利用(Exploitation)倾斜的设计,在 AIDE 上取得了极其显著的效果。在多项评测任务中,结合了控制回路的超参数优化干预带来了高达 0.1 到 0.38 的指标绝对提升,有力证明了算法工程中精细调优在最后冲刺阶段的决定性作用。
汤普森采样回溯:让树搜索拥有概率探索智慧
当代码探索遭遇不可调和的环境崩溃时,智能体必须学会断臂求生、合理回溯。针对现有树搜索机制在回溯时采用随机挑选兄弟节点的粗放做法,研究团队引入了基于汤普森采样(Thompson Sampling, TS)的蒙特卡洛树搜索回溯算法。
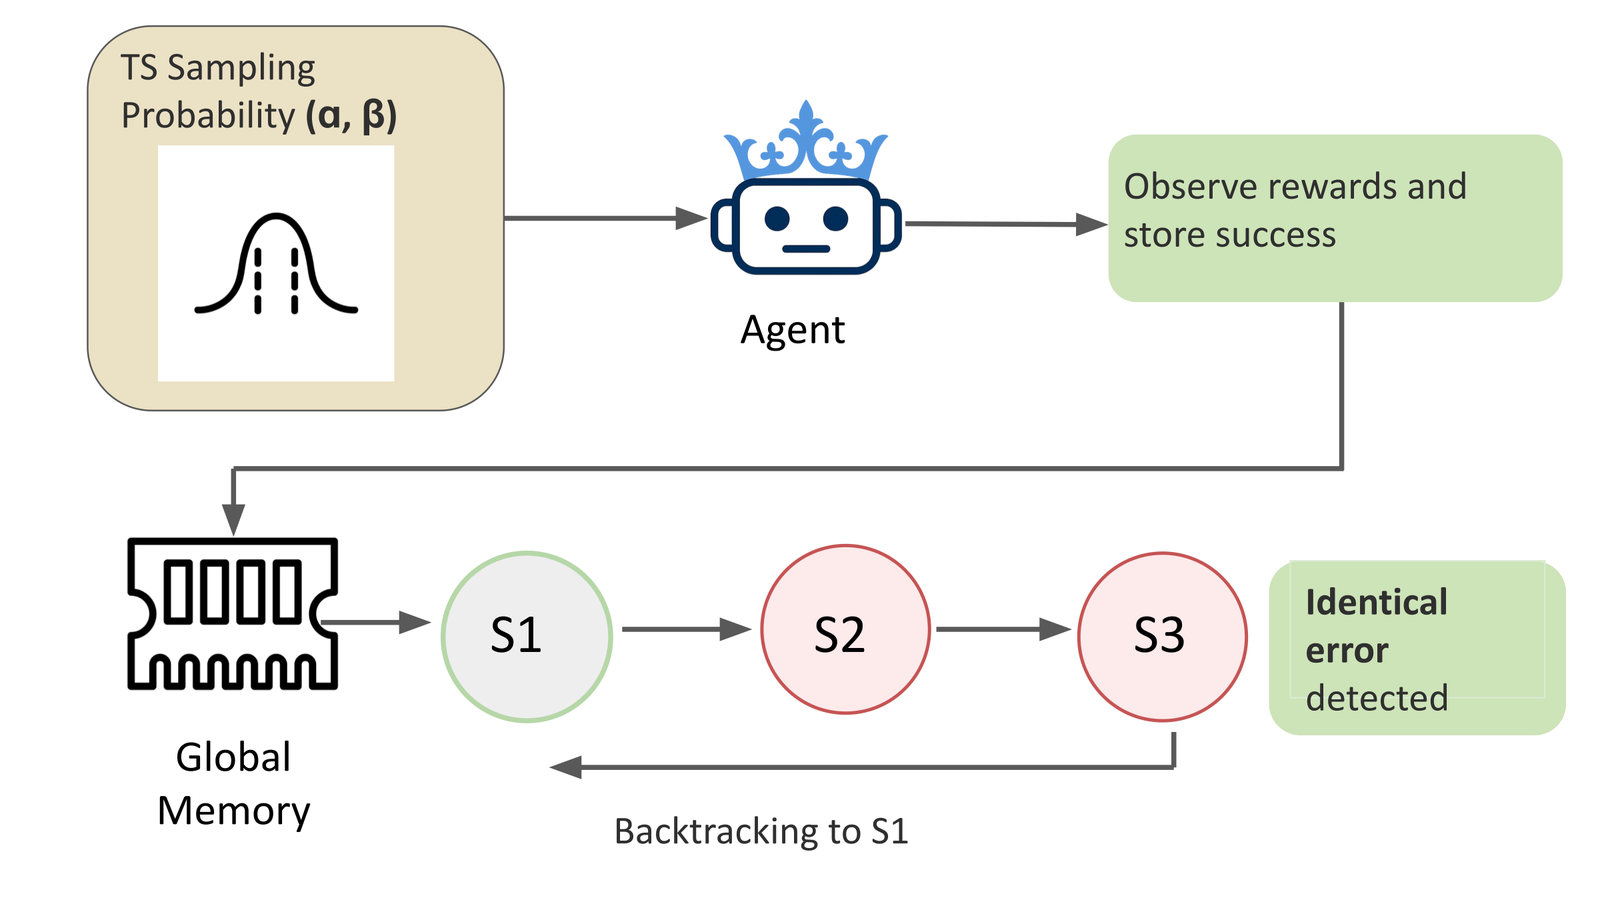
该方案为搜索树中的每个候选分支维护一个描述其代码质量的贝塔分布 $\mathrm{Beta}(\alpha, \beta)$。参数在全局内存中持久化保存,并在节点执行完毕获得验证奖励 $r \in [0, 1]$ 后进行贝叶斯更新:
\[\alpha_{\text{new}} = \alpha_{\text{old}} + r\] \[\beta_{\text{new}} = \beta_{\text{old}} + (1 - r)\]如图 3 所示,当智能体在一条深层路径上(例如从节点 $S_1$ 演进至 $S_2$ 再到 $S_3$)连续遭遇相同的死锁错误时,系统判定当前路径不可行,触发概率回溯机制。智能体不会停留在死胡同中反复打转,也不会随机抓瞎挑选分支,而是退回到最初分叉的父节点 $S_1$,从其所有兄弟候选节点的质量后验分布中进行汤普森采样,挑选采样值最大的候选继续展开。
这种机制在理论上极其优雅地平衡了探索与利用:表现稳定且屡获高分的节点分布持续右移,获得更高被选中几率(利用);而访问次数较少、认知不确定性极高的节点因方差更大,同样保留了被采样的可能(探索)。这一机制彻底消除了搜索陷入僵尸代码分支的顽疾。
实验评测:金牌数近乎翻倍背后的真相
为了验证上述干预措施的真实威力,研究团队在 9 个涵盖分类与回归的复杂表格数据集上展开了评估,评测基准主要来自 MLE-bench 和 Kaggle 近期的高难度竞赛。为了杜绝数据污染,所有竞赛数据集的发布时间均晚于底层模型 GPT-5-mini 的知识截止期。每次实验均严格限制在 22 核 CPU、2 小时算力上限内,并以 10 个独立随机种子重复运行,计算其平均分数与人类前 10% 顶尖排位(即金牌标准)。
在针对调试顾问的对比实验中,结果呈现出碾压式的优势。在 AIDE 框架下,调试顾问直接消除了基线模型原本多达 17 次的运行崩溃,将有效提交率从 81% 拉升至 100%;金牌总数从 22 枚飙升至 38 枚。在基线一无所获、全军覆没的极难赛题 S5E3 上,调试顾问甚至帮助智能体达成了 10 次运行全部夺得金牌(10/10)的壮举。类似的效果同样在 ML-Master 上复现,其金牌数从 18 枚显著提升至 29 枚。更重要的是,智能体获得首次有效提交的中位数步数直接从第 6 步降至第 0 步——这意味着智能体在写下第一行代码之前,就已经内化了由全局顾问提供的运行环境先验规则。
然而,实验中也出现了一个极富启发性的反常现象:同一套超参数调优控制方案在 AIDE 上效果拔群,但在直接迁移至 ML-Master 时却反而导致了性能下降。
深入的归因分析揭示了智能体模块间的复杂耦合性。ML-Master 内置了强烈的子节点反思机制,当控制回路强行要求其执行某种特定的超参数搜索脚本时,该脚本因某种边界条件在 ML-Master 的容器中触发了偶发性崩溃;ML-Master 的记忆模块仅仅机械地记录了“这套方法崩溃了”,却没有深究底层报错原因,导致其在后续轮次中固执地尝试同一种失败逻辑的微调变体,最终彻底把算力浪费在无效重试中。这一发现给所有做 Agent 系统工程的从业者敲响了警钟:智能体脚手架的各项机制并非彼此正交的积木,缺乏全局协同的单点干预极易引发连锁反应。
诊断性反思:智能体真的在做数据分析吗?
在论文的最后一节,作者设计了一个非常尖锐的诊断性对抗实验:检验科研智能体是否真的具备“数据科学家思维”。
在标准的机器学习研发流程中,探索性数据分析(EDA)被奉为圣经。然而当前的智能体脚手架在系统提示词中往往会矛盾地明令禁止深入 EDA,只鼓励盲目生成建模代码。为了验证智能体是否具备吸收数据洞察的能力,研究团队在 AIDE 和 ML-Master 的上下文窗口中,人为注入了一份漏洞百出、充满恶意误导结论的简易 EDA 报告。按照常理,如果智能体真的在利用 EDA 信息做下游决策,这些错误结论必然会剧烈破坏其后续的特征工程策略,导致最终模型得分暴跌。
但评测结果令人错愕:注入恶意 EDA 之后,两款智能体的最终成绩与没有任何 EDA 提示的基线相比几乎毫无波动,统计学差异极小。通过进一步引入 GPT-5 作为裁判模型对智能体的思考链与代码进行逐行审查,研究团队发现了一个残酷的事实:在基线状态下,智能体从未主动开展过实质性的 EDA;而在被强行注入恶意 EDA 的工况下,智能体承认该报告内容的比例只有 21%,最终仅有 5% 的用例在特征工程中被错误分析真正干扰。
这个诊断实验一针见血地撕下了当前自动科研智能体的伪装:智能体在代码中打印特征分布图、输出相关性矩阵的行为,本质上只是对人类代码语料的机械模仿,并没有把分析结果内化为下游决策逻辑的输入。现有智能体依然只是由验证集指标驱动的“试错生成器”,距离拥有连贯科研思维的真正科学家仍有极其遥远的距离。
走向成熟的科研智能体架构
这项来自哥伦比亚大学等机构的研究,对当前狂热的 Agent 研发浪潮提供了一剂清醒剂。它清晰地表明,现阶段制约自动科研系统能力的,往往不是底层大模型不够聪明,而是脚手架工程在记忆管理、搜索控制与算力分配上的严重幼稚。
把局部的环境报错抽象为全树共享的显式约束,用严密的控制策略遏制智能体的提前收敛与无效内耗,并用严谨的概率分布指引搜索树的回溯与探索——这三项无需改动大模型权重的设计,释放出了底层大模型本就具备但被严重浪费的代码与工程潜力。
未来的自动化科研系统如果想要真正突破玩具 demo 的边界,承担起自主提出假说、设计验证实验、归纳错误结论的科研闭环,就必须把全局记忆的结构化沉淀、搜索多样性的动态维持以及架构层面的抗崩溃鲁棒性作为核心目标。只有这样,投入进自动化研发的每一度电和每一次前向传播算力,才能真正转化为有价值的科学发现。