PluginEval:大模型工具调用总分失真?腾讯等用3000测试例拆解三大败因
PluginEval: A Diagnostic Benchmark for Fine-Grained Error Attribution in Function Calling
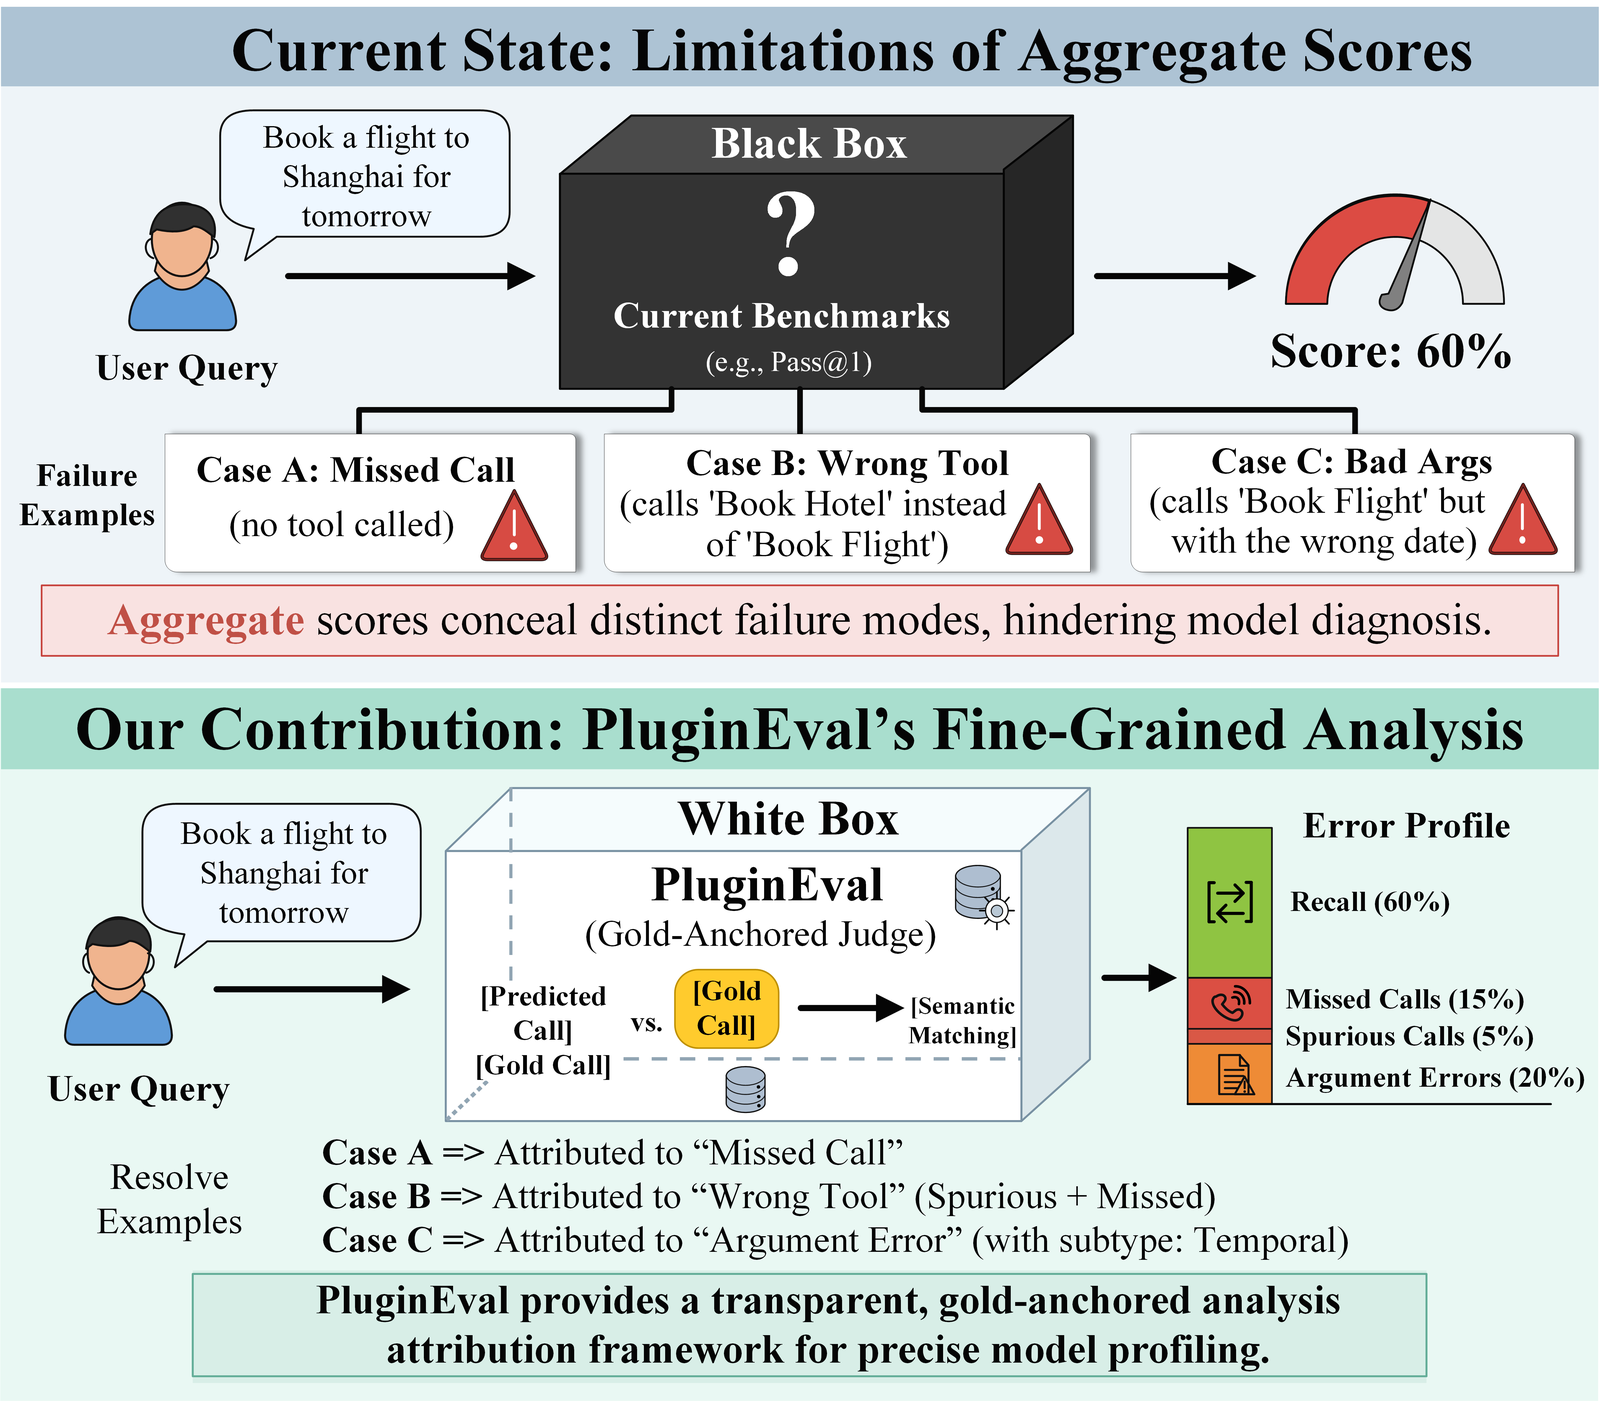
在当前大模型向自主智能体(Autonomous Agents)演进的进程中,工具调用与路由能力(Function Calling / Tool Routing)被普遍视为大模型连接现实软件生态的咽喉要道。然而,绝大多数现存的评测基准依然停留在“只看最终准确率或任务成功率”的粗粒度汇总评分阶段。这种传统的总体指标往往掩盖了模型截然不同的失败机制:一个表面上获得 70% 成功率的模型,究竟是因为对不需要工具的请求强行调用(过召回/误调),还是在面对明确指令时无动于衷(漏调),抑或是在识别了正确插件后把关键的时间、实体参数传错?
ArXiv URL:https://arxiv.org/abs/2608.08700v1
为了打破这种“只给分数、不判病因”的评测黑盒,来自腾讯、小红书、北京邮电大学、南京大学及中国科学院大学等多家机构的研究团队联合推出了针对函数调用的细粒度错误诊断基准 PluginEval。该工作不仅建立了一个包含 3,000 个经过真实 API 执行验证的高质量中文测试集,更首次提出了能够实现自我迭代演进的双阶段闭环构建框架 PCCF(PluginEval Closed-Loop Construction Framework)。实验不仅让 GPT-5.4、Claude 4.6、Gemini 3.1 Pro、DeepSeek-V4-Pro 以及 Qwen3-235B 等五大代表性前沿模型在严苛的对抗场景下“现出原形”,更明确揭示出当前顶尖模型普遍存在的结构性短板:时间参数解析是大模型集体的致命软肋,而高召回率的模型往往伴随着极差的对抗拒答能力。
现有基准的“三大硬伤”与分层决策重塑
评估大模型能不能用好工具,远比想象中复杂。研究团队指出,目前学术界和工业界广泛采用的工具评测基准普遍存在三大结构性缺陷:
其一是数据分布的严重偏斜。现实交互与大多数合成数据往往遵循幂律分布,常见的高频请求占据了绝大部分样本,而真正考验模型推理深度的长尾复杂场景、边界工况严重代表性不足。其二是缺乏高质量的“对抗性硬负样本(Adversarial Hard Negatives)”。当用户输入一段看似与某个工具紧密相关、但实际上因缺少必要条件或根本无需外部系统介入的请求时,很多基准根本不设防,导致不同模型在鲁棒性与幻觉控制上的巨大差异被完全抹平。其三是标注链路的高度不可靠。大量现有基准过度依赖无执行验证的 LLM-as-a-judge 标注,许多参数看似格式合规,但一旦输入真实 API 就会直接报错崩溃,甚至逻辑完全南辕北辙。
为了从根本上厘清问题,这项研究首先将工具路由重塑为一个严格的三级递进决策过程。第一级是“工具必要性判断”:模型必须准确判断当前用户意图是否真的需要外部工具介入,对于闲聊、常识问答或超出系统能力范围的提问,模型必须坚决拒答;第二级是“插件相关性匹配”:在确定需要工具的前提下,在候选工具库中精准锁定目标插件,排除具有误导性的相似插件;第三级是“有效调用与参数落地”:将用户的非结构化上下文精准映射为强类型、语义正确的 API 调用参数,当参数缺失或存在歧义时应拒绝虚构调用。
这一层级体系意味着,上游决策的失误会直接使下游操作失去意义。如果一个模型在无需调用工具的请求中强行触发了 API,哪怕它生成的参数格式再完美,本质上也属于严重的路由幻觉。因此,评测基准的构建必须在每一个层级上都布下清晰的边界与锚点。
PCCF框架:从执行闭环到行为校准
针对传统数据集构建中的可信度低与覆盖率不足问题,作者提出了 PCCF 框架。该框架最大的工程亮点在于将“标注可靠性”与“样本覆盖度”彻底解耦,形成了一个两阶段的闭环反馈回路。
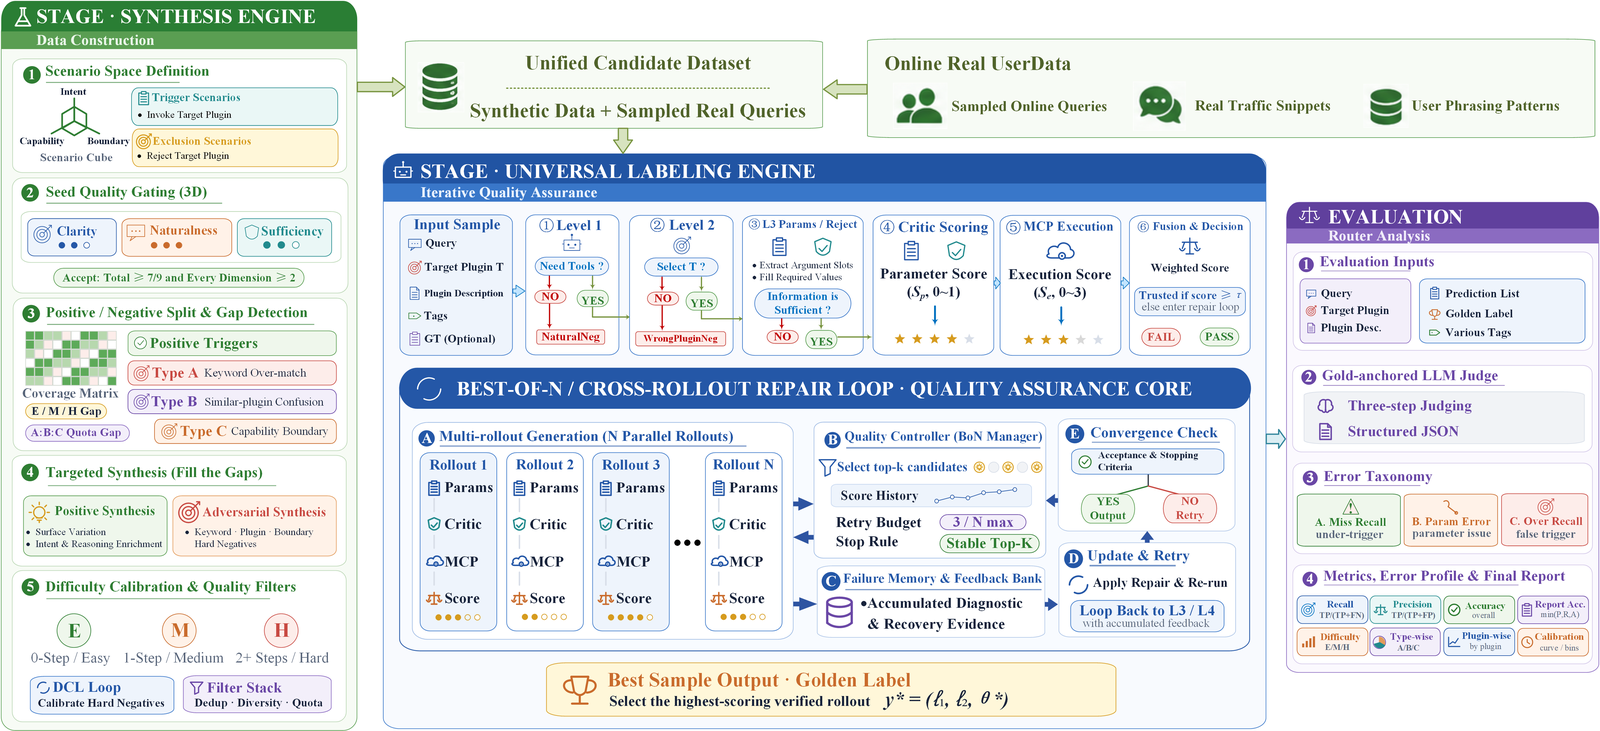
在阶段一(Stage I:基于执行落地的集成标注)中,系统同时接收自然真实查询与阶段二生成的对抗合成查询。为了彻底消除大模型“虚假正确”的幻觉,系统引入了多生成器独立提案机制。针对每一个候选调用,框架并非只做静态的 Schema 结构校验,而是直接调用真实外部 API 发起网络执行,并将执行返回的状态码、实体内容与独立的评估器反馈相结合。若候选调用未能达到质量阈值,框架会把确定性校验报错、API 异常信息以及失败轨迹作为强化信号,回传给生成器开启多轮修复,直至达到收敛阈值或选出最优金标样本。
在阶段二(Stage II:场景驱动的合成与行为难度校准)中,框架对每一个目标插件的功能说明书进行深层解构,形式化提炼出能力边界、用户意图、触发场景(Trigger Scenarios)以及三类严格的排除场景(Exclusion Scenarios)——包括无需工具场景、需要其他工具场景,以及超出当前插件能力上限的拒答场景。利用这一多维场景矩阵,系统能够实时比对阶段一已产出的有效样本,精准定位未被覆盖的长尾真空地带,并定向合成不同难度层级的测试样例。
更具突破性的是,PCCF 放弃了人工凭主观感觉定义“简单、中等、困难”的传统套路,而是采用了“基于行为的动态校准(Behavioral Calibration)”。合成出的测试用例会被推送到一组外部模型进行多次路由探测,根据多个模型在实际预测中的一致性通过率,精确标记其实际行为难度:若所有探测模型全部预测失败,该样本才被确认为 Hard 级硬负样本;若部分正确,则归入 Medium 级;若全部轻松答对,则标记为 Easy 级。如果一个负样本的实际难度低于预期目标,系统还会引入识别证据进行对抗强化,直到其难度达标后再送回阶段一进行严格的真实执行验证。这种闭环机制确保了基准中的每一个样本不仅具备经得起 API 执行检验的真实性,而且在难度分布上具备极高鉴别力。
金标锚定的三层错误归因机制
拥有了经过严密执行验证的基准之后,如何判定被测模型的成败同样是一个技术难题。传统的字符串完全匹配(Exact Match)在函数调用评估中极不合理,因为自然语言中的实体别名、浮点精度表达或等价列表顺序差异,常常导致逻辑正确的预测被误判;但若完全放任无约束的 LLM 评测器,又极易引入评测偏见和打分漂移。
为此,PluginEval 设计了一套“金标锚定(Gold-Anchored)”的层次化评测器。该评测器以阶段一经过真实执行和人工审核锁定的黄金调用(Gold Call)为唯一基准真理,评测过程严格遵循三步走漏斗:
-
工具对齐阶段(Tool Alignment):严格比对预测调用列表与黄金调用列表中的工具名称交集。预测中多出的工具被归入误调用,缺失的工具被归入漏调用,唯有名称完全吻合的工具才允许进入下一阶段。
-
参数过滤阶段(Argument Filtering):检查对齐工具的入参是否为空。任何一方参数缺失均被隔离,防止空参数调用污染后续的语义评估。
-
语义验证阶段(Semantic Verification):在金标约束下,LLM 评测器仅被允许针对参数的语义一致性给出二元判断(通过或不通过),同时严格禁止评测器自行追加或放宽参数约束。特别是在时间范畴(Temporal Scope)上执行严苛对齐,例如将明确的时间区间缩写为单一时间点的行为均被判定为错误。
最终,评测器不会只吐出一个冷冰冰的准确率,而是输出一张精细的模型“体检单”,将错误明晰地归因为三大类:漏调(Missed Calls)、误调/虚假调用(Spurious Calls / Over Recall)以及参数错误(Parameter Errors)。其中,参数错误被进一步解构为时间错误(Temporal Errors)、缺失参数(Missing Arguments)与错误取值(Incorrect Values),使模型的底层认知缺陷一览无余。
实验结果:各大顶尖模型的“偏科”真相
基于 54 个高频插件、63 个独立工具和 9 大主流应用领域的 3,000 个精标实例(包含 2,500 个正向调用与 500 个强对抗负样本),研究团队对 GPT-5.4、Claude 4.6、Gemini 3.1 Pro、DeepSeek-V4-Pro 以及 Qwen3-235B 展开了全面体检。对比现有的知名基准(如 BFCL、APIBench 和 NexusRaven),PluginEval 展现出了更显著的区分度,所有模型在 PluginEval 上的准确率均出现了不同程度的明显下滑,这直接印证了对抗硬负样本与严格参数语义落地的杀伤力。
更值得关注的是模型之间的能力分化与错误画像:
-
Claude 4.6:召回之王,但拒答能力欠佳
在五大模型中,Claude 4.6 展现出了极强的工具触发敏感度,其正样本漏调率(Miss Recall)仅为 $13.95\%$,在所有被测模型中最低。然而,在面对无需使用工具或超出能力的对抗负样本时,Claude 4.6 的过召回率(Over Recall / 误调)却高达 $29.10\%$。这意味着它在实际作为 Agent 运行时,极易产生“过度自信”的强行调用倾向,面对模糊意图时缺乏必要的审慎。
-
Gemini 3.1 Pro:最稳健的防御者
与 Claude 形成鲜明对比的是 Gemini 3.1 Pro。它在对抗负样本上的过召回率控制得极其优异,仅有 $18.55\%$,是所有模型中误调用率最低的。尽管其正向调用的绝对召回表现略逊于 Claude 4.6,但正是凭借其在“拒答与防误触”上的出色表现,使得它在整体准确率上表现出极强的综合竞争力。
-
GPT-5.4:两端受挫的工具路由困局
令人意外的是,GPT-5.4 在本基准中遭遇了较为严重的滑铁卢。它的漏调率达到了 $33.72\%$,同时过召回率也高达 $33.20\%$,在识别必须调用的工具以及规避无关工具两个维度上同时承压,反映出其在多层级中文工具路由场景下的边界感知较为模糊。
-
开源巨头与新势力的表现
DeepSeek-V4-Pro 在整体表现上超越了 GPT-5.4,在正向召回与参数解析上展现出极具竞争力的表现,但在对抗负样本上的过召回率同样接近三成;而 Qwen3-235B 则展现出了与 GPT-5.4 相似的模式,在工具识别的灵敏度与边界把控上仍有较为明显的提升空间。
当视线移至参数解析层面,实验揭示了一个惊人一致的现象:在所有大模型的所有参数错误中,时间错误(Temporal Error)无一例外地成为了占比最高的一项,在各模型中分布在 $7.96\%$ 至 $10.41\%$ 之间,发生频次显著超越了“参数缺失”或“取值类型错误”。这一结论强有力地证明,尽管各大模型在自然语言理解上已经登峰造极,但在将复杂的相对时间、时区转换以及动态时间窗口映射为精确的结构化 API 参数时,依然存在广泛的底层推理缺陷。
为什么这项工作对 Agent 落地至关重要?
在消融实验部分,研究团队给出了极具说服力的数据:如果从构建流程中剔除基于真实执行的“内容验证(Content Validation)”,生成的虚假正例率(False Positive Rate)会瞬间从 $0\%$ 飙升至 $78\%$。这一关键数字揭示了一个常被工业界忽视的残酷现实——绝大多数基于 Schema 生成的代码和入参,哪怕在语法和数据结构上百分之百合法,在语义和执行层面依然可能是毫无价值的废弃调用。同时,迭代校准机制让测试集的累积有效合格率从 $11.1\%$ 提升至 $39.7\%$,证实了闭环修复在数据工程中的决定性作用。
PluginEval 与 PCCF 框架的价值,不仅在于贡献了一个高难度的中文工具调用测试集,更在于它向整个行业阐明了一个核心逻辑:评估大模型的 Agent 能力,必须从粗放的单一准确率转向结构化的根因归因。一个只追求高召回的大模型,在实际落地进企业级软件时,极有可能演变成滥发网络请求、触发错误操作的安全灾难;而一个能够精准平衡工具必要性、插件相关性与严谨参数落地的模型,才是真正能够放权至复杂自主工作流的坚实底座。对于致力于研发大模型自主 Agent 的团队而言,这一套兼顾对抗难度、真实执行落地与精细错误归因的评估体系,无疑提供了更具现实参考意义的诊断坐标。