CAPS:看清不等于会推理!跨模态自蒸馏补齐视觉Agent,上下文省83%
Reading is not Reasoning: Bridging the Agentic Policy Gap in Vision-Text Compression
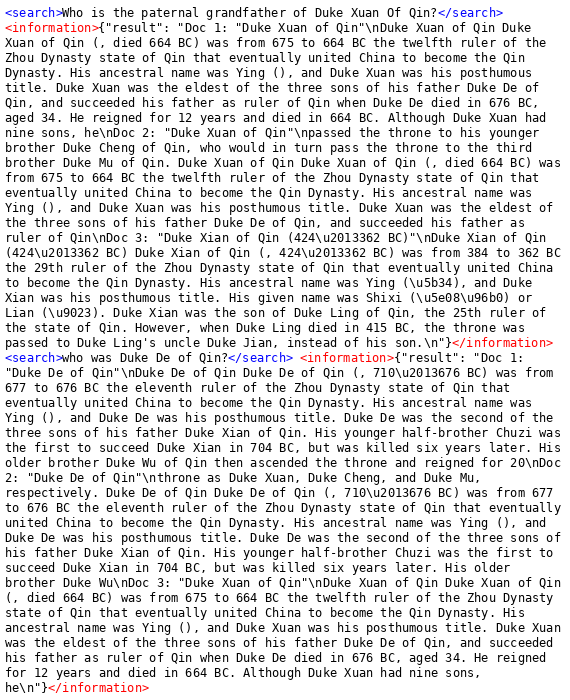
在多轮交互任务中,自主智能体(LLM/VLM Agent)往往需要频繁与外部环境交互、调用工具并逐步规划推理。然而,随着交互轮数增加,不断累积的历史记录会导致上下文窗口被快速撑爆,带来惊人的计算与显存开销。一种非常直接且诱人的优化手段是“图文压缩”(Vision-Text Compression, VTC)——将冗长的文本交互历史直接渲染成图片,利用视觉语言模型的视觉编码器将成百上千个文本 Token 压缩成寥寥数十或数百个视觉 Token。
ArXiv URL:https://arxiv.org/abs/2608.08960v1
直觉上,只要视觉模型具备良好的 OCR 光学字符识别能力,它就应当能够像阅读纯文本一样做出正确的推理与行动决策。但现实往往大相径庭:即使输入的内容完全一致,把文本历史换成渲染后的图片后,智能体的行动表现会发生断崖式下跌。学界以往通常将其归咎于多模态大模型的感知缺陷或 OCR 识别精度不足,但来自香港城市大学与华为诺亚方舟实验室的研究团队给出了一个截然相反的发现:智能体能看清历史,并不意味着它懂得如何利用这些信息进行逻辑推理与决策。
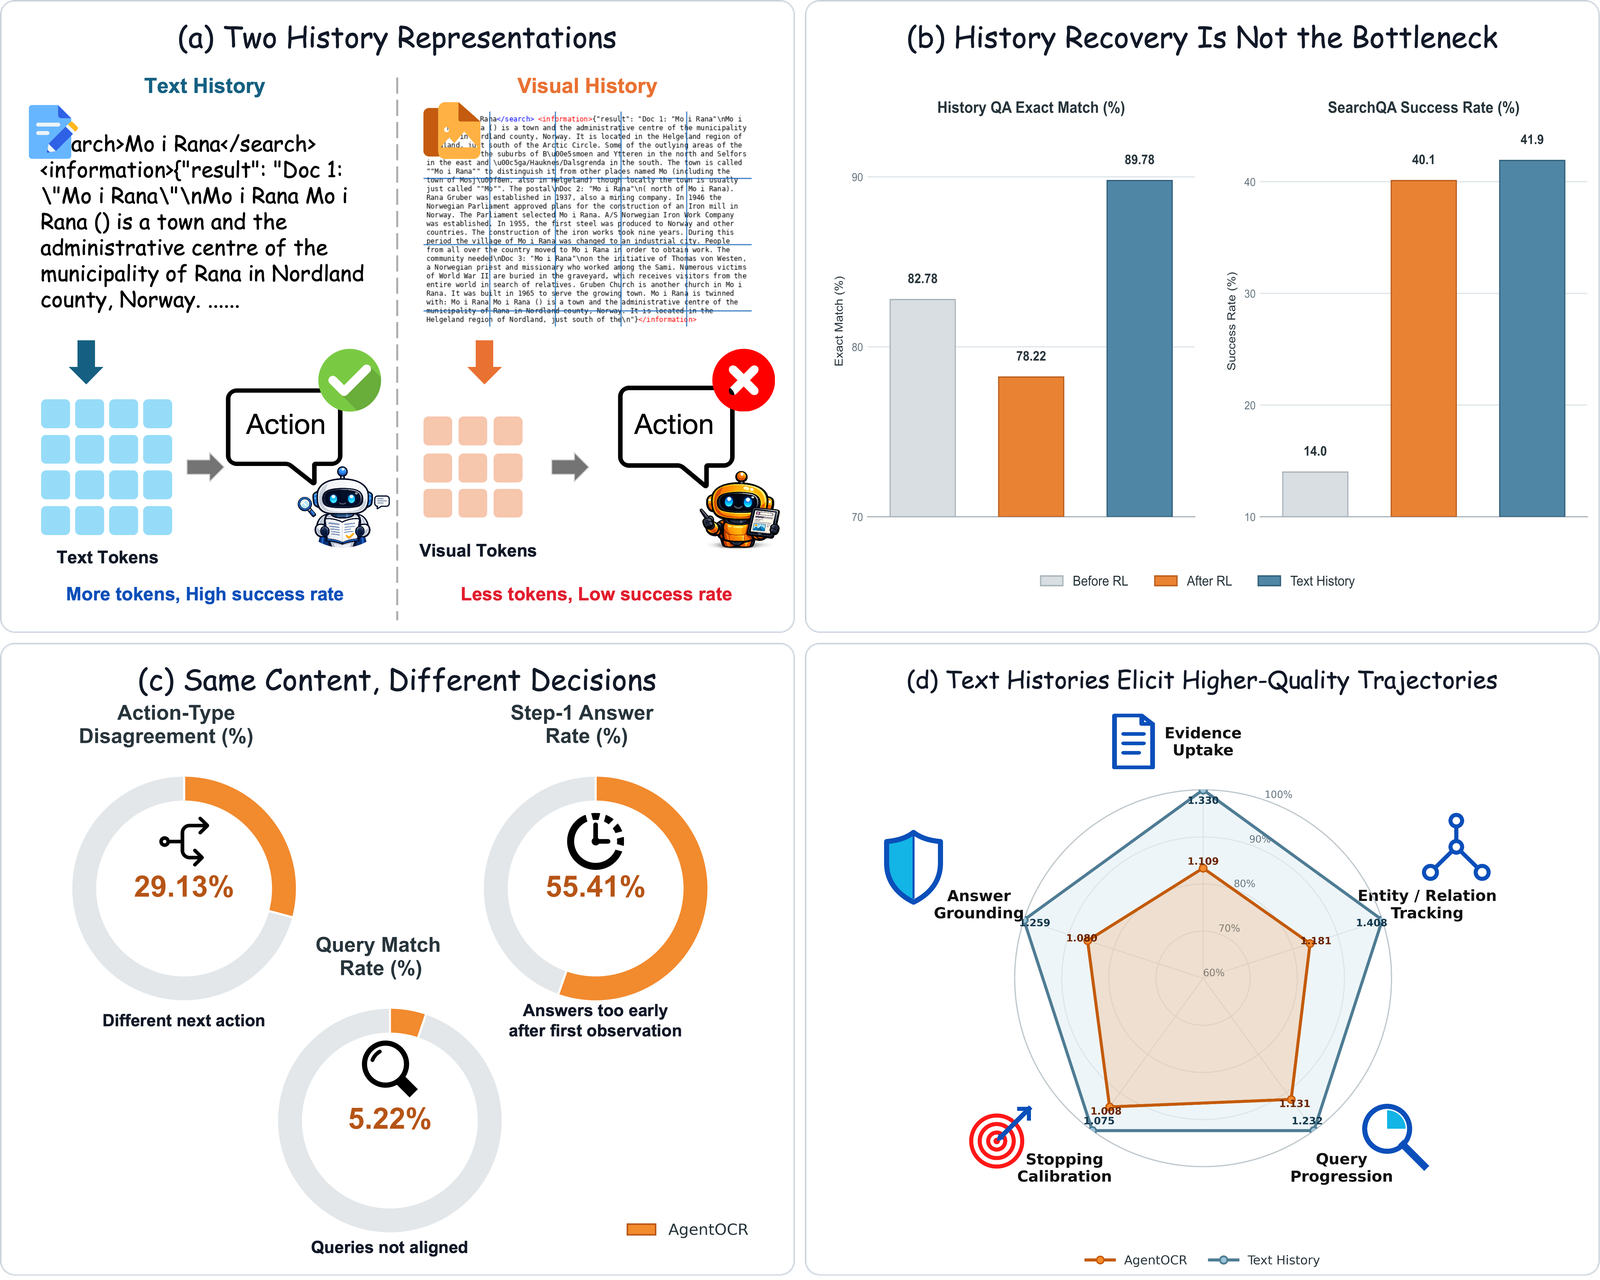
这项发表于近期的新研究明确指出了视觉历史智能体中存在的“智能体策略鸿沟”(Agentic Policy Gap)。为了抹平这一因模态切换带来的能力损伤,研究团队提出了名为 CAPS(Cross-modal Agentic Policy Self-distillation,跨模态智能体策略自蒸馏)的统一训练框架。该方法无需引入额外的大模型作为教师,而是巧妙地让同一个模型以其未压缩的文本历史策略为师,通过“离线轨迹蒸馏”和“在线策略自蒸馏”两个阶段,手把手将原本在纯文本环境下的推理与动作规划能力传递给视觉状态下的自己。
实验表明,在多跳知识检索基准 SearchQA 上,CAPS 相较于先前的最强基线 AgentOCR 分别在 3B 和 7B 模型上实现了 5.0% 和 3.4% 的成功率提升;在复杂的长流程具身任务 ALFWorld 上,成功率提升幅度更是高达 15.6% 和 14.5%,甚至超越了纯文本历史策略本身。同时,CAPS 在保持超高成功率的前提下,平均显存上下文开销最多降低了 63.3%,峰值开销降低了 83.4%。这一成果为长程大模型智能体的高效部署开辟了全新的可行路径。
困局:看得清文本,为何做不对决策?
为了彻底弄清楚图文压缩导致性能衰退的根本原因,研究团队进行了一组层层递进的受控诊断实验。他们把评测拆解为三个不同维度:底层历史恢复能力(History Recovery)、匹配状态下的单步动作决策(Matched-State Decisions)以及全局多轮交互轨迹(Complete Trajectories)。
首先在底层历史恢复测试中,研究人员构建了一个严格的 History QA 数据集,专门测试智能体能否从渲染出的历史图片中精准提取文档标题、搜索关键词、最近搜索请求和关键数字年份。令人惊讶的现象发生了:当视觉智能体通过强化学习(RL)显著提高下游任务成功率时,它在 History QA 上的提取准确率并没有任何同步提升。换句话说,强化学习教会了智能体如何完成任务,但并没有让它的 OCR 读图能力变强。这直接证伪了“性能下降是因为模型看不清图片文字”的传统直觉。
真正的病灶出现在更高层次的推理与决策阶段。当研究人员强制让文本智能体和视觉智能体面对完全一致的语义状态(即前序步骤相同,仅区分是纯文本上下文还是渲染后的截图),视觉智能体表现出了系统性的策略漂移(Policy Drift)。在面对相同的中间检索结果时,文本智能体能够敏锐捕捉到关键证据并选择停止检索、直接作答;而视觉智能体往往会做出错误的动作分类,频繁发出多余且模糊的重复查询,或者在该停止的时候停不下来,甚至在检索到核心事实后依然抓不住重点。
从整个轨迹层面的盲测评分来看,视觉历史智能体在证据整合、查询递进逻辑、终止时机校准和最终回答的依据支撑度上,均全面落后于纯文本智能体。这一系列证据充分证实:模态的转换切断了大模型内部原本在海量文本预训练中沉淀下来的高级推理机制与工具调用逻辑。视觉特征空间的表征虽然保留了语义信息,但未能有效触发下游的策略行为。
CAPS 机制:同一模型的跨模态自我“传功”
既然同一个多模态大模型在阅读文本时是个“逻辑清晰的优等生”,但在看图时却成了“举棋不定的新手”,最自然且成本最低的导师正是模型自己。
在任意交互时刻 $t$,环境输入为任务指令 $\mathcal{I}$ 和交互历史 $h_t = (o_1, a_1, \ldots, o_t)$。文本策略接收纯文本上下文 $x_t^T = (\mathcal{I}, h_t)$ 并生成响应分布 $\pi_\phi^T(\cdot \mid x_t^T)$;而视觉策略接收由历史文本渲染并拼叠而成的图像 $I_t$,以视觉上下文 $x_t^I = (\mathcal{I}, I_t)$ 生成分布 $\pi_\theta^I(\cdot \mid x_t^I)$。由于两者在底层共享相同的模型参数底座和输出动作空间,因此完全可以直接进行跨模态的自监督对齐。
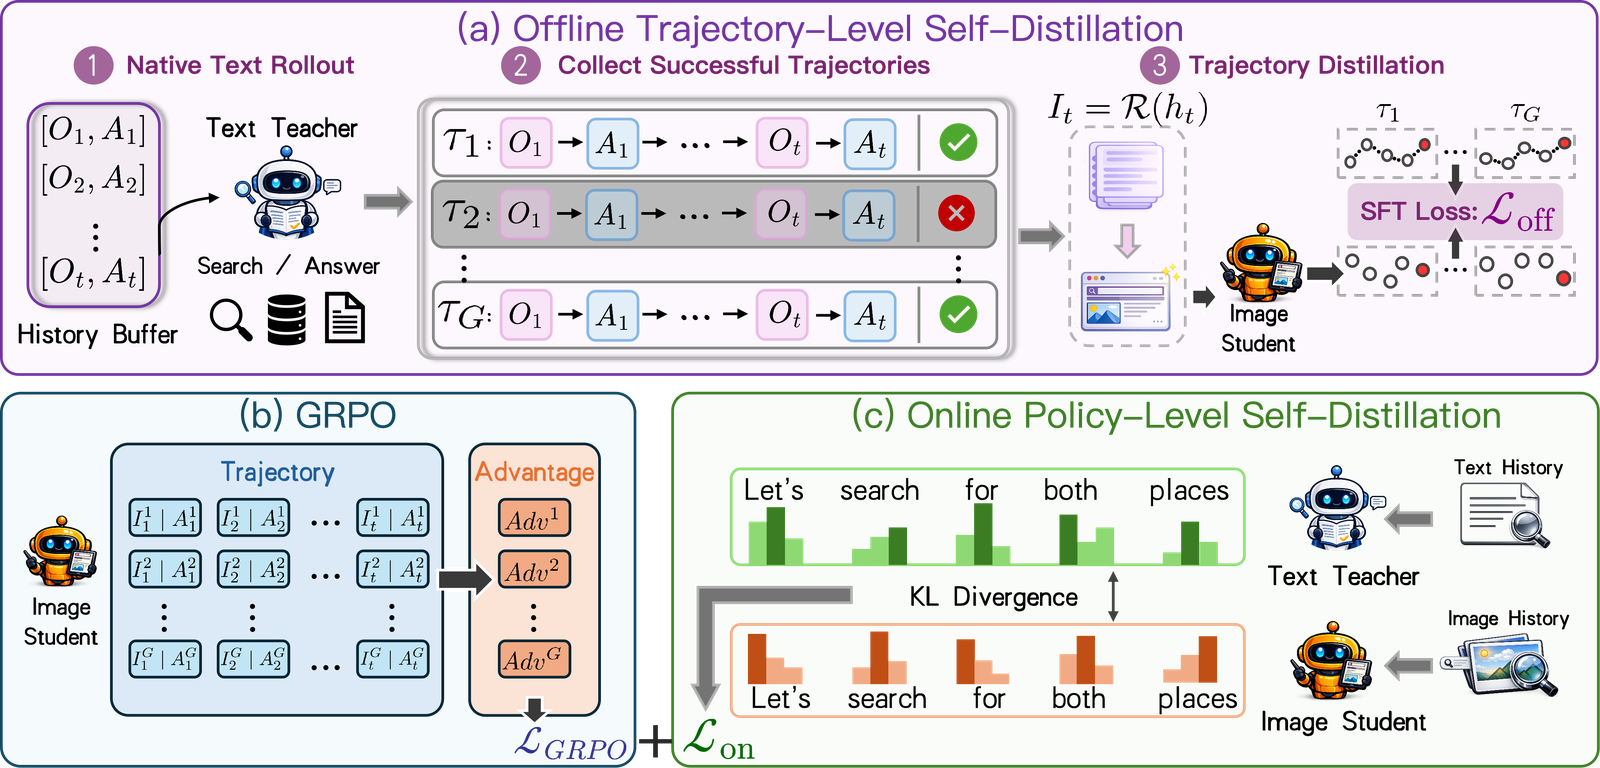
CAPS 框架的核心就在于设计了一套兼顾离线优质示范与在线探索覆盖的双阶段蒸馏机制:
第一阶段:离线轨迹自蒸馏(Offline Trajectory Self-Distillation)
要让视觉智能体学会行动,首先必须赋予它在视觉输入下生成连贯推理与正确动作的“冷启动”能力。研究团队首先利用文本历史策略 $\pi_\phi^T$ 收集其与环境交互成功的完整优质轨迹 $\tau_i = (\mathcal{I}i, {h{i,t}, y_{i,t}^T, a_{i,t}}{t=1}^{L_i})$。其中 $y{i,t}^T$ 包含了完整的中间思维链推理过程(CoT)和最终执行动作。
接着,系统将这些优质轨迹中的每一个文本历史前缀 $h_{i,t}$ 确定性地渲染为对应图像 $I_{i,t}$,构建起离线监督微调数据集 $\mathcal{D}_{\mathrm{off}}$。该阶段的优化目标为标准的自回归交叉熵损失:
\[\mathcal{L}_{\mathrm{off}}(\theta) = -\mathbb{E}_{(\mathcal{I}, I, y^T) \sim \mathcal{D}_{\mathrm{off}}} \left[ \frac{1}{\lvert y^T \rvert} \sum_{k=1}^{\lvert y^T \rvert} \log \pi_\theta^I (y_k^T \mid \mathcal{I}, I, y_{<k}^T) \right]\]这一步的关键在于,被监督的不仅仅是动作指令本身,更包含了思考链条,从而强制引导模型将视觉图像中的字面线索与深层推理链路绑定。
第二阶段:在线策略自蒸馏(Online Policy Self-Distillation)
仅靠离线成功轨迹是远远不够的。在强化学习试错或实际部署时,视觉智能体往往会做出自己的次优探索,从而陷入离线数据集中从未出现过的状态分布中。此时,传统的离线蒸馏便失去了效用。
为此,CAPS 在第二阶段引入了结合强化学习的在线策略蒸馏。该阶段使用 GRPO(Group Relative Policy Optimization)作为主干强化学习算法,同时引入一个被冻结权重的文本历史策略作为在线教师。在视觉智能体与环境实时交互生成的每一步状态中,系统同步保留其对应的纯文本历史表示。视觉学生模型根据当前图像采样生成动作前缀 $\widehat{y}_{<k}$,随后视觉学生和文本教师分别在各自的模态上下文下,针对同一个前缀预测全词表的下一个 Token 概率分布 $p_k^S(v)$ 与 $p_k^T(v)$。
系统通过前向 KL 散度(Forward KL Divergence)来惩罚两者的策略偏差,并施加截断上界 $\tau$ 以免异常扰动破坏强化学习训练稳定性:
\[D_{b,k}^{\mathrm{FKL}} = \sum_{v \in \mathcal{V}} p_{b,k}^T(v) \log \frac{p_{b,k}^T(v)}{p_{b,k}^S(v)}\] \[\mathcal{L}_{\mathrm{on}}(\theta) = \frac{\sum_{b} \sum_{k} m_{b,k} \min(D_{b,k}^{\mathrm{FKL}}, \tau)}{\max(1, \sum_{b} \sum_{k} m_{b,k})}\]最终的总优化目标将环境奖励驱动的 $\mathcal{L}{\mathrm{GRPO}}$ 与密集教师监督信号 $\mathcal{L}{\mathrm{on}}$ 相结合:
\[\mathcal{L}(\theta) = \mathcal{L}_{\mathrm{GRPO}}(\theta) + \lambda \mathcal{L}_{\mathrm{on}}(\theta)\]这种设计巧妙地实现了“既有环境真实奖励把关最终成败,又有同源文本大师在关键分岔路口纠偏其思维过程”,确保智能体即使走进了非预期状态,也不会在视觉迷雾中彻底迷航。
实验印证:高维表现全面修复,Token 开销锐减
为了验证 CAPS 的实际效能,论文在两大主流复杂多轮评测集上进行了全面测试:涵盖单跳与复杂多跳检索的 SearchQA 任务群(包括 NQ、HotpotQA、TriviaQA、PopQA、2Wiki、MuSiQue、Bamboogle),以及长达 50 步的长程具身家庭交互基准 ALFWorld。评测采用 Qwen2.5-VL-3B-Instruct 和 Qwen2.5-VL-7B-Instruct 作为骨干模型。
在 SearchQA 评测中,针对跨领域迁移的严苛考验,CAPS 在 3B 参数规模下达到了 39.2 的平均严格匹配率(Exact Match, EM),相比此前的视觉历史基线 AgentOCR 激增 5.0 个百分点;在 7B 参数规模下达到 43.5 EM,不仅超越 AgentOCR 3.4 个百分点,更是以 0.5 点的微弱优势反超了作为教师的纯文本基线(43.0 EM)。在上下文资源占用方面,CAPS 的 3B 模型将平均显存上下文 Token 开销削减了 34.8%,峰值开销削减了 83.4%;7B 模型则分别减少了 51.3% 和 54.6%。
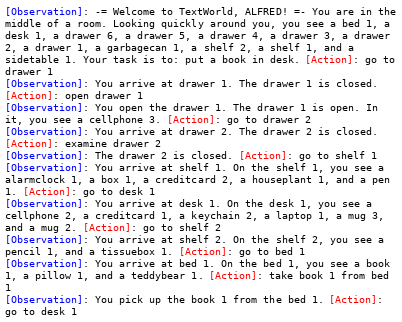
在更具挑战性的长上下文 ALFWorld 具身任务中,历史依赖窗口被完整拉长至 $H=50$ 步。此时传统纯文本 Agent 的显存暴增问题极度严峻。实验数据显示,在保持全历史输入的严苛条件下:
-
3B 模型性能:CAPS 取得了 93.8% 的任务成功率,比 AgentOCR(78.2%)高出足足 15.6 个百分点,同时也领先于技能化基线 SKILL0(87.9%)与纯文本基线(91.0%)。
-
7B 模型性能:CAPS 的成功率更是飙升至 95.7%,相对 AgentOCR(81.2%)实现了 14.5 个百分点的飞跃,不仅显著超越所有同尺寸视觉历史方法,还将 7B 模型的平均上下文开销与峰值上下文开销分别压缩了 63.3% 和 70.0%。
值得特别注意的是,CAPS 在没有对图像渲染引擎做任何激进有损压缩的前提下,其整体平均 Token 消耗甚至比 AgentOCR 和 SKILL0 还要低。这一现象背后的本质是:由于智能体决策策略大幅优化,它不再频繁发出试探性的冗余指令,而是能够用更少的交互轮数迅速达成目标,从源头上缩短了交互生命周期与历史厚度。
消融实验进一步证实了双阶段设计的必要性。如果仅进行离线轨迹自蒸馏,7B 模型的平均得分会从 43.5 跌落至 42.9;如果仅保留在线策略蒸馏,得分则降至 41.4;而如果直接在离线阶段使用原始文本输入(未进行图像映射),模型甚至退化至 40.7,几无收益。这充分表明,让智能体在冷启动期习惯于从视觉界面中读取并规划动作,是后续在线强化探索能够平稳收敛的前提。
从认知机制看 Agent 的未来压缩架构
为了深入剖析 CAPS 究竟治愈了视觉智能体的哪些具体病症,研究人员通过盲测评估量表,从五个具体维度对智能体的行为模式进行了统计画像:
[盲测五维评估诊断]

1. 实体绑定 (Entity Binding)       :精准锁定目标实体,排除近似实体干扰的能力

2. 检索递进 (Query Progression)   :根据已有证据逐步收敛搜索词的能力

3. 终止校准 (Stopping Calibration):获取足够事实后即刻结算答题的能力

4. 证据整合 (Evidence Use)        :跨多步检索信息合成正确逻辑链的能力

5. 事实依托 (Answer Grounding)    :回答内容严格基于检索证据而非自身幻觉
评测结果清晰地显示,AgentOCR 在上述五项指标中无一例外地处于最低水平,而 CAPS 则全面逼近甚至在部分维度上追平了文本策略。论文中的一个典型案例直观地揭示了这种差异:在面对一道涉及阿斯特家族(Astor family)历史人物的复杂检索题时,初始检索返回的内容中同时包含了主角母亲和旁系亲属的干扰信息。原始的视觉智能体 AgentOCR 立刻被旁系实体的线索带偏,顺着错误的名字连续发出了多次无效检索;而经过 CAPS 蒸馏后的视觉智能体展现出了坚固的“实体绑定”能力,准确锁定了目标人物并在下一步立刻完成了推理收敛。
这篇研究给当前多模态智能体工程领域带来了一个至关重要的观念纠偏:在多模态 Agent 系统的上下文降本增效中,工程人员往往倾注大量心血去设计更精妙的高分辨率切图算法、更高效的视觉特征压缩器或是更清晰的字体渲染排版,然而系统能力天花板的关键制约点,根本就不在前端像素的还原度上。
渲染把符号化的文本变为了密集的连续感知信号,这本身是一次重大的界面模态迁移(Modality Shift)。大模型具备优秀的通用多模态感知能力,却并不天然懂得如何在全新的视觉交互界面中延续它在语言空间中锤炼出的严谨逻辑。CAPS 的成功证明,通过合理的跨模态自蒸馏机制,无需引入外部更强或更大的黑盒模型,系统便能利用模型自身在纯文本世界中的“逻辑智能”,完美渡化它在视觉世界中的“认知盲区”。对于未来需要极长交互轮数、频繁多步调用的复杂 Agent 应用而言,这一范式无疑兼顾了极致的算力经济性与卓越的推理可靠性。