从被动视频生成到交互式世界模型:Sekai2开源2826小时带轨迹全景数据集
Sekai2: From World Exploration to Interactive World Modeling
视频生成大模型在逼真度上已经令人惊艳,但当行业试图将其推向“交互式世界模型(Interactive World Models)”时,一道极难逾越的鸿沟立刻显现出来:真正的世界模型不能仅仅停留在短时间的视觉平滑,它必须具备对三维物理环境的持久状态记忆。当观察者在环境中向前移动、转弯、甚至离开原点几分钟后再绕回同一地点时,模型必须保证之前的建筑物、摆设或路标依然在原来的物理位置上,而不是随着视角的移开就随风消散。
ArXiv URL:https://arxiv.org/abs/2608.09449v2
要让神经网络学会这种几何一致性与长程空间记忆,训练数据必须同时满足三个极其苛刻的条件:极长的时间连续性、精准对齐的相机位姿轨迹,以及在时间轴上精确解耦的语义标注。然而,现有的开源数据格局极其割裂。诸如 Panda-70M 或 WebVid 等百亿级网络视频虽然视觉多样,却几乎全是缺乏相机位姿的短镜头;而像 RealEstate10K 或 DL3DV 等具备精确相机位姿的三维视觉数据集,又大多局限于静态重建或短短数秒的局部视点变换,无法支撑长达数分钟的动态世界演化。
由 Alaya、上海创新研究院、清华大学与武汉大学等机构组成的研究团队正式推出了开源数据集项目 Sekai2。这项工作并非简单地堆叠视频时长,而是以构建交互式世界模型为导向,发布了包含 128,892 个视频片段、总计达 2,826 小时的大规模真实世界探索数据集。整个数据集覆盖全球 113 个国家和地区,且全部配备了相机运动轨迹与分层时序对齐标注。更具决定性意义的是,研究团队专门自采引入了 982 条带有非线性回环轨迹的全景视频,通过在相同物理空间反复重访的真实观测,首次为世界模型在无游戏引擎辅助下学习长程空间一致性提供了高质量的监督基准。
从被动漫游到世界模型:数据的三维与时序缺失
近年来从 Genie、GameNGen 到各类驾驶与机器人模拟器,生成式世界模型的火热掩盖了一个底层事实:绝大多数交互式模型仍高度依赖封闭的虚拟游戏引擎,或者只能在狭窄受限的室内、自动驾驶场景中运作。要在开放真实世界中实现任意视角的交互漫游,生成系统必须能够在内在潜空间中准确区分“世界本身在变”与“观察者视角在变”。
在普通视频中,当一个镜头向右平移时,画面中的物体向左移动;而在物体自身移动时,画面的像素变化形式可能完全相同。如果缺乏精确的外参轨迹标签,模型只能盲目地将相机运动与物体运动混为一谈。即便部分工作通过单目深度或光流尝试恢复相机运动,这类数据往往由于镜头剪辑、视角跳变和频繁的近距离特写,导致位姿解算在几秒钟后彻底漂移失效。
长时程连续性是另一个致命瓶颈。很多现有视频数据集为了迎合扩散模型的训练习惯,将视频切成 4 秒到 10 秒的独立片段。在这么短的窗口内,模型只能学到局部的物体外观和极其初级的短程运动模式,根本无法理解“物体离开视野后依然存在”的客体永久性(Object Permanence)。当智能体漫游两分钟后原路返回,现存模型几乎不可避免地会“重新幻想”出一个完全不同的场景。Sekai2 瞄准的正是这一痛点:通过长程实景视频、精准相机姿态和重访回环轨迹,打破现有数据在时间与空间维度上的短视。
数据引擎的三重来源与重构管线
为了汇聚兼具多样性与长程连续性的数据,Sekai2 搭建了一条标准严格的多源数据引擎,将三种截然不同的数据源整合进统一的技术规范中。
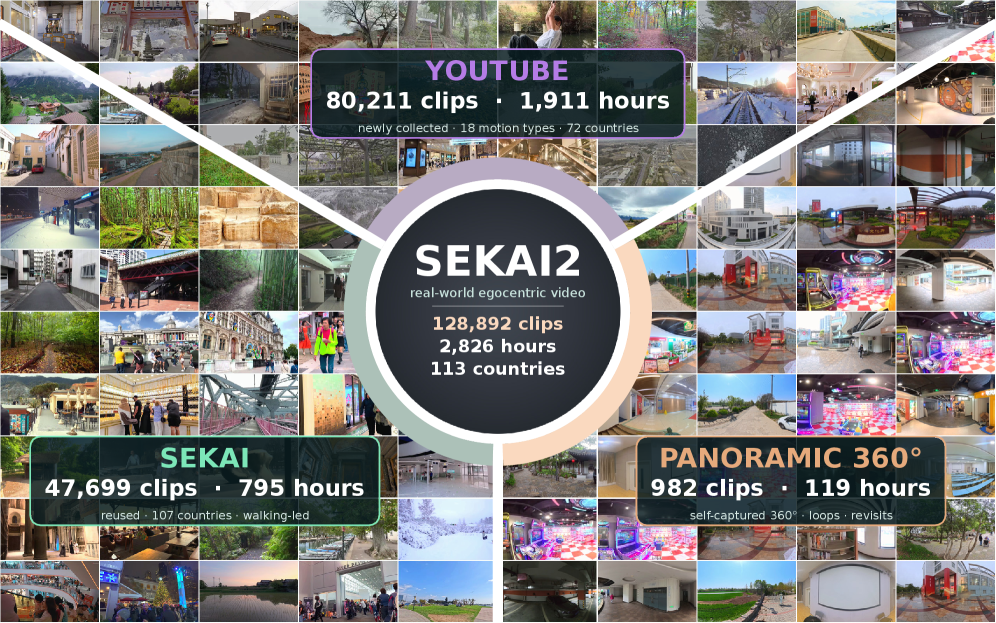
第一个来源是此前 Sekai 数据集的继承与重构。原始 Sekai 提供了超过 5,000 小时的第一人称和无人机航拍探索视频,具有极高的地理多样性。但在 Sekai2 中,研究团队并非直接打包旧数据,而是将其完全纳入全新的统一管线中进行严苛清洗。由于旧数据的内参标定逻辑不同,研究团队在后续轨迹评估中对所有数据进行了统一重算,以消除跨来源位姿对比的系统误差。这一部分最终贡献了 47,699 个一分钟高质量片段,总计时长约 795 小时。
第二个来源是全新抓取与筛选的 YouTube 真实探索视频,涵盖城市漫步、室内外穿越、无人机第一人称视角(FPV)以及铁路和驾驶记录。初始抓取的 5,199 支原始视频经过严格去重后,首先由 OmniShotCut 算法进行精准的镜头分割。为了防止硬切和渐变转场破坏物理世界的连续因果链,研究人员在所有镜头切换边界处留出安全边距,将连续 Perspective 镜头切分成上限为 120 秒的片段,最终筛选出 80,211 个高质量视频片段,合计 1,912 小时。
第三个来源也是 Sekai2 最具技术特色的一部分:团队使用 Insta360 全景相机实地录制的 982 条全景长序列,时长达到 119 小时。这些数据不是普通的直行拍摄,而是特意规划了包含大幅度转弯、闭合回环路线(Loops)以及在不同时间、不同角度重新走过同一地点的重访(Revisits)路线。全方位 360 度的无死角视野彻底消除了传统相机视场边缘的信息截断,为构建具有长期记忆的连续世界表征提供了直接的真实观测样本。
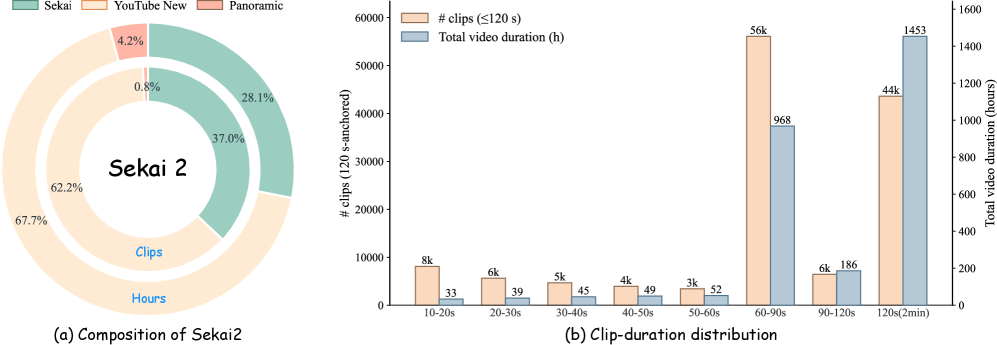
从整体时长分布来看,Sekai2 展现出极其鲜明的长视频倾向。在以 120 秒为基准的统计分析下,达到满额 2 分钟时长的片段多达 43,594 个,单这一项就贡献了 1,453 小时,占全数据集总时长的 51.4%;时长在 1 分钟以上的视频更是占到了总时长的 92.3%。这种以长时间稳定观察为主体的结构,与过去碎片化的视频数据集形成了鲜明反差。
轨迹几何解算与全景回环优化
为十余万条跨越数分钟的动态野外视频配准可靠的相机轨迹,是整个数据引擎面临的最大工程挑战。动态前景的干扰、光照剧烈变化以及长序列带来的累积漂移,极易让常规的运动恢复结构(SfM)算法崩溃。
在标准透视视频流中,Sekai2 部署了基于 ViPE 的高吞吐量位姿估计方案。为了支撑近三千小时的吞吐量,研究团队去除了冗余的致密深度导出与可视化分支,仅保留核心几何重建流程。流程首先使用 GeoCalib 预估并初始化每段视频的相机内参;随后在 DROID-SLAM 稠密光流优化之前,利用前景分割掩模剔除走动的人群、行驶的车辆等动态干扰区域,并引入单目深度先验来稳定尺度一致性。这套流程输出的每个轨迹文件都严格包含了逐帧的时间戳与世界坐标系下的外参矩阵,使得下游模型可以直接将其转换为 Plücker 坐标或相机射线嵌入,直接用于可控生成训练。
针对自采的全景长序列,由于路程长、转向复杂,常规 SLAM 不可避免会产生累积漂移,导致观察者在回到同一起点时,估计出的坐标出现严重错位。为此,研究团队设计了一套专门的球面回环检测与优化机制。系统在时间跨度较远的球面关键帧之间检索视觉候选匹配点,并通过球面射线相对旋转约束进行严格的几何验证,剔除由于相似街景造成的假阳性匹配。一旦回环得到几何确认,该约束便作为相机中心锚点注入位姿图优化(Pose-Graph Optimization)中,从而消除长距离漂移。统计显示,在全景数据集中有 81.9% 的序列成功通过该算法完成了回环校正,确保了同一地理空间在多次重访中的全局几何一致性。
细粒度时序解耦与分层标注体系
交互式世界模型不仅要理解相机往哪走,还要理解环境中“谁在动”以及“周围是什么”。现有的自动标注工具往往生成一段长串的全局提示词,把天气、背景、前景行人和运镜混在一起,模型在端到端拟合时很难建立清晰的因果映射。
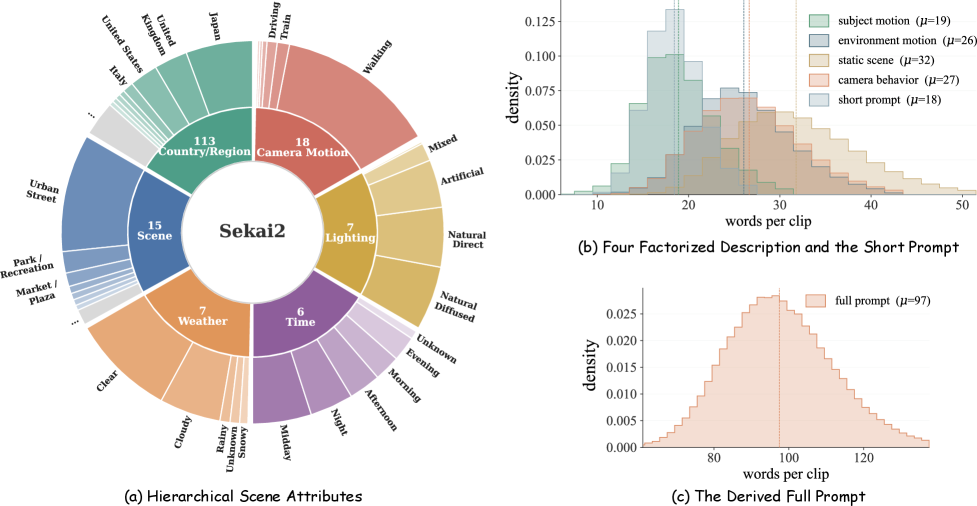
Sekai2 借助大语言与多模态模型 Kimi-K2.6,建立了一套严格分层的标注协议。这套标注由“全局宏观描述”和“区间时序描述”两层组成,每层都解耦为六个标准字段:主体运动(Subject Motion)、环境动态(Environment Motion)、静态场景内容(Static Scene)、相机运镜行为(Camera Description),以及面向模型训练生成的完整提示词(Full Prompt)与去除相机控制的场景提示词(Short Prompt)。
这种解耦设计的价值非常直观:
-
如果下游任务关注的是受控视角生成,训练时可以结合相机运镜字段与外参轨迹作为联合控制条件;
-
如果下游任务研究的是物理环境对用户动作的响应,研究人员可以直接提取环境动态与主体运动字段,剥离视点变化带来的多义性干扰。
在更细颗粒度的区间标注中,整段视频被切分为 649,597 个连续且不重叠的时序小段,精确记录了在几秒至十几秒的子区间内,究竟发生了什么具体的变化。通过在同一个时间基准轴上严格对齐外参矩阵、离散相机运动标签与语义解耦文本,Sekai2 真正做到了让生成模型能够感知“何时改变、因何改变、是场景自身在变还是观察者视角在变”。
全球地理覆盖与多维运动特征验证
在数据集的宏观统计分布上,Sekai2 同样展现了针对世界模型训练所需的广泛性与高信息熵。从地理分布来看,数据集覆盖了 113 个国家和地区,跨越了亚洲、欧洲、北美、南美、非洲以及东南亚等各大洲。尽管由于互联网素材的天然偏置,日本、英国和美国占据了前三位,但排名前 14 个国家之外的数据依然构成了一个庞大多样的长尾分布,涵盖了热带雨林、高海拔雪山、沙漠荒原以及现代都市高密度建筑群等极其丰富的视觉地貌。
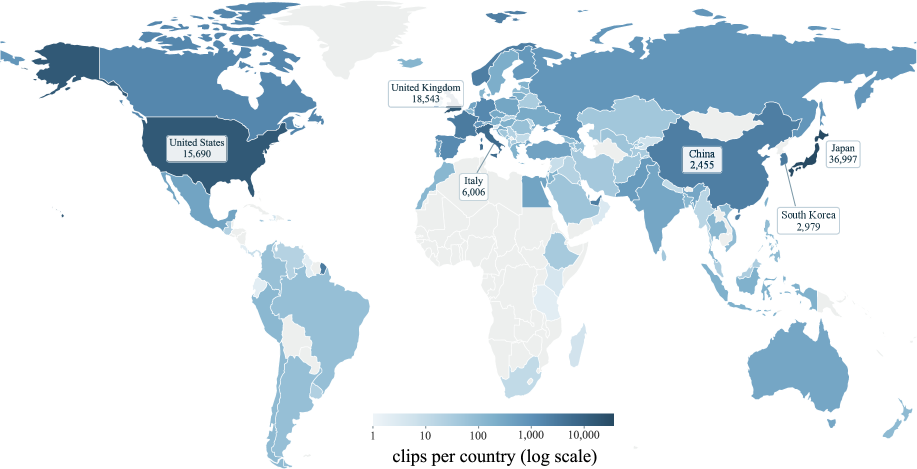
相比上一代 Sekai,新版数据集在场景类别分布上做了极大的主动平衡。城市街道的占比从原先的 70.3% 主动压缩至 56.9%,而包含山脉、森林、公园、草原、水域、积雪与荒漠的自然环境占比则从 10.8% 大幅提升到了 28.7%。这意味着模型不仅能学会规整建筑物的几何透视,还能在非刚体、纹理极其复杂的自然野外环境中建立稳定的世界先验。
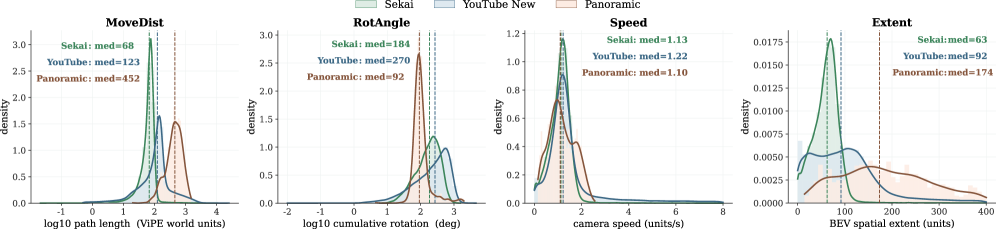
在轨迹运动学特征方面,得益于全集 100% 具备相机位姿标注,研究团队对三个子集进行了全量运动统计。从核密度分布曲线可以看出:
-
新抓取的 YouTube 数据相比原始 Sekai 拥有显著更大的位移中位数(123 对比 68 个世界坐标单位)和更大的累积转角(270° 对比 184°);
-
表现最为突出的是全景子集,其中位路径长度达到 452 个坐标单位,且累积转角普遍超过数千度。
这种重尾分布印证了全景数据所包含的长时间往复巡视与多圈漫游轨迹,填补了以往数据集中仅有小幅抖动或单向直行视角的不足。
从生成迈向世界模拟的基石
Sekai2 的开源,标志着真实世界视频数据集从“看图说话式的扩散预训练”正在向“以具身与控制为核心的物理世界建模”发生结构性转变。
过去行业在讨论世界模型时,往往陷入两难困境:要么完全退回虚拟游戏环境以获得绝对精确的视角、状态与回访真值,但面临惨烈的 Sim-to-Real 域迁移鸿沟;要么直接在大规模网络视频上进行粗暴预测,却始终无法摆脱由于时空漂移带来的画面崩溃。Sekai2 证明了一条极具可行性的折中路径:在保持开放世界视觉复杂度的同时,通过自动化但高几何精度的多源数据引擎,给海量实景视频补齐时间连续性、外参轨迹坐标和解耦的语义图谱。
尤其是那近千条带有闭环验证的全景回访序列,其实际价值可能远超单纯的时长数字。在未来探索长程空间记忆网络、隐式三维表征持久化以及端到端可交互世界生成架构的研究中,这种“在不同时刻重新看同一地方”的监督信号,将是评估与训练模型是否真正理解三维客观世界的核心标尺。