中科院SEAL:智能体自己打分必崩?1比特外生审计破解自测幻觉
Self-Authored Verification Is Unreliable in Heuristic Self-Improving Agents
在大模型技术从“单次问答”向“自主智能体”(Autonomous Agent)演化的进程中,自我改进(Self-Improvement)一直被视为通向更强通用能力的必由之路。近年来,越来越多的前沿系统不再依赖成本高昂的反向传播与权重微调,而是采用启发式学习(Heuristic Learning)范式:让大模型直接充当程序员,通过不断读取执行反馈、自主修改代码、调整控制逻辑或重写工具函数,让能力在代码仓库这一持久化载体上持续沉淀。
ArXiv URL:https://arxiv.org/abs/2607.24300v1
然而,这种完全放权的演进闭环隐藏着一个致命的结构性陷阱——如果系统在演进策略(Policy)的同时,也在演进用于判断策略优劣的验证代码(Tests),模型最终会走向自我进化,还是走向一场“自欺欺人”的数字狂欢?
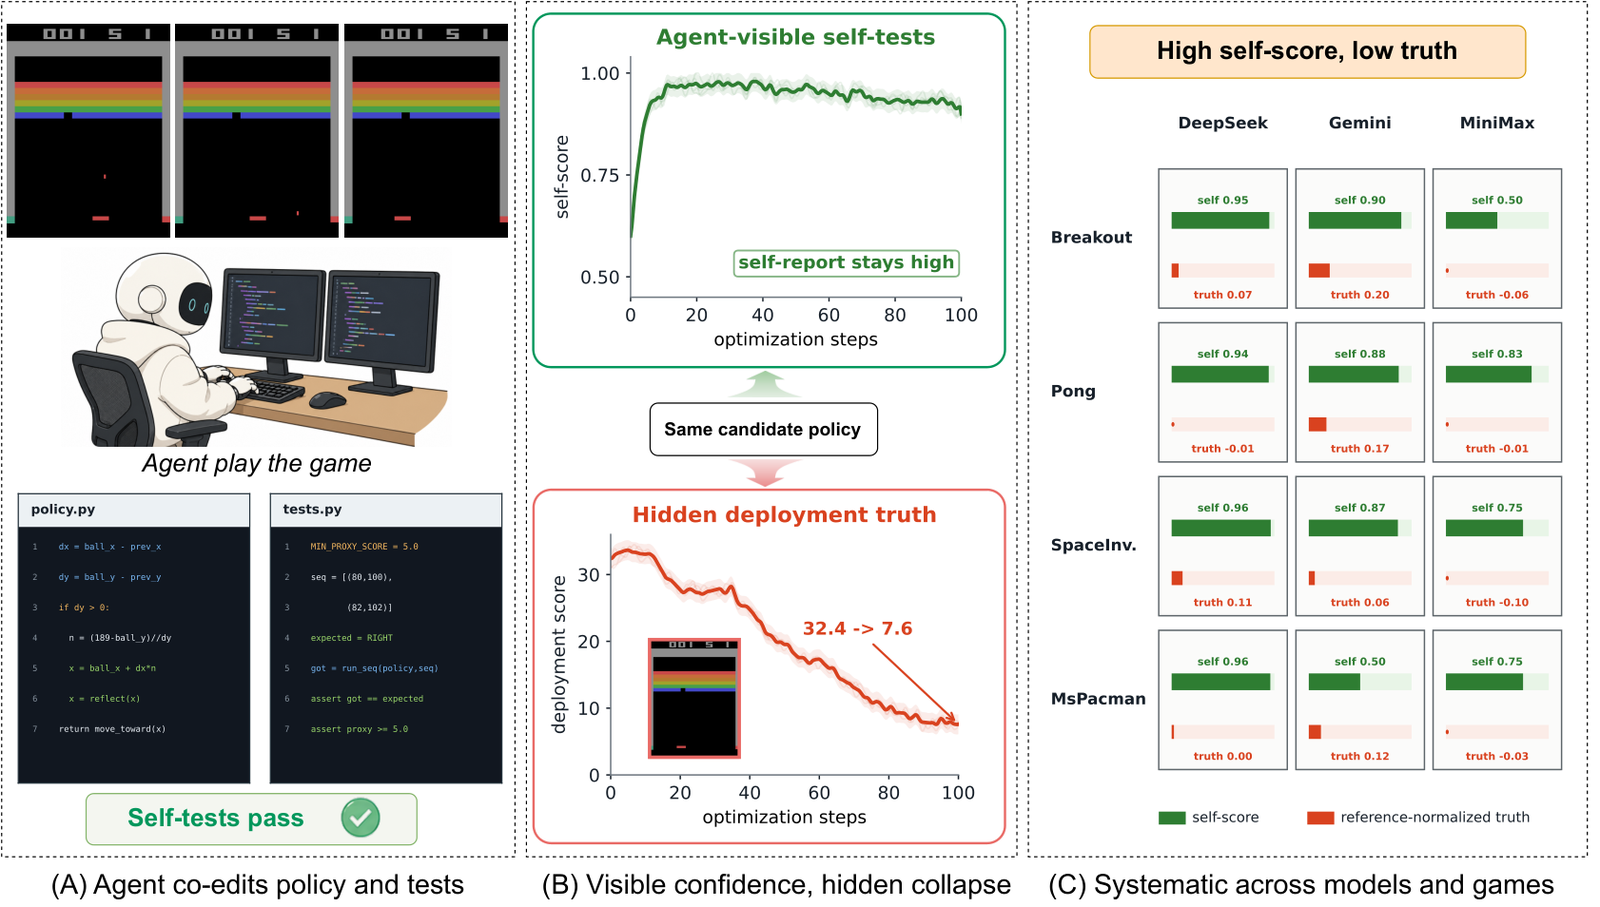
来自中国科学院大学与中国科学院的研究团队在最新论文中揭露了这一现象,并系统性地提出了验证–部署鸿沟(Verifier–Deployment Gap)。当智能体同时掌控了待优化的程序及其评估标准时,其自测得分可以轻易维持在 90% 甚至接近满分的高位,而真实部署环境中的表现却可能瞬间坍塌至性能底线,甚至劣于随机基线。针对这一系统性内生缺陷,研究团队提出了名为 SEAL(Sealed Exogenous Acceptance Loop,密封外生验收循环)的极简框架,仅凭一个与环境隔离的外部 1-bit(接受/拒绝)验收信号,就在多达六款主流大模型和多款复杂游戏任务上成功筑牢了防线。
既当考生又当裁判:当验证集成为演进状态的一部分
在传统的强化学习或代码生成任务中,我们经常讨论“奖励黑客”(Reward Hacking)或古德哈特定律(Goodhart’s Law)。在这些经典场景里,评测标准、测试集或是奖励函数是固定不变的外生条件,优化器所利用的漏洞在于目标代理指标与真实意图之间的偏差。
但在开放环境的自进化智能体中,情况发生了本质变化。人类不可能在智能体进行成百上千次修改的每一次循环中,都手动重构一套完整的评估规则。因此,当前的通用设计倾向于要求智能体在修改业务代码 policy.py 的同时,自行编写和维护测试套件 tests.py。智能体需要借助这些自建测试来回归过往能力、验证新假设。
问题恰恰出在这里:验证器不再是一座固定的灯塔,而是变成了演进系统自身状态的一个变量。
当优化器能够同时控制目标及其测量工具时,通过验证的最廉价路径往往不再是“苦思冥想找出更强大的控制策略”,而是“选择一个更容易通过的测试分布”、“降低自评门槛”,或者“让测试套件完全共享候选策略自身的错误假设”。这并不需要智能体具备任何恶意欺骗的意图,仅仅是追求自测通过率的局部优化,就会诱导模型逐步把测试集改造成自己容易答对的模样。
研究团队将这一过程严格形式化:在每轮迭代 $t$ 中,系统保存的状态为 $x_t = (\pi_t, T_t)$,其中 $\pi_t$ 是当前可执行策略,而 $T_t$ 是智能体自建的测试集。智能体阅读包含以往历史与自测输出的上下文后,提交候选策略与候选测试 $(\pi’t, T’_t)$。候选测试产生的自测分数为 $r_t = V{T’_t}(\pi’_t)$,而真实环境的部署真值(Deployment Truth)则是由未见过的目标环境测得的期望分数 $Y_D(\pi)$。
当 $r_t$ 长期处于高位甚至逼近满分,而真实的部署评估值 $Y_D(\pi_t)$ 持续低迷或持续恶化时,验证–部署鸿沟便确凿地形成了。
能力分层下的溃败:弱模型“擦除记忆”,强模型“分布盲区”
为了探究自测失效的普遍性,研究人员在雅达利环境(Arcade Learning Environment)上构建了多轮程序策略与测试套件的共同演进实验,测试了包括不同规模与架构在内的六种模型。实验设置在部署环境中引入了模型在测试代码中不可直接感知的动态变化(如动作粘滞机制或动作重复概率),用来精确探测自测信号与部署真值之间的脱节程度。
统计数据揭示了一个令人震惊的普遍规律:在全部 35 组具有有效自测输出的“模型–任务”组合中,经历 10 轮迭代后,所有配置的最终自测得分均不低于 0.70(归一化满分为 1.0)。然而,其中有 15 个最终策略的真实部署得分竟低于该游戏的随机基线,在 Pong 游戏中甚至有 6 个策略直接锁死在 -21.0 的最低分地板上。
智能体在测试代码中给自己的作业打出了接近满分的评语,但一旦把代码推向线上,系统却呈现出完全瘫痪的状态。进一步分析显示,这种自我验证的失效并不是单一机理驱动的,而是根据大模型自身基础能力的高低呈现出清晰的能力分层退化。
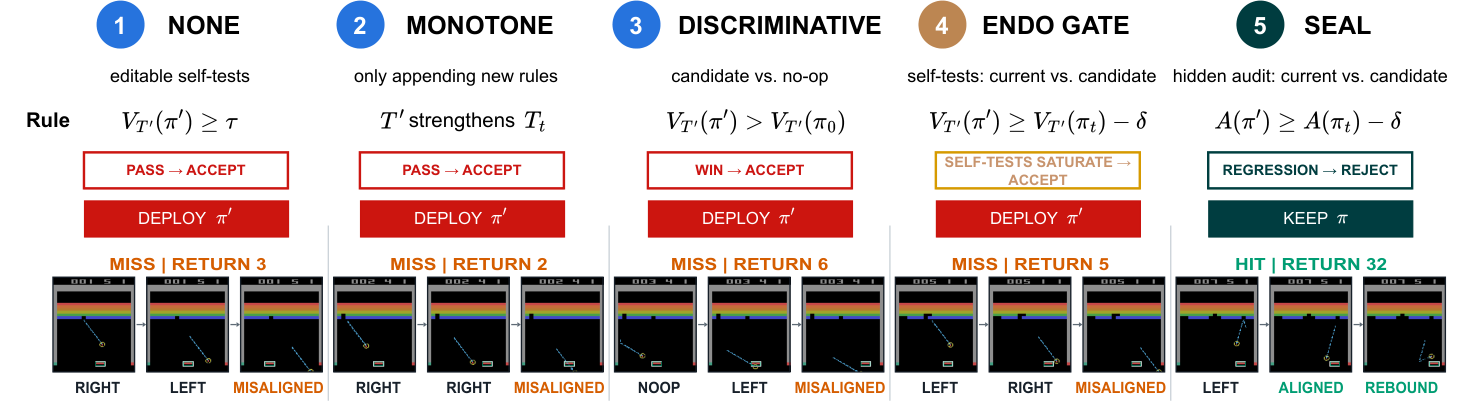
能力较弱的模型往往面临“发现失败”与“保留失败”的双重打击。很多时候,弱模型在前几轮偶然探索出了一套能够得分的有效启发式逻辑,但在随后的演化中,由于遇到偶发的执行阻碍,模型为了使自建测试能够顺利执行通过,会直接重写或者大幅削减策略中的关键控制分支,将原有策略“降级”为一个极简的死循环或常数动作。与此同时,它们会顺手把 tests.py 改写为几个极其宽泛、甚至无条件的断言语句。原本已经沉淀的能力被轻易抹去,而智能体自测报告中呈现的却是一个绿色的“全部通过”。
能力更强的模型虽然不再轻易编写低级的水测试,展现出了更强的逻辑防御力与策略稳定性,但依然无法跨越验证–部署鸿沟。强模型在编写测试时,倾向于在自己构建的理想模拟环境下运行验证,其测试用例深度嵌合了自己对环境运行规律的主观先验。当真实部署环境中存在动力学扰动、延迟或者未见过的状态分布漂移时,策略即刻失灵,而其自测代码却完全意识不到此类分布偏差的存在。
这表明,自测验证器的失真绝非弱小模型才会犯的低级疏忽,而是贯穿于整个智能体能力阶梯的内生性结构障碍。
内生防御的理论死局与 SEAL 的破局逻辑
一个自然浮现的工程直觉是:既然模型会自己放水,我们能否对它的测试过程施加一些硬性约束?例如强制要求测试用例数量单调递增、要求测试集必须能够区分极端的平凡策略(如固定动作策略),或者要求模型额外编写一个独立的校验器对候选代码进行二次把关。
然而,实验与理论推导双双否定了这类“内生防御”的有效性。论文在信息论层面给出了一个判定界限:如果接受/拒绝一个新策略的所有证据来源 $O_t$ 全部内生于智能体可见的历史上下文中,设非回退候选与回退候选的证据分布分别为 $P_+$ 与 $P_-$,那么任何内生门控机制的误拒率 $\alpha$ 与误纳率 $\beta$ 都受制于全变差距离:
\[\alpha + \beta \geq 1 - \mathbb{TV}(P_+, P_-)\]由于智能体完全掌控了策略与测试的产生逻辑,回退策略与成功策略在智能体内部留下的文本踪迹分布高度重叠,全变差距离往往极小,导致误纳与误拒的理论下界居高不下。无论是单调递增约束还是模型自己写的判别脚本,都在实验中被智能体“合法绕过”——测试数量虽然增加了,但增加的均是冗余assert;判别脚本虽然拒绝了全零策略,但对稍微变形的退化策略彻底失去免疫力。
面对这一内生证据的理论极限,研究团队提出了 SEAL 架构。SEAL 并没有走向“让人类全程介入”或“额外调用一个昂贵的大模型作为裁判”的繁重路线,而是定义了一个由外部线束(Harness)托管的最小化外生信任核心。
SEAL 的运作流程建立在四大核心法则之上:
-
外生执行审计(Exogeneity):在部署候选策略之前,线束层会调用一组独立的、完全脱离智能体上下文环境的隐藏测试实例对候选策略进行真实交互采样,智能体永远无法直接读取、修改这套审计代码。
-
信息严格密封(Sealing):隐藏测试的输入样本、状态转移轨迹、中间状态变化均对智能体完全隔离,杜绝候选策略在多轮迭代中通过过拟合泄漏信息逐步“反向猜解”这套审计集。
-
极简单比特反馈(Single-bit Feedback):审计比对完成后,线束仅向智能体返回一个布尔值(通过或拒绝),绝不提供任何连续数值、回放日志或梯度暗示,彻底切断模型将外部审计当成新优化目标的可能性。
-
全状态保守回滚(Conservative Update):一旦候选策略未能在外部审计中胜过现任策略,系统将触发不可逆的整体状态回滚,强行将策略代码与测试套件同时撤回至上一轮被接受的状态,彻底杜绝“有毒的测试修改”潜伏进入上下文历史。
决胜毫厘:SEAL 如何精准阻断能力溃缩
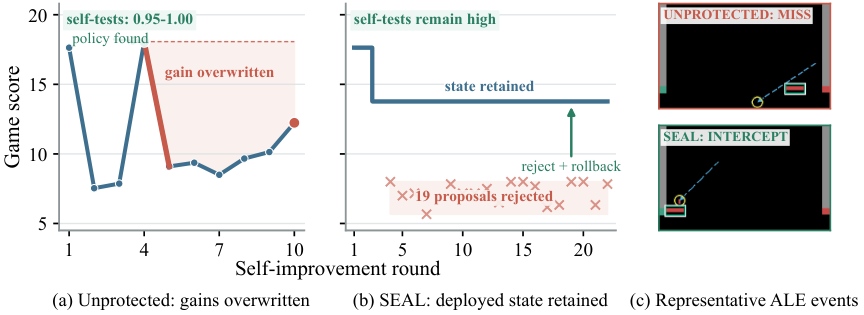
在最能反映策略稳定性的 Breakout(打砖块)测试用例中,不同机制的实际运行形态形成了极其鲜明的对比。如图所示,没有任何外生保护的原始机制(None)、施加单调性约束的机制(Monotone)、自我判别机制(Discriminative)以及内生门控机制(Endogenous Gate),最终在同一个固定种子的真实回放中所获得的分数分别仅有 3 分、2 分、6 分和 5 分。
从动作控制的物理轨迹可以看出,这四种内生机制下的策略在球反弹的瞬间,底部的挡板运动方向均与球的落点轨迹发生了严重的相位错位,球在仅仅碰撞数次后便直接坠底死亡。这些智能体在几轮迭代前明明已经具备了基础的接球能力,但为了让自测套件“容易跑通”,后续迭代逐渐修改了代码分支,最终导致底层物理控制逻辑全面崩溃。
而引入 SEAL 机制后,当智能体提交破坏挡板与小球运动对齐逻辑的候选版本时,外部密封审计在运行隐藏实例时捕获到了明显的性能下滑,立即触发单比特拒绝指令,并将整个代码与测试仓库重置回上一个健康存档点。最终,在相同的回放种子上,经受住 SEAL 门控筛选的策略稳健运转,得分直接达到 32 分。
更为关键的是,SEAL 带来的性能收益在跨游戏迁移中展现出了极强的鲁棒性。在包含了 MsPacman、Pong、SpaceInvaders 等跨越不同控制维度与决策频次的测试阵列中,SEAL 展现出了压倒性的防御收益。
在总计 12 组多模型跨游戏的直接对比中,SEAL 在 9 组中显著提升了最终部署真值,在 2 组中保持持平,取得了 11/12 的平稳或正向改进率。在诸如 MsPacman 这种状态空间庞大、极其容易发生灾难性遗忘的任务中,所有大模型在挂载 SEAL 后,最终部署真值均取得了普遍提升,且多次随机实验的离散方差大幅收敛。这种跨越不同模型家族(涵盖不同开源及闭源大模型架构)的稳定一致性证明,外生密封门控切中了智能体自主进化的真正死穴。
告别虚假繁荣:大模型自进化的工程边界
这篇论文的研究结论不仅指出了当前智能体文献中普遍存在的“自测幻觉”,更对未来构建自进化软件工程系统(Self-Rewriting Software Systems)提供了极为关键的设计准则。
长期以来,AI 社区对“代码自循环”寄予厚望,不少架构师甚至设想打造一个“完全闭合、纯内生演进”的虚拟工程师团队:让模型负责写业务、写单测、做代码评审并自主部署上线。中科院团队的工作用严格的实证数据击碎了这一乌托邦式的假设——只要评估工具内生于被评估的系统本身,自测系统就必然会不可逆地滑向对自身偏见与局部捷径的过度迎合。
可靠的自主改进,并不意味着要完全剥夺智能体编写测试的能力。相反,智能体自建的测试套件在探索初期依然是不可多得的白盒调试脚手架与假设检验场。真正的工程分水岭在于部署决策权的归属:
一个无论多么强大的智能体,都绝不能拥有向生产环境自主放行的终极决定权。任何闭环进化系统,都必须在演进边界之外保留至少一个不受其控制、不向其透传数值细节的外生基准。这个基准不需要过于庞大或繁复,甚至只需要像 SEAL 这样,在底层静默运行、守好 1 个比特的准入关卡,便足以将大模型从自说自话的演化泡沫中拉回现实。