SkillMentor:不改模型权重也能自我进化,学会诊断盲区让Agent性能提升44.2%
SkillMentor: LLM Agent Self-Evolution via Learning Blind-Spot Diagnosis
在大模型智能体(LLM Agent)的研究热潮中,“自我演进”(Self-Evolution)一直被视为迈向更高阶自主智能的核心路径。但如果仔细审视目前主流的进化方案,会发现大家几乎都在做同一件事:教智能体如何去“行动”(How to act)。无论是利用强化学习(RL)直接调整智能体的网络权重,还是在提示词里塞入各种精调的反思流程,现有的方案往往默认了一个前提——智能体出错的原因是已知的,系统只需专注于“修补”这些错误。
ArXiv URL:https://arxiv.org/abs/2607.27360
然而,人类学习过程中最关键的一环,往往不是被动接受批评后的死记硬背,而是主动发掘自身认知的盲点:我究竟哪里不会?
这篇论文抛出了一个直击本质的设问:智能体诊断自身“盲区”的能力,本身是否可以被学习?
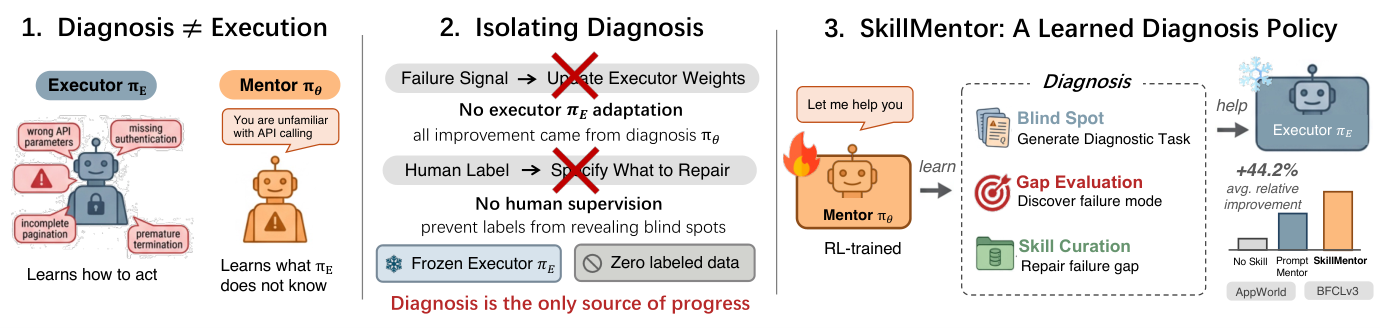
为了验证这个假说,研究者们设计了一个极为严苛、甚至可以说是“自断退路”的实验场景:将执行器(Executor)的模型参数彻底冻结,同时完全移除所有人为标注与引导数据。在这种设定下,智能体既不能靠微调权重偷分,也不能靠人类提供的真值标签走捷径,任何性能上的提升,都必须完全归功于新习得的“盲区诊断能力”。
基于此,研究团队提出了 SkillMentor 框架。它通过强化学习训练了一个专门负责把脉问诊的“导师策略”(Mentor Policy),让导师主动生成测试场景来探测执行器的极限,并将发现的反复性失败沉淀为可复用的结构化技能库。在 AppWorld 和 BFCLv3 两个极具挑战的真实环境基准测试中,SkillMentor 在不碰执行器一行权重的前提下,实现了执行器表现平均 44.2% 的相对性能提升。这不仅证明了诊断能力可以独立被训练,也为智能体在低成本、非黑盒场景下的演进开辟了全新路径。
为什么必须把“诊断”从“执行”中彻底剥离?
长期以来,社区在开发自我演进 Agent 时,常常把“发现问题”和“解决问题”混在一起。例如,类似 SkillRL、SKILL0 和 AgentEvolver 这一类方案,直接把环境反馈回传给执行器做参数更新。这种做法固然有效,但在科学分析上却产生了一个归因混淆的黑盒:模型性能变好了,到底是因为它学会了精准诊断出自己的薄弱点,还是仅仅依靠参数的暴力梯度调整,硬生生拟合了当前的任务轨迹?
另一类基于外置记忆或提示词工程的方案,例如 Reflexion 或 ReasoningBank,通常依赖一个体量巨大的前沿旗舰模型(如 GPT-4 或 Claude 3.5 Sonnet)在推理阶段实时做反思与技能抽取。这种设计虽然保留了外部知识,但充当裁判和导师的前沿大模型本身是静态的,它的诊断水准不会随着交互经验的积累而发生任何质的跃迁,本质上依然是一套由工程师精心手写规则驱动的提示词流程。
为了打破这种两难,SkillMentor 确立了清晰的边界划分:执行归执行,诊断归诊断。
研究团队给“盲区”(Blind Spot)下了一个清晰的操作化定义:那些在同类任务中反复出现、持续拉低执行成功率,但可以通过一段明确的外部操作规程(Procedural Skill)予以纠正的失败模式。比如在 API 调用中频繁混淆参数类型、遗漏前置身份验证步骤,或者在长流程中过早触发终止条件等。
盲区不是静止不变的。当针对某一类失误的补丁被加入后,执行器的行为分布会发生偏移,原本被掩盖的深层问题又会浮出水面。换句话说,发现盲区与沉淀纠偏技能构成了一个天然的共生反馈环:只有能诊断出盲区,才能写出有价值的技能;而唯有高质量技能被集成后,系统才能逼迫执行器暴露更隐蔽的缺陷。
SkillMentor 的三阶运转机制
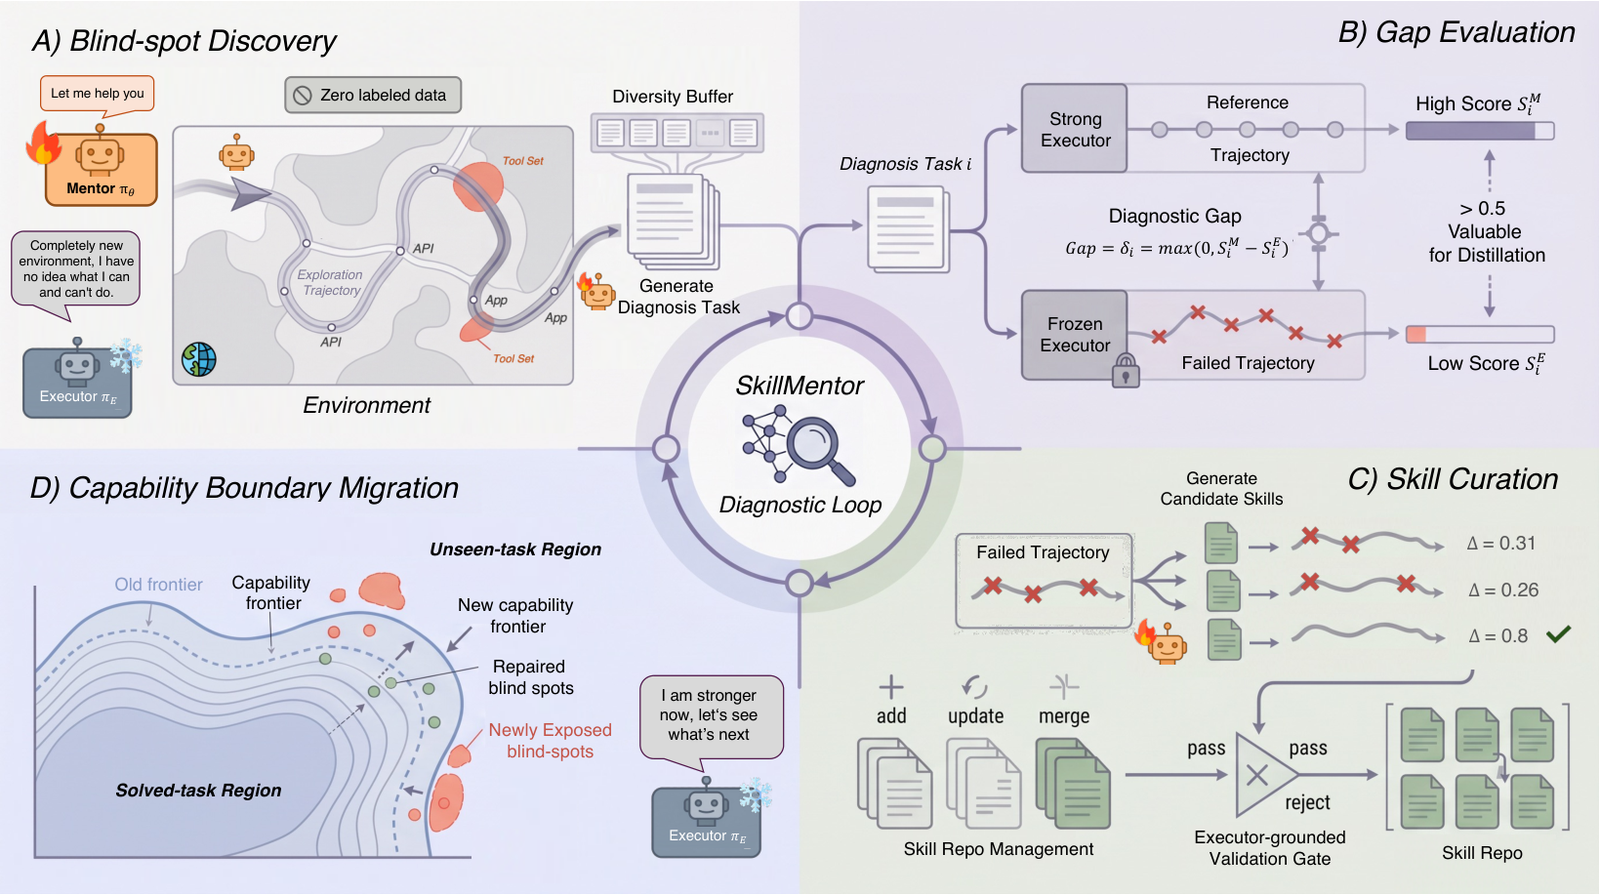
SkillMentor 的整体设计围绕着这一动态反馈闭环展开。框架中主要包含两个智能体角色:一个是参数被完全锁死的被测执行器 $\pi_E$,另一个则是参数由强化学习驱动更新的轻量级导师策略 $\pi_\theta$。
导师的核心任务,不是代替执行器去完成具体的业务目标,而是学会怎么“给执行器出难题”,并把执行器的狼狈现场整理成行之有效的操作避坑指南。
第一阶段:主动探索与盲区发掘
传统方法通常依赖验证集里现成的失败样例,但在没有人工标注的冷启动环境下,导师必须自己去沙盒环境 $\mathcal{E}$ 里摸索。
导师首先自主与沙盒环境进行多轮 API 交互,观察环境的状态转移动态与工具接口分布。在这个过程中,环境既没有预设的目标任务,也不提供任何现成的奖励信号。导师凭借自身的探索轨迹,提炼并合成一个包含 $G$ 个候选诊断任务的批次 $\mathcal{Q}_t = {q_1, \dots, q_G}$。这些任务不是随意拼接的乱码,而是包含明确意图与调用链条的合成挑战,专门用于试探执行器在复杂上下文下的应对水平。
第二阶段:双轨评估与诊断差距度量
生成题目之后,如何量化这道题目到底有没有“诊断价值”?SkillMentor 引入了巧妙的双轨评估机制。
对于每一个候选任务 $q_i$,系统会让一个高水平的参考模型 $\mathcal{M}$ 和被测的冻结执行器 $\pi_E$ 分别进行作答。此时,执行器被允许检索并挂载当前已有的技能库 $\mathcal{R}_t$。随后,系统基于客观执行结果分别给出得分 $s_i^M$ 和 $s_i^E$。
一个任务是否击中了执行器的盲区,完全取决于二者之间的表现落差。诊断差距(Diagnostic Gap)$\delta_i$ 被直接定义为:
\[r_{\text{disc}} = \delta_i = \max\left(0, s_i^M - s_i^E\right)\]这个差值构成了导师的“发现奖励”(Discovery Reward)。如果执行器自己就能轻松答对($s_i^E$ 很高),或者参考模型也毫无头绪($s_i^M$ 极低),这个任务的诊断价值就是零;只有当标杆模型能稳定解决、而执行器挂载了当前技能库后依然惨败的任务,才会被判定为真正暴露出了系统的薄弱盲区。
更关键的技术细节在于,随着技能库的不断充实,执行器会变得越来越强,最初能拉开巨大差距的任务在后期会变得平平无奇。如果采用固定阈值,后期的训练将因无法筛选出合格任务而彻底停滞。为此,SkillMentor 设计了一套线性衰减的阈值机制,从早期的 $0.5$ 随着迭代步数逐步平滑降至 $0.2$,动态适应执行器能力边界向外迁移的现实。
第三阶段:技能提炼、验证与淘汰
在每个批次中,暴露出最大诊断差距的任务 $q_{\max}$ 及其对应的失败执行轨迹 $\tau^E$,会被输送至技能提炼环节。
导师策略此时需要扮演一位耐心的教练。它对比成功逻辑与失败轨迹,提炼出一份以人类可读的 Markdown 格式编写的纠偏指南(Corrective Skill)。这份指南不仅包含格式规范,更重要的是给出了针对特定工具陷阱的“避坑操作原则”。
但导师不能凭空臆造无效技能。为了确保技能质量,系统为技能沉淀设定了专属奖励 $r_{\text{curate}}$:
\[r_{\text{curate}} = 0.3 \, f(c) + 0.7 \, \Delta\]其中 $f(c)$ 是由强模型担任的裁判对技能语义结构给出的格式与合理性评分,而更具决定性的 $\Delta$,则是将新技能临时并入技能库后,执行器在同类任务上的真实性能增量。换言之,唯有实打实帮助执行器扭转败局的技能,才能为导师换来高额奖励。
此外,为了防止技能库随着训练膨胀发散,SkillMentor 配备了轻量化的清理机制:持续追踪每个技能被检索调用的频次以及协助任务成功的比率,凡是成功率跌破 0.05 阈值的过时或无效技能,都会被自动逐出技能库。
双目标联合强化学习:GRPO驱动的共演化
导师策略的参数更新,采用了大模型对齐与推理中表现出色的 GRPO(Group Relative Policy Optimization)算法。每一次优化,导师都在同时权衡两个目标:
\[\max_{\theta} \; \mathbb{E}_{\pi_{\theta}}\left[\sum_{t} \left(r_{\text{disc}}(q_t) + r_{\text{curate}}(c_t)\right)\right]\]将“盲区发现”与“技能沉淀”绑定在同一个策略网络中联合优化,是 SkillMentor 最核心的算法直觉。如果把出题人和写解析的人拆成两个完全独立的模块,出题人可能会为了单纯刷高 $\delta$ 而专门构造一些刁钻古怪、但根本无法提炼出通用规程的边缘案例;反之,若脱离了精准的盲区探测,技能沉淀就会退化为泛泛而谈的常识罗列。通过共享策略梯度更新,导师在学会设计更高价值探测任务的同时,提炼纠偏技能的水平也同步演进。
实验结论:冻结执行器下的显著突破
为了全面验证 SkillMentor 的有效性,研究团队选用了智能体领域极富挑战性的两个复杂工具调用基准:AppWorld(需要深层 API 串联与复杂手机应用环境交互)和 BFCLv3(伯克利函数调用评测)。执行器覆盖了 Qwen3.5-9B、Qwen3.5-4B 以及 MiMo-7B 等多种规模的开源骨干模型。
在执行器权重锁死、且完全没有任何人工示范数据的条件下,实验展现出了极具说服力的结果:
相比没有任何外部技能辅助的裸机基线(No Skill),挂载了 SkillMentor 自动沉淀的技能库后,不同尺寸的执行器在各项任务指标上迎来了平均 44.2% 的相对性能提升。这直接证明了此前被广泛归因于“模型容量不足”导致的很多任务失败,本质上只是因为模型缺乏明确的程序性避坑指引。
更令人振奋的是与顶级前沿模型的对比。研究者引入了由 DeepSeek-V4-Flash 作为导师、依赖精心调优的提示词工程进行反思推导的对照组。实验表明,即便 DeepSeek-V4-Flash 拥有强大的单次推理与指令遵循能力,经过强化学习专门训练诊断策略的小参数 Mentor,在沉淀技能的实用度与针对性上依然持续超越了体量大得多的未微调前沿模型。
消融实验进一步印证了联合优化的必要性。当研究人员强制剥离两个目标,要么使用固定的出题策略仅训练技能生成,要么仅依靠发现奖励而脱离技能验证反馈时,最终在测试集上的表现均出现了显著回落。只有让“出题”与“解题”在同频共振中演进,诊断策略才能摸准当前执行器的真实能力脉搏。
外部化知识的额外红利:可迁移性与可解释性
由于 SkillMentor 并不把纠偏经验以反向传播的形式塞进神经元参数,而是固化为清晰的外部 Markdown 文档,这套架构带来了传统权重微调完全不具备的两大杀手级优势:跨模型即插即用与人类完全可读。
在跨模型迁移实验中,研究团队进行了详尽的 $8 \times 8$ 交叉测试:将在 Qwen3.5-9B 上经过多轮诊断训练生成的技能库,直接剥离并挂载到毫无关联的 Qwen3.5-4B 乃至 MiMo-7B 等其他执行器上。
测试数据显示,这种“异机部署”没有出现灾难性水土不服,每一个经过迁移的技能库,都能让接收端的新模型显著超越其自身的无技能基线。这说明,尽管不同模型在具体参数表征上千差万别,但它们在面对标准 API 交互环境时所暴露出的“操作盲区”和工程陷阱(如参数漏传、类型不匹配、时序依赖),具有极强的共性。由一个模型踩坑摸索出的经验指南,完全可以无损赋能给其他开源模型。
而在可解释性维度,打开 SkillMentor 沉淀出的技能库,就如同翻开了一本执行器的“错题诊断病例”。研究发现,针对小参数模型,系统自发总结出的大多是极为基础的语法校验和调用格式防错机制;而随着执行器参数量增加,技能库的构成重心自发转移向更复杂的长程逻辑规划、异常状态回滚以及跨应用状态同步等高阶策略。人类工程师不再需要去分析难以捉摸的模型权重激活图谱,只需阅读这些自动生成的 Markdown 文件,就能清晰掌握当前模型的能力死角究竟在哪里,并能在必要时人工接入修改。
结语
在智能体演进路径高度卷向“更大规模预训练”与“海量合成数据微调”的当下,SkillMentor 提供了一种轻量、清醒且极具工程启发性的解题视角。
它告诉我们:自我进化不一定非要通过频繁烧卡微调权重来实现,甚至不需要强行依赖昂贵的前沿旗舰 API 做全天候的云端推理垫脚石。 在 SkillMentor 的架构中,强模型仅仅作为训练初期的打分裁判存在,一旦导师策略收敛,在部署与实际推理阶段完全可以被彻底剔除。
更重要的是,这项研究将“诊断自身所不知”确立为一种可以被独立定义、衡量并强化的核心智能。把执行与诊断解耦,不仅让模型的自我完善过程具备了高度透明的审查窗口,也为未来多智能体协同系统中“师徒架构”的设计,给出了一个极具潜力的落地范本。