SIREN:港科大等提出端到端气象预警Agent,实战性能提升近30%
SIREN: Towards End-to-End Extreme-Weather Early Warning with Experience-Grounded LLM Agents
极端天气正在以更高的频率、强度和破坏力冲击全球基础设施与人类生命安全。面对台风、龙卷风、极端严寒或暴雨洪涝,现代防灾减灾的核心防线是早期预警系统(Early Warning Systems, EWS)。然而,气象学界和应急管理领域长久以来面临一个尴尬的断层:预报模型算出了风速和降水量,但如何评估具体哪个变电站会断电、哪条主干道会被淹、哪座城镇该在何时发布强制撤离令?
ArXiv URL:https://arxiv.org/abs/2607.24588v1
在真实世界的业务流中,这一连串环环相扣的工作高度依赖气象和应急专家的人工研判。专家不仅要看数值天气预报网格,还要查阅中尺度分析图件、调取地理信息,最重要的是翻阅历史类似案例积累经验。现有的大语言模型(LLM)驱动的气象 Agent 往往只停留在“单点科学工具”的层面上,例如辅助调用一个气象诊断算法或做简单的时空插值,完全脱离了从“灾害发生”到“响应决策”的端到端链条。
来自香港科技大学和世界可持续发展研究院(World Sustainable Development Institute)的研究团队在论文《SIREN: Towards End-to-End Extreme-Weather Early Warning with Experience-Grounded LLM Agents》中,首次将极端天气早期预警形式化为端到端的多智能体协同任务。该研究不仅构建了首个涵盖 12 类极端天气、跨越全预警流程的基准评测数据集 SIREN-Bench,更推出了基于经验落地(Experience-Grounded)的智能体框架 SIREN。实验表明,通过引入历史案例的检索、技能蒸馏与现场建模,SIREN 相比既有最强气象 Agent 基准在综合预警表现上取得了 26.2% 至 29.7% 的显著提升,填补了气象科研与防灾减灾业务落地之间的鸿沟。
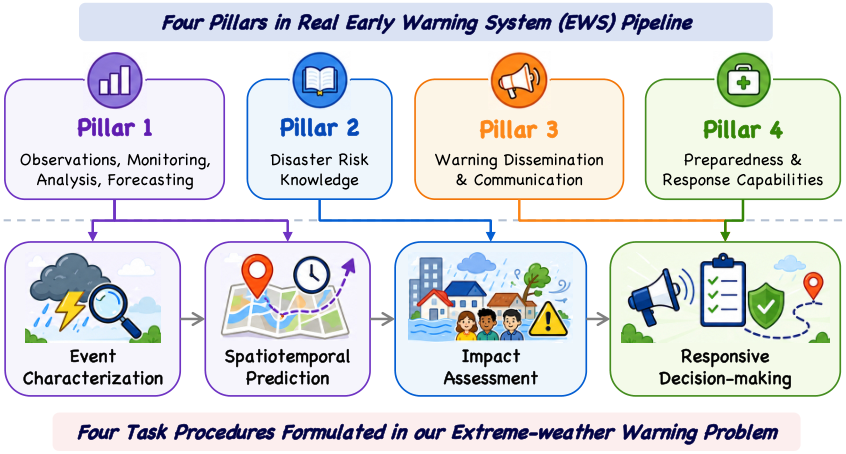
为什么现有气象 Agent 无法应对实战?
联合国(UN)与世界气象组织(WMO)倡导的早期预警系统,本质上不是一个孤立的天气预测软件,而是一条完整的“预警到行动”(Warning-to-Action)业务链。具体而言,它必须闭环串联起四大环节:事件特征解析(Event Characterization)、时空演变预测(Spatiotemporal Prediction)、潜在影响评估(Impact Assessment)以及响应与决策(Responsive Decision-Making)。
现有研究针对气象大模型做了诸多尝试,诸如 ZephyrusBench、ClimaBench 以及各类气候科学 Agent,但纵观它们的设计思路,绝大多数都将视野局限在早期阶段。例如让模型诊断高空急流形态,或者调用动力模型做未来数小时的降水反演。这些系统普遍缺失了至关重要的下半场:当 10 级大风来袭时,房屋受损概率是多少?农作物倒伏面积预估如何?应急避难场所设在何处?公用事业部门该对哪片电网做拉闸抢修预案?
如果测评基准本身不包含下半场,研发出的 Agent 就不可能具备实战决策能力。更深层次的瓶颈在于人类专家的决策机制。一名资深预警专家在面对复杂对流天气时,绝非仅凭物理学第一性原理从零推演,而是本能地在脑海中检索记忆:五年前类似气压场和湿热配置下,本地哪个低洼处首先内涝?当初下达撤离命令时延误了什么?这种“基于历史经验的推理”在现存的气象 Agent 架构中几乎是一片空白。缺乏可复用的历史经验,模型不仅容易在长链条推理中发生幻觉,还极易在跨模态异构数据的串联中引发灾难性的误差累积。
覆盖五大维度的评测基准:SIREN-Bench
为了彻底打破单点研究的局限,研究团队基于 2021 年美国全境的真实极端天气事件,构建了全新的基准数据集 SIREN-Bench。该基准包含 600 个精心设计的问答(QA)测试例,横跨 12 种主要灾害家族,包括强对流风暴、热带气旋、龙卷风、洪涝、冬季冰雪、大风、低能见度灾害、极端高温、山火、干旱、海洋灾害及寒潮,且样本在时间上均匀分布于全年 12 个月,充分保留了气候的季节性差异。
SIREN-Bench 将复杂的减灾流程细化拆解为 19 个原子子任务,严格对应业务流的五大模块:
-
事件特征解析(64 例):对正在发展的危险天气进行属性研判与物理机制分析,例如灾害类型分类、中尺度对流机理归因。
-
时空预测(160 例):对灾害未来的发生概率、落区坐标、强度演变、持续时间进行精确定量预测。
-
影响评估(192 例):将气象强度转化为社会经济层面的实际风险,包括伤亡人数估算、房屋财产损失预测、农业减产幅度以及电网停电时长分析。
-
响应决策(160 例):基于研判证据生成公众警报、规划防护减灾方案、选定灾后重建与临时庇护中心。
-
预警长链(24 例):这也是该基准最具挑战性的部分,要求智能体以端到端(End-to-End)的方式,将上述四大步骤串联为一个完整的级联决策管道,前一步的输出即为后一步的输入支撑。
在数据源建设上,团队整合了美国国家海洋和大气管理局(NOAA)的国家环境信息中心风暴事件数据库(SED)与风暴预测中心中尺度讨论文本(MDs)、联邦紧急事务管理局(FEMA)的灾害损失与响应行动数据库,以及开放能源数据倡议(OEDI)的全美电力中断监测流。
多源数据的整合极具工程挑战。例如同一个龙卷风事件,气象雷达记录的触地时间为下午 5 点 20 分,而应急管理部门收到的接警救援记录可能是下午 4 点 50 分,两者的空间地理标注也存在统计粒度差异。针对这一现象,团队设计了一套带有容差区间的“软对齐策略”(Soft Alignment Strategy),在给定的时空阈值(如相邻县域、合理的时间浮动窗口)内进行实体匹配,确保了跨部门业务数据的无缝缝合。随后,数据集经过了大模型初筛、分布均衡重采样与气象领域专家的人工二次复核,杜绝了任务条件中的标签泄露隐患。
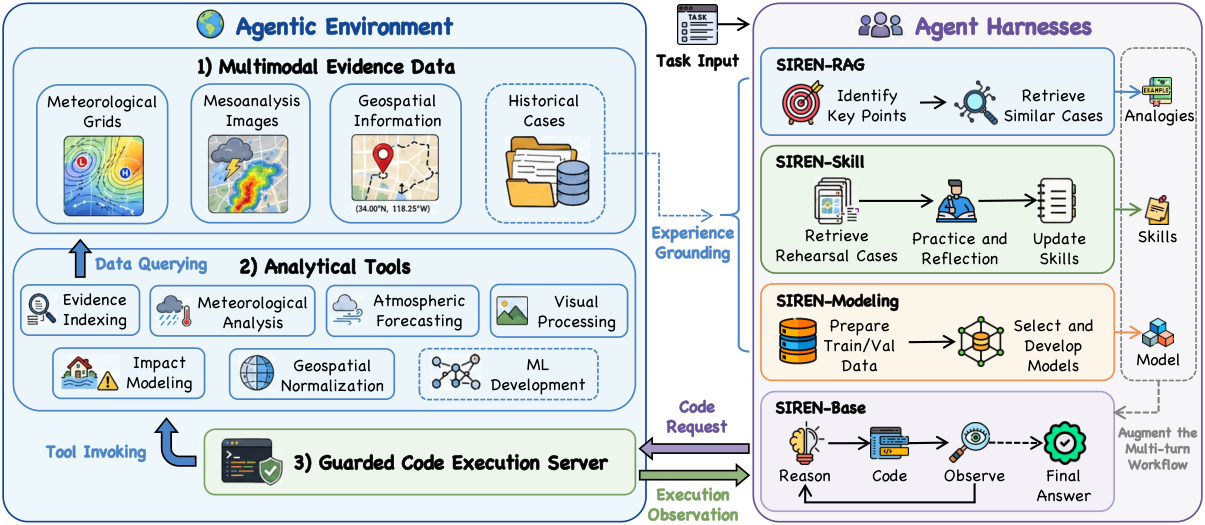
SIREN 框架:以可执行环境与经验底座为核心
针对 SIREN-Bench 暴露出的业务短板,研究团队提出了 SIREN 框架。该框架的底层逻辑在于:拒绝纯文本口嗨,拒绝缺乏事实依据的盲目推理。整个框架由两大部分构成:高度可交互的执行环境(Agentic Environment $\mathcal{E}$)和基于历史经验的智能体驾驭系统(Agent Harness)。
异构气象数据与受控沙盒环境
为了让智能体像气象专家一样工作,SIREN 的执行环境 $\mathcal{E}$ 整合了四类多模态证据源:
-
气象数值网格:来自 NOAA 高分辨率快速刷新系统(HRRR)的高精细分析与预报场,提供风场、气温、湿度、位势高度等连续变量。
-
中尺度分析图件:来自 NOAA SPC 历史归档的实况分析图,直观展示大气不稳定度、对流有效位能(CAPE)和垂直风切变等关键天气图符。
-
空间地理信息:结合美国人口普查局 TIGER/Line 县级行政边界与 OpenStreetMap 地理要素,将经纬度锚定至具体的交通网、居民区与关键基础设施。
-
历史案例知识库 $\mathcal{K}$:包含往年经过标准化预处理的真实天气事件问答链条,作为智能体可调用的“外脑经历”。
在工具层,SIREN 提供了涵盖证据索引、动力学诊断、专业预报模型调用、可视化图像处理(如自动切片局部风切变图)、脆弱性与影响建模、地理坐标统一以及机器学习训练接口等七大类 API。所有操作并不允许 LLM 直接向操作系统注入执行,而是必须经过一层带有权限拦截的受控代码执行服务器(Guarded Code Execution Server)。智能体生成 Python 脚本,沙盒在隔离空间内验算并过滤越权行为,最终仅向智能体反馈结构化的观测事实(Observations)。
三种不同维度的“经验注入”机制
如何将过往灾害处置的案例转化为当下任务的战斗力?SIREN 探索了三种互补的驾驭范式(Harness):
第一种是 SIREN-RAG(案例级类比检索)。这是最符合人类直觉的方式。当遇到突发气象事件 $q$ 时,智能体首先运行一个检索循环,从历史库 $\mathcal{K}$ 中比对当下天气特征,检索出若干高度相似的历史案例 $\mathcal{K}_{\mathrm{rag}}$。随后,智能体将这些真实案例作为 In-Context 参考范例注入后续的多轮推理与代码生成中。模型不再单凭参数记忆瞎猜,而是参考类似风力等级下的实测财产损失进行比例推算。
第二种是 SIREN-Skill(过程级技能蒸馏)。面对未曾谋面的复杂气象综合诊断,单纯检索出的答案往往无法直接套用。SIREN-Skill 采用“先演练再实操”的模式:智能体在正式解答目标问题前,先从案例库挑选几个具有代表性的历史测试题进行脱敏模拟演练(Rehearsal)。在隐藏标准答案的前提下,智能体跑一遍解题轨迹;演练结束后揭晓真实答案,由模型比对自身轨迹的瑕疵,提炼出抽象的、跨场景适用的程序化技能规则(Procedural Guidance $\mathcal{S}$)。带着这套在实操中蒸馏出的方法论,智能体再去攻坚当下的目标预警任务。
第三种是 SIREN-Modeling(数据级原地建模)。在定量预测或灾害影响预估任务中,自然语言的归纳推理能力往往不如紧凑的统计模型。SIREN-Modeling 允许智能体将历史库 $\mathcal{K}$ 视作一个原始数据集:智能体自主定义特征工程,从海量历史事件中提取自变量与因变量,划分训练集与验证集,调用环境中的 ML 接口当场训练一个小型专用预测器 $M$(如梯度提升树或浅层回归网络)。在后续的正式推理中,该模型作为一个由代码驱动的预测探针,随时向 Agent 返回定量数值作为辅助证据。
实验评测:单点突破与全链路跨越
为了全面验证 SIREN 的有效性,研究团队选取了当前极具代表性的开源与闭源前沿模型作为底座,包括 Qwen3.7-Plus、GPT-5.4 mini 和 Gemini 3.1 Flash-Lite,并对比了 Zephyrus、EWE、ClimAgent、ClimateAgent、HVR-Met 等五个专门针对气象或气候科学研发的 Agent 基线系统。
评测结果给出了数项极具分量的结论。首先,极端天气端到端全流程预警对现有 AI 模型而言依然十分困难。在基线系统中,大部分 Agent 在 SIREN-Bench 上的综合得分甚至无法突破 0.35;即便在引入最强配置后,最高综合得分也仅在 0.44 左右。其中,事件表征分析相对容易,而涉及未来状态推演的时空预测则是所有大模型的集体软肋。但在下半场的影响评估和应急决策任务中,历史经验展现出了非同寻常的支点价值。
从实验数据对比来看,引入历史经验的 SIREN 变体展现出了碾压式的优势。在 Qwen、GPT 和 Gemini 三种底座上,表现最好的 SIREN 变体相比既有最强基线,综合性能分别提升了 26.2%、28.6% 和 29.7%。
值得注意的是,即便是完全禁用历史案例库的 SIREN-Base,仅仅凭借包含多模态证据和专业工具链的可执行环境 $\mathcal{E}$,其综合得分就已达到了 0.31 左右,紧逼甚至小幅超越了部分在专用语料上精调过的气象 Agent 基线。这表明,一个能够严谨执行 Python 计算、调取气象网格、执行地理对齐的代码沙盒环境,本身就是专业智能体不可或缺的基石。
三种经验驾驭机制在不同场景中表现出了互补性。实验表明,SIREN-RAG 在 GPT 和 Gemini 底座上斩获了最优的综合平均表现,这主要得益于闭源强模型极强的情境类比与上下文信息提取能力;而在基于 Qwen 底座的测试中,SIREN-Modeling 展现出了惊人的单项爆发力,特别是在需要精确数字输出的时空预测与停电时长估计等任务中,现场训练 ML 统计模型所带来的定量确定性,远胜于语言模型直接输出数值的玄学推断。而在涉及长思维链、跨多步骤调度的灾害综合分析任务中,SIREN-Skill 经过预先演练所沉淀的操作规程,则表现出了最高的推理稳定性。
在更具业务代表性的“预警长链”(Warning Chain)综合任务测试中,传统基线 Agent 由于缺乏跨阶段状态保持机制与全局经验校验,往往在进入第三个阶段(影响评估)时就已经出现严重的上下文漂移或工具误用,错误层层级联放大。而具备历史经验锚定的 SIREN 则能够保持逻辑连贯,从风暴成因出发,步步为营推导至撤离物资部署,在全链条任务上将成功率提升到了全新高度。
从单点预测到全链减灾的智能演进
回顾气象与人工智能交叉领域近两年的演进脉络,学界和产业界的聚光灯大多打在盘古、风乌、GraphCast 等数据驱动的气象预报大模型上。但必须承认的是,即便天气数值预测的分辨率做到极致,它距离真正的人类社会防灾减灾仍有一大截关键的“最后一公里”。
SIREN 的研究价值不仅在于提出了一个表现更优的 Agent 框架,更在于它重新定义了气象大模型的实战范畴:
-
预警不只是气象动力学计算,更是基于多源异构证据的综合研判工程。
-
智能体面对高风险决策时,不能仅仅依赖静态的预训练参数,必须学会在历史的沉淀中“寻找先例”。
-
无论是 RAG 的快速经验迁移、Skill 的试错复盘反思,还是 Modeling 的现场定量建模,都证明了将历史经验与交互环境相融合是通往高可靠性业务级 Agent 的必由之路。
这项工作清晰地表明,未来的气象减灾系统必将是“基础物理模型 + 跨模态工具沙盒 + 经验感知型智能体”的混合形态。在面对扑朔迷离的极端天气时,大模型唯有扎根历史事实、手握执行工具、贯通决策长链,才能从单纯的图表解读者,蜕变成为守护公共安全的前线参谋。