字节与北大推出SkillLens:视觉技能卡注入程序记忆,操作成功率提升11.6分
SkillLens: Visual Skill Cards for Retrieval-Augmented GUI Action Prediction and On-Policy Distillation
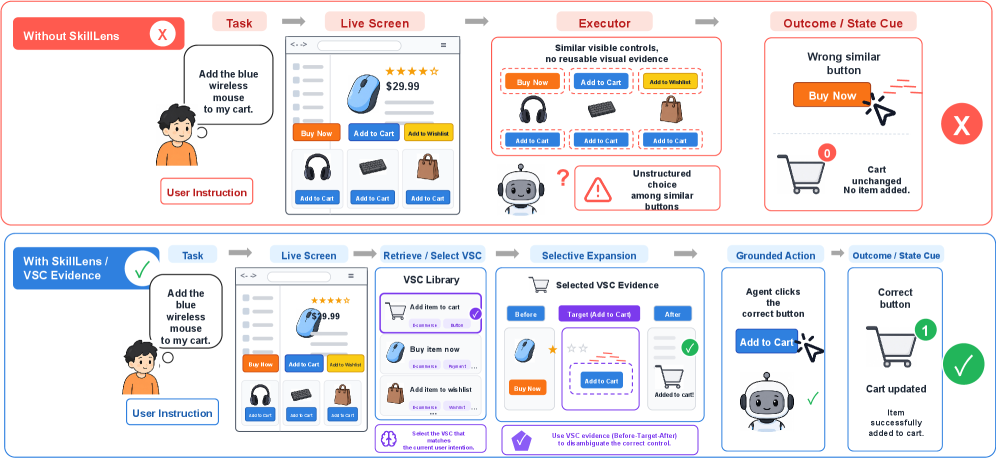
现阶段基于视觉语言模型(VLM)构建的计算机操作智能体(Computer-Using Agents, CUAs),在界面感知能力上已经取得了长足进步。无论是解析密集复杂的网页排版、提取文本信息,还是检测屏幕上的可交互控件,主流前沿模型都能给出差强人意的表现。然而,真实的图形用户界面(GUI)交互往往不仅依赖“看到什么”,更取决于“正在走哪套流程”。一个普遍的尴尬现实是:智能体虽然能识别出当前屏幕上的搜索框、下拉菜单或确认按钮,却极易在外观高度相似的控件之间迷失,不知道下一个核心步骤该操作哪一个,也缺乏校验当前操作是否生效的直观依据。
ArXiv URL:https://arxiv.org/abs/2608.10775v1
这种缺陷的根源在于视觉程序记忆(Visual Procedural Memory)的匮乏。纯文本形式的操作手册往往丢失了让动作得以成立的界面视觉状态;而未经加工的多模态历史交互轨迹虽然保留了全量上下文,却篇幅冗长、信噪比极低,难以在紧凑的 Token 预算下被执行器高效复用。针对这一瓶颈,来自字节跳动、北京大学和上海交通大学的研究团队提出了全新的解决方案 SkillLens。该方案将非结构化的人机交互经验重构成一种名为视觉技能卡(Visual Skill Cards, VSC)的状态条件记忆单元,并在推理时采用“低开销检索与按需视觉展开解耦”的机制,为冻结的执行模型提供精确引导。实验表明,SkillLens 让未经微调的 GPT-5.4-mini 在复杂网页基准 Multimodal-Mind2Web 上的步级成功率大幅提升了 11.6 分;同时,配套的在策略蒸馏算法 CardDistill 进一步将这种技能卡特权知识直接内化到了轻量端侧模型中,使脱离检索库独立运行的 Qwen3-VL-2B 性能提升了 12.0 分。
从原始轨迹到视觉技能卡:标准化程序记忆表征
要让跨平台、异构的 GUI 交互经验真正变得可检索、可复用,核心挑战在于构建统一的记忆抽象格式。以往的研究要么尝试把整条录屏或多帧长轨迹直接塞进上下文,导致执行模型注意力涣散;要么将操作抽象成纯文本规则,丢失了关键的局部视觉锚点与前后状态对比。
SkillLens 提出了 Visual Skill Cards (VSCs) 这一标准化记忆单元。形式化地,一张技能卡被定义为一个四元组:
\[s_{i} = (p_{i}, z_{i}, v_{i}, \kappa_{i})\]其中,$p_i$ 表示操作规程(Procedure),用结构化文本说明当前步骤的子目标与意图;$z_i$ 为适用条件(Applicability Cues),记录触发该技能卡所需满足的界面状态条件与上下文描述;$v_i$ 代表关键视觉证据(Visual Evidence),通常由高分辨率的局部控件裁切图、状态变化对比框或参考引导线构成;$\kappa_i$ 则是验证信号(Verification Signals),定义了该动作执行成功后界面应呈现的可观测后验状态。
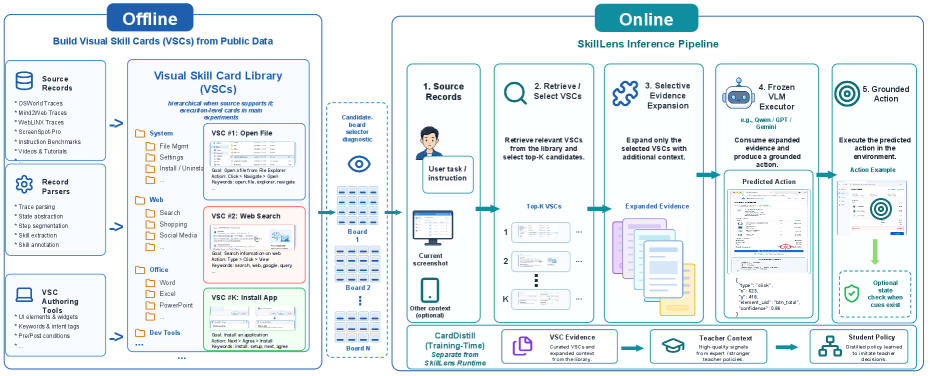
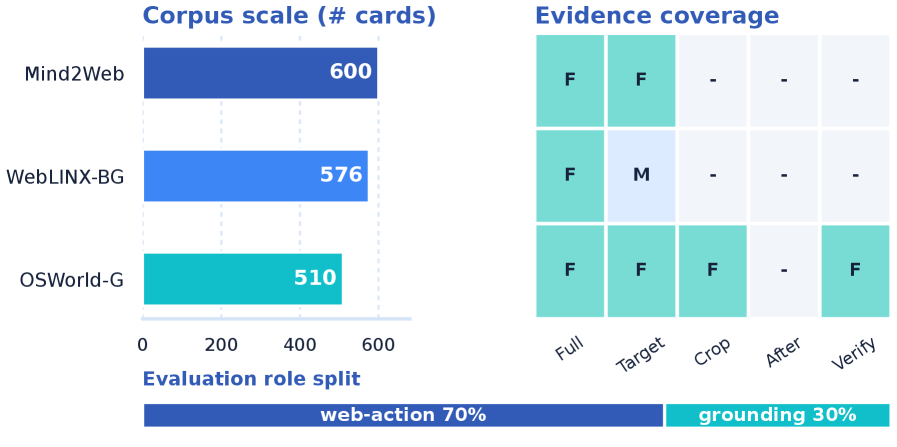
为了将海量公共演示、多模态基准和人工录屏沉淀为技能卡库,研究团队设计了 Trace-to-VSC 转换流程。该流程包含规范化切分、子目标提炼、视觉证据绑定与自包含性审计四个阶段。对于长序列交互任务,系统会提取包含“元卡片(Meta Card,对应宏观任务模式)”、“核心卡片(Core Card,对应可复用子目标)”与“执行卡片(Execution Card,对应单步接地操作)”的分层卡片;而在离线动作预测基准中,则直接对齐到执行级卡片。值得注意的是,审计模块严格禁止在卡片中泄露绝对坐标模板,强制保留模型基于当前屏幕独立做空间定位的能力,确保外部记忆提供的是“操作参照”而非僵硬的机械回放。
推理时架构:低开销初筛与高分辨率证据的按需展开
在实时交互场景下,把成百上千张包含高分辨率截图的技能卡直接输入 VLM 执行器既不现实也不经济。如何在极其严苛的上下文开销下,既不遗漏关键线索,又不引入视觉干扰?
SkillLens 的核心机制在于将轻量级检索与高分辨率视觉展开彻底解耦。整个推理流程分为三步推进:
第一步是状态感知初筛。系统基于当前任务指令 $x$、最近交互历史 $h_t$ 以及当前界面提取出的上下文表征 $c_t$ 构建检索查询 $q_t = Q(x, h_t, c_t)$。检索层首先通过轻量级文本索引与倒排表计算词元级重合度,从庞大的全量技能库 $\mathcal{L}$ 中快速筛选出规模为 $K_c$ 的紧凑候选集 $\mathcal{C}_t$。由于这一阶段只处理卡片的文本元数据和适用条件描述,毫秒级即可完成。
第二步是精细过滤与按需展开。在紧凑候选集内部,系统结合界面布局特征执行重打分,最终仅锁定极少量的胜出卡片集合 $S_t$(实际评估中通常只取 1 至 2 张最相关的卡片)。此时,SkillLens 才会触发视觉扩展函数 $e(S_t)$,仅仅调取被选中卡片内部绑定的高分辨率视觉证据 $E_t$,例如目标控件的局部高亮切片或典型的点击前状态图。
第三步是当前屏幕下的动作接地与验证。被选中的技能卡摘要与展开后的视觉证据会被装配进提示词中,与用户当前所面对的实时截图 $o_t$ 协同输入给冻结的底层 VLM 执行器。执行器输出预测动作:
\[a_t = \pi_{\theta_0}(\xi_t, S_t, E_t)\]在这里,视觉技能卡仅充当“参考佐证”,当前的实时截图始终享有最高的接地优先级。这种设计确保了即便参考卡片来自不同分辨率、不同配色主题的相近软件版本,执行器也能借由卡片中的语义与局部视觉特征找到当前界面中对应的真实元素,避免发生错位点击。同时,卡片自带的验证条件 $\kappa_i$ 为后续多步交互提供了自我纠错的校验基准。
CardDistill:让小模型摆脱实时检索的在策略蒸馏
外部挂载检索库虽然灵活且即插即用,但在部分高频、低延迟的边缘端 GUI 场景下,维护外部索引和实时展开证据依然带来了一定的工程负担。能否将 VSC 所承载的视觉程序能力直接“内化”到小模型自身的权重中?
常规的监督微调(SFT)往往受到参考轨迹分布偏差的困扰,难以应对智能体在实际自主探索时产生的级联误差。为此,团队提出了面向多模态程序记忆的在策略蒸馏算法 CardDistill。其核心理念是将视觉技能卡作为训练期的特权上下文(Privileged Context)。
在训练阶段,教师模型 $\pi_\phi$ 与学生模型 $\pi_\theta$ 共享相同的底座架构,但接收不对称的信息:
-
学生模型仅输入基准环境原生的上下文 $\xi_t = (x, o_t, h_t)$,模拟真实的无检索推理环境;
-
教师模型则额外接收与当前真实步骤精准对齐的特权技能卡证据包 $(S_t^{\mathrm{priv}}, E_t^{\mathrm{priv}})$,其上下文为 $\tilde{\xi}_t = (\xi_t, S_t^{\mathrm{priv}}, E_t^{\mathrm{priv}})$。
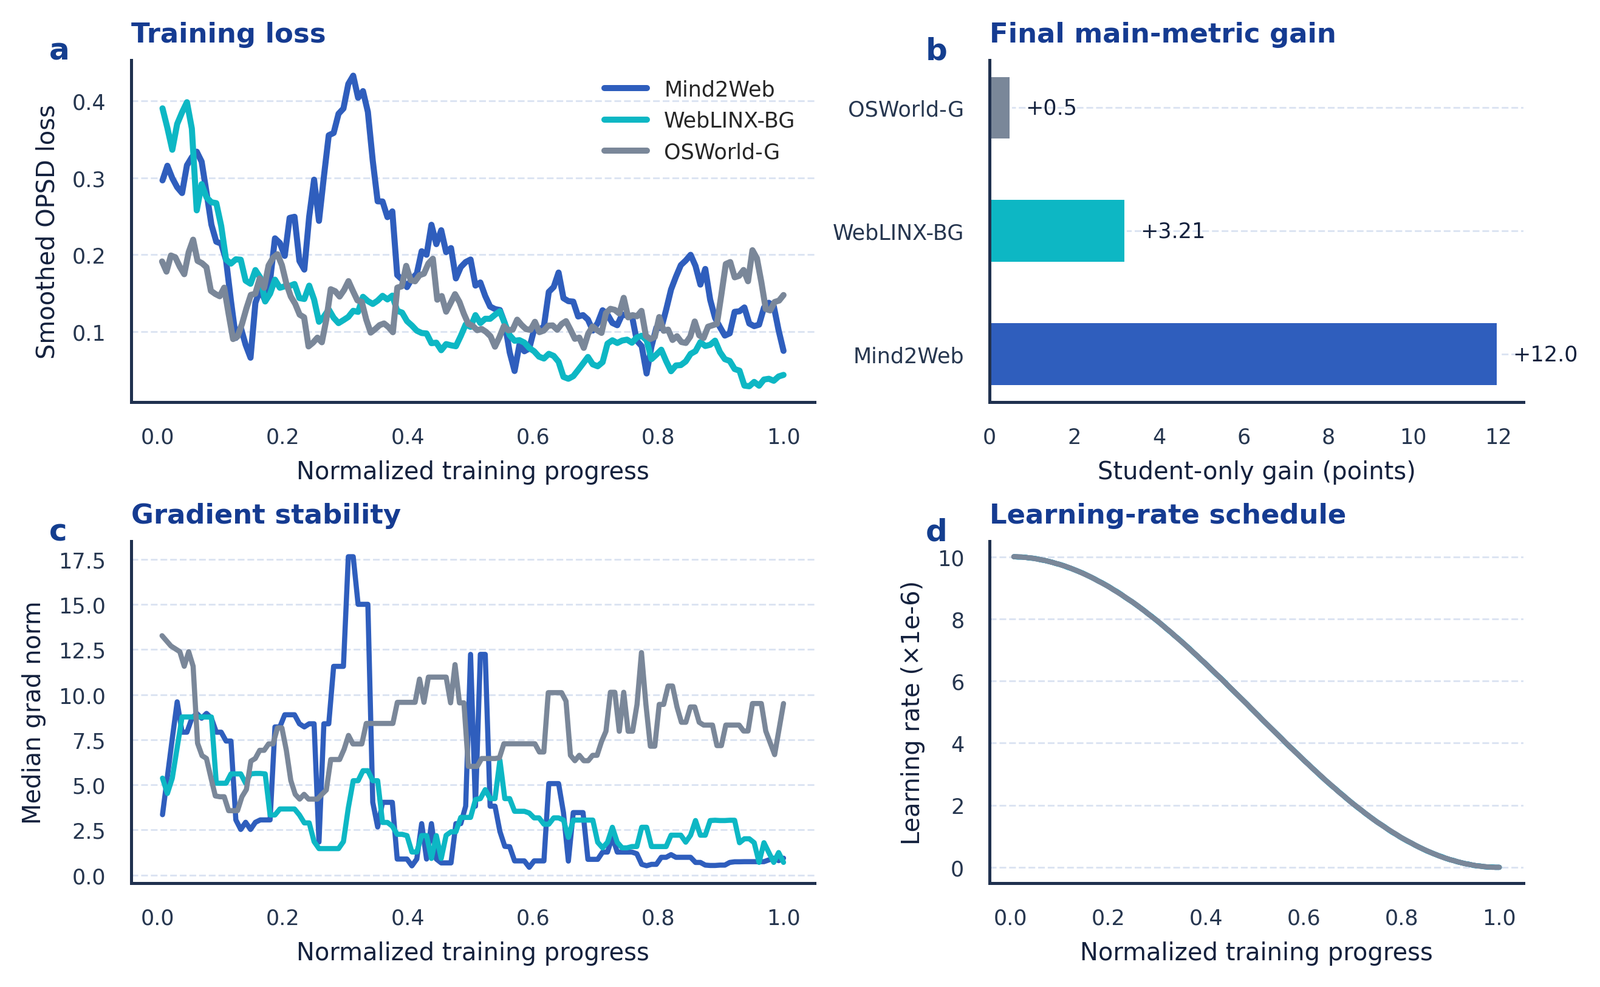
在策略(On-Policy)学习的关键在于,训练数据所依赖的动作前缀完全由当前处于演化中的学生模型自主采样生成 $\hat{y}t \sim \pi\theta(\cdot \mid \xi_t)$。教师模型在特权证据的辅助下,对学生自主生成的 Token 前缀进行逐位评估与分布校准。CardDistill 优化的目标函数为教师置信度加权的反向 KL 散度:
\[\mathcal{L}_{\mathrm{CD}} = \sum_{t}\sum_{j} w_{t,j} \, \mathrm{KL}\!\left(P^{(T)}_{\theta,t,j} \;\middle\|\; P^{(T)}_{\phi,t,j}\right)\]其中置信度权重 $w_{t,j} = 1 - \frac{H(P^{(1)}_{\phi,t,j})}{\log\vert{}\mathcal{V}\vert{}}$ 会动态抑制教师模型自身熵较高、判断摇摆的无效样本,聚焦于高确定性动作的无损传授。当模型部署上线时,特权证据包与教师网络被完全剥离,参数量仅 2B 的轻量级学生模型凭借自身权重即可直接输出媲美甚至超越检索增强模式的高质量操作。
实验评测:全线突破与深度归因消融
研究团队在三个具有代表性且侧重维度截然不同的 GUI 交互与定位基准上对系统进行了全面评测:涵盖多模态离线网页任务决策的 Multimodal-Mind2Web、注重长程对话式浏览器操作的 WebLINX-BrowserGym (WebLINX-BG),以及主打复杂桌面系统精确定位接地的 OSWorld-G。
冻结执行器的外挂表现与跨模型泛化
在不微调任何模型参数的前提下,SkillLens 展示出了强劲的增强效果。以最新一代旗舰模型 GPT-5.4-mini 为例:
在 Mind2Web 网页任务中,其步级成功率(Step SR)从基线的 77.2 直接提升至 88.8,带来了高达 +11.6 个百分点的绝对增益;在更具交互挑战的 WebLINX-BG 上,综合得分(Overall)从 12.8 提升至 15.7(+2.9);在涉及复杂操作系统桌面控件定位的 OSWorld-G 上,定位准确率(Grounding Acc.)更是从 45.0 飙升到 66.5,涨幅达到 +21.5 个百分点。
这种性能收益并非单一闭源模型所独有。在 GPT-4o、Gemini 系列以及开源端侧模型 Qwen3-VL-2B 上,挂载 SkillLens 均呈现出一致的正向跃升。例如 Qwen3-VL-2B 在 OSWorld-G 上的定位准确率直接由 28.5 提高到了 41.0。无论模型的原始规模如何,结构化的视觉参考卡片都能有效充当其空间决策的“外部提示器”。
负控制实验:是视觉线索奏效,还是 Prompt 变长的假象?
针对检索增强类工作,学界常常提出一个尖锐的质询:性能的提升究竟源于检索到了精准的特定知识,还是仅仅因为增加了输入长度或塞入了额外的图像 Token?
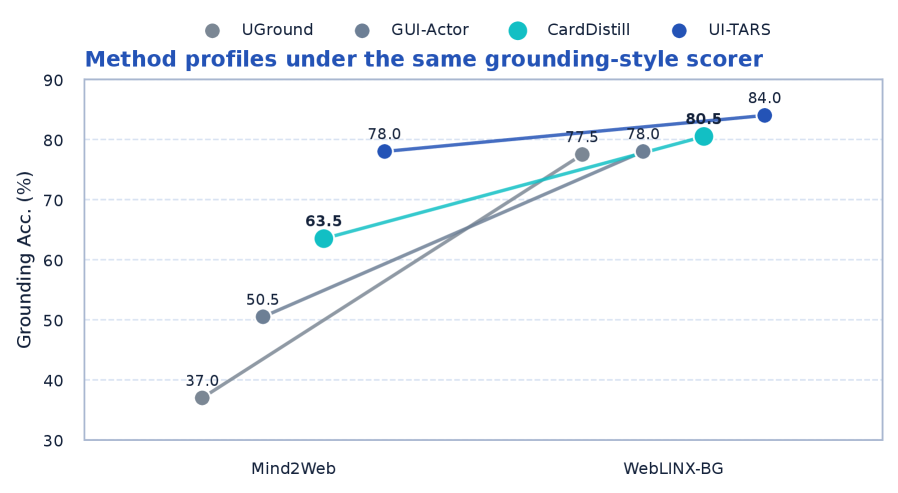
为了彻底排查这一变量,作者团队设计了极具说服力的负控制(Negative Control)实验。在保持模型、提示词骨架和图像输入预算完全相同的前提下,对比了三种条件:精准检索到的 VSC、从库中完全均匀随机抽取的 VSC、以及通过检索挑选但语义明确无关的低重合 VSC。
结果显示,在 Mind2Web 的子集评测中,挂载真实检索 VSC 的准确率为 92.0;而一旦换成随机卡片或无关卡片,准确率直接暴跌至 72.0 与 71.0。在 OSWorld-G 桌面基准上,这种差距更为悬殊:正常检索卡片得分 66.5,而随机与无关卡片的得分仅为 10.5 和 12.5,甚至大幅落后于不加任何技能卡的原生基线。这一强对比有力证实:GUI 执行器对视觉上下文高度敏感,输入不相干的界面切片会直接干扰模型的空间注意力;SkillLens 的飞跃完全建立在检索阶段对工作流和视觉锚点的精确定位之上。
纯学生模型的内化飞跃
在 CardDistill 的评估中,被蒸馏的 Qwen3-VL-2B 学生模型在测试期全程不挂载外部卡片库,完全依靠内化后的网络参数执行预测。
监控曲线显示,经过反向 KL 蒸馏优化的学生模型在训练步长推进下展现出平稳的收敛态势。在无任何运行时检索辅助的情况下,最终评估显示:纯学生模型在 Mind2Web 上的 Step SR 实现了 +12.0 的显著跨越,在 WebLINX-BG 上也稳步取得了 +3.2 的综合提升。为了进一步对照,研究人员对比了不加特权卡片证据的普通在策略蒸馏(Plain OPD)以及故意错位打乱卡片对应关系的 Shuffled-VSC 实验。结果表明,后两者在相同的计算开销下几乎未能带来统计学意义上的显著增益;唯有正确对齐的程序级特权上下文,才能真正驱动小模型习得跨界面的操作直觉。
重新思考 GUI Agent 的记忆范式
SkillLens 与 CardDistill 的提出,为当前方兴未艾的计算机操作智能体研究提供了一个极具启发性的工程范式。
长期以来,社区在“长上下文暴力堆叠”与“端到端全量微调”两条技术路线上摇摆不定。前者在面临海量界面交互时推理成本急剧攀升,极易导致显存爆炸与关键信息淹没;后者虽然推理轻便,却将经验固化为黑盒权重,难以灵活进行知识审计、即时修正与跨应用迁移。
这项工作证明,将程序知识分解为解耦的视觉技能卡是一条高度可行的折中路径。在宏观层面上,它将非结构化的交互数据沉淀为清晰可解释的多模态资产,允许开发者独立诊断检索错误与执行偏差;在微观层面上,它既能在推理端以极小的 Token 开销即插即用地赋能顶尖大模型,又能在训练端充当高密度的特权导师,把昂贵的认知经验提炼至端侧边缘模型之中。随着未来更多复杂办公软件、工业设计软件被纳入自主 Agent 的操作范畴,这种以状态感知为核心的程序记忆体系,势必成为构建高可靠数字员工不可或缺的技术拼图。