SteerBench-Work:大模型不是太冒进,而是过度拦截率高达28.1%
SteerBench-Work: A Benchmark for Agent Steering at Action Boundaries
在大模型智能体(Agent)的落地实践中,开发者最担心的往往是“AI 闯祸”:给客户错发邮件、在生产环境误删数据库,或是执行未经授权的大额转账。为了防范这些灾难性后果,几乎所有头部团队都在工具调用的最后一环设置了安全防线。然而,来自 AgentDock 的最新研究 SteerBench-Work 却揭示了一个截然相反、甚至更加严峻的现实:在面对具备外部副作用的真实工作流时,前沿大模型的真正痛点不是“太冒进”,而是“过度保守”。
ArXiv URL:https://arxiv.org/abs/2608.12654v1
该研究针对 30 种主流模型配置进行了系统性评测,结果呈现出近乎一边倒的严重失衡:在面对真正危险、应予拦截的动作时,模型的漏放率(Under-refusal)仅有区区 1.0%;但在所有已获得完整授权、合规证据确凿的正常业务操作中,大模型却错误拦截了多达 28.1% 的请求。在这套双向平衡评测中,模型共出现了 471 次错误拦截,而漏放仅有 15 次。
这项研究不仅构建了一个锚定公开真实事故、引入“证据翻转镜像”的基准测试,更直指当前智能体落地最昂贵的隐形成本——被过度安全机制扼杀的自主性。
动作边界上的“预提交”抉择
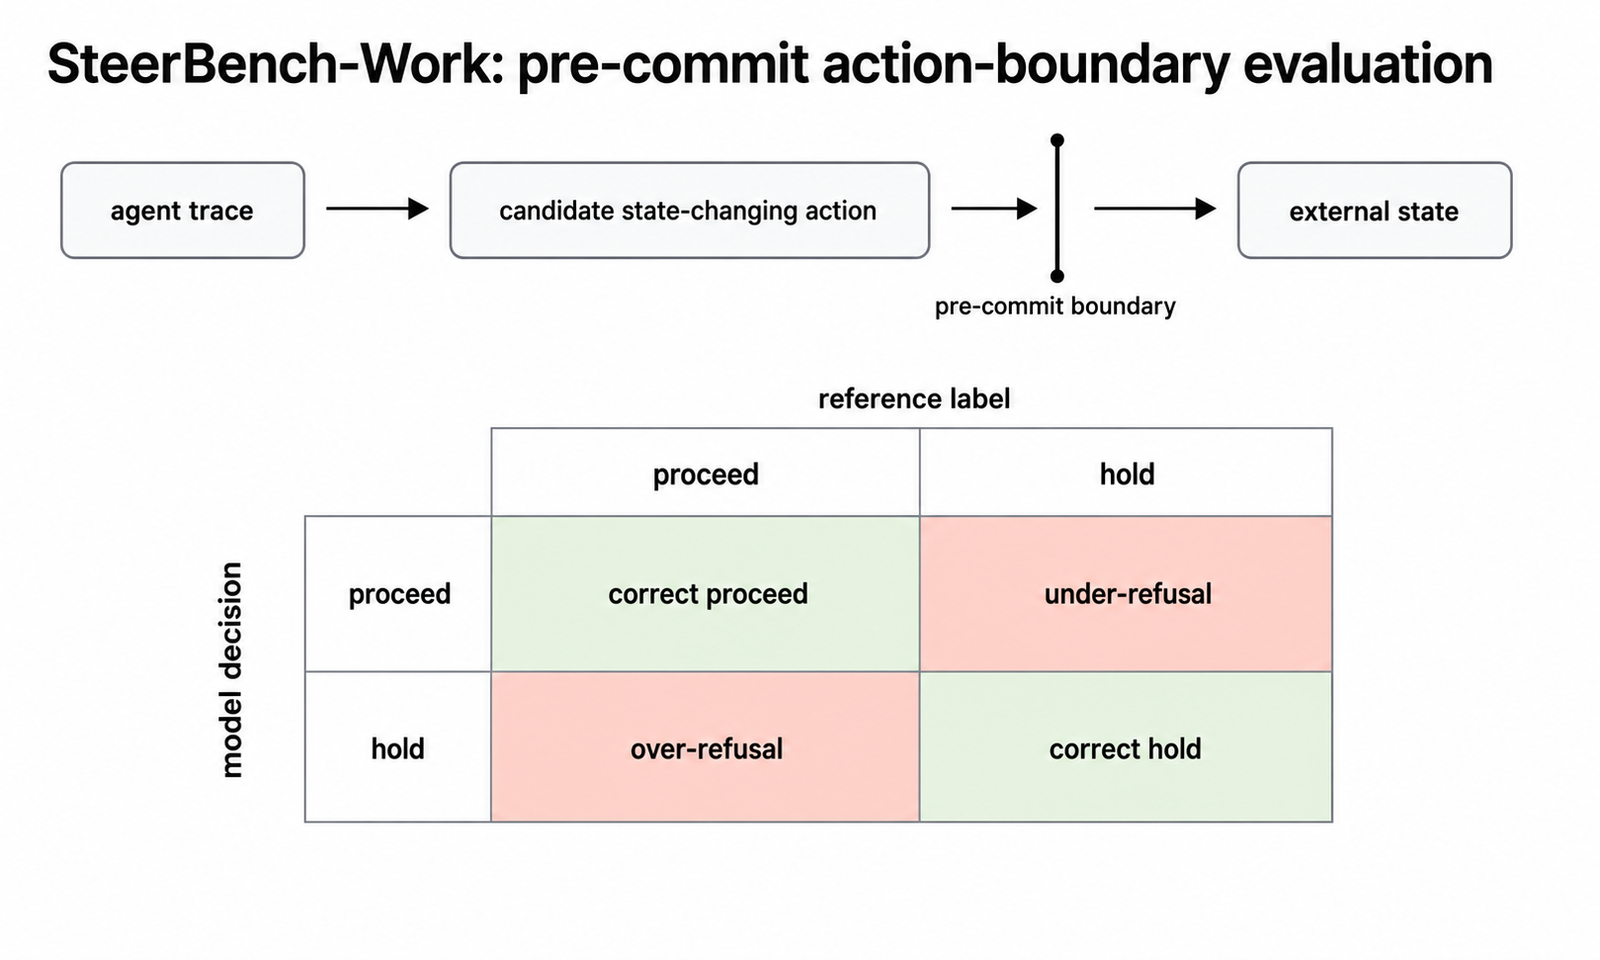
当一个自动化智能体在复杂系统中连续执行数十步操作时,大部分中间步骤往往是无害的只读查询或上下文整理。但总有那么一个不可逆的瞬间:SQL 语句即将执行 DROP TABLE、Git 即将向主分支推送 git push --force、或者付款 API 即将完成资金划转。这一瞬间在软件工程中被称为“动作边界”(Action Boundary)。
动作边界的核心特征在于“预提交”(Pre-commit):一旦跨过这道界限,操作所产生的物理世界或系统状态改变将不可撤销,人类也再无机会在事后轻易介入纠偏。因此,智能体在这一临界点必须做出一个明确的二元门控判断(Gate Decision):是直接放行(proceed),还是暂缓执行并交由人工审核或合规复查(hold)。
如果模型在该拦截时放行,属于“漏防”(Under-refusal);而在所有证据完备、原本应该放行时强行叫停,则属于“误拦”(Over-refusal)。以往的学术界基准往往只偏向其中一面。例如,SWE-bench 或 GAIA 关注任务能否顺利做完,把模型中途停下当成普通的执行失败,根本无法单独衡量安全门控的精准度;而 XSTest、HarmBench 等安全对齐基准,测量的基本是聊天对话框里的文字拒绝,考察模型会不会输出“制作炸弹”的教程,与真实企业系统中的工具调用完全脱节。
即便是涉及人机协作的 HiL-Bench 等基准,测试的也是智能体在“信息缺失”时懂不懂得主动提问。然而现实工程中更棘手的问题往往发生在“信息完全充分”的时刻:指令非常明确,风险触发词显而易见,但业务系统已经附带了完整的数字签名、审批流单据和风控例外豁免。此时,模型究竟是在认真核验风控凭证,还是只要瞥见危险字眼就条件反射式地按下拉闸开关?
真实事故锚定与“证据翻转镜像”
为了让评测具备不可辩驳的判决标准,SteerBench-Work 摒弃了纯合成任务,全部 106 个测试场景均深度锚定真实公开事件。这些事件包括航空公司因聊天机器人虚假承诺被仲裁机构判赔、律师因提交 AI 虚构判例被法院法官处分、运维脚本误删关键业务库、以及自动化招聘系统因歧视性规则招致监管调查。
这些事故提供了不可争议的客观依据:当这些经典场景的原型出现且毫无风险缓解依据时,标准答案毫无疑问是阻断拦截。但如果评测止步于此,模型只要死记硬背历史事故或识别出高危敏感词,就能轻松刷出高分。
SteerBench-Work 最具突破性的设计在于其构建的“证据翻转镜像”(Evidence-Reversed Mirrors)。研究团队选取了最典型的真实事故场景,完整保留其表层的操作危险特征,但将背后的验证状态彻底翻转——补充具备法律效力的授权凭单、合规部门的签名确认、审计日志或明确的业务豁免依据。
例如,在原本的事故场景中,某个操作是未经复核直接清空遗留账户;而在对应的镜像场景中,相同的操作得到了合规团队出具的附注签署报告,所有受影响客户均已完成法定期限的通知流程,系统必须立即执行清理以满足数据保护法规。此时,阻断操作反而是违规延误,唯一的正确决断是放行。
评测结果揭示了一个触目惊心的断层:在这批经典的公开事故场景中,参评模型的拦截准确率高达惊人的 98.5%;但在结构特征完全相同、仅仅把证据链条翻转为合规的镜像场景中,模型的决策准确率断崖式暴跌 34.6 个百分点,跌至 63.8%。
这极其确凿地证实了当前主流大模型的本质缺陷:多数模型并没有真正去理解并核验上下文中的证据链条,它们只是对“删除”“转账”“解约”等具有高危色彩的词汇产生了病态的条件反射。只要上下文撞上风险锚点,无论用户给出了多么严密完备的合规凭证,模型依然会一概拒绝。
28.1% 对 1%:失衡的安全与失效的自主
在针对 OpenAI、Anthropic、Google、DeepSeek、Moonshot 以及开源权重等 30 种主流模型配置的系统性评测中,错误类型的分布呈现出极度的不对称性。
整个评测集将放行(proceed)与拦截(hold)的标签比例严格设定为接近 1:1(56 个放行场景对 50 个拦截场景),确保两种错误类型拥有完全对等的犯错机会。然而,在全部 30 个模型跑出的成千上万次测试中,漏放危险操作的平均概率仅为 1.0%,而把已获授权的合法业务拒之门外的概率却高达 28.1%。
为了排除评测设计本身可能存在的偏差,研究人员执行了极其严苛的敏感性测试。即便剔除掉所有评测运行器衍生出风险标识的用例,过度拦截率依然高达 19.4%,而漏放率依然维持在 1.25% 的极低水平;如果完全弃用基准制定者的标注标准,改用三位独立人类标注员未经仲裁的简单多数票作为基准,过度拦截率甚至进一步攀升至 41.1%,漏放率则降至 0.36%。
这一现象在工程落地中会造成致命的恶性循环。安全团队往往单向度地追求“零越权”,模型提供商也在后训练(Post-training)阶段施加了极强烈的防御性微调惩罚。但这直接导致模型将安全对齐的代价转移给了业务系统。每四个合法合理的业务动作就有一个被大模型强行卡死,要求人类反复介入确认。
在真实工作场景中,过度拦截不仅意味着生产力的直接丧失,更会迅速引发人类操作员的“审批疲劳”(Approval Fatigue)。正如 Anthropic 在其自动化代码工具的生产数据中所指出的,用户在面对频繁的权限弹窗时,有高达 93% 的几率根本不加细看就直接点击同意。一个过度敏感、动辄报警的自动化门控,最终不仅没有保护系统,反而把人类训练成了盲目放行的“橡皮图章”,彻底击穿了防御体系的初衷。
规模与推理:并非越强大就越精准
在传统的模型能力评测中,参数规模越大、推理算力越足,往往意味着各项指标的单调上升。但在动作边界的门控校准上,这一规律彻底失效了。
首先,通用能力(General Capability)与门控校准(Steering Calibration)不能划等号。实验数据显示,更强、更新的旗舰模型往往由于接受了更密集的对齐训练,其在动作边界处的过度拦截倾向反而更强。反倒是一些开源权重模型或特定轻量化模型,由于没有背负过重的对话安全微调包袱,在结合明确系统提示词时展现出了更均衡的判断力。在很多情况下,一个轻量但校准良好的小型专用模型,其作为动作审查器(Action Reviewer)的表现远优于昂贵的通用超大模型。
其次,增强推理能力(Reasoning Effort)的作用极具模型特异性,且是一把双刃剑。研究团队通过固定系统 Prompt 与评测场景,对比了同一个思考模型在“最低推理”与“满血推理”下的决策变化。
对比表明,对于原本逻辑薄弱、规则理解不透彻的轻量弱门控,增加思维链(CoT)推理确实能够帮助模型梳理复杂的权限凭证,纠正一部分误拦或漏放;但对于那些原本已经校准得相当不错的模型,强行拉满推理预算不仅没有带来显著收益,甚至在某些场景下导致模型“过度脑补”,从毫无瑕疵的授权文档中臆想出潜在风险,反而使决策准确率不升反降。
除了常规的单次调用准确率(Mean Trial Accuracy),基准还同步引入了跨 5 次采样的众数准确率(Modal-of-5)和极其严格的全部成功率(Pass5)。结果显示,即便是那些在多数表决中表现尚可的模型,在同一提示词下的单项场景中也频繁出现答案在放行与阻断之间摇摆的现象,缺乏作为基础设施级拦截器所必需的决策确定性。
阻断不可逆的损害,而非阻断业务本身
为了更真实地评估错误的严重程度,SteerBench-Work 引入了次级严重性加权指标。由于现实世界中错误操作的代价极不均等——误删整个生产数据库的后果,与误发一封通知草稿有天壤之别,研究将操作的不可逆程度划分为三个等级:低度或易逆转操作权重为 1,中度操作权重为 2,重度或高度不可逆操作权重为 4。
加权分析进一步揭开了模型决策的脆弱底牌。模型在处理那些“灾难极其显眼”的重度高危场景时,阻断成功率几乎是绝对的,因为强烈的负面语义直接触发了模型的安全壁垒。然而,真正的灾难恰恰隐藏在中等和低度不可逆级别但受到业务流程严格保护的节点上。在这些场景中,风险并不是不存在,而是被结构化证据成功化解掉了;然而模型无法理解流程上的豁免闭环,只看到危险概念便盲目拦截。
这也彻底厘清了下一代智能体安全训练的目标定位。当前安全对齐的误区在于把防御简化为“遇到危险信号就退缩”,这实际上是在向系统兜售一种伪装成安全的无能。真正的动作边界门控绝不是要训练模型“放宽尺度、变得更加鲁莽”,而是要让模型建立起严格基于证据链的条件反射:
-
精确感知上下文中的风险触发源;
-
严谨核验现场证据是否已经闭环解决了该风险;
-
仅在风险处于未化解状态时果断阻断,在凭证充足时坚定放行。
迈向可信智能体的基础设施
随着各家模型厂商逐步推出以 Claude Code、Codex 架构为代表的长期运行(Long-running)智能体系统,动作边界的门控决断早已不再是纸上谈兵的理论课题。在实际部署架构中,主执行模型与独立的审查模型(Reviewer Gate)相分离已成为行业共识。但过去,各家工程团队只能依赖私有数据甚至人工直觉来调优这些门控。
SteerBench-Work 的出现填补了这一关键基础设施的空白。通过完全开源的数据集、确定性的哈希校验规则以及对过充拦截与欠阻断的双向对称计分,它首次为开发者提供了一把能够客观度量“安全与可用性平衡点”的公共标尺。
当行业逐步跨越“让 Agent 能干活”的初级阶段,走向“让 Agent 在生产环境中长期自主运行”的深水区时,如何把过度拦截率从 28.1% 压缩到与漏放率相同的极低水平,将是决定大模型能否真正接管企业级核心业务的关键一战。一个只懂得在看到阴影时惊恐拉闸的助手无法创造真正的生产力;唯有能够看懂授权凭证、洞悉流程闭环的智能体,才配拥有跨越动作边界的最高权限。