21款博弈测出LLM社交短板!CMU提SPaRTan免微调自进化战术
Social Gym and SPaRTan: Benchmarking and Improving LLM Social Reasoning via Multi-Agent Game Tournaments
当大语言模型被推向多智能体协同、商务谈判或角色扮演等复杂社交场景时,它们真实的“情商”与博弈水准究竟如何?在数学证明或代码生成任务中,评测往往拥有绝对客观的真值;但在社交互动中,既没有单步标准答案,也不存在非黑即白的逻辑判断。长期以来,学界评估大模型社交能力要么依赖静态的心理理论(Theory of Mind)问卷,要么退回到“以模型评判模型(LLM-as-judge)”的互动评分中。然而,这种依赖主观裁决的方式不仅容易引入长文本偏好、自夸偏差与位置偏差,更无法为智能体的学习与进化提供可靠、可验证的反馈信号。
ArXiv URL:https://arxiv.org/abs/2608.09128v1
为了打破这种主观评测与单一场景的局限,卡耐基梅隆大学(CMU)的研究团队提出了一套完整的评估基准与无须微调的自优化框架:Social Gym 与 SPaRTan。该研究通过算法严格判定胜负规则,汇集了从“囚徒困境”到“狼人杀”等 21 款经典博弈,建立起统一的 Elo 跨游戏天梯榜;同时,团队提出了类似“战术复盘”的 SPaRTan 机制,让模型通过阅读自己的对局轨迹提炼自然语言战术手册,在完全不更新权重的前提下显著提升了弱势角色的胜率。
告别主观裁决:构建规则驱动的 Social Gym
评估多智能体社交智能的最大痛点在于“规则与奖励的不可验证性”。过去即便有研究尝试用狼人杀或阿瓦隆测试大模型,也大多局限于单一游戏,缺乏横跨不同认知维度的系统性视野。
Social Gym 的核心理念是算法可验证性(Algorithmically Verifiable)。环境内的每一局博弈,其胜负、得分与淘汰皆由严格的代码规则决定,彻底剥离了主观的裁判模型。系统底层基于统一的通用游戏引擎构建,依托有限状态机(Finite State Machine, FSM)管理复杂的状态转换(如狼人杀中的“黑夜降临”与“白天处决”,抵抗组织中的“组队表决”与“任务执行”)。更关键的是,该环境引入了严格的部分可观测性(Partial Observability)可见度层,将交互信息分为全员公开、阵营私密与单人私密三类。这种设计杜绝了信息泄露,逼迫模型必须依靠有限的可见线索去推断对手或盟友的隐变量,构成了对高阶心理理论能力的严苛测试。
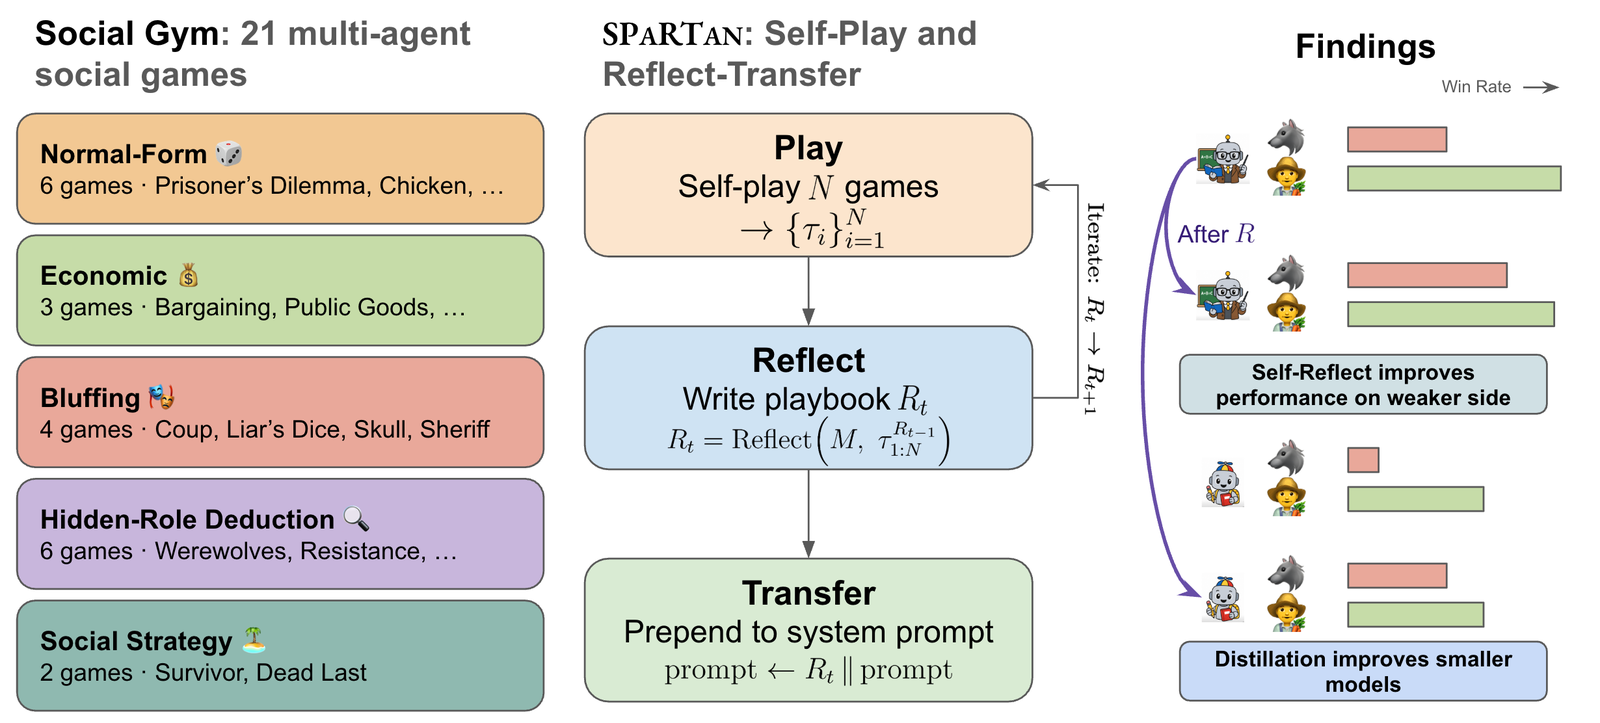
整个基准涵盖的 21 款博弈根据“信息结构”与“沟通模式”两个正交维度,划分为五大认知类别:
-
正规形式博弈(Normal-Form Games,共 6 款):如经典囚徒困境、胆小鬼博弈(Chicken)、智猪博弈、硬币少数派博弈等。完全信息且无自由沟通,测试模型在纯粹收益矩阵下的战略基元。
-
经济博弈(Economic Games,共 3 款):包括公共品博弈、蜈蚣博弈与结构化讨价还价,重点考察搭便车冲突、信任随赌注递增的脆弱性以及利益分配机制。
-
虚张声势博弈(Bluffing Games,共 4 款):涵盖吹牛骰(Liar’s Dice)、骷髅牌(Skull)、政变(Coup)与诺丁汉警长,测试智能体在非固定阵营下的概率推理与主动欺骗能力。
-
隐藏角色推理(Hidden-Role Deduction,共 6 款):包含狼人杀、抵抗组织(Resistance)、间谍危机(Spyfall)、变色龙、卧底等,要求模型在自由多轮对话中识别伪装的盟友与敌人。
-
社交策略博弈(Social Strategy,共 2 款):如幸存者(Survivor)与 Dead Last,完全信息但重度依赖联盟缔结、劝说与淘汰投票中的声誉管理。
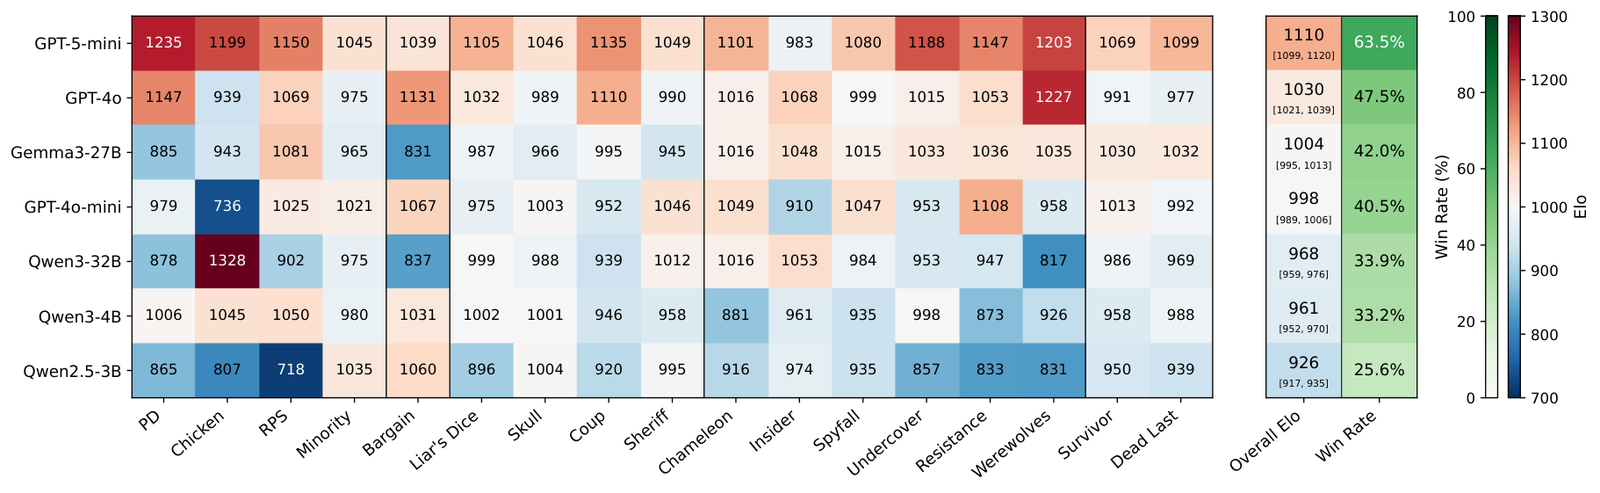
通过全模型排列组合的循环锦标赛,并利用正则化 Bradley–Terry 最大似然估计,研究团队拟合出了覆盖所有对抗性博弈的 Elo 统一战力排行榜。
排行榜反转:没有全能模型,小模型深陷“鹦鹉学舌”
实验选取了涵盖闭源与开源的七款代表性模型展开角逐,包括 GPT-5-mini、GPT-4o、GPT-4o-mini、Qwen3-32B、Qwen3-4B、Qwen2.5-3B 以及 Gemma3-27B。
天梯榜整体呈现出清晰的能力阶梯:GPT-5-mini 以综合优势登顶总榜,闭源大模型在宏观胜率上依旧领先。然而,单项博弈的细分 Elo 揭示了一个此前被单一标量评分掩盖的严酷事实:没有任何一个模型能够统治所有博弈场景,各游戏排名甚至发生剧烈反转。
最刺眼的案例莫过于开源主力 Qwen3-32B。在纯矩阵对抗的“胆小鬼博弈”中,该模型凭借极具攻击性的激进策略拿下 1328 的单项最高 Elo,斩获第一;但一旦切换到需要长期信息追踪与隐蔽掩护的“狼人杀”,其 Elo 瞬间暴跌至 817,在所有参赛模型中凄惨垫底。即便是总榜头名的 GPT-5-mini,在特定经济博弈或诈唬博弈中也会跌破基准线,被参数规模远逊于自己的对手压制。这种反转说明:社交推理绝非单一维度的同质能力,欺骗检测、联盟管理与博弈论均衡解之间存在着深刻的行为机制差异。
在非对称隐藏角色博弈中,模型普遍表现出“角色能力偏科”。面对全模型池对抗时,多数模型扮演少数派/欺诈角色(如潜伏的狼人或间谍)的 Elo 得分明显更高;但当进入同模型“左右互搏”的高水平自我对弈时,情况完全反转——在模型自身严密的逻辑排查下,欺骗变得极其困难,少数派弱势阵营的胜率往往跌至谷底(例如在未经优化的基准对局中,狼人胜率仅约 23%,抵抗组织中的间谍胜率仅为 30%)。
此外,对小模型的对局轨迹进行质性分析还发现了一个普遍存在的系统性漏洞:“鹦鹉学舌”效应(Parroting Effect)。以综合垫底(Elo 仅 926)的 Qwen2.5-3B 为例,它在多轮自由对话中频繁出现简单复述或改写前一位发言者观点的行为。这种缺乏独立观点的附和看似在维持对话,实质上属于输出接近零信息增量的行动,在狼人杀等游戏中不仅无法自证清白,更为潜伏的欺骗者提供了完美的掩护屏障。
SPaRTan 机制:无需微调的战术提炼与迁移
既然模型在不同角色和场景下存在明显的策略盲区,能否让模型在不调整任何权重的前提下实现“自主打磨”?研究团队受人类棋手复盘与战术手册的启发,提出了 SPaRTan(Self-Play and Reflect-Transfer,自我对弈-反思-迁移) 框架。
SPaRTan 的运行逻辑由三个清晰的阶段构成闭环:
-
对弈(Play):模型在没有外部提示的前提下进行多轮自我对弈,记录包含动作、发言与胜负结算的完整轨迹 $\tau$。
-
反思(Reflect):模型以元认知视角阅读并审视自己的成败轨迹,分析导致失败的典型决策点,提炼出一套跨回合可复用的自然语言战术策略(Playbook)。
-
迁移(Transfer):将生成的手册直接作为系统前置 Prompt 注入后续智能体的上下文中,指导其进行全新对局。
这实质上构成了一种“上下文内的微调(In-Context Fine-Tuning)”,它将模型的历史试错经验直接编译为自然语言形式的战略指令,极大地降低了社交行为优化的成本。
为了验证这套机制的泛化边界,团队针对非对称弱势阵营设计了四种不同维度的实验:
1. 局内迭代反思:并非轮数越多越好
在狼人杀、间谍危机与抵抗组织中,让 GPT-5-mini 连续进行四轮迭代反思(从基础策略 $R_0$ 进化至 $R_1 \sim R_4$)。实验给出了一个反常识的结论:战术收益并非随反思轮数线性累积,大部分胜率增益在第一轮($R_1$)就已经爆发式释放。在狼人杀中,装备 $R_1$ 战术的弱势狼人阵营胜率迅速从基线的 24% 跃升至 36%;而后续的多次迭代仅仅是在策略风格上微调甚至重新洗牌,并未进一步大幅推高胜率峰值。
2. 跨游戏战术迁移($1 \to n$)
如果一份战术手册是在“狼人杀”中反思得来的,它能否用于“间谍危机”或“抵抗组织”?实验将单款游戏沉淀的 $R_1$ 战术注入到其他未见过的博弈中。
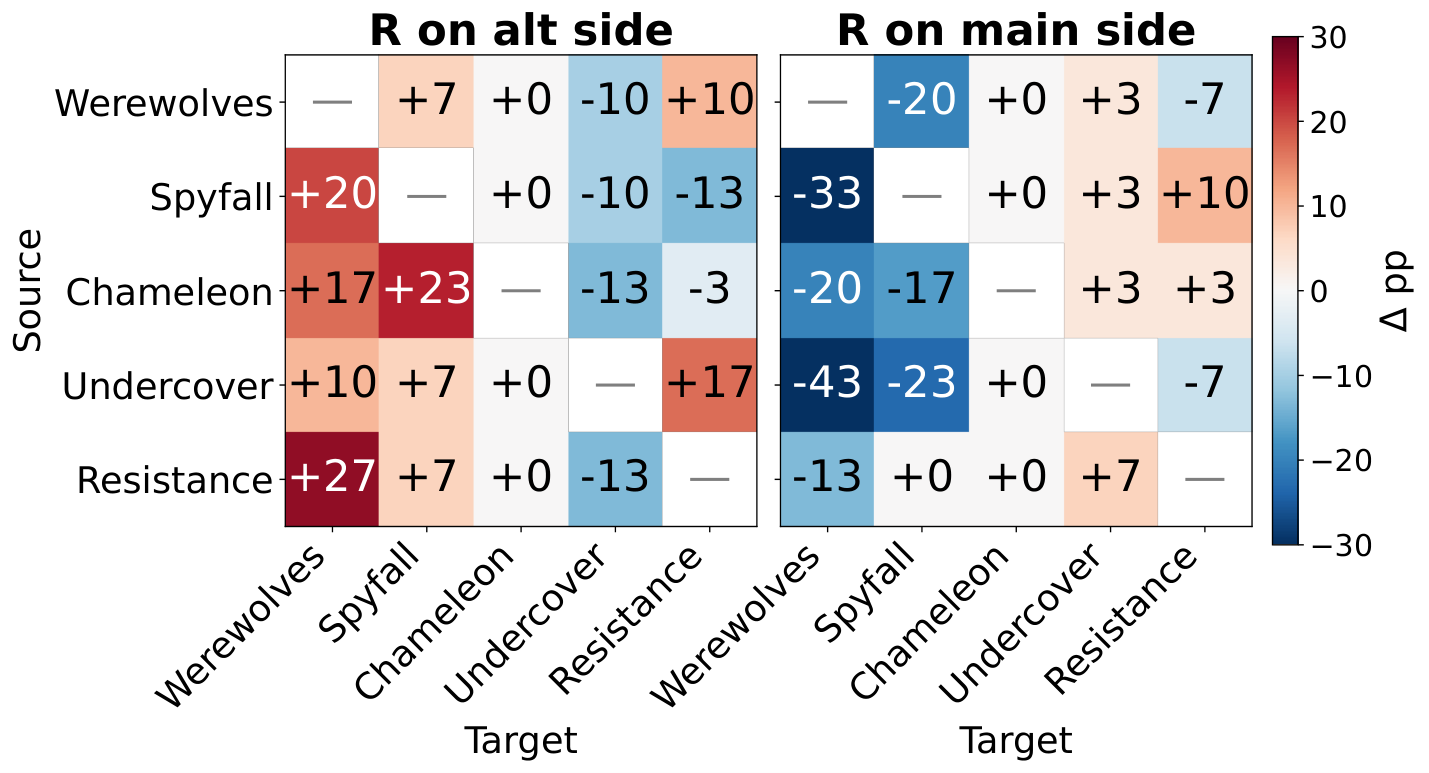
跨游戏热力图清晰地揭示了 SPaRTan 的特质:无论源任务与目标任务如何切换,战术手册对弱势阵营(Alt side)几乎全盘带来正向胜率加成(热力图左侧被代表胜率提升的暖色主导);相反,如果强行把手册塞给本就占优的主流阵营(Main side),反而会导致胜率下滑。这种现象表明,反思提炼出的战术核心在于“高风险下的精准伪装与疑点化解”,它天生适配逆风角色的自救,但套用在优势守成方身上反而打乱了原本的防御阵型。
3. 多源知识融合($n \to 1$)
当智能体同时阅读来自狼人杀、变色龙、间谍危机等多款复杂博弈的混合对局轨迹时,提炼出的多源战术手册表现出了更平稳的迁移适应能力。即使在测试完全被屏蔽在外的抵抗组织博弈时,模型依然能稳定地借用隐蔽身份的综合经验拉平胜率。
4. 跨模型蒸馏与能力瓶颈
更具现实意义的是强弱模型间的战术蒸馏。研究者将 GPT-5-mini 提炼的多博弈战术注入给 GPT-4o、Gemma3-27B、Qwen3-32B 等 6 款学生模型。结果显示,高阶战术能够突破模型架构的限制,精准拉升不同学生模型在弱势角色上的胜率。
然而,这套自优化循环在开源模型自主运行时遭遇了冷水。当研究人员尝试在 Qwen3-32B 身上复现同一套自反思管线时,却得到了一组几乎为零的提升结果(Null Result)。除了最简单的单轮囚徒困境略有改观外,在多轮隐藏角色博弈中,Qwen3-32B 既无法从自身混乱的长文本对抗中抽象出高维度的博弈战略,也无法严格执行自我总结出的原则。这印证了一个关键推论:从社交博弈试错中实现自我进化的能力,具有极高的模型容量(Capacity)门槛;中等规模的模型或许能在微调后扮演特定角色,但想要依靠上下文反思实现自主战术沉淀,底座模型的长程推理与抽象归纳能力依然是无法绕过的硬指标。
总结与展望
CMU 这项工作的重要性不仅在于搭建了首个涵盖 21 款博弈、以算法规则为基准的通用社交评估沙盒 Social Gym,更在于用严格的数据破除了“大模型情商已能通杀”的幻觉。游戏间排名的剧烈倒挂向所有开发者提了个醒:面对复杂的非对称对抗,没有任何基座模型可以不加适配地直接掌控全场。
而 SPaRTan 的探索则展示了一条极具性价比的无参数自进化路径:通过自我对弈和战术复盘,强模型能够将长程博弈经验沉淀为高迁移性的战略指令,甚至实现自上而下的跨模型降维赋能。随着大模型在多智能体系统与人机协同场景的深入铺开,这种摆脱主观评分依赖、以战养战的自进化范式,或许正是未来构建真正具备“心智推理与战略深度”自主智能体的必由之路。