SocialBuddy:腾讯等提出社交搜索智能体,35B模型精准检索突破多维约束
SocialBuddy: Tailoring Search Agent for Social Scenarios
在开放网络或通用知识库场景中,基于强化学习的大语言模型(LLM)搜索智能体(Search Agent)已经展现出强大的长程推理和动态工具调用能力。然而,当把这些在学术问答和网页检索中游刃有余的智能体放进朋友圈、X(Twitter)或 Facebook 等社交动态流时,现有的搜索系统往往会迅速失效。用户每天都在产生极其具体又充满隐含限制的需求:“小明上周发了哪些关于大模型的动态?点赞最高的是哪一条?”面对这类问题,通用网页搜索 Agent 和传统的检索增强生成(RAG)管道常常在检索第一步就偏离方向,要么无法圈定特定好友与时间窗口,要么在点赞数、评论互动等多维元数据上彻底迷失。
ArXiv URL:https://arxiv.org/abs/2609.01641
为了解决这一断层,来自微信(腾讯)、北京理工大学以及中国科学技术大学的研究团队联合推出了专为社交场景打造的智能体搜索框架 SocialBuddy。针对真实社交网络极度私密、数据无法直接用于公开训练与评估的难题,研究团队首先构建了首个大规模社交搜索仿真环境 SocialEnv,内含 20 万虚拟用户画像、1000 万条社交动态以及 5 万条高质量推理轨迹;随后,针对长程社交搜索中奖励极度稀疏、归因极其困难的痛点,提出了混合粒度策略优化算法 SocialPO;最终构建了包含 4,893 个多意图真实验证查询的 SocialSearch 基准评测集。
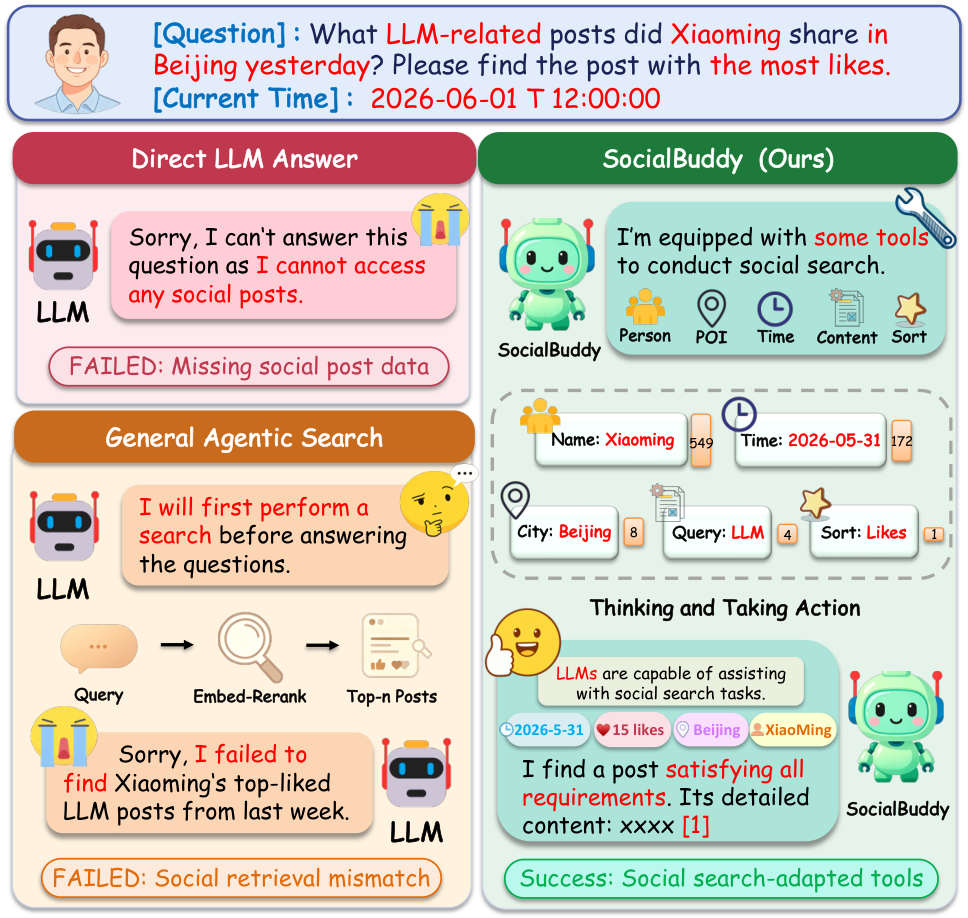
实验表明,经过专门适配与策略优化的 SocialBuddy-35B,在各项社交检索与问答指标上全面超越了参数量远大于自身的顶尖前沿模型(包括 GPT-5、GLM-5.2 等),在精准匹配率(Exact Match)上带来了显著的性能跨越,成功填补了大模型在日常社交智能检索方向的空白。
为什么通用搜索智能体会在社交场景中频频碰壁?
社交媒体内容与静态开放网页存在本质区别。开放网页检索的核心假设是“全局可见”且“内容静态”,检索器只需基于文本语义相关度从海量索引中拉取相关网页即可。然而在社交网络中,信息检索面临着独特的双重发散性(Divergence):
第一是空间维度的发散性(Spatial Divergence)。社交网络是以自我为中心(Ego-centric)的局部子图。两个不同用户在同一时间发出完全相同的检索词,他们能够看到且应该看到的内容是完全由其社交圈层界定的。如果系统无法将检索严格限制在当前用户的“可见好友范围”内,就会造成严重的数据越界和语义漂移。
第二是时间维度的发散性(Temporal Divergence)。社交动态流具有极强的时效衰减特性。同一个用户在不同时间节点发出“上周的好友聚餐动态”,所锚定的绝对时间切片完全不同。传统向量检索器(Dense Retriever)倾向于将整句自然语言直接压入一个稠密向量中,往往直接抹平了“上周”、“上个月”这种强时间约束,导致召回的动态充斥着时间穿越的错误结果。
更为致命的是多维元数据的级联约束。社交动态绝非单纯的文本,它天然绑定了发帖人身份、社交关系强弱、精确时间戳、地理位置、内容形态(纯文字、九宫格图片、转发链接、视频),以及持续波动的互动指标(点赞量、评论数)。当用户提出“找出获赞最多的一条”时,这不再是一个纯粹的语义相似度匹配任务,而是一个需要将文本语义过滤与元数据数值排序深度解耦、分步执行的结构化推理过程。传统 RAG 将所有条件揉碎在自然语言提示词中丢给模型,极易导致上下文窗口被海量无关候选塞满,进而诱发灾难性的幻觉。
SocialEnv:从零构建千万级社交沙盒
在保护用户隐私的前提下训练和评估社交 Agent,直接采集真实社交数据在合规和伦理上是不可行的。因此,研究团队搭建了高保真的交互式仿真环境 SocialEnv。
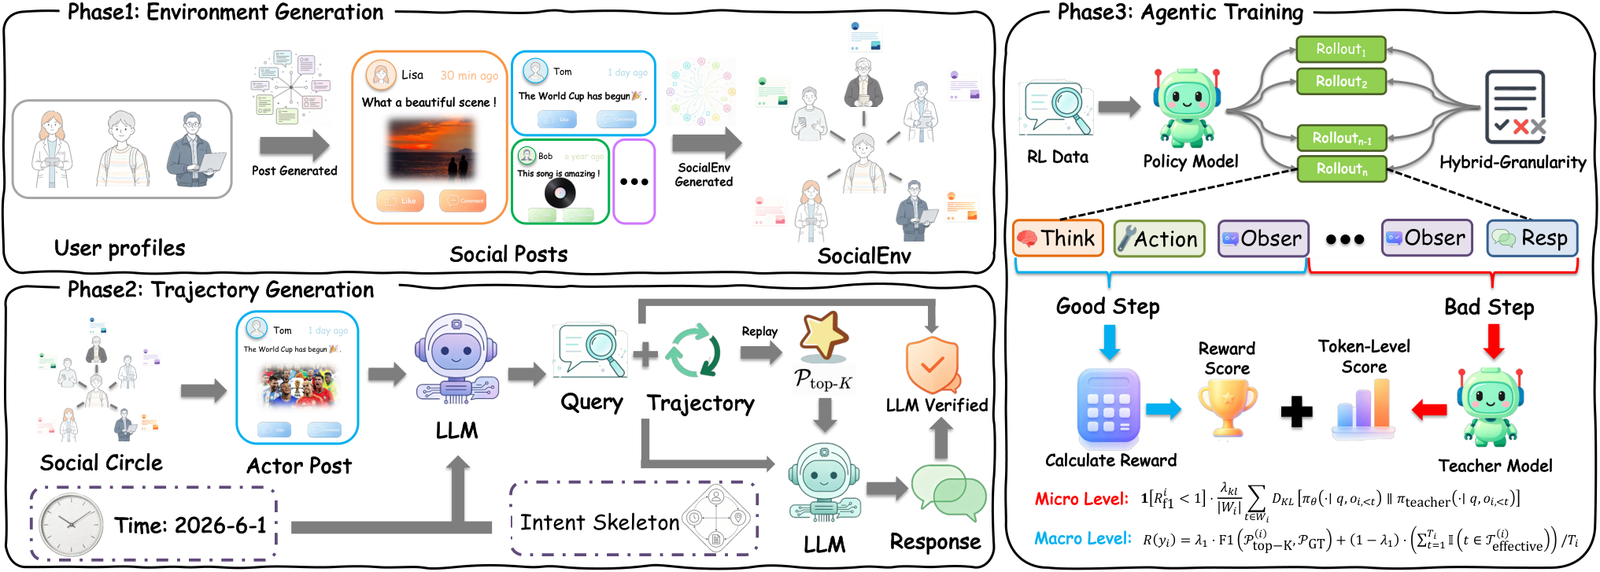
SocialEnv 的核心在于将错综复杂的全网社交拓扑精准抽象为以单个人物为核心的自我中心子图。系统为每一个锚点用户限定了可见范围:用户能检索到的动态,严格受限于该用户自身及其一度直接好友在特定时间戳前发布的内容。在底层数据构建上,团队利用定制化提示驱动前沿生成模型,合成了 20 万个覆盖 7 岁至 85 岁、涵盖 12 类社交圈层关系(如同事、亲人、同学、挚友等)的真实虚拟画像。在此基础上,合成了包含文字、图文、视频、分享链接及音乐在内的 1000 万条社交动态,覆盖超过 2.84 万个兴趣主题标签,最终划分成 1000 个独立的虚拟朋友圈生态。
拥有了环境沙盒后,下一步是获取可供模型学习的高质量推理轨迹。如果单纯依靠大模型对环境进行无先验的随机盲抽,大部分检索尝试都会返回空结果,产生严重的采样算力浪费。真实世界中的用户发起搜索时,脑海中往往已带有对目标好友或事件的模糊先验。为此,SocialEnv 采用了基于环境上下文引导的逆向轨迹合成管线:先从特定好友圈中抽取包含特定交集的目标动态簇,反向合成符合真实表达习惯的多意图自然语言 Query,再引导教师模型生成调用工具过滤候选池的完整动作链,并配合质量验证模块对轨迹执行严格的事后审计,确保召回结果与目标动态严格闭环,过滤掉产生幻觉或执行中断的无效路径。这一流程最终沉淀出 5 万条可用于监督微调的基础轨迹,以及 2 万条包含多重约束的强化学习进阶数据。
为了让 Agent 在动态环境中具备确定性的操作抓手,SocialBuddy 为其定义了由五类原子工具构成的结构化动作空间。初始状态下,当前用户的可见动态构成全集候选池,Agent 必须学会在思维链驱动下,按需分步调用用户过滤、时间窗圈定、关键词与主题语义匹配、多模态形态筛选以及互动量排序等工具,驱动候选池状态发生确定性转移,将原本模糊的社交意图拆解为可验证的程序化执行流。
SocialPO:攻克稀疏反馈下的信用分配困境
在具备了环境与动作空间后,如何训练模型在长达数轮的交互中稳定命中正确动态?如果直接套用传统的端到端强化学习(如仅依据最终检索命中率给予单一奖励),智能体会陷入严重的“信用分配困境”(Credit Assignment Dilemma)。
社交检索轨迹具有明显的长程级联特征。一次包含 5 步工具调用的检索,只要其中第 2 步的时间范围设定过窄,就会导致后续候选池被彻底清空;而如果 Agent 在中间步骤频繁执行无意义的重复拉取或冗余筛选,虽然最终可能碰巧命中了部分答案,但整条推理轨迹已经高度臃肿劣化。粗粒度的最终结果奖励无法区分到底是哪一步做对了、哪一步做错了。
为了破局,研究团队设计了混合粒度策略优化算法 SocialPO(Social Policy Optimization)。该算法在宏观结果层面与微观步骤层面实施双向对齐:
在宏观维度上,SocialPO 摒弃了单一的命中奖励,引入了多维复合结果奖励。奖励函数由两部分紧密结合:其一是检索结果集合与标准答案集合的 F1 分数,直接衡量最终任务的召回与精确度;其二是整条轨迹的“动作有效率”,系统会精确审计智能体在整条交互路径中每一步工具调用是否真正推动了有效状态转移,对无效的重复调用、冗余拉取以及空步操作施加平滑惩罚,迫使模型在探索中学会最简、最清晰的调用路径。
在微观维度上,针对检索失败或效果不佳的轨迹(F1 奖励未达到满分),SocialPO 引入了基于错误前缀截断与 Token 级局部修正的细粒度监督。不同于以往直接基于整条轨迹计算相对偏好并施加偏好损失(OPD)的做法,SocialPO 敏锐地意识到整轨迹的粗放惩罚会误伤轨迹前半段原本正确的规划步骤。算法会自动定位执行链中导致候选池异常归零或偏离的转折点,提取关键决策窗口,并利用能力更强的教师模型在该局部切片上计算精确的 KL 散度正则化约束。这种设计让模型在微观上明确知道“究竟是哪个动作的哪个参数选错了”,在大幅提升长序列强化学习稳定性的同时,彻底根治了长程交互中的奖励稀疏问题。
跨越评测基准:超越超大参数前沿模型
为了验证 SocialBuddy 的真实水准,研究团队搭建了 SocialSearch 基准评测集。该评测集由 50 名受试者在完全沉浸熟悉特定虚拟朋友圈后,人工设计并严格多轮校验了 4,893 条复杂多意图查询,划分为简单(Easy)与困难(Hard)两个子集,覆盖人、时间、地点、内容形态与互动指标等多维度的交织组合。评测指标涵盖任务成功率(Success Rate)、检索精确率(Precision)、召回率(Recall)以及要求预测集合与黄金标准完全一致的精准匹配率(Exact Match, EM)。
在与 GPT-5、Claude-4.5-Sonnet、Gemini-2.5-Flash、GLM-5.2、Kimi-2.5 以及 Qwen3.5 全系列基线的全面横向对比中,SocialBuddy 展现出了极具统治力的性能优势:
在整体表现上,参数量仅为 35B 的 SocialBuddy-35B 在全部指标上均刷新了最优记录。相较于当前最强的开源大模型基线 GLM-5.2,SocialBuddy-35B 在平均精确率上提升了 7.8 个百分点,召回率提升了 8.2 个百分点,最严苛的精准匹配率(EM)更是取得了 9.7 个百分点的绝对领先。即便是面对参数量极其庞大的闭源旗舰商业模型 GPT-5,SocialBuddy-35B 依然在精准率、召回率和 EM 上分别取得了 6.9%、6.5% 和 8.0% 的平均领先幅度。
即使是尺寸更小的轻量化版本 SocialBuddy-9B,也展现出了令人惊喜的表现。对比未经专门适配训练的基座模型 Qwen3.5-9B,SocialBuddy-9B 的平均精确率从 78.3% 跃升至 95.4%(绝对提升 17.1%),召回率从 77.8% 攀升至 95.6%(绝对提升 17.8%),精准匹配率更是从 73.2% 飙升至 93.5%(绝对提升 20.3%)。这清晰地证明,通用大模型之所以在社交检索中表现平庸,并非因为其底层通用语言或感知能力不足,而是缺少对社交多维元数据的图谱化感知工具和针对长程交互的确定性决策机制。
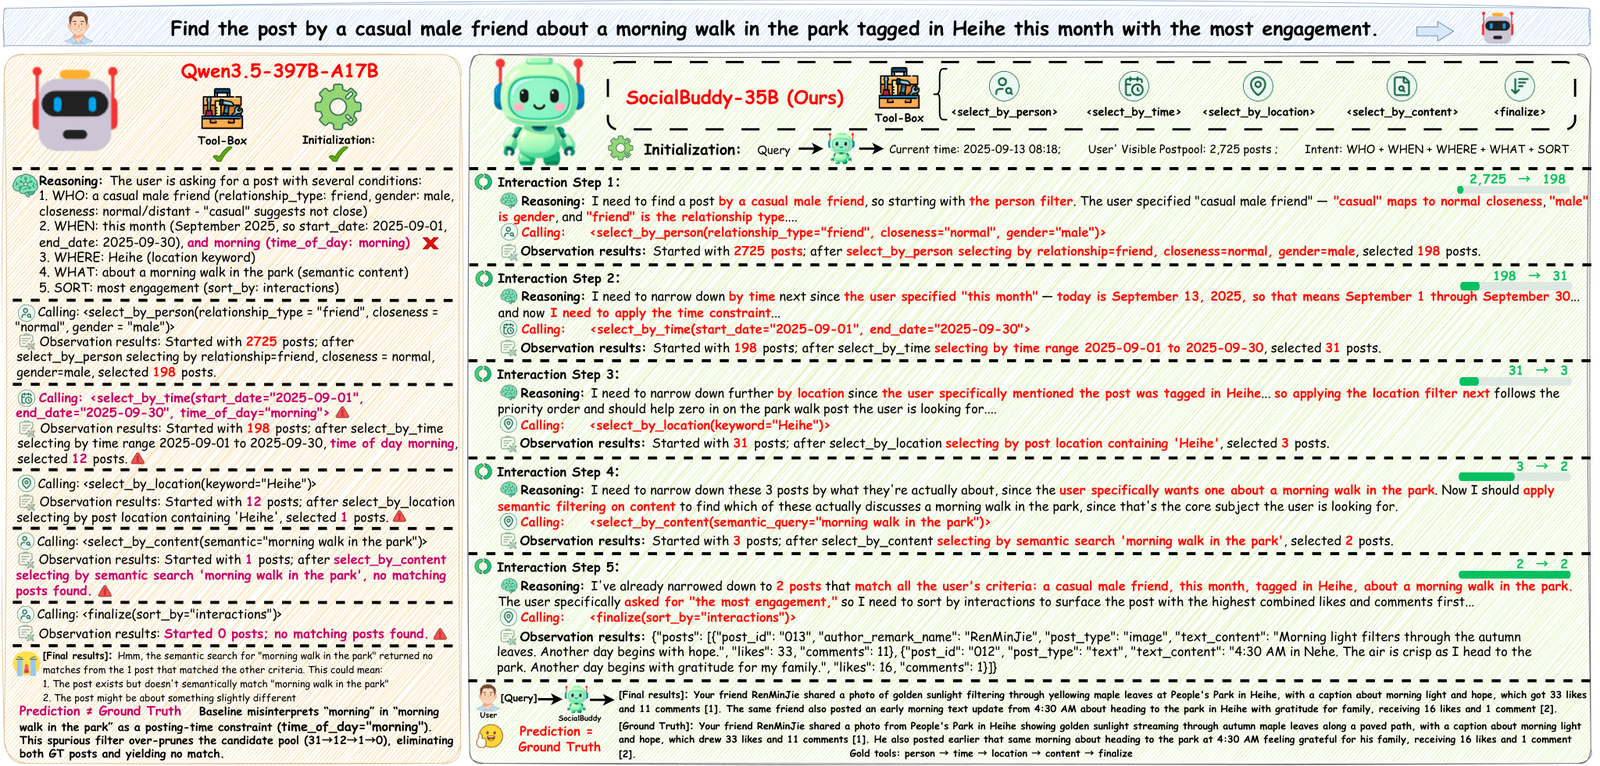
在定性案例分析中,这种能力的差异体现得尤为具象。如图 5 所示,面对一个融合了特定好友、特定动态发布时段、特定话题语义以及“点赞数必须最高”的五维极端复杂请求,近四千亿参数的超大模型 Qwen3.5-397B-A17B 在规划第一步就陷入了混乱:它试图在单次调用中将多重条件全量拼装,由于无法精确对齐相对时间跨度,模型过度收紧了时间窗口,导致首次检索直接返回空集,并在后续步骤中陷入死循环报错,最终未能给出任何有效答案。相反,SocialBuddy-35B 展现出了清晰且沉稳的拆解逻辑:先通过用户与时间范围工具将检索空间平稳缩减至候选子集,随后借助语义过滤锁定相关主题动态,最后准确调取互动指标排序工具定位点赞最高的一条并优雅总结输出,完美展现了结构化智能体的优势。
关键组件消融:精细化监督为何无可替代
为了探究 SocialPO 框架中各项机制的真实增益,研究团队在 9B 尺度上进行了解耦消融实验。数据清晰揭示了模型能力进阶的完整演进路径:
基础监督微调(SFT)发挥了关键的“工具对齐与格式规范”作用。通过学习 5 万条基础轨迹,模型迅速掌握了工具接口的调用协议与基础多轮交互逻辑,使得精准匹配率(EM)从基座模型的 0.732 直接跳升至 0.835。然而,单纯依赖模仿学习的 SFT 极易在面对复杂未见场景时发生累积误差,陷入多轮死循环。
引入强化学习是打破瓶颈的关键,但奖励机制的粒度决定了策略的上限。如果仅采用基于检索结果 F1 值的终局稀疏奖励,EM 仅能提升至 0.878;而一旦在终局奖励中引入衡量动作有效率的宏观复合奖励,有效剔除冗余路径,EM 随即进一步提升至 0.894,表明消除多余无效交互对于提升检索整体质量具有直接贡献。
而在微观优化层面,对比实验揭示了一个常被忽视的现象:如果在强化学习中引入针对整条轨迹的离线偏好蒸馏(OPD),虽然性能可以提升到 0.909 至 0.921,但由于正负样本轨迹往往在前半段共享许多合理的探索前缀,整条轨迹级别的惩罚必然会导致“连带误伤”。SocialPO 所采用的“错误前缀截断与局部 Token 级教师监督”机制展现了其优越性,通过只对产生偏离的关键步骤施加精细制导,SocialBuddy-9B 最终将 EM 推高至 0.935,极大逼近了 122B 规模的教师模型上限。
走向更广阔的个人日常智能
长期以来,搜索 Agent 的进化重心高度集中在通用学术探究、代码调试以及开放网络研报生成等专业级任务上。然而,在以智能手机和移动互联网为主导的当下,普通用户耗费时间最多、情感粘性最深、信息沉淀最丰富的场景,其实是个性化的社交圈层。从浩瀚的社交动态流水线中准确定位某个朋友的生活碎片,在技术本质上要求智能体同时掌控极度严格的局部权限拓扑、高度发散的相对时间推断,以及离散元数据与稠密自然语言语义的精密联动。
SocialBuddy 及其配套的 SocialEnv 环境与 SocialPO 训练范式,为社交场景下的 Agent 设计提供了兼具理论可行性与工程可复现性的标准样板。它向学界与工业界证明了一点:面对高度动态、异构多维的特殊垂类场景,单纯依靠堆叠底座模型参数量并不能自然“涌现”出鲁棒的业务落地能力;唯有将深刻契合场景物理特性的结构化环境仿真、清晰解耦的动作空间构建,以及粗细兼备、直击归因痛点的混合粒度策略优化紧密结合,才能真正将通用大模型锻造为触手可及、高效可靠的个人生活智能助手。