SPECTRA:冲破2-bit悬崖,将KV Cache压缩推至12倍
SPECTRA: Pushing the KV Cache Beyond the 2-Bit Cliff via Spectral Transform Coding
在大模型迈入智能体(Agent)与长文本时代后,显卡显存的第一杀手不再是静态的模型权重,而是动态膨胀的键值缓存(KV Cache)。当上下文窗口拉长到数万甚至数十万 Token 时,自注意力机制在每一步生成中都需要完整遍历并加载全部历史键值对。由于 KV Cache 随序列长度与并发并发请求数线性膨胀,它往往会在很短时间内吞噬掉昂贵的高带宽显存(HBM),成为限制服务吞吐与序列长度的核心瓶颈。
ArXiv URL:https://arxiv.org/abs/2608.07915v1
现有的缓存瘦身方案中,均匀量化(Uniform Quantization)是工程落地的首选,但这一路线长期被一道坚不可摧的技术屏障所阻碍,即所谓的“2-bit 悬崖”(2-bit Cliff)。当把缓存精度从 4-bit 强行下压到 2-bit 附近时,每个数值只剩下区区 4 个离散区间,面对大模型激活值中天然存在的离群点(Outliers),这 4 个量化区间被极端极值完全霸占,其余绝大多数正常数值迅速塌缩为噪声,模型表现呈现断崖式下跌。为此,来自诺基亚(Nokia)与莱斯大学(Rice University)的研究团队提出了名为 SPECTRA 的全新免微调、即插即用 KV Cache 编解码方案。该工作将 KV 缓存压缩重新建模为经典的率失真编码问题,利用激活协方差诱导的正交谱变换与反向注水分配,统一了低秩投影与非均匀量化,成功越过了 2-bit 悬崖。在 Llama-3.1-8B 和 Qwen2.5-7B 等模型上,SPECTRA 不仅在 4 倍压缩下实现几乎无损,在传统量化崩溃的 8 倍压缩区依然保持极高精度,甚至能进一步推进至 12 倍压缩,使同一张 GPU 能够容纳的上下文长度直接扩大一个数量级。
为什么现有方案跨不过“2-bit 悬崖”?
要理解 SPECTRA 的突破,需要先审视当下主流的三类 KV Cache 压缩路线的共同痛点。第一类是 Token 剔除(Token Eviction),如 H2O、StreamingLLM 和 SnapKV,其核心是通过注意力打分或位置先验丢弃部分历史 Token,但这种硬性裁剪在跨多跳检索、长代码库分析等需要密集细节的任务中极易导致关键信息永久丢失。第二类是低秩投影(Low-rank),如 Palu 等,试图通过将键值向量投射到底维子空间来减少存储维度。第三类则是量化(Quantization),如 KIVI、KVQuant 等,将高精度的浮点数压缩到 4-bit 或 2-bit 整数。
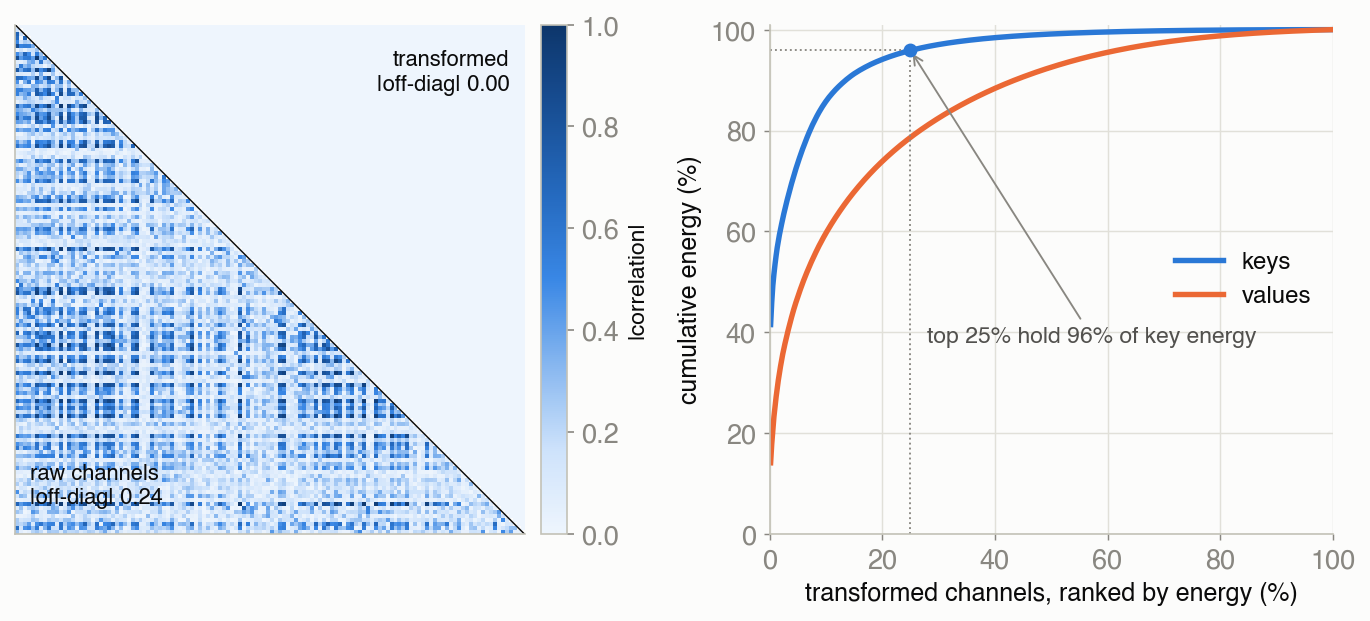
无论是低秩还是量化,绝大多数方案都共享着一个预设:在压缩前人为定死预算分配。低秩方案固定裁剪的目标维度,量化方案则让每个通道均分固定位宽。然而直觉告诉我们,模型不同特征通道承载的信息量有着天壤之别,理应“重要通道给高精度,次要通道给低精度”。但若直接在原始 KV 通道上做非均匀分配,就会遇到巨大的阻碍:原始通道之间存在强烈的非正交耦合。
如上图左侧所示,在未经变换的原始通道基底中,不同特征维度之间的平均非对角相关系数高达约 0.2。由于通道互相纠缠,无法干净地判定究竟哪个特征维度独立承载了不可替代的信号。一旦暴力截断或做极低位宽量化,通道间的耦合扰动就会放大注意力误差。
研究人员发现,破局的关键在于坐标系的转换。通过利用一小批校准数据估计出激活状态的二阶矩统计量,并将缓存投影至其主成分方向后,相关性完全被消除(图 1 左侧上三角的非对角元素骤降为 0)。更为惊人的是,在这一正交谱基底之下,能量展现出极端集中的“帕累托法则”:仅仅头部 25% 的通道就捕获了高达 96% 的键值能量,其余 75% 的通道几乎全是非必要冗余。这证实了一个重要推论:KV Cache 的信息高度集中,但前提是必须在正确的特征基底下才能剥离。
视角转换:低秩与量化本是同一种机制
发现能量高度倾斜的特征之后,研究团队将视角从传统的“张量裁剪”升级为通信领域的“率失真理论”(Rate-Distortion Theory)。既然目标是用有限的比特预算最小化注意力输出误差,那么低秩投影和量化在本质上根本不是两条割裂的技术路线,而是同一种控制手段的两极。
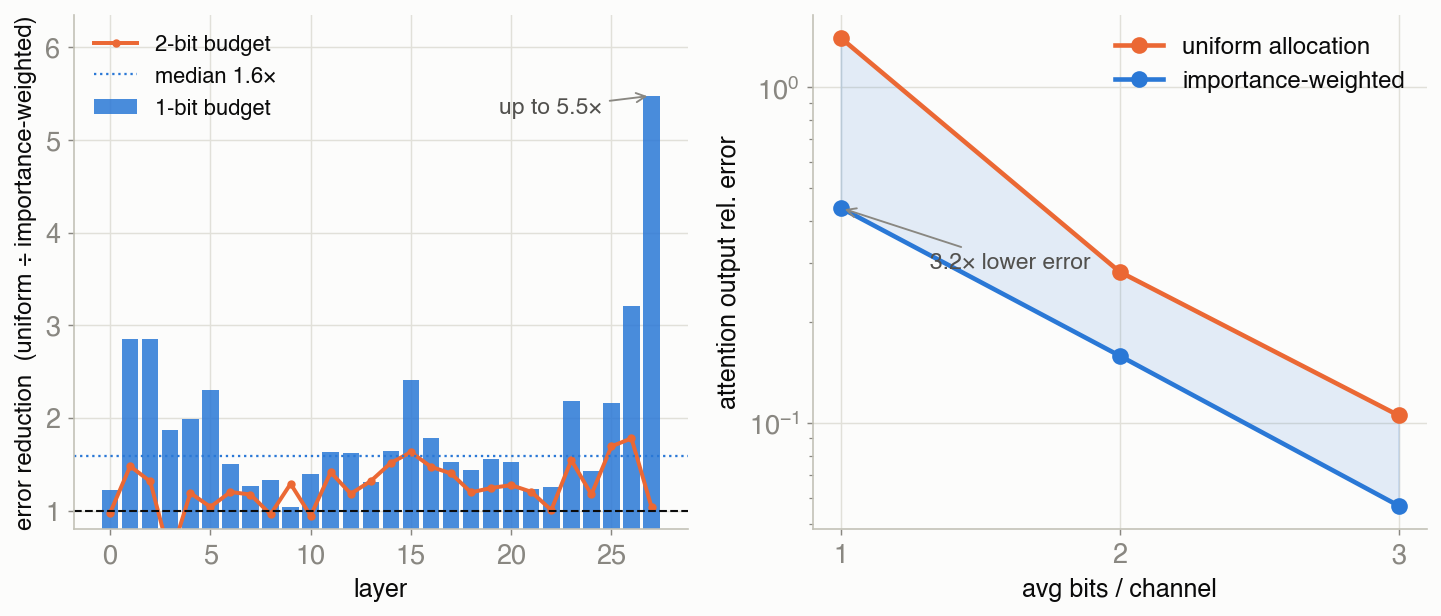
试想一下:量化决定了一个通道分配几个 bit(例如 4-bit、2-bit、1-bit),而低秩投影直接丢弃某个维度,本质上就是给该维度分配了 0-bit。因此,设定低秩维度与设定量化精度的动作,完全可以统一为单一决策:根据通道的方差贡献,连续地从多比特分配到零比特。
上图清晰地展示了这一策略的优越性。在按能量加权进行比特分配后,注意力输出的重构误差在几乎所有 Transformer 层均大幅下降,在等效 1-bit 的极端预算下,加权分配带来的误差缩减中位数达 1.6 倍,最高达到 5.5 倍。更为关键的是,这种收益在位宽充裕时(如 4-bit 以上)相对平缓,而在逼近并跌破 2-bit 的恶劣区间里最为陡峭。这直接指出了 2-bit 悬崖的本质:它不是模型无法承受高倍率压缩,而是均分比特的生硬量化策略在低位宽下撞上了信息表达的物理极限。
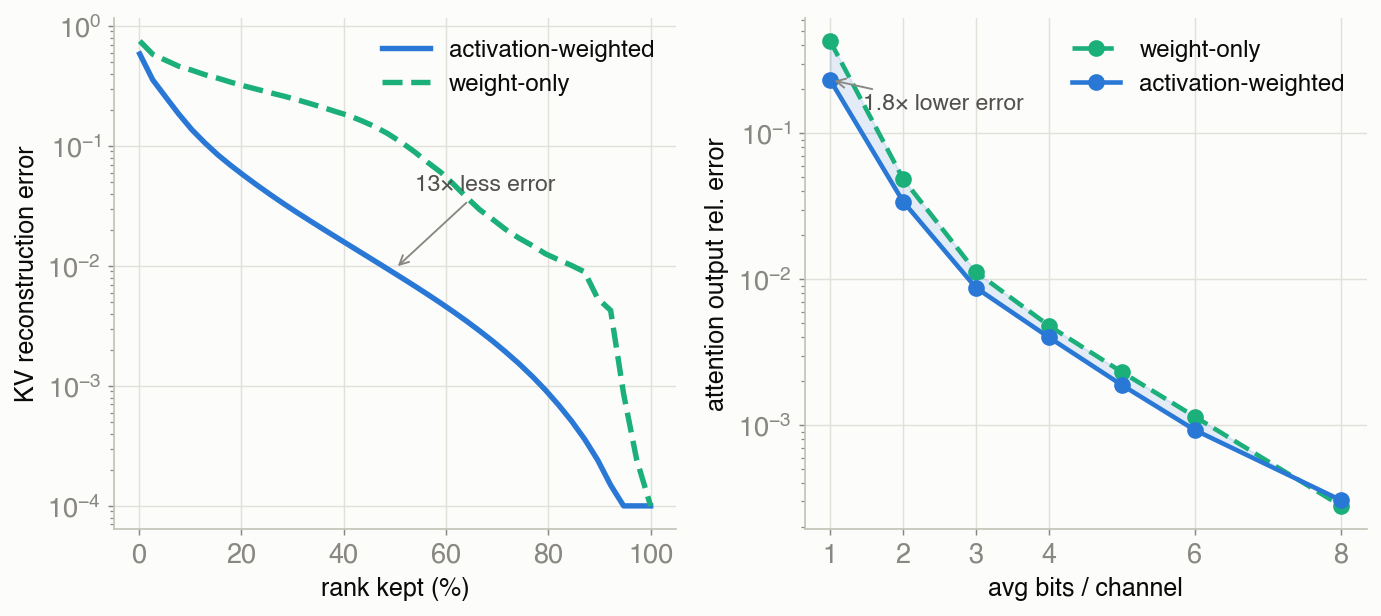
不仅如此,研究还揭示了决定通道重要性的本源究竟来自哪里。许多传统模型压缩方法习惯仅从权重矩阵 $\mathbf{W}_K$ 本身做奇异值分解(SVD),但实验证明,通道究竟重不重要,并不取决于投影权重的大小,而取决于输入激活值 $\mathbf{h}$ 如何驱动它。如图 3 所示,相比于纯权重分解,引入未中心化二阶矩 $\mathbf{G} = \mathbb{E}[\mathbf{h}^\top \mathbf{h}]$ 进行激活加权后再做分解,在保留一半秩时的重构误差直降 13 倍,在同等平均比特预算下的注意力误差降低约 1.9 倍。
SPECTRA 的核心机理:从谱变换到反向注水
基于上述三大核心洞察,SPECTRA 构建了一套极具数学美感且完全免训练的即插即用流水线。它主要由两大部分构成:基于激活加权的潜空间投影,以及基于反向注水(Reverse Water-Filling)算法的非均匀比特分配。
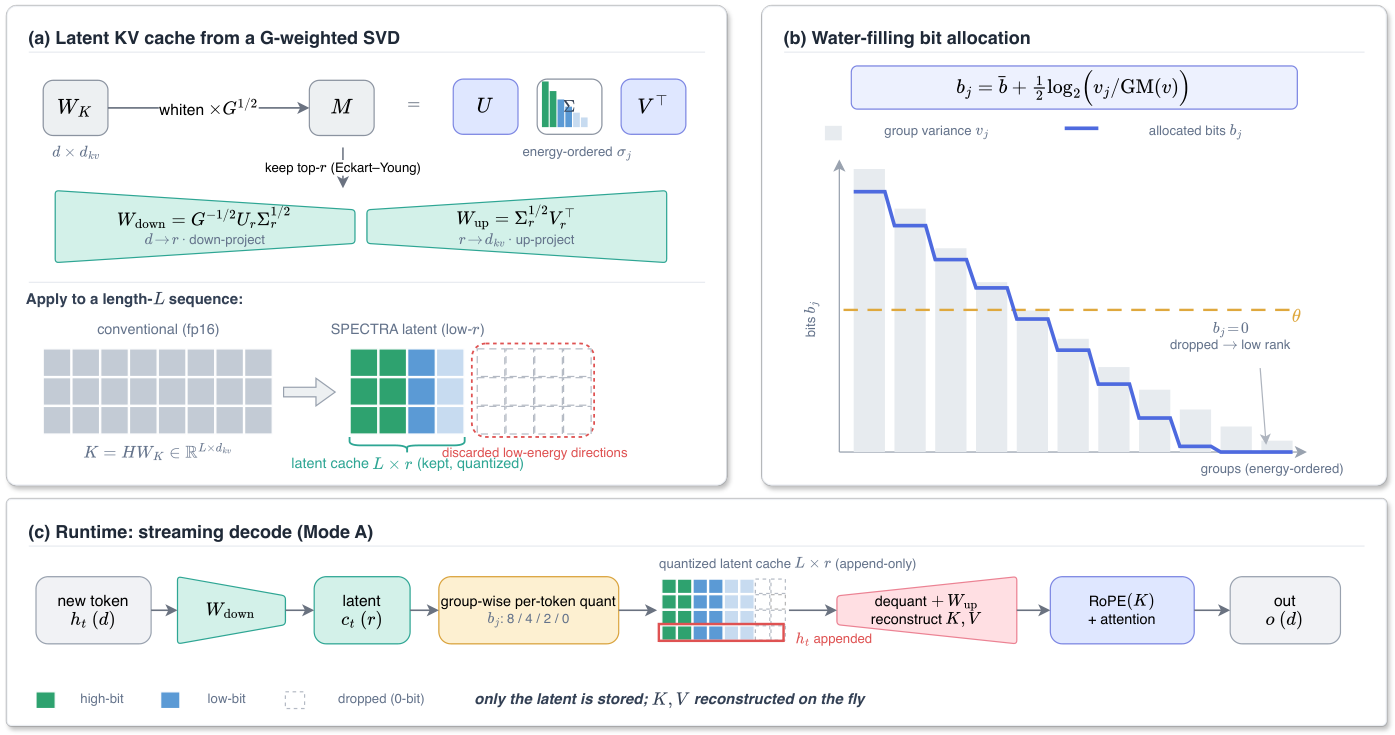
1. 激活加权谱分解($\mathbf{G}$-weighted Transform)
在常规投影中,我们希望将维度为 $d_{kv}$ 的键向量通过降维矩阵 $\mathbf{W}{\text{down}} \in \mathbb{R}^{d \times r}$ 与升维矩阵 $\mathbf{W}{\text{up}} \in \mathbb{R}^{r \times d_{kv}}$ 近似表示。但普通的 Frobenius 范数最小化将所有方向视作等同,而 SPECTRA 的优化目标是最小化在真实激活分布下的实际键向量误差:
\[\min_{\operatorname{rank} r}\ \mathbb{E}_{\mathbf{h}}\big\|\mathbf{h}\,(\mathbf{W}_{K}-\mathbf{W}_{\text{down}}\mathbf{W}_{\text{up}})\big\|^{2} = \min_{\operatorname{rank} r}\ \big\|\mathbf{G}^{1/2}\,(\mathbf{W}_{K}-\mathbf{W}_{\text{down}}\mathbf{W}_{\text{up}})\big\|_{F}^2\]通过计算白化权重矩阵 $\mathbf{M} = \mathbf{G}^{1/2}\mathbf{W}_K$ 并对其进行截断 SVD 分解($\mathbf{M} \approx \mathbf{U}_r \mathbf{\Sigma}_r \mathbf{V}_r^\top$),可以得到闭式解析解:
\[\mathbf{W}_{\text{down}}=\mathbf{G}^{-1/2}\,\mathbf{U}_{r}\,\mathbf{\Sigma}_{r}^{1/2},\qquad\mathbf{W}_{\text{up}}=\mathbf{\Sigma}_{r}^{1/2}\,\mathbf{V}_{r}^{\top}\]这一变换不仅直接丢弃了能量排名在 $r$ 之后的超低方差方向,而且投影得到的潜变量 $\mathbf{c} = \mathbf{h}\mathbf{W}_{\text{down}}$ 具有极佳的数学性质:其二阶矩矩阵 $\mathbb{E}[\mathbf{c}^\top\mathbf{c}] = \mathbf{\Sigma}_r$ 为严格降序排列的对角矩阵。所有特征完全解耦,且方差严格单调递减。
2. 率失真理论指导下的反向注水比特分配
在将特征解耦并排序后,SPECTRA 将潜坐标建模为独立的标量高斯源,其方差为 $v_j$。在经典信息论中,给定高斯变量在量化位宽为 $b_j$ 时的失真正比于 $v_j 2^{-2b_j}$。要在平均位宽 $\bar{b}$ 的硬约束下最小化总失真,其理论最优解正是反向注水算法:
\[b_{j}=\bar{b}+\tfrac{1}{2}\log_{2}\!\Big(v_{j}\,/\,\mathrm{GM}(v)\Big)\]其中 $\mathrm{GM}(v)$ 为所有保留坐标方差的几何平均值。当算法运算至尾部弱方差通道时,计算出的 $b_j$ 会自然降为负数或零,这些通道被直接置为 0-bit 丢弃。低秩截断由此以极其优雅的方式退变为量化位宽自然衰减的结果。
为了适应长序列流式推理的高效存储,SPECTRA 没有为每个坐标单独记录位宽,而是将排序后的相邻坐标划分为固定大小的组(Group),组内共享同一量化位宽,并采用针对每个 Token 的动态最大/最小标度进行极低开销的非对称量化。
在解码阶段,SPECTRA 支持两种模式:一种是在线恢复模式(Mode A),对新生成的 Token 进行下投影和分组量化后存入缓存,在自注意力计算前动态重构回全尺寸 $\mathbf{K}, \mathbf{V}$,这种方式与旋转位置编码(RoPE)完全精确对齐且无需修改注意力算子;另一种则是直接在潜空间内进行注意力运算的紧凑模式(Mode B),未来有极大的定制算子加速潜力。
实验评测:碾压 2-bit 悬崖的实际表现
为了全面验证 SPECTRA 的实力,研究团队在严格一致的基准下对 Llama-3.1-8B-Instruct、Mistral-7B-Instruct-v0.3 以及 Qwen2.5-7B-Instruct 进行了系统评测,覆盖 LongBench 综合长文本基准(8 项不同类型的长文本任务,最大长度截断至 31,500 Token)与“大海捞针”(Needle-in-a-Haystack, NIAH)多深度检索任务。对比基线涵盖了当前领域内最先进的五种方案:KIVI、TurboQuant、PolarQuant、OTT 以及 RotateKV。
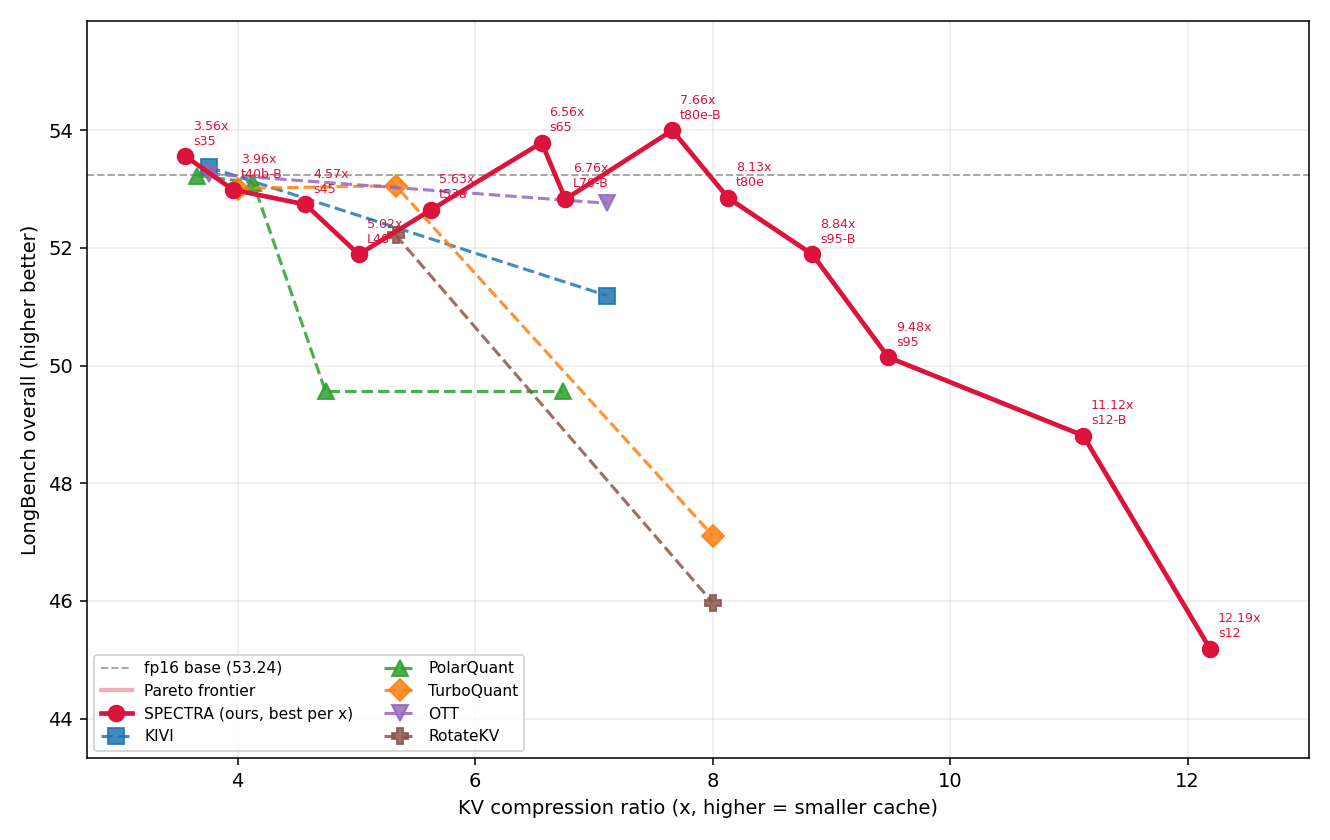
评测结果描绘出了一条极具说服力的帕累托前沿曲线:
首先,在 3.5 倍至 4 倍压缩的中等区间,SPECTRA 几乎是无损的。在 Llama-3.1-8B 上,3.56 倍压缩率下的评分为 53.56,甚至微幅超越了 Dense 全精度模型的 53.24,显著领先于同等倍率下的 KIVI 和 PolarQuant。
其次,也是最具决定性的差异,出现在 8 倍压缩率附近(对应等效约 2-bit)。在该区域,所有纯标量量化和旋转量化方法均不可避免地跌落 2-bit 悬崖:TurboQuant 的平均分从 53.24 暴跌至 47.11,RotateKV 跌至 45.97,所有现有基线在超过 8 倍压缩后均无可用结果。而 SPECTRA 表现得极为稳健,在 7.7 倍压缩下依然维持在 54.00 的高位,在 8.84 倍压缩下仍高达 51.89。
更为震撼的是,SPECTRA 将可用的压缩空间一举推向了 11 倍乃至 12 倍。在 11.12 倍的极限压缩比下,模型在 LongBench 上仍能拿到 48.80 分,依然优于跌落悬崖后的 8 倍现有基线。在单针“大海捞针”检索测试中,SPECTRA 甚至在 12 倍极限压缩下做到了 100% 检索成功率,完全规避了传统量化方法因尾部扰动造成的检索失效。
核心机制消融:为什么潜空间变换是胜负手?
SPECTRA 之所以能够在高倍压缩下避免雪崩,核心在于它跳出了“单一维度硬压”的死胡同,实现了对“保留精度”与“保留维度”的动态套利。
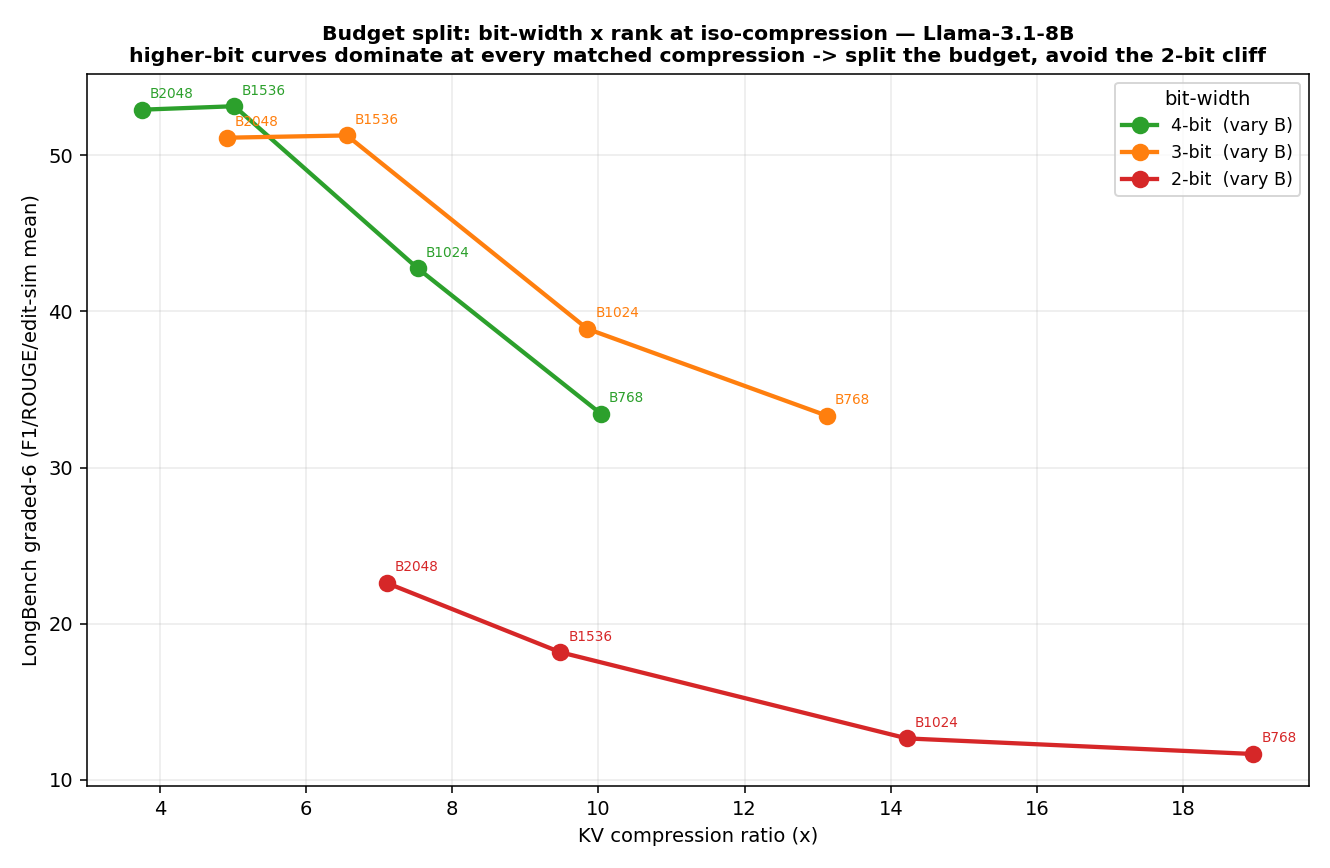
上图通过固定最终总压缩比、扫描潜变量维度与保留位宽,清晰揭示了背后的几何直觉:
在绝大多数压缩目标下,强制使用 2-bit 量化(图中黄绿色曲线)的整体表现全线落后于保持 3-bit 或 4-bit 精度(蓝线与绿线)。换言之,把有限的存储预算花在“裁剪更多不重要的低能量秩、但给高能量方向留出更高位宽(3-4 bit)”,其信息保真度远远高于“保留全部维度但粗暴下压到 2-bit”。
这正是 SPECTRA 的制胜法宝。由于在激活加权的谱基底下能量极度倾斜,SPECTRA 能够沿着图中的上包络线自由移动。在严苛的高压缩要求下,算法自动将弱通道归零,优先腾出宝贵的比特位去滋养前排核心通道,从而在整个压缩域内彻底绕开了 2-bit 悬崖这个结构性缺陷。
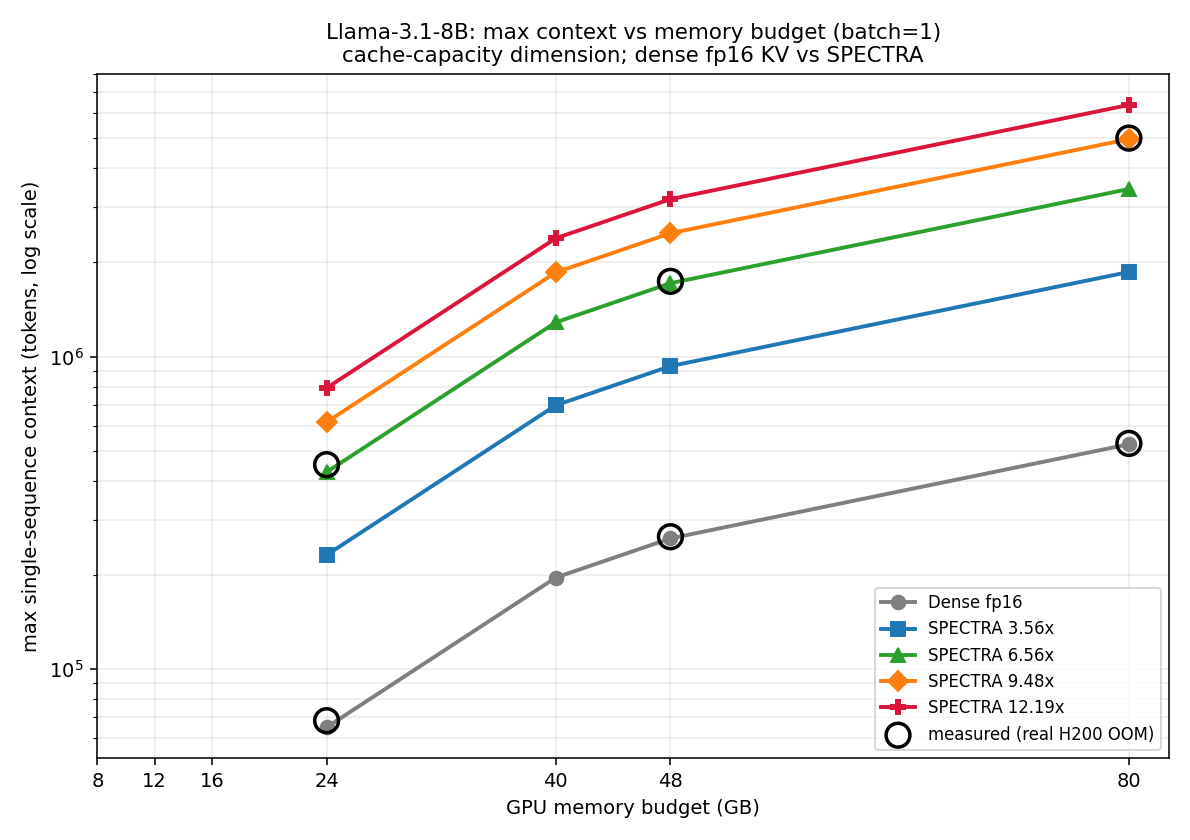
这种算法优势直接折算成了巨大的工程收益。在实际硬件容量评测中,针对消费级与数据中心常见显存规格进行的 OOM(Out Of Memory)测试表明,在 24GB 显存预算(例如单张 RTX 3090/4090 或 A10G)运行 Llama-3.1-8B 时,全精度 fp16 缓存仅能勉强支撑 6.5 万 Token 的单序列处理,而 SPECTRA 在 12 倍压缩下将最大容纳序列长度大幅推升至惊人的 79.3 万 Token。实测在 H200 上的硬件显存溢出点与理论推算吻合度在 1% 以内,证实了其显存节省的扎实度。
总结与启示
回顾 SPECTRA 的设计,它的创新之处并不仅在于又刷新了某项榜单指标,而在于给日渐陷入工程补丁化的 KV Cache 压缩领域引入了一种更具解释性的分析范式。它打破了长期以来将“低秩分解”与“模型量化”视为独立工具箱的思维定势,在信息论框架下将两者统摄为同一控制函数的两端。
对于工业界落地而言,SPECTRA 展现出了极高的实用价值:它无需耗时费力的大规模重训或指令微调,仅依赖极少量的无标注文本在几秒钟内完成激活二阶矩校准,便能即插即用嵌入现有推理引擎。尽管目前该论文仍主要利用 Mode A 验证存储容量的释放,尚未针对底层流式推理开发定制化的专用 Triton/CUDA 算子,但它已经向行业证明:大模型 KV 缓存远比我们想象的要“空旷”,2-bit 绝不是大模型推理显存优化的终点。只要坐标变换得当,用极低比特预算跑通百万级上下文,正在成为唾手可得的现实。