北航提出ToolLIFT:解耦工作流与具体API,让大模型工具规划跨工具集泛化
ToolLIFT: Lifting Tool-Specific Trajectories into Function-Level Graphs for Generalizable Tool Planning
让大语言模型(LLM)学会熟练使用工具,是通向实用型自主 Agent 的核心一环。在实际业务中,人类面对复杂的现实任务很少从零开始盲目试错,而是依赖过往类似场景中沉淀的执行路径与协作经验。然而,当前的智能体在复用工具调用轨迹(Tool-use Trajectories)时,正面临着严重的“工具绑定”困境。
ArXiv URL:https://arxiv.org/abs/2608.03468v1
主流方案往往直接在历史调用数据上构建工具级的协作图(Tool-level Graph),图上的每个节点都对应着具体的 API 接口名称,边则代表接口间的先后调用关系与数据流动。这种强耦合的设计带来了致命的泛化瓶颈:一旦真实业务场景中引入了未曾在历史数据中露面的新工具,或是需要将方案整体迁移到另一套第三方 API 体系,现有的规划图就会瞬间瘫痪。大量长尾 API 在图中如同孤岛,缺乏连接;而全新的工具更是彻底无法继承过往任何协作经验。此外,逐步贪心的局部图搜索极易陷入“近视规划”,而在多步调用之间累积的参数依赖错乱与幻觉,更让多工具协同的成功率雪上加霜。
来自北京航空航天大学的研究团队在最新论文中给出了破局思路,他们提出了名为 ToolLIFT 的通用工具规划框架。该研究的核心洞见在于:对于相似性质的复杂任务,即使底层调用的具体工具千差万别,它们在更高维度的“功能级工作流结构”上却展现出惊人的一致性。
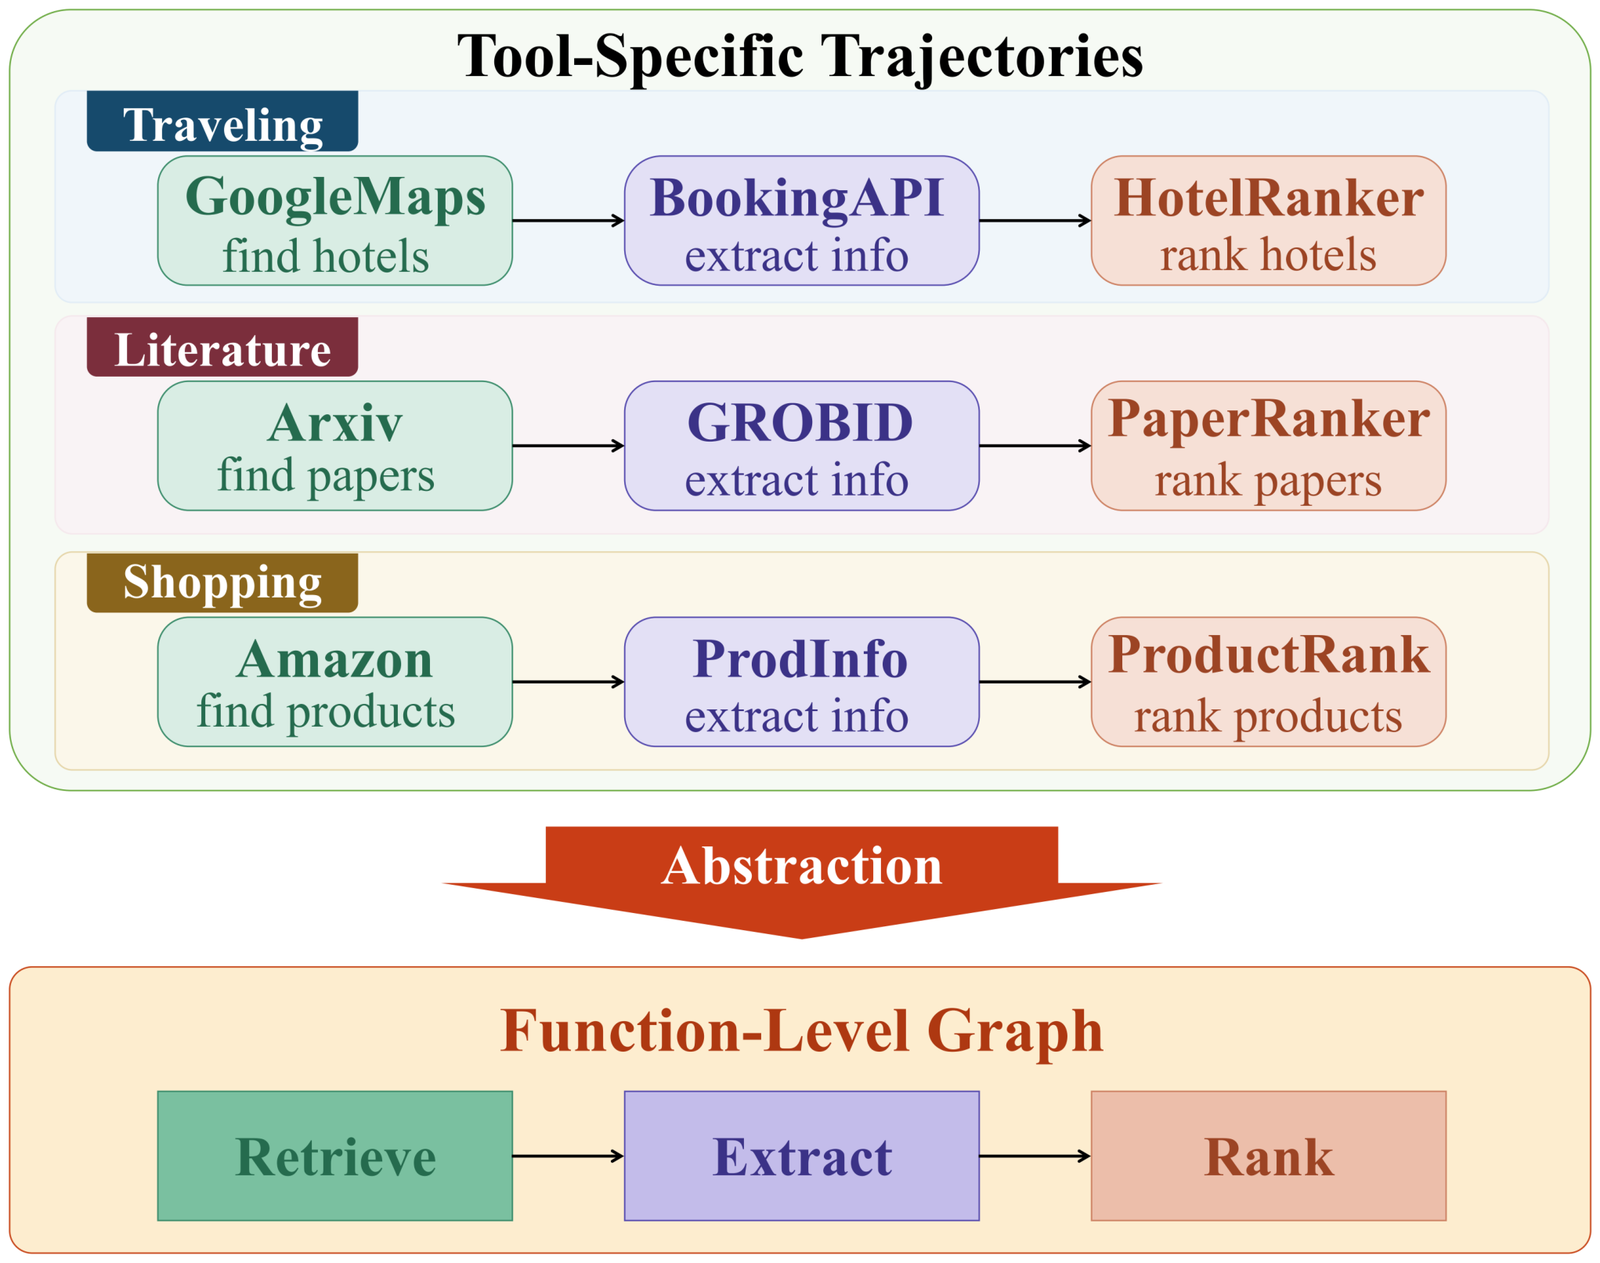
如上图所示,当分别使用工具集 A 与工具集 B 处理同类问题时,具体的 API 节点完全不同,但它们所扮演的功能角色(例如“信息检索”、“数据过滤”、“结果格式化”)及其调用顺序与依赖模式是完全镜像的。基于这一观察,ToolLIFT 提出了“轨迹升维(Trajectory Lifting)”机制,将绑定具体 API 的原始轨迹抽象为功能级工作流图(Function-Level Workflow Graph,FWG),进而实现工作流规划与具体工具选择的彻底解耦。结合强化学习对跨调用数据流的显式溯源约束,ToolLIFT 在多个分布内(ID)与分布外(OOD)基准上显著超越了现有基准方案,尤其在全新工具集的 OOD 场景下,工具规划成功率展现出了极强的迁移鲁棒性。
从 API 孤岛到抽象图:轨迹升维与冷启动继承
传统的经验复用方法之所以脆弱,本质在于把“功能(What to do)”与“工具实现(How to do it with API X)”混为一谈。如果一个智能体只学过使用特定翻译接口后接特定邮件发送接口,当面对另一套企业自建通讯录和通讯接口时,它往往需要大量的重新微调或图重构。
为了让历史协作经验突破具体工具标识符的束缚,ToolLIFT 在第一步构建了 FWG。这一过程依赖于系统性的“工具到功能升维”。如果直接使用 API 的完整技术文档(Schema)提取语义嵌入,模型往往会被各家工具独特的领域特征所干扰,例如把金融报表 API 与天气查询 API 判定为相距甚远,却忽略了它们都属于“数据结构化拉取”这一核心功能。
为此,框架先借助大语言模型将每个工具的技术规范解耦为两部分描述:纯粹的功能抽象描述 $d_t^{\mathrm{func}}$ 与领域特异描述 $d_t^{\mathrm{dom}}$。系统仅对功能描述 $d_t^{\mathrm{func}}$ 进行特征提取与向量编码,并通过 UMAP 降维聚类,形成 $L$ 个抽象功能簇 $\mathcal{C} = {c_1, \ldots, c_L}$。这就建立了一个稳定的工具向功能映射函数 $\phi: \mathcal{T} \rightarrow \mathcal{C}$。
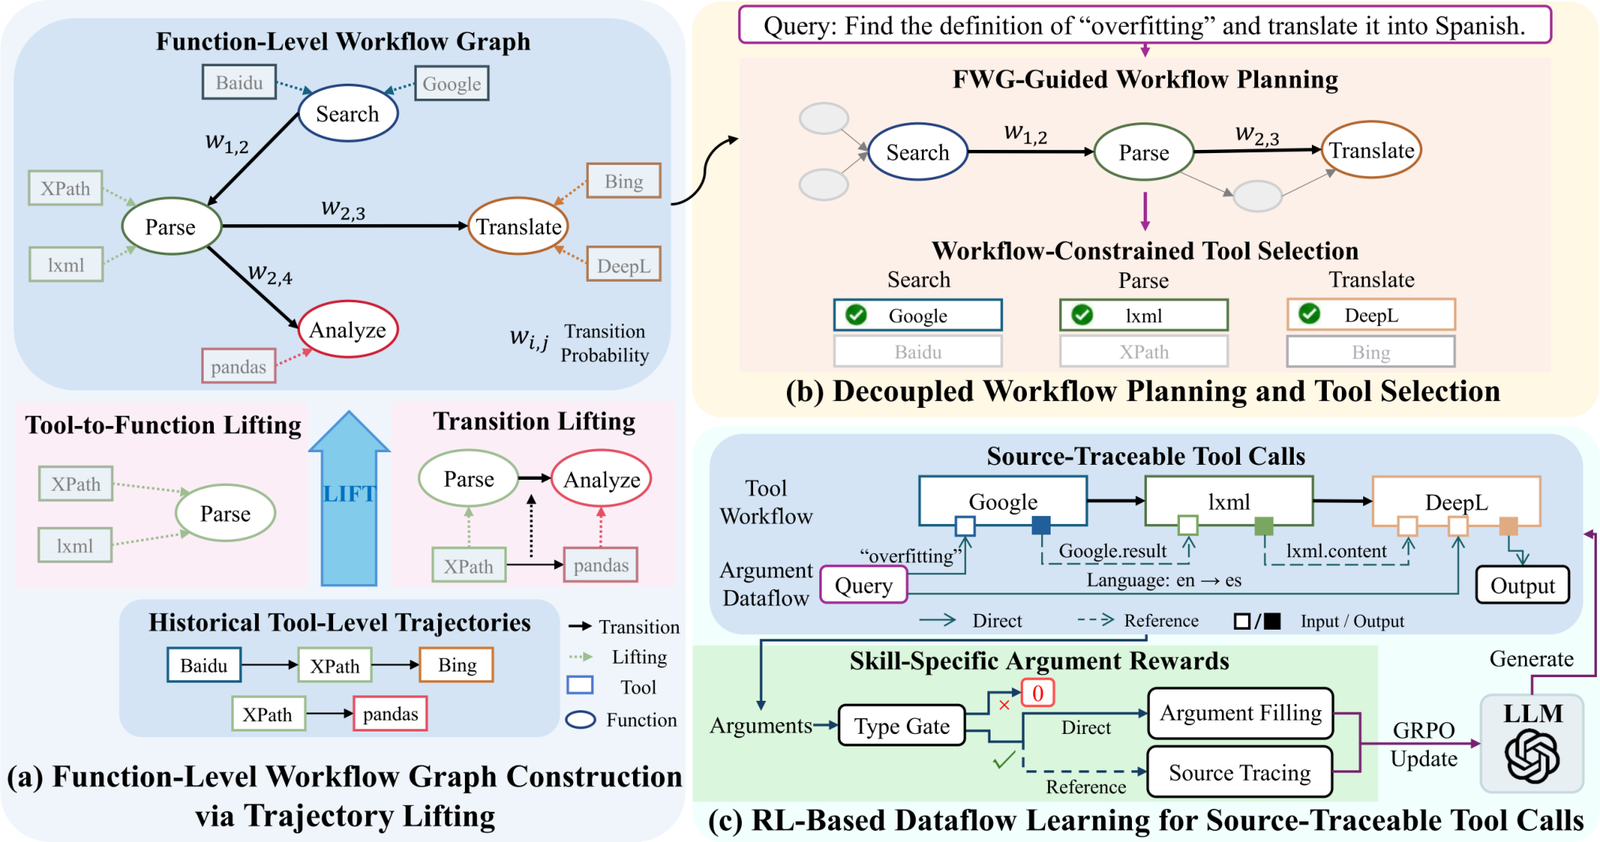
有了这个映射,原本由具体工具构成的历史调用轨迹 $\mathcal{W}t^{(m)} = (t_1^{(m)}, \ldots, t{K_m}^{(m)})$ 便被无损升维为功能序列 $\mathcal{W}c^{(m)} = (c_1^{(m)}, \ldots, c{K_m}^{(m)})$。框架在此基础上聚合所有历史轨迹中相邻功能节点的转移频次,归一化计算出加权边,最终生成了统一的功能级工作流图 $\mathcal{G}_{\text{fwg}}$。
这种设计巧妙地解决了新工具的冷启动问题(Cold-Start Transition Inheritance)。当系统接入一个从未见过的全新工具 $t_{\mathrm{new}}$ 时,不需要任何历史调用记录,只需提取其功能描述,计算其与各功能簇中心的欧氏距离,即可瞬间将其归类到既有的功能簇中:
\[\phi(t_{\text{new}}) = \arg\min_{c \in \mathcal{C}} \|\tilde{\mathbf{e}}_{t_{\text{new}}} - \boldsymbol{\mu}_c\|_2\]新工具因此直接继承了该功能节点在历史沉淀下来的全局转移模式,彻底告别了“零记录即孤岛”的尴尬境地。
全局优先与逐层具象:解耦规划如何克服局部近视
在拥有了功能级工作流图之后,智能体该如何制定调用计划?以往的图规划方法通常采用单步走查策略(Stepwise Traversal),智能体在图上每走一步,就立刻敲定一个具体的 API 及其参数。然而在多步复杂调用中,这种局部贪心策略极易造成“步步合法、全局崩溃”的近视错误。
ToolLIFT 采取了“分而治之”的双层解耦策略:先在全局尺度上敲定功能骨架,再在局部空间中落实具体工具。
首先是 FWG 引导下的工作流宏观规划。面对用户的输入请求 $q$ 和候选工具池 $\mathcal{T}q$,系统先将候选工具投影为功能子集,并从庞大的全域工作流图中诱导出局部的功能子图 $\mathcal{G}_q$。将该子图的拓扑转移概率文本化输入给规划器,规划器并不去进行费时的逐步搜索,而是站在宏观视角,直接一次性生成完整的功能级工作流序列 $\mathcal{W}_c = (c{\sigma(1)}, \ldots, c_{\sigma(K)})$。
这一步的核心难点在于评估指标。在复杂的现实任务中,许多工具调用是彼此独立的,拓扑排序并不唯一,机械地要求模型按照标准答案的调用顺序对齐会导致不合理的惩罚。ToolLIFT 提出了针对多重集(Multiset)重叠度的功能覆盖奖励函数 $R_{\mathrm{func}}^{(1)}$,通过计算预测功能集合与真实功能集合的最大匹配与 Jaccard 系数,给予模型平滑而富有信息量的反馈,既宽容了合理的并行重排,又严格约束了核心功能模块的完整性。
紧接着是 工作流约束下的工具实例化与参数绑定。当宏观功能骨架固定后,工具生成器(Tool-Call Generator)接收到的搜索空间已经被功能约束强行收窄。针对序列中的第 $k$ 步功能 $c_{\sigma(k)}$,生成器只需在属于该功能簇的候选工具中挑选最契合当前语境的实体 API。这种层级收敛极大减少了工具混淆与参数错位,确保局部的微观选择时刻锚定在全局工作流主干上。
显式溯源与两阶段强化学习:让数据流拒绝参数幻觉
即使工具序列完全正确,智能体调用常常仍会因参数传递错误而溃败。随着多步调用在上下文中不断展开,中间输出迅速堆积,LLM 极难分清某个参数值究竟应该直接从用户提问中提取,还是必须引用上一步某个工具的具体返回字段。在传统生成模式下,模型常常产生微妙的幻觉,用看似合理但未经执行生成的“伪真值”填入后续 API。
ToolLIFT 将参数赋值明确分为两类互斥模式:
-
直接取值(Direct Value):直接从当前上下文与用户指令中抽取的固定实体信息。
-
引用取值(Reference Value):明确指向前置步骤调用 $p_j$($j < k$)输出结果的指针引用。
这种前置依赖约束不仅在形式上锁定了数据流拓扑,更让数据流变得可审计、可溯源。为了让模型熟练掌握这种溯源机制,研究团队采用了基于 GRPO(Group Relative Policy Optimization)的两阶段强化学习训练流程。
在优化目标中,团队设计了精巧的门控与技能特异性奖励函数(Source-Gated and Skill-Specific Rewards)。系统首先设立类型门(Source-Type Gate):一旦模型将“引用型参数”误判为“直接文本输入”,或者反之,奖励直接置零。只有在来源类型预测正确的前提下,模型才会根据参数类型获得差异化评分:
\[r_{\mathrm{val}}(\hat{v}, v^*) = \begin{cases} 0, & \tau(\hat{v}) \neq \tau(v^*), \\ \mathds{1}[\hat{v} = v^*], & \tau(v^*) = \mathrm{reference}, \\ \mathrm{ROUGE\text{-}L}_{\mathrm{F1}}(\hat{v}, v^*), & \tau(v^*) = \mathrm{direct}. \end{cases}\]对于直接取值,系统宽容文本表述的微小差异,采用连续的 ROUGE-L F1 计算软匹配得分;而对于引用类型,指针位置必须精确无误,要求绝对匹配。这种奖惩机制迫使模型不仅要“猜出可能的值”,更要“搞清楚信息的源头”。
为了防止工具生成器过度依赖完美的宏观工作流而丧失容错能力,研究人员还在训练过程中引入了 工作流扰动机制(Workflow Perturbation)。在训练生成器时,系统有 $\epsilon_{\mathrm{pert}} = 0.2$ 的概率随机篡改、替换或插入功能骨架,迫使生成器学会在宏观骨架出现轻微偏差时,结合原始 Query 的意图进行自我纠偏,避免推理时出现灾难性的误差单向传播。
评测结果与深层剖析:分布外迁移的显著突破
研究人员在两个分布内(ID)数据集——HuggingFace(模型编排)与 Multimedia(多媒体处理),以及三个完全由未见过的工具集构成的分布外(OOD)基准——DailyLifeAPIs(日常生活场景)、Seal-Tools(多层嵌套调用)和 ToolAlpaca(模拟真实 API)上对 ToolLIFT 进行了全面评测。测试底座涵盖了 Qwen2.5-7B-Instruct 与 Llama-3.1-8B-Instruct 两种开源模型,对比方案包括 Tool-Planner、ToolNet、GTool、DFSDT 以及依赖细粒度强化学习奖励的 ToolRL。
在整体准确率(Acc)、节点预测 F1 值($n$-F1)和调用依赖连边 F1 值($l$-F1)上,ToolLIFT 展现出压倒性的综合优势。
在分布内评测中,ToolLIFT 在 HuggingFace 和 Multimedia 上分别较最强基线取得了 1.37 和 1.50 个百分点的整体准确率提升,说明功能级图结构并没有因过度抽象而牺牲细粒度规划的精度。
更引人注目的是分布外(OOD)环境下的泛化表现。在工具集完全未见的情况下,以 Llama-3.1-8B 为基座时,ToolLIFT 在 DailyLifeAPIs、Seal-Tools 和 ToolAlpaca 上分别超越了最强基线 4.69、3.22 和 4.90 个百分点。在多层复杂嵌套的 Seal-Tools 上,这种优势尤为难得。对比基线在 OOD 场景下的断崖式下跌,ToolLIFT 凭借在功能簇维度的“知识继承”,维持了惊人的规划稳定性。
为进一步验证框架各项设计的理论有效性,论文开展了深度的消融与机理分析。
首先是跨工具经验共享的实际效果。研究人员根据测试样本中工具在训练集中出现的最低频次,将测试用例划分为罕见工具组(Rare,前 20%)、中等频次组(Moderate,中间 60%)和高频工具组(Frequent,后 20%)。
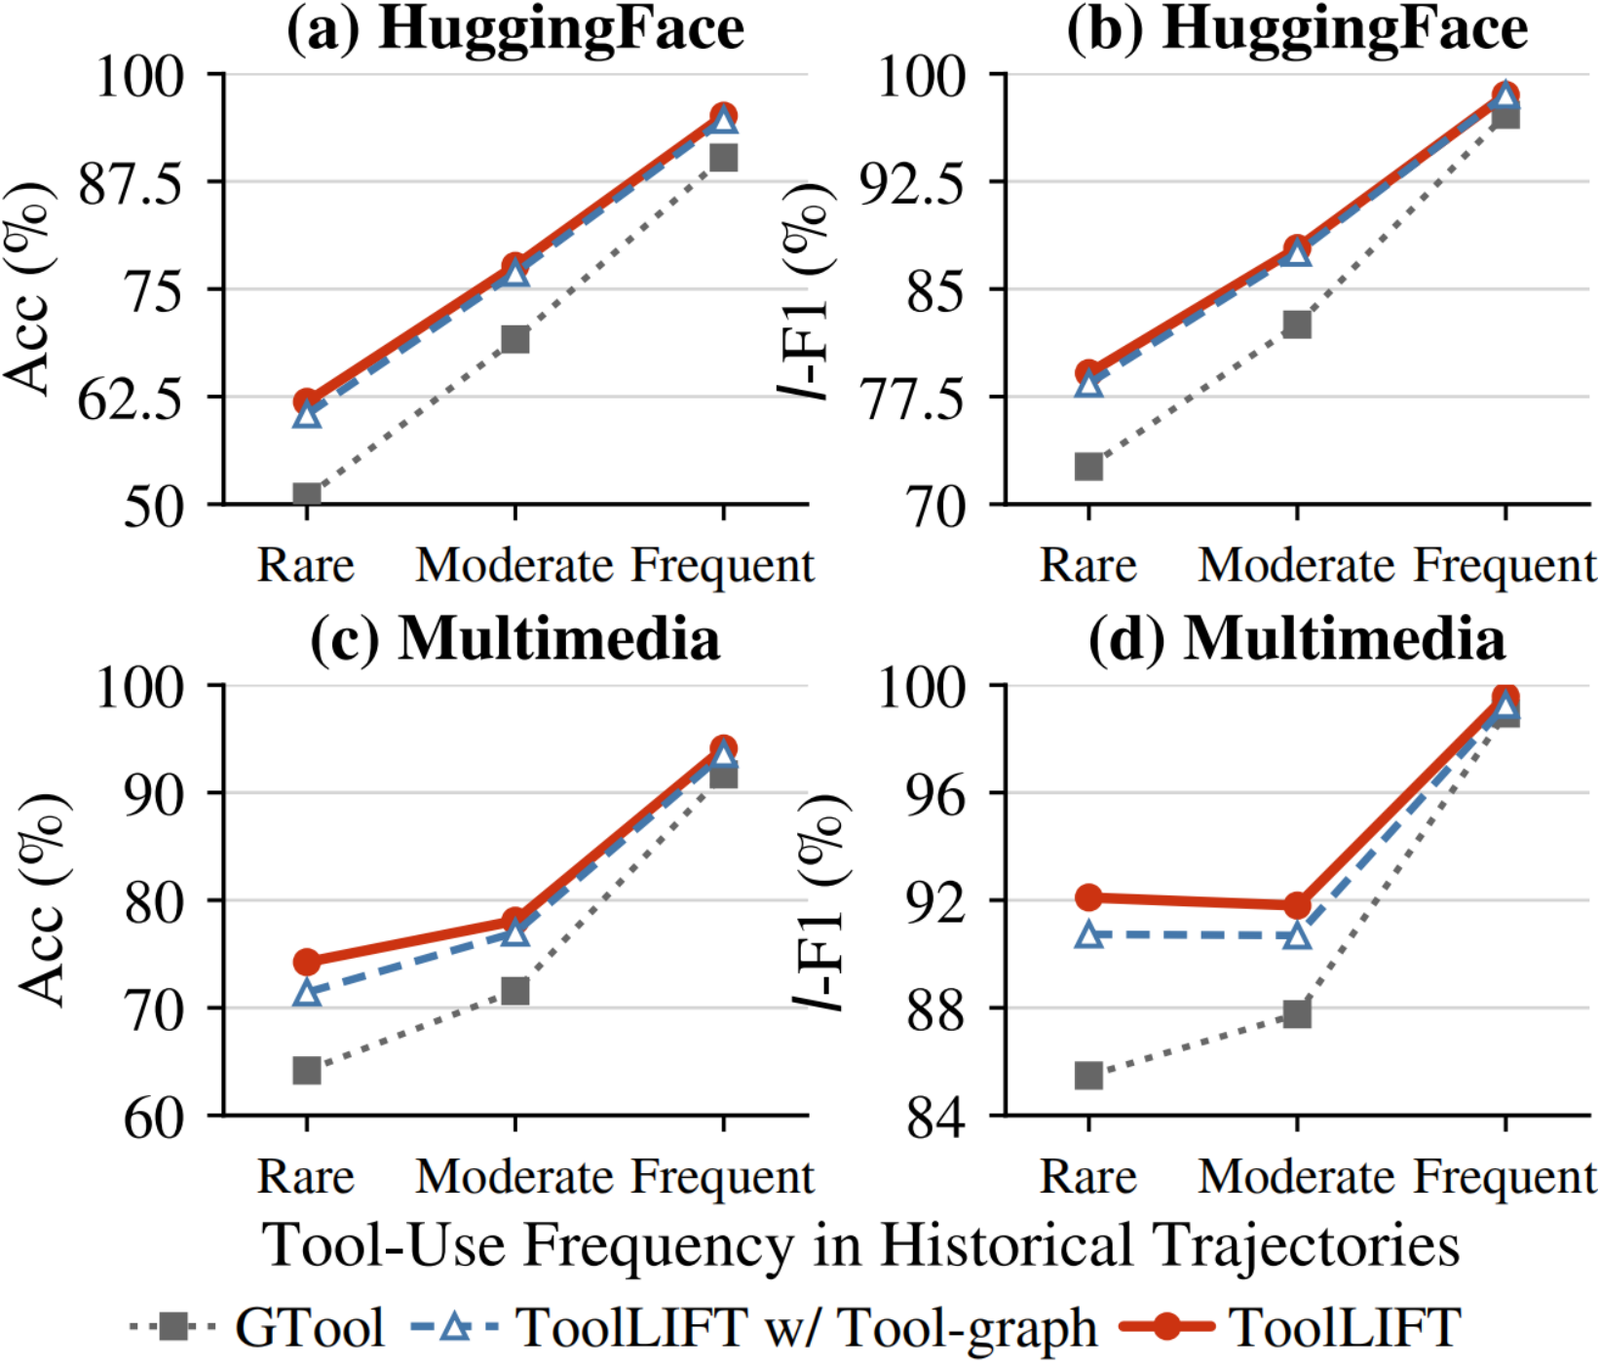
对比 ToolLIFT、退化至工具层级的图规划变体(Tool-Graph Variant)以及经典图基线 GTool,数据清晰表明:对于历史样本丰富的频繁调用工具,各方案的性能差距并不大;但随着工具曝光频次急剧降低进入“罕见区间”,基于具体工具图的方案性能断崖式下跌。而 ToolLIFT 无论在哪个频次区间都保持了高位平稳的准确率。这证明了功能级工作流图 FWG 确实成功将“群体智慧”转移给了长尾与冷启动 API。
不仅如此,在参数数据流的追踪方面,ToolLIFT 引入的显式溯源门控奖励发挥了决定性作用。相比未对参数来源进行显式区分的基准方案,ToolLIFT 在各项基准上的溯源错误率(Source Error Rate, SER)均大幅下挫,有效杜绝了多步交互中的上下文幻觉传递。
总结与展望
ToolLIFT 给出了一种不同于以往“暴力微调”或“机械图搜索”的工具调用范式。它告诉我们,在构建工具型智能体时,经验的复用不应停留在 API 签名的表象上,而应当沉淀在更通用的业务逻辑与功能骨架之中。
通过“轨迹升维构建功能图”、“全局工作流与具体工具选择解耦”以及“强化学习驱动的显式数据流溯源”三部曲,ToolLIFT 成功让大语言模型掌握了跨工具集迁移的深层协作模式。这一框架对于企业级 Agent 的落地极具参考价值:在企业 IT 架构频繁迭代、内外部 API 经常更换的现实世界中,只有把业务工作流的经验与具体实现的接口清晰剥离,才能打造出真正具备强鲁棒性、高泛化能力的通用智能体。