BinaryPC:无需训练的二值主成分哈希,长文本解码吞吐提升3.56倍
Training-Free Hashing-Based Attention via Binary Principal Components
在长文本大语言模型的实际落地中,推理阶段的“Prefill(预填)快、Decoding(解码)慢”已经成为工程部署的核心痛点。预填阶段具有高度的并行性,能够充分吃满 GPU 的计算单元;但一旦进入逐 Token 生成的自回归解码阶段,显卡便不得不为了计算单个 Token 的注意力,在显存与计算核心之间反复搬运体量庞大且持续膨胀的 Key-Value(KV)缓存。这种严重的内存带宽受限(Memory-Bound)特性,直接导致硬件算力利用率大幅跌落。
ArXiv URL:https://arxiv.org/abs/2608.04405v1
为了打破长上下文解码的效率瓶颈,学术界与工业界的主流解法之一是稀疏注意力(Sparse Attention)。既然大部分上下文对当前生成的贡献微乎其微,只要在每一步生成时挑出最关键的少量 KV 对即可。然而,现有的稀疏化方案往往陷入两难:启发式的粗粒度分块(如按 Page 筛选)容易遭遇块内碎片化,误伤细粒度关键信息;基于局部敏感哈希(LSH,如 MagicPIG)的方法依赖与数据分布无关的随机投影,必须采用极长的哈希编码才能勉强维持精度;而引入非线性映射的学习型哈希(如 Spotlight)虽然精度较高,却需要针对每个模型版本进行昂贵且繁琐的前置训练与校准。
来自腾讯、厦门大学以及中俄数字经济研究中心的研究团队提出了名为 BinaryPC 的全新注意力方案。该方案放弃了“数据无关的随机投影”与“黑盒梯度训练”这两条旧路线,巧妙借助矩阵的二值主成分(Binary Principal Components),在无须任何梯度训练的前提下,直接从数据自身提取几何结构。实验表明,BinaryPC 仅需 64 位的紧凑哈希编码与 2% 的注意力预算,即可逼近甚至匹敌全精度 Full Attention 的表现,在现代 GPU 上将端到端解码吞吐提升高达 3.56 倍,在极端场景下更是实现了超过 5 倍的加速。
困局:为什么现有哈希注意力总在精度与开销间挣扎?
在大模型长上下文注意力中引入哈希,核心逻辑非常直观:全精度向量内积 $\mathbf{q}\mathbf{k}^\top$ 的计算与传输成本太高,若能将高维浮点向量 $\mathbf{q}$ 与 $\mathbf{k}$ 映射为紧凑的二进制比特串 $\mathbf{h}_q$ 与 $\mathbf{h}_k$,使得汉明距离或位运算能够近似反映原空间的内积大小,即:
\[\mathbf{h}_{q}\mathbf{h}_{k}^{\top}\sim\mathbf{q}\mathbf{k}^{\top}\]系统就能在极低显存搬运与极速位运算(Bitwise Operations)的辅助下,快速完成 Top-$k$ 关键 Token 的初筛,最后仅对极少数选中的 KV 对执行高精度的注意力计算。
理论很美好,但构建这个哈希函数的代价往往难以承受。以往的研究路径大致可以分为两类:
第一类是基于传统局部敏感哈希(LSH)的方案,典型代表如 MagicPIG。这类方法采用与数据无关的随机超平面(Random Projections)对特征空间进行切分。由于完全忽视了大模型内部隐层表征的高度各向异性(Anisotropy)和低维流形特征,随机切分产生的空间划分极其低效。在长文本压测任务(如 RULER 的大海捞针多值检索任务)中,随着上下文长度扩展到 128K,MagicPIG 与真实 Oracle Top-$k$ 之间的检索准确率差距拉大到了 6.5 个百分点。为了弥补这种结构错配带来的精度损失,系统被迫拉长哈希编码长度,进而侵蚀了原本依靠位运算换来的效率优势。
第二类则是以 Spotlight 为代表的“学习型哈希”。它们通过引入小型神经网络在模型表征上进行监督或自监督训练,强制学习出适配该模型隐空间的非线性映射。尽管结构对齐问题迎刃而解,但其工程落地成本陡增:每一次底座模型微调、版本迭代甚至尺寸切换,都需要重新收集校准数据并执行梯度优化流程,通用性与易用性大打折扣。
这正是 BinaryPC 切入的核心问题:能否在完全不需要梯度训练(Training-Free)的前提下,让哈希超平面自发对齐当前激活值的几何分布?
核心机制:以最小重构误差逼近二值主成分
BinaryPC 的破局点在于将哈希编码与投影平面的构建,重构为一个经典的低秩矩阵逼近问题,但将其约束在离散二值空间中。
给定解码时需要检索的键向量矩阵 $\mathbf{K}$,BinaryPC 的目标不是随意拉几道随机超平面,而是寻找一组紧凑的二值哈希码 $\mathbf{H}$ 以及对应的浮点解构投影矩阵 $\mathbf{P}$,使得重构误差最小化:
\[\min_{\mathbf{H},\mathbf{P}}\left\|\mathbf{K}-\mathbf{H}\mathbf{P}\right\|_{F}\]在这里,二值码 $\mathbf{H} \in {-1, +1}^{N \times d_b}$ 的每一行对应一个 Token 的比特指纹,而投影矩阵 $\mathbf{P}$ 则承载了解析这套指纹的主成分基底。当该重构误差被有效压缩时,解码端针对当前 Query $\mathbf{q}$ 的注意力检索,就能通过代数恒等变换转化为低开销的形式:
\[(\mathbf{q}\mathbf{P}^{\top})\mathbf{h}^{\top} = \mathbf{q}(\mathbf{h}\mathbf{P})^{\top} \approx \mathbf{q}\mathbf{k}^{\top}\]这一转换的工程意义非凡:在每一步解码开始时,由于当前步的 Query 向量维度极小,计算 $\mathbf{q}\mathbf{P}^\top$ 仅是一次轻量的向量-矩阵乘法,瞬时即可完成;而后续遍历数万甚至数百万上下文 Token 的过程,则完全退化为 $\mathbf{q}\mathbf{P}^\top$ 与海量离散二值码 $\mathbf{h}$ 之间的快速点乘,其在现代硬件上可以完全由极致优化的位并行指令(如 popcount)承载。
为了摆脱耗时的梯度优化,研究团队推导了一套无需训练的逐位贪心求解算法。在确定第 $i$ 个哈希位时,算法先从当前的残差矩阵 $\mathbf{R}$ 出发,通过迭代的幂法思路获取其连续域的主方向向量 $\mathbf{v}^*$:
\[\mathbf{u} = (\mathbf{R}\mathbf{R}^{\top})^{n}\mathbf{R}{\mathbf{v}^{\ast}}^{\top}\]随后迅速执行硬符号量化提取离散特征:
\[\mathbf{u} = \text{sign}(\mathbf{R}{\mathbf{v}^{\ast}}^{\top})\]一旦二值码的对应列 $\mathbf{u}$ 锁定,通过简单的最小二乘闭式解,即可同步更新投影矩阵中对应的基向量 $\mathbf{v}$:
\[\mathbf{v} = \mathbf{u}\mathbf{R}/N\]整个过程没有反向传播,不需要反向求导器介入,仅仅包含少量的矩阵连乘与符号截断,可以在 Prefill 阶段结束时以极低延迟一次性在线完成,亦或通过少量离线语料预先标定好投影矩阵 $\mathbf{P}$。最终,BinaryPC 仅凭 64 位的哈希长度,就构建出了高度保真的空间划分体系——其编码长度比 MagicPIG 缩短了 10 倍以上,也仅为 Spotlight 的一半。
安全气囊机制:如何兜住“难被哈希”的离群 Token?
即使主成分能够覆盖高维数据绝大多数的方差分布,但在自然语言大模型的自注意力激活中,普遍存在一种令稀疏算法头疼的极端现象:“孤立点(Outliers)”与“重度击中者(Heavy Hitters)”。
例如在 Needle-in-a-Haystack(大海捞针)类任务中,关键事实(Passkey)可能与通篇的上下文语境毫无语义重合。在数学层面上,这种键向量会表现为严重偏离主成分流形的离群点。由于二值主成分必然优先照顾占据方差大头的群体分布,这些孤立的特征往往无法被紧凑的 64 位哈希码充分表达,导致哈希重构残差偏大,从而在 Query 检索阶段被无情漏检。
针对这一理论缺陷,BinaryPC 没有选择盲目加大哈希码长度,而是提出了极具工程洞察力的“误差感知保障机制”(Error-Aware Safeguard,简称 EAS)。
因为 BinaryPC 本身就是基于显式重构误差驱动的,每个 Token 在被哈希编码后,其重构损失是自带的且显式可求的:
\[\text{Error} = \|\mathbf{k} - \mathbf{h}\mathbf{P}\|_{2}\]在解码启动前,系统不仅保存了哈希码,还会顺手计算并记录每个 Token 的重构误差。凡是残差极高、属于“即便用尽哈希位也画不清楚”的硬骨头 Token,系统会将其划入常驻白名单集合 $\mathcal{S}_{\text{err}}$。最终参与真实精确注意力计算的候选集由两部分动态并集而成:
\[\mathcal{S}_{\text{attn}} = \mathcal{S}_{\text{hash}} \cup \mathcal{S}_{\text{err}}\]这一机制好比给纯数学检索装上了“安全气囊”:大部分常规 Token 靠高效的 64 位哈希检索搞定,而由于极度离群导致哈希失真的关键 Token 则被 EAS 规则硬性保全。实验证明,这个设计彻底化解了长文本检索中经典“丢针”的致命隐患。
实验印证:跨尺度评估与精准的大海捞针表现
为了验证 BinaryPC 的泛化能力与实际检索保真度,研究团队在涵盖 Llama-3-8B、Llama-3.1-8B-Instruct、Mistral-7B-Instruct-v0.3 以及 Qwen2.5-7B-Instruct-1M 的多个主流模型上进行了多维度评测。基准涵盖短上下文推理(GSM8K、MMLU)、中长文本理解(LongBench)以及超长文本基准(InfiniteBench、LongBench v2、RULER)。
在极度考验长程单点记忆定位的 Needle-In-A-Haystack(NIAH)测试中,BinaryPC 展现出了近乎完美的检索能力。
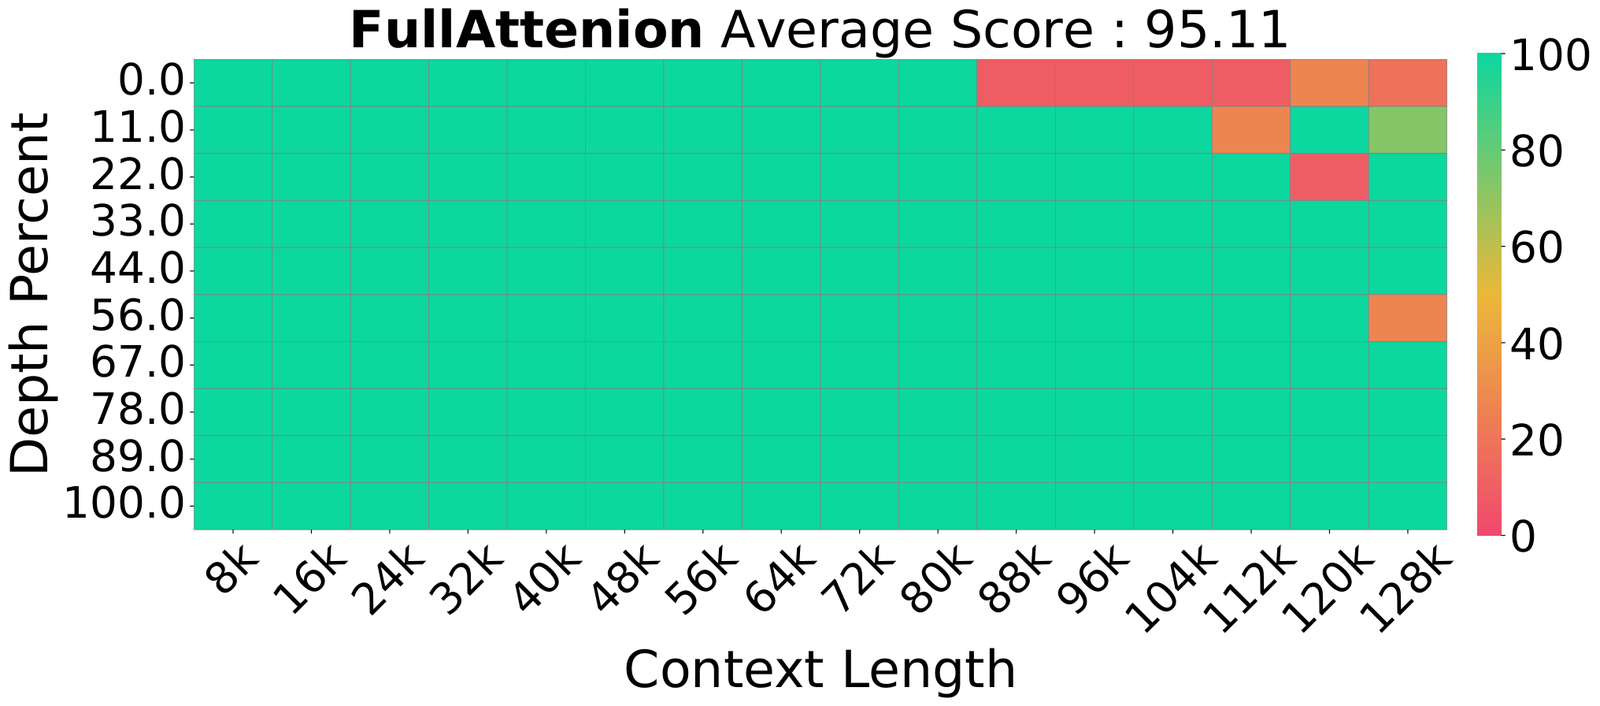
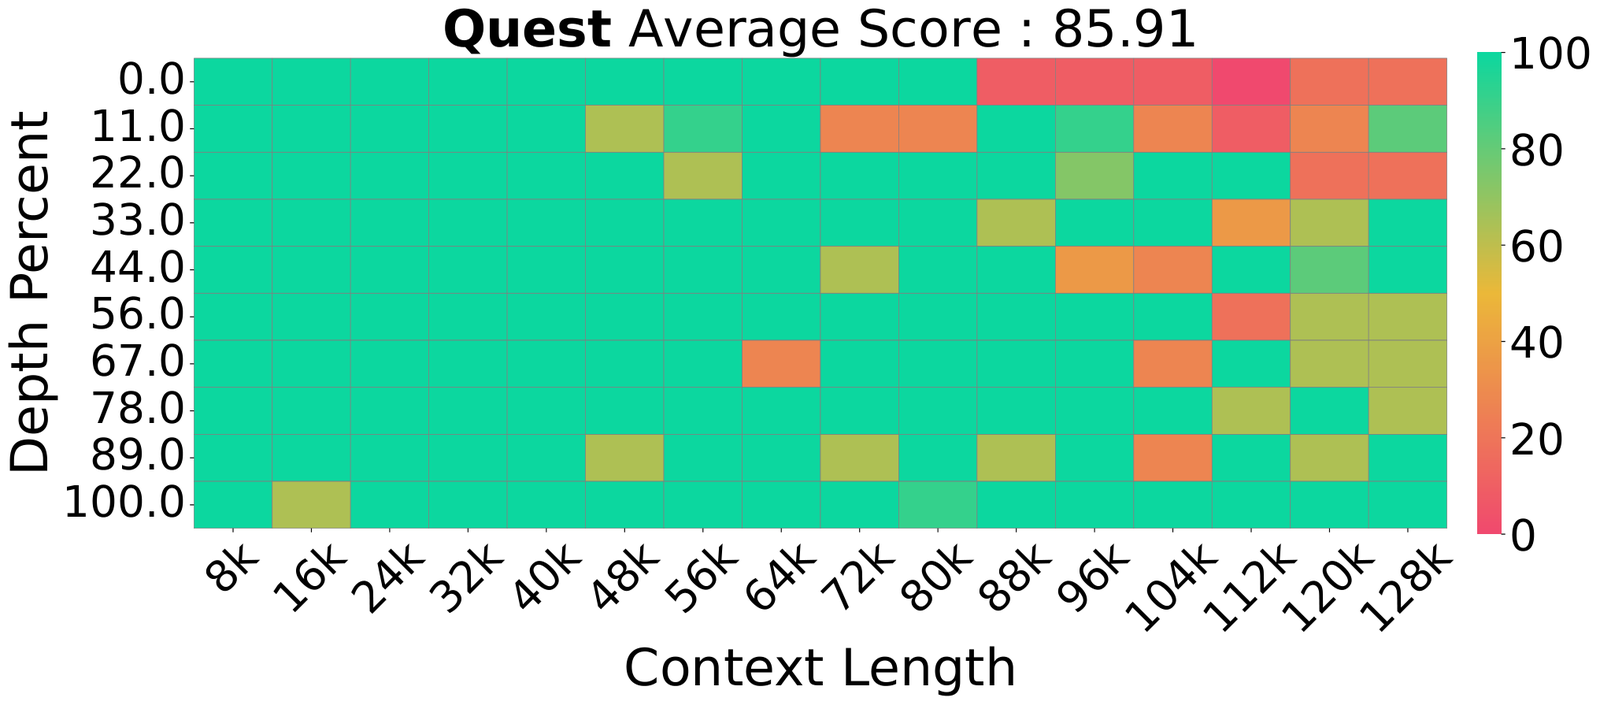
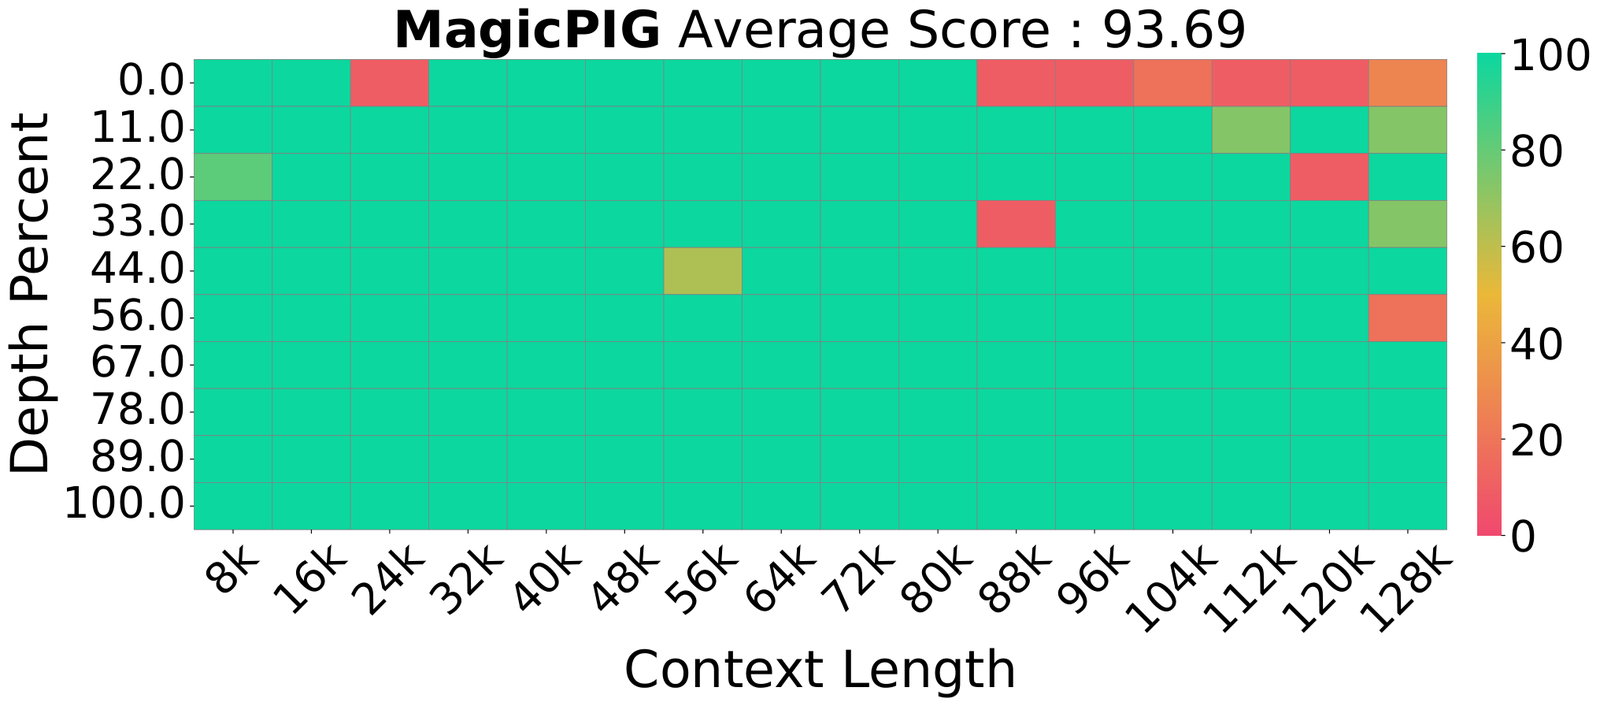
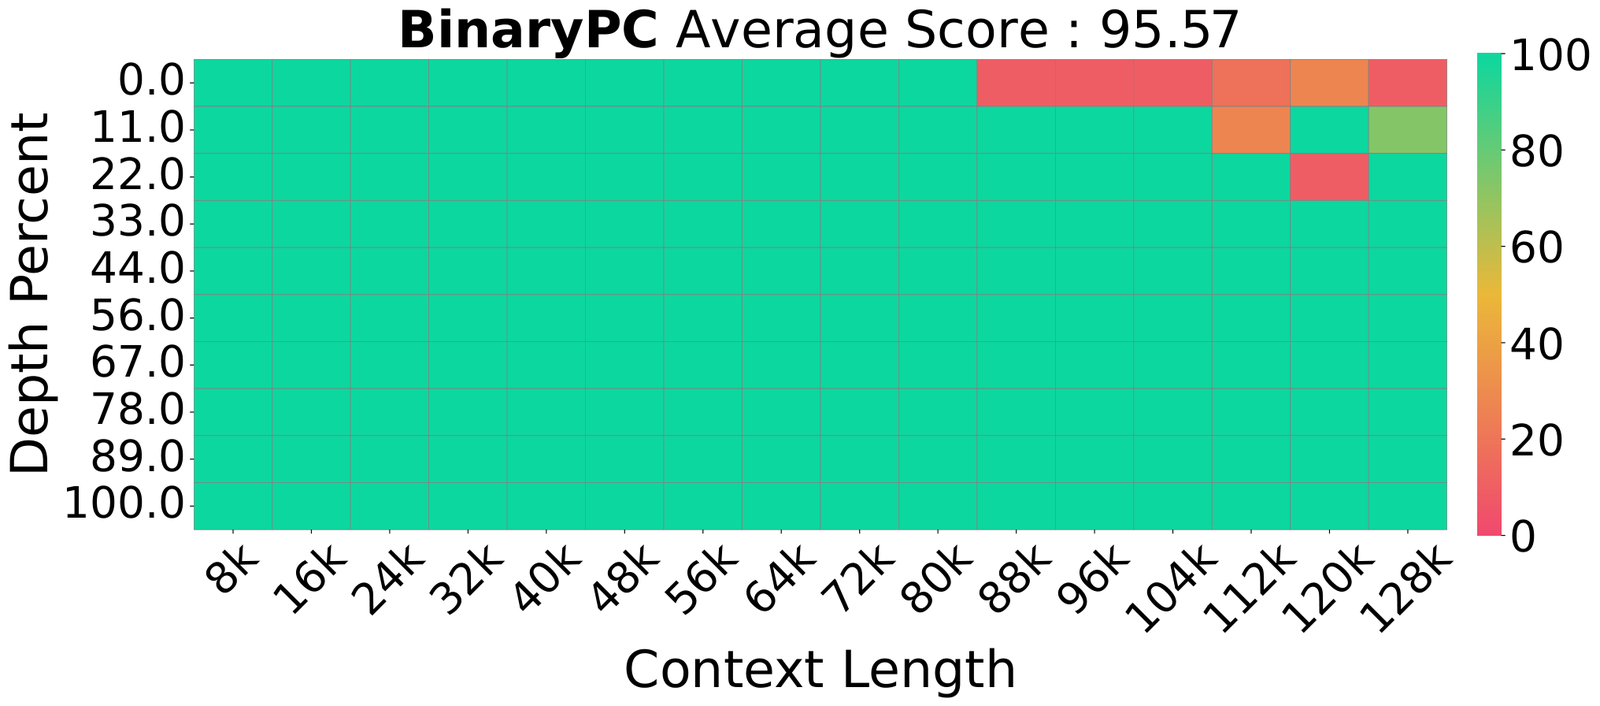
对比上面四组针对 Llama-3.1-8B-Instruct 在不同深度和上下文长度下的 NIAH 热力图可以清晰地看到:
-
第一张原始注意力(Origin)展现了模型的理论检索上限,绿色区域代表能够正确召回,整体表现扎实;
-
第二张 Quest 作为基于页面分块的启发式稀疏方法,在长上下文深处开始浮现出大片的红色召回失效区;
-
第三张 MagicPIG 受制于数据无关的随机投影,即便动用了更庞大的编码空间,在超长距离和特定文档深度依然不可避免地丢失了大量关键 Token;
-
第四张 BinaryPC 依靠数据感知的主成分划分与 EAS 的双重协同,几乎全绿地复刻了全精度注意力的表现,在各个深度位置均实现了无损召回。
在综合性长上下文基准 RULER 的评测中,随着上下文长度从 8K 扩展到 128K,BinaryPC 与真实 Oracle Top-$k$ 基线的得分曲线高度吻合。相比之下,传统的随机哈希方案在 64K 以上的超长尺度下均出现了不可逆的断崖式掉点。
而在 EAS 模块的消融实验中,数据更为直观:在 InfiniteBench 的检索任务中,若关闭 EAS,模型在检索通行密码(Passkey)子任务上的准确率仅有 64.00;而仅仅分配极其有限的 2% 预算给高误差残差集合,该任务的得分瞬间拉升至 99.00。并且,当 EAS 预算比例在 2% 到 15% 之间变动时,模型的综合得分始终稳定在 47.5 附近,这充分证明该机制并非一个依赖精细参数调优的脆弱补丁,而是一个鲁棒性极强的算法底层保障。
吞吐爆发:突破 GPU 算力瓶颈的底层收益
稀疏注意力算法最容易遭遇的质疑是:“理论 FLOPs 降低了,但由于引入了复杂的寻址和分支,在真实 GPU 上的端到端耗时反而更慢了”。BinaryPC 在这一考量上展现出了极高的工程实用价值。
在大模型长上下文服务中,FlashAttention-2 是一座难以逾越的高效底座。但当上下文极长或 Batch Size 增大时,即便 FlashAttention 也会撞上内存墙。更有趣的工程现象在于,FlashAttention 内部存在自适应启发式切换:当 Batch Size 超过特定阈值(如大于 15)时,为了维持调度开销的平衡,算子内部会从超高并发的 Split-K 算子悄然回退至标准 Kernel,这往往会导致吞吐出现明显的局部断崖。
由于 BinaryPC 将注意力预算压缩到了仅 2% 左右,送入底层 FlashAttention 计算的有效 KV 规模缩减了 50 倍。这不仅彻底规避了昂贵的全局显存数据读写,还直接平抑了算子底层的性能抖动:
在固定的 64K 与 128K 长上下文生成压测下,随着并发 Batch Size 的上升,BinaryPC 相对于 FlashAttention 的加速比持续扩大;当上下文处于主流服务区段时,端到端解码吞吐稳步达到了 FlashAttention 的 3.56 倍。而在触发标准 Kernel 回退的边界场景下,BinaryPC 更是录得了高达 5.04 倍 的端到端吞吐增长。
启示:几何先验与极简工程的结合
长上下文 LLM 推理的优化战场,正在逐步走出单纯依靠工程微调内核或盲目牺牲精度的启发式剪枝阶段。
BinaryPC 提供了一个非常纯粹且优雅的示范:与其耗费大量显卡资源去针对特定模型重新训练复杂的非线性哈希网络,亦或用与任务结构脱节的纯随机投影来盲测相似度,不如直接回到主成分分析(PCA)这一经典降维思想的本源。通过显式构建带有二值约束的最优线性逼近,它在“训练开销为零”和“精准捕捉数据流形”之间找到了一个极具实用价值的平衡点。
这种“数据感知但无需训练(Data-Aware yet Training-Free)”的范式,叠加上对离群异常点具备兜底能力的残差保护机制,使得长上下文大模型在海量并发生产环境中同时兼顾高吞吐与高可靠成为可能。对于希望在现有开源模型上无缝挂载、不愿承担二次微调风险并渴望即刻榨干硬件吞吐的实际工程系统而言,这条技术路线无疑指明了极具潜力的演进方向。