消除转置偏差!2D方块量化破解FP4训练,与BF16差距小于1.3%
Stable FP4 Training via Transposition-Invariant Block Quantization
在大语言模型(LLM)的算力竞赛中,降低训练数值精度一直是最具吸引力的降本增效手段。随着主流硬件全面拥抱 FP8,整个行业已经尝到了显存带宽占用减半、计算吞吐翻倍的甜头。然而,当学界和工业界试图进一步向前推进一步、迈向更加极致的 4 位浮点数(FP4)端到端训练时,却普遍撞上了一堵高墙:极窄的动态范围与巨大的量化噪声,使得模型在反向传播和长时间优化过程中频繁出现数值不稳定乃至训练崩溃。
ArXiv URL:https://arxiv.org/abs/2607.24953v1
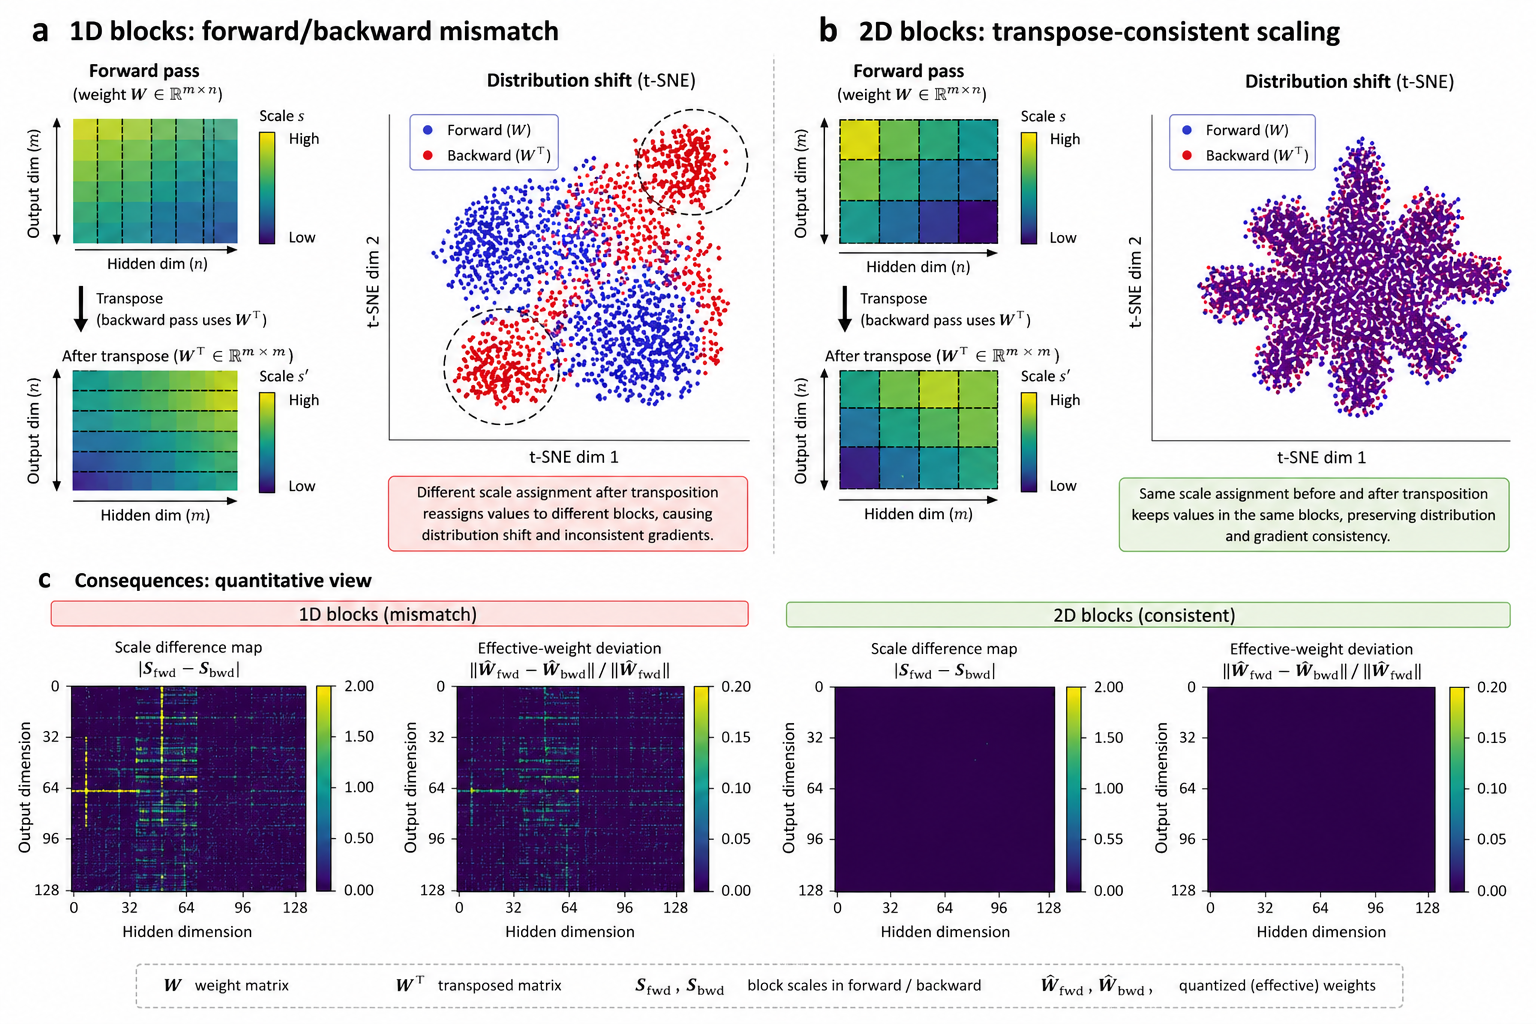
最近一项针对低精度训练的深入研究揭示了一个此前被广泛忽视的关键失效模式。以往基于微缩放(Microscaling,如 MXFP4、NVFP4)的低精度方案之所以在 FP4 阶段难以收敛,其症结并不仅仅在于 4 位浮点表示能力有限,而在于传统一维分块量化所引发的“转置缩放不一致性”(Scale Inconsistency Induced by Tensor Transposition)。在深度学习的反向传播中,权重与激活矩阵必须频繁执行转置运算;一旦沿用一维切块方式,同一个数值在前向与反向计算中就会被重新划分进不同的块,从而被赋予完全不同的缩放因子,直接向梯度引入严重的系统性偏差。
为了从根本上拔除这一病灶,研究团队提出了一套基于二维方块(2D Square Block)的 FP4 量化训练框架。通过保证几何结构在转置下的内在不变性,该方法使得张量在反向传播中完美保留前向的缩放因子,彻底消除了前反向之间的量化失配。结合无截断缩放(Truncation-Free Scaling)、随机舍入(Stochastic Rounding)以及在最敏感的注意力机制中局部保留 MXFP8 的混合精度策略,该方案在 dense 架构的 OLMo-1B、OLMo-7B 以及拥有 300 亿参数的 Qwen 30B MoE 稀疏模型上,完成了高达 1000 亿 Token 的稳定端到端训练,其困惑度与下游推理基准表现与标准 BF16 基准相比差距小于 1.3%。这一成果不仅证明了超低精度 FP4 训练在大规模模型上的可行性,更将低精度算法设计的核心命题从“单纯压缩局部量化误差”重塑为“维护全局计算与梯度的对称一致性”。
被忽视的病根:矩阵转置带来的缩放撕裂
要理解 FP4 训练为何屡屡受挫,必须先审视当前微缩放(Microscaling)机制的工作原理。像 MXFP4 这样的格式通常采用 E2M1 编码,每个浮点数仅有 4 个 bit,其本身能表达的数值跨度极其狭窄。为了防止严重溢出或下溢,微缩放格式引入了分块共享比例因子(Block-wise Scaling)的思想:将张量切分成小分组(例如 $1 \times 32$ 或 $1 \times 16$ 的一维向量),每个分组独立寻找自身绝对值的最大值,并计算出一个共享的高精度比例因子 $S$。每个元素只要通过除以 $S$ 映射到当前块的局部动态范围内,再做低比特舍入即可。
这种设计在推理阶段或局部计算中表现良好,但在完整的反向传播链条中暴露出致命隐患。在线性层的前向传播中,输出由 $Y = XW^\top$ 给出;而在反向传播计算输入梯度与权重梯度时,需要分别执行 $\nabla X = \nabla Y W$ 和 $\nabla W = (\nabla Y)^\top X$。这里的计算伴随着多次张量转置。
当使用传统的一维分块(如沿某一行连续切分)时,张量一旦发生转置,原本在同一个块内同甘共苦的数值就会被硬生生拆散,分别重组进全新的分块中。由于每个新块内的最大值发生了变化,导致同一个位置上的数值在反向传播中所获得的缩放因子 $S_{\text{bwd}}$,与前向传播时的 $S_{\text{fwd}}$ 截然不同。结果便形成了量化表征的前后分裂:前向计算看到的张量是 $\hat{X}{\text{fwd}}$,而反向传播实际计算出的梯度方向对应的却是另一个张量 $\hat{X}{\text{bwd}}$。这种由转置引起的缩放撕裂,直接破坏了反向传播对于前向状态的精确导数依赖,向优化器注入了带有系统性偏移的受偏梯度(Biased Gradients)。在 FP8 甚至更高精度下,数值范围足够宽容,这种偏差尚不足以致命;但当精度被压缩到区区 4 位时,这种累积的梯度偏差会迅速演变为优化震荡,最终导致损失发散。
哪怕通过进一步缩减 1D 分块的长度,这种由于几何不对称带来的转置撕裂也无法被根除,反而会引入巨大的缩放因子存储与计算开销。这清晰地表明,端到端 FP4 训练所缺失的并非更复杂的经验修正,而是一个在数学上具备“转置不变性”(Transposition Invariance)的底层分块范式。
2D 方块量化:让前向与反向站在同一基准线上
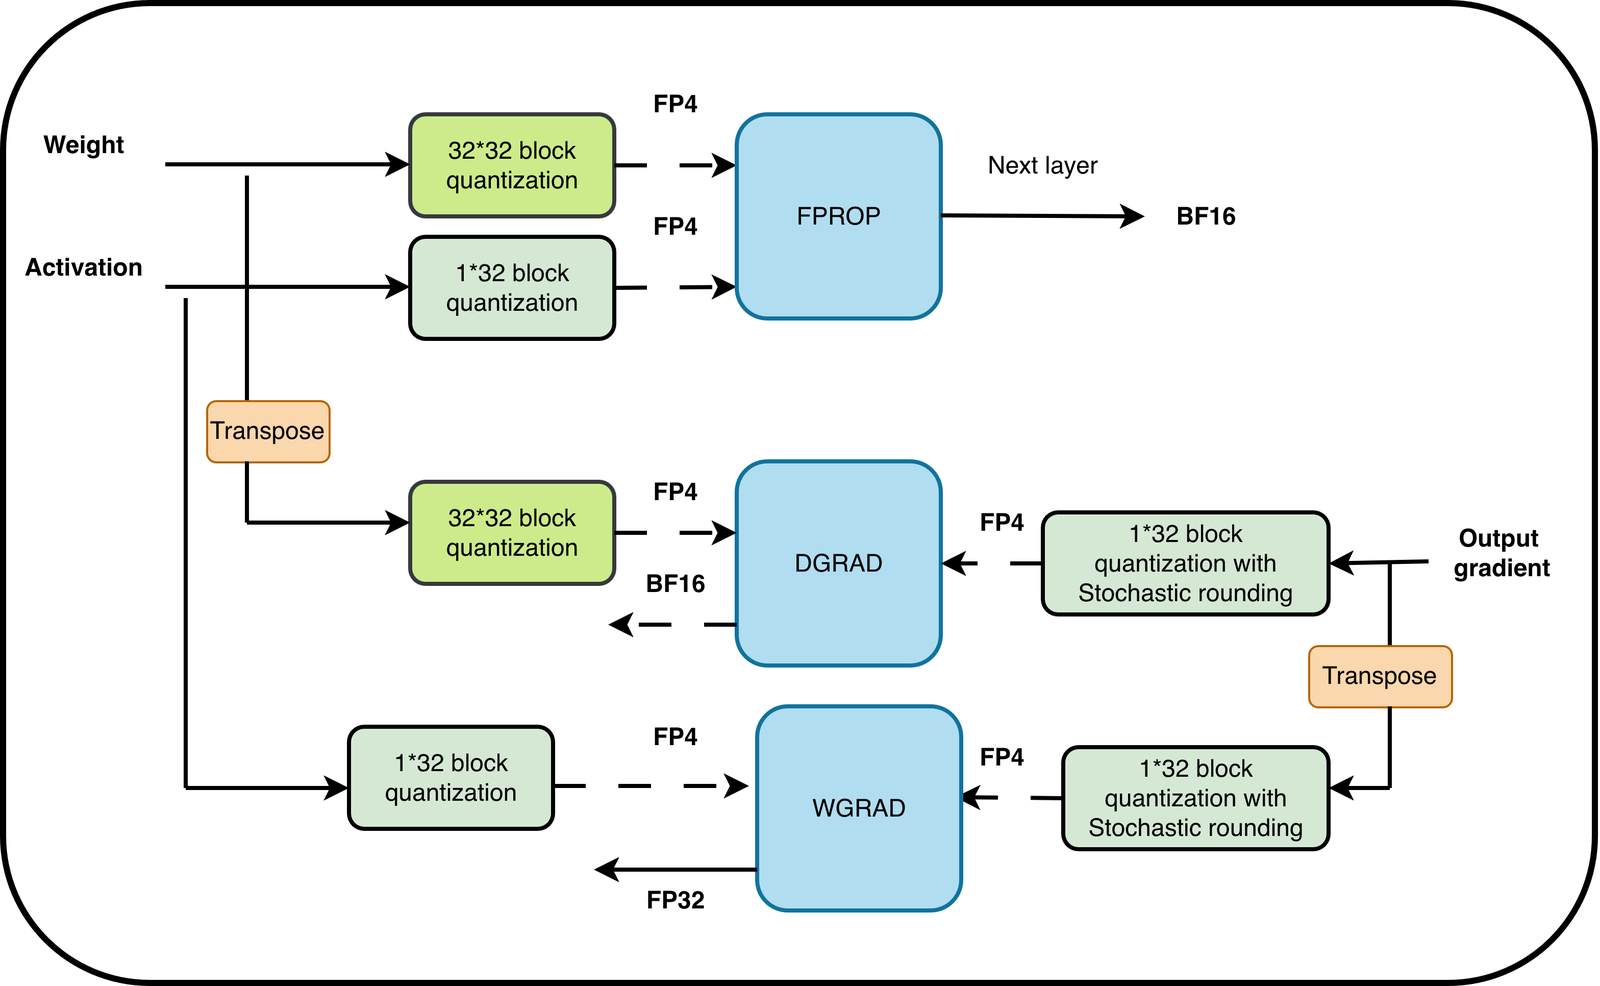
为了从几何层面根治转置不一致性,本文提出的核心思路极为纯粹而优雅:将张量划分单元从一维切片重构为二维正方形块(2D Square Blocks)。
假设一个矩阵 $X \in \mathbb{R}^{m \times n}$ 被划分为多个尺寸为 $b \times b$ 的二维方块。位于第 $i$ 行、第 $j$ 列的方块记作 $B_{i,j}$。在反向传播中,张量整体发生转置变成 $X^\top$,原本的方块 $B_{i,j}$ 随之映射为转置张量中对应的方块 $B_{j,i}$。由于方块本身是严格对称的正方形,从集合论的角度来看,$B_{j,i}$ 内包含的数值集合与原始的 $B_{i,j}$ 完全相同,仅仅是内部元素完成了位置互换。因此,方块内的绝对值最大值在转置前后保持恒定不变,其推导出的块缩放因子天然满足:
\[S(B_{i,j}) = S(B_{i,j}^\top)\]这意味着,无论张量在前向传播中被读取,还是在反向传播中被转置求偏导,同一个参数或激活值永远从属于同一个数值集合,并共享同一个缩放因子 $S$。前向与反向之间量化表征的等价性得到了严格保证,系统性的梯度偏差由此被彻底抹平。正如误差分布图所示,传统 1D 分块在转置后会产生剧烈的缩放因子差值与权重偏离,而 2D 方块结构下的有效权重偏差几乎归零,使低精度梯度能够以极高的保真度沿反向路径顺畅流动。
除了在分块几何形态上的创新,极低精度训练还需要解决溢出敏感和舍入偏差两大数值地雷。在 FP4 的极端空间内,任何细微的非对称截断都可能让梯度均值漂移。作者团队为此引入了互补的两项数值加固方案:
首先是无截断缩放(Truncation-Free Scaling)。常规的缩放因子计算往往依赖经验估计,极易因未充分容纳最大值而引发局部截断上溢。该方案基于块内极值 $M$ 与正负极限量化区间的关系,直接计算比例尺度:
\[S = 2^{\lceil \log_2 (2M / (Q_p - Q_n)) \rceil}\]通过以 2 的幂次动态保证极值处于表示范围边界以内,彻底排除了数值溢出带来的非线性突变风险。
其次是引入随机舍入(Stochastic Rounding)来替换确定性就近舍入。在 4 位量化下,确定性舍入会导致大量微小的梯度更新量被直接截断为零,或者朝固定方向积累偏移。随机舍入在数学上天然具备无偏期望属性:
\[\mathbb{E}[\text{roundS}(x)] = x\]它确保了在大量神经元和长时间更新的宏观统计视角下,梯度估计的数学期望始终忠实于全精度梯度,从而为极低精度优化器提供了坚实的收敛理论支撑。
混合精度取舍:对注意力敏感区域的精细化防护
在消除了通用线性层中的转置偏差后,端到端 Transformer 训练还面临着另一道难关:自注意力机制的数值敏感性。在 Transformer 的核心构件中,大部分计算量集中在线性前馈层(FFN)和投影矩阵上,其计算复杂度与序列长度及隐藏层维度的平方成正比($\mathcal{O}(Nd^2)$);而注意力机制涉及的 Query 与 Key 之间的点积计算 $QK^\top$,其复杂度与序列长度的平方成正比($\mathcal{O}(N^2d)$)。
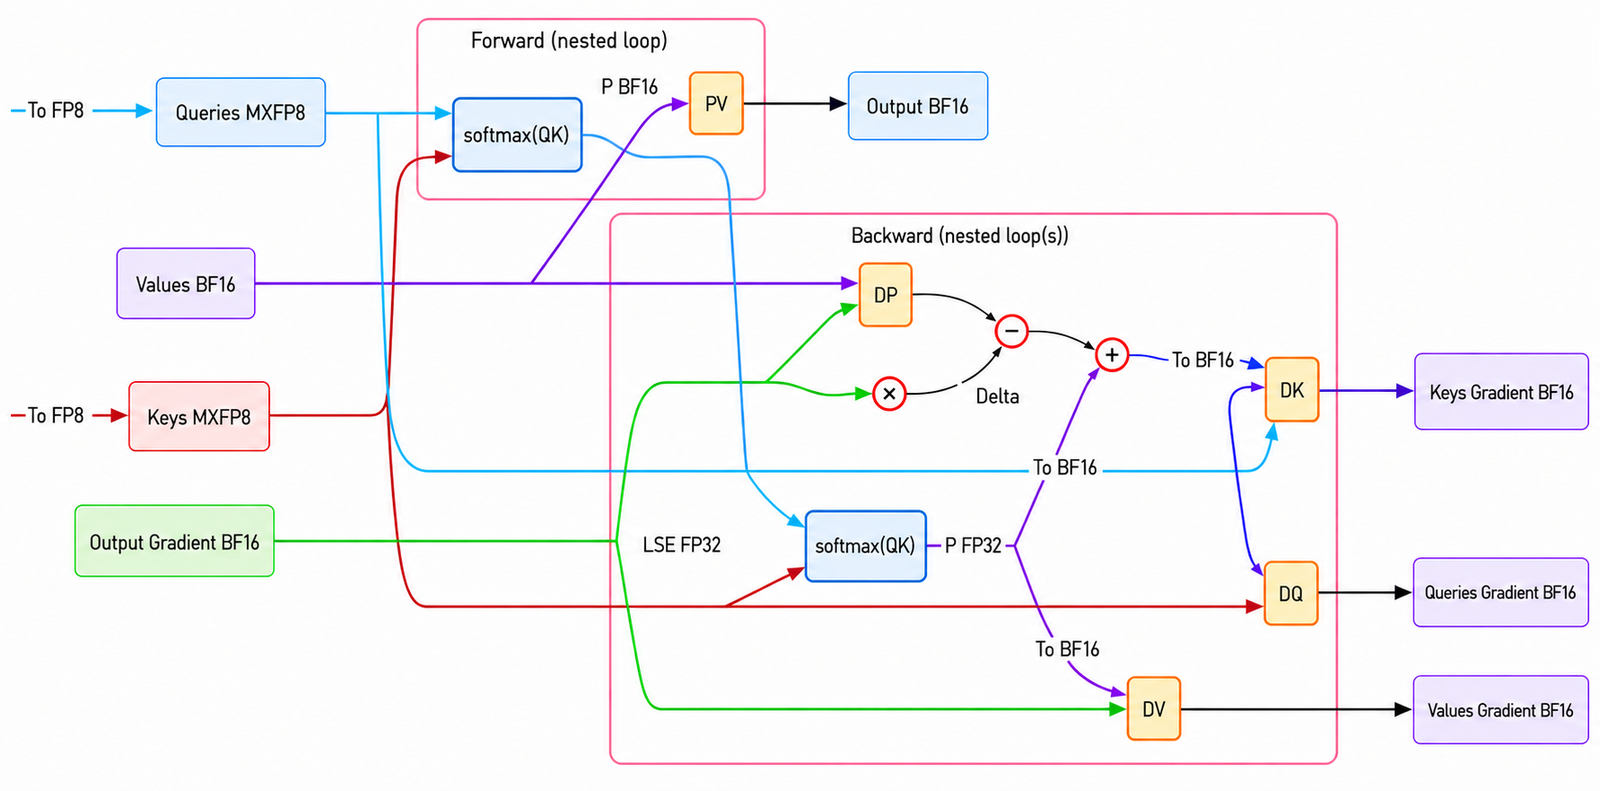
尽管 $QK^\top$ 占用的参数量相对有限,但其对精度的苛刻程度远超普通前馈网络。这主要是由两个层叠的非线性放大效应决定的:点积运算本身会把微小的量化噪声呈数量级放大;随后接续的 Softmax 归一化具有强烈的指数放大特性,输入端哪怕出现微小的数值抖动,都会剧烈扭曲注意力概率分布的平滑度,导致模型注意力机制涣散,甚至直接摧毁上下文学习能力。
实验证实,若激进地将 Query 和 Key 投影同样压制到 FP4,误差将在点积与 Softmax 中迅速级联发散。为此,作者采取了务实的混合精度设计:在模型计算占比最大、决定吞吐上限的大规模通用线性层上全面铺开 2D 方块 FP4 量化;而在对扰动极其敏感的 Query 和 Key 投影计算上,则保留精度稍高、具备更宽动态区间的 MXFP8 格式。
这种架构设计在计算效率与数值稳定性之间取得了精妙的平衡。它将计算代价最高昂的“大头”交给 FP4 换取理论吞吐与内存的大幅节省,而将至关重要的注意力对齐留给 MXFP8 兜底,避免了因注意力崩溃而导致的模型退化。
从 1B 到 30B MoE:拉齐 BF16 的硬核实测
为了检验该方案是否能在真实规模的大模型预训练中承受住长周期的考验,研究团队开展了横跨密集模型与混合专家模型(MoE)的多维度实证评估。实验覆盖了三套代表性架构:从参数规模较小的 OLMo-1B,到工业级主流尺度的 OLMo-7B,再到参数量达 300 亿的 Qwen 30B MoE。所有模型均在高达 1000 亿(100B)Token 的真实数据流上完成从零开始的预训练。由于当前主流硬件对于原生微缩放 FP4 张量核心(Tensor Core)的支持仍处于迭代阶段,实验重点在于验证长周期优化的数学收敛稳定性与下游表征质量,排除了硬件模拟器对速度统计的干扰。
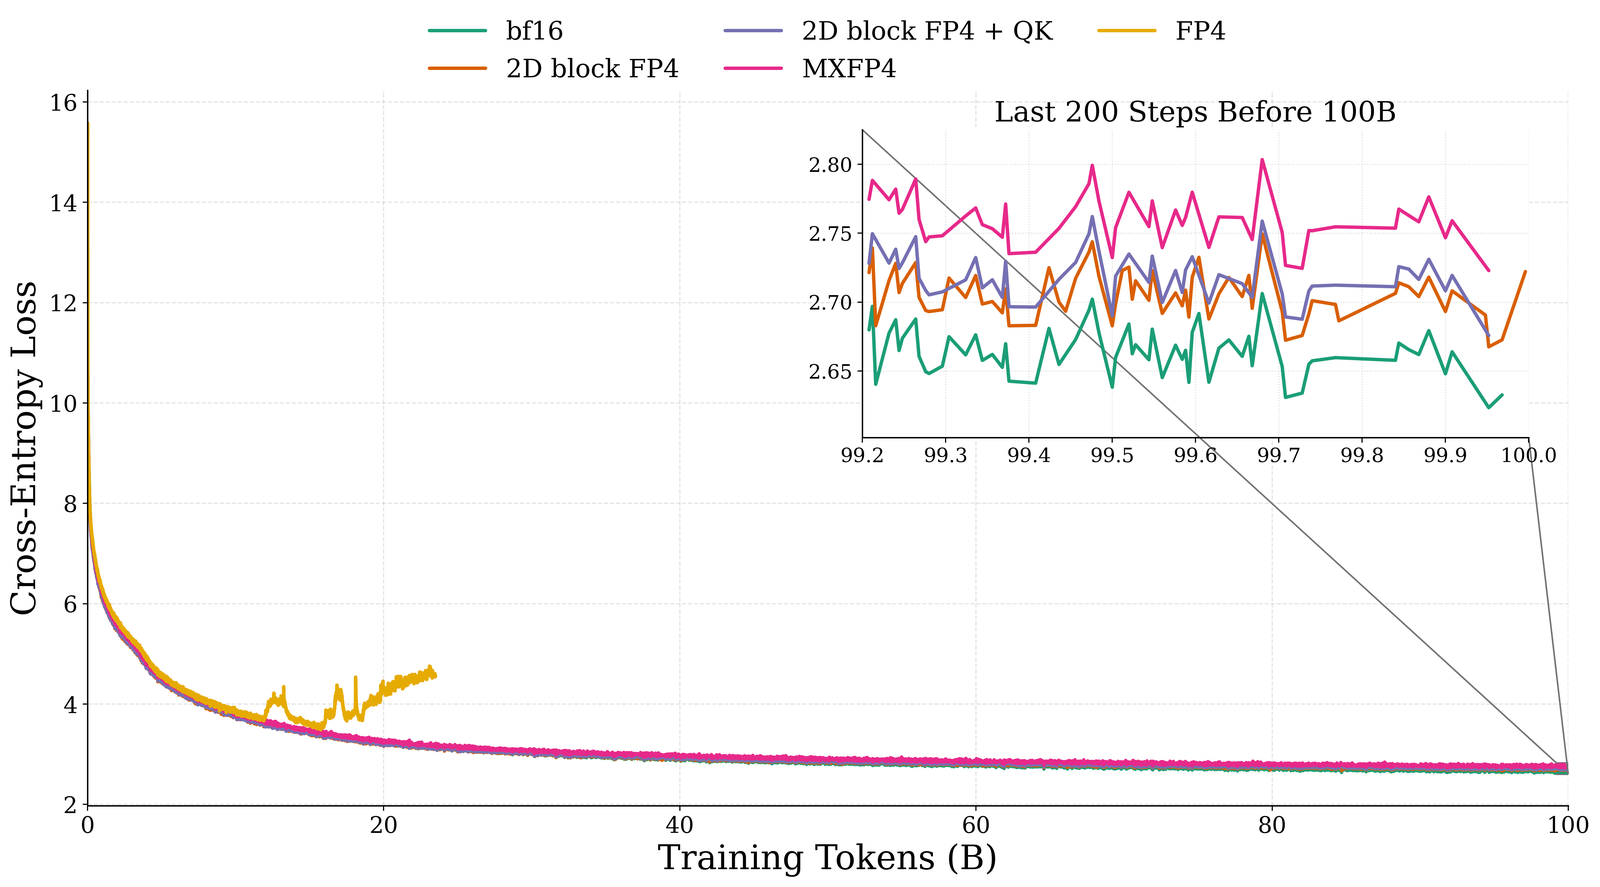
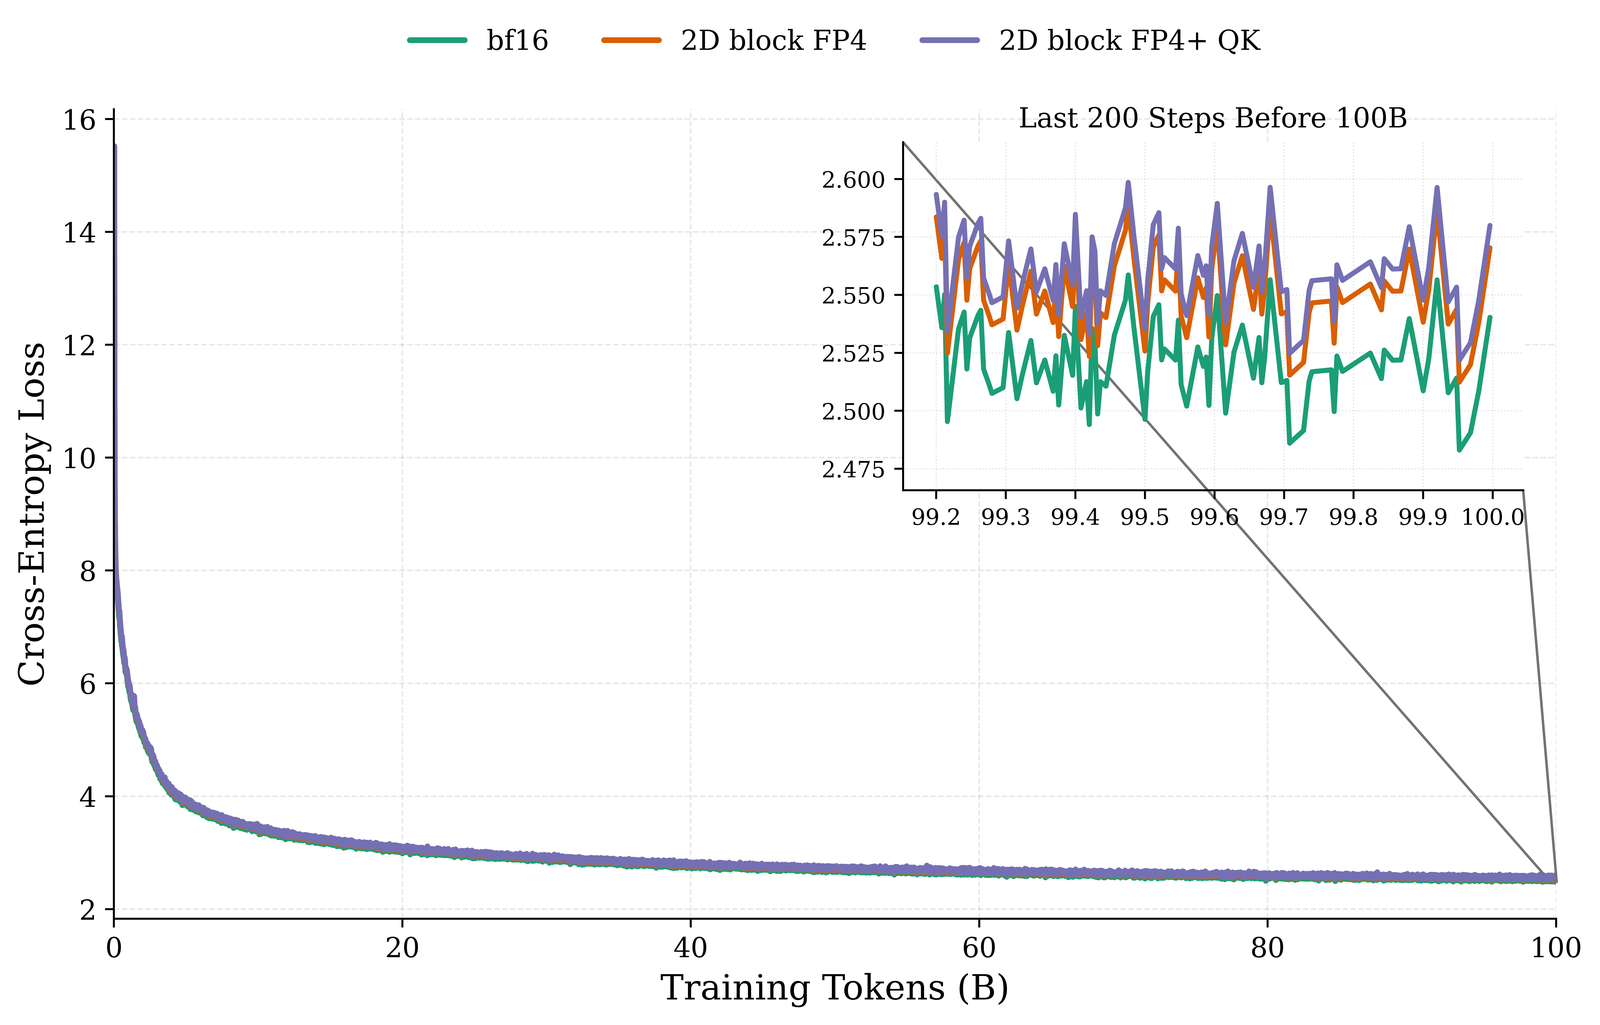
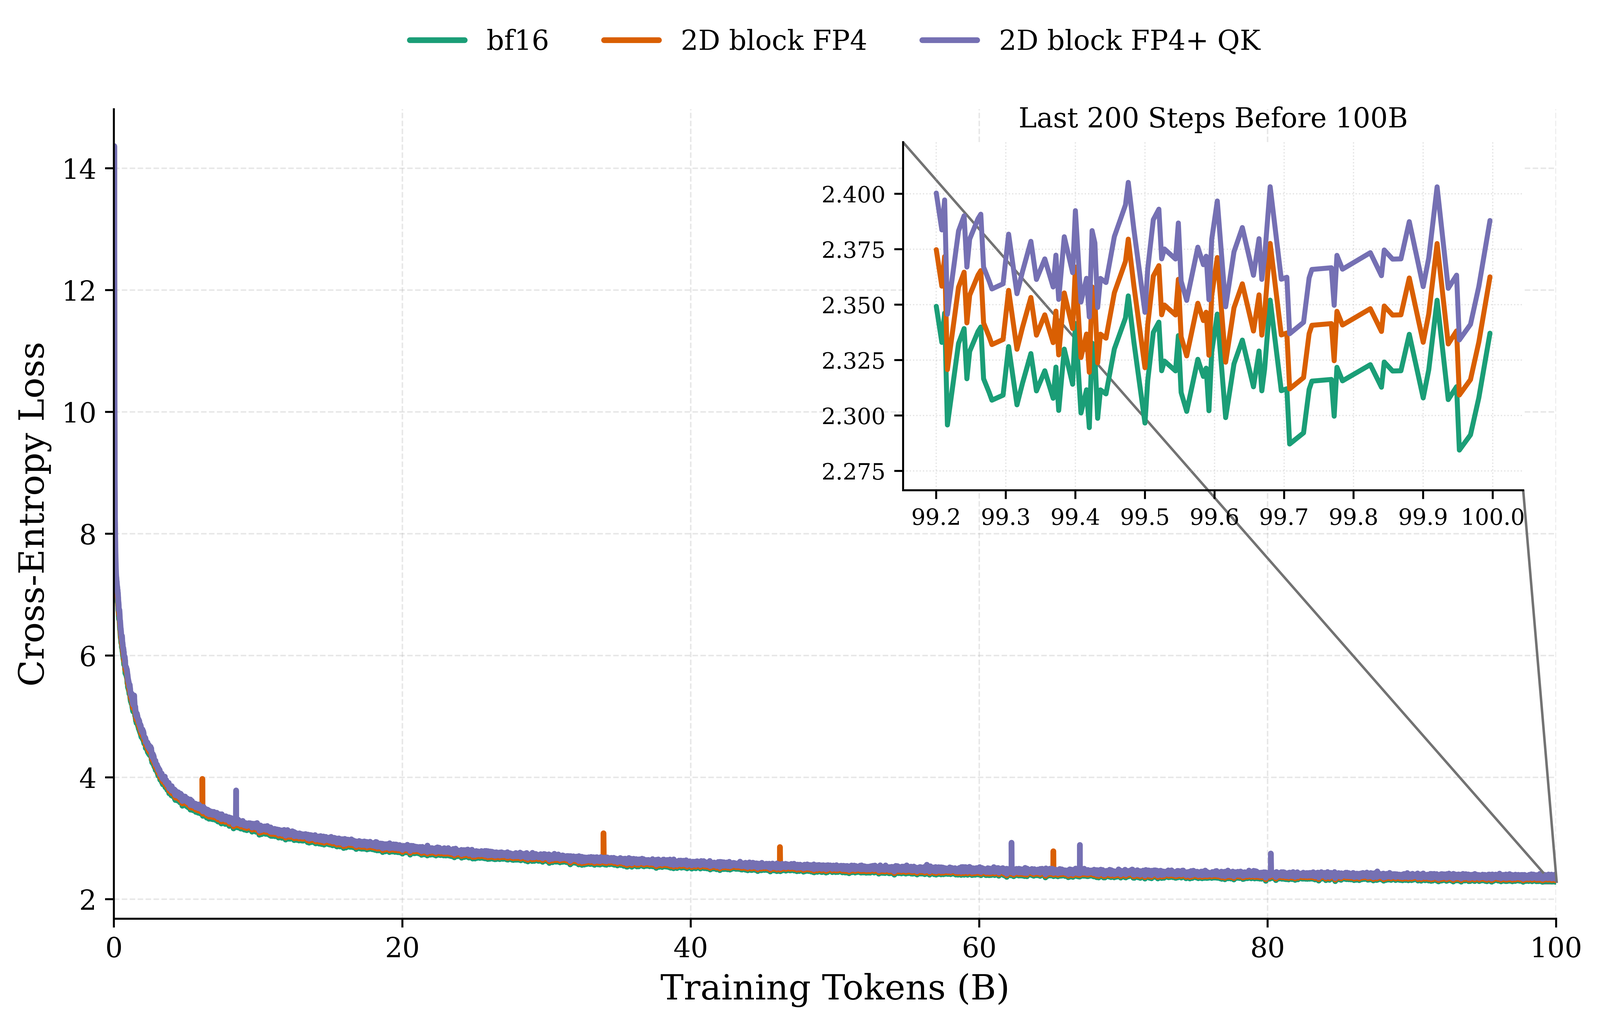
训练动态曲线展现出了令人信服的一致性。在过去的多项研究中,FP4 训练往往在几千步之内就会出现损失波动乃至发散,而采用 2D 方块量化的模型展现出了极其平滑且可预测的收敛轨迹。无论是在 OLMo-1B 还是 OLMo-7B 上,整个 100B Token 的训练过程中完全未出现任何损失骤升(Loss Spike)或梯度爆炸现象。更值得注意的是,在结构更复杂、容易因专家路由离散决策而加剧数值不稳定的 Qwen 30B MoE 上,2D FP4 的收敛曲线与全精度 BF16 保持了高度的重合度。
在语言建模的基础评测(包括 Wikitext、The Pile 和 C4 测试集)以及涵盖常识推理的下游任务(如 SciQ、COPA、ARC-Easy、HellaSwag)中,这套端到端低精度方案交出了一份惊人的成绩单:
-
与全精度极其微小的性能鸿沟:在所有测试模型中,纯 2D 方块 FP4 结合 MXFP8 注意力的混合精度方案,其困惑度与下游推理准确率相较于原汁原味的 BF16 基准,退化幅度均被严格压制在 1.3% 以内。
-
大模型更显稳健的“涌现鲁棒性”:数据呈现出一个引人深思的规律——随着模型规模从 1B 逐步上升到 7B 再到 30B MoE,低精度训练与 BF16 之间的相对性能差距不升反降。这证明只要系统性地剔除了“转置缩放不一致”所造成的结构性梯度偏差,参数规模更大的模型对于残留的随机量化噪声拥有更强的内在容忍度。
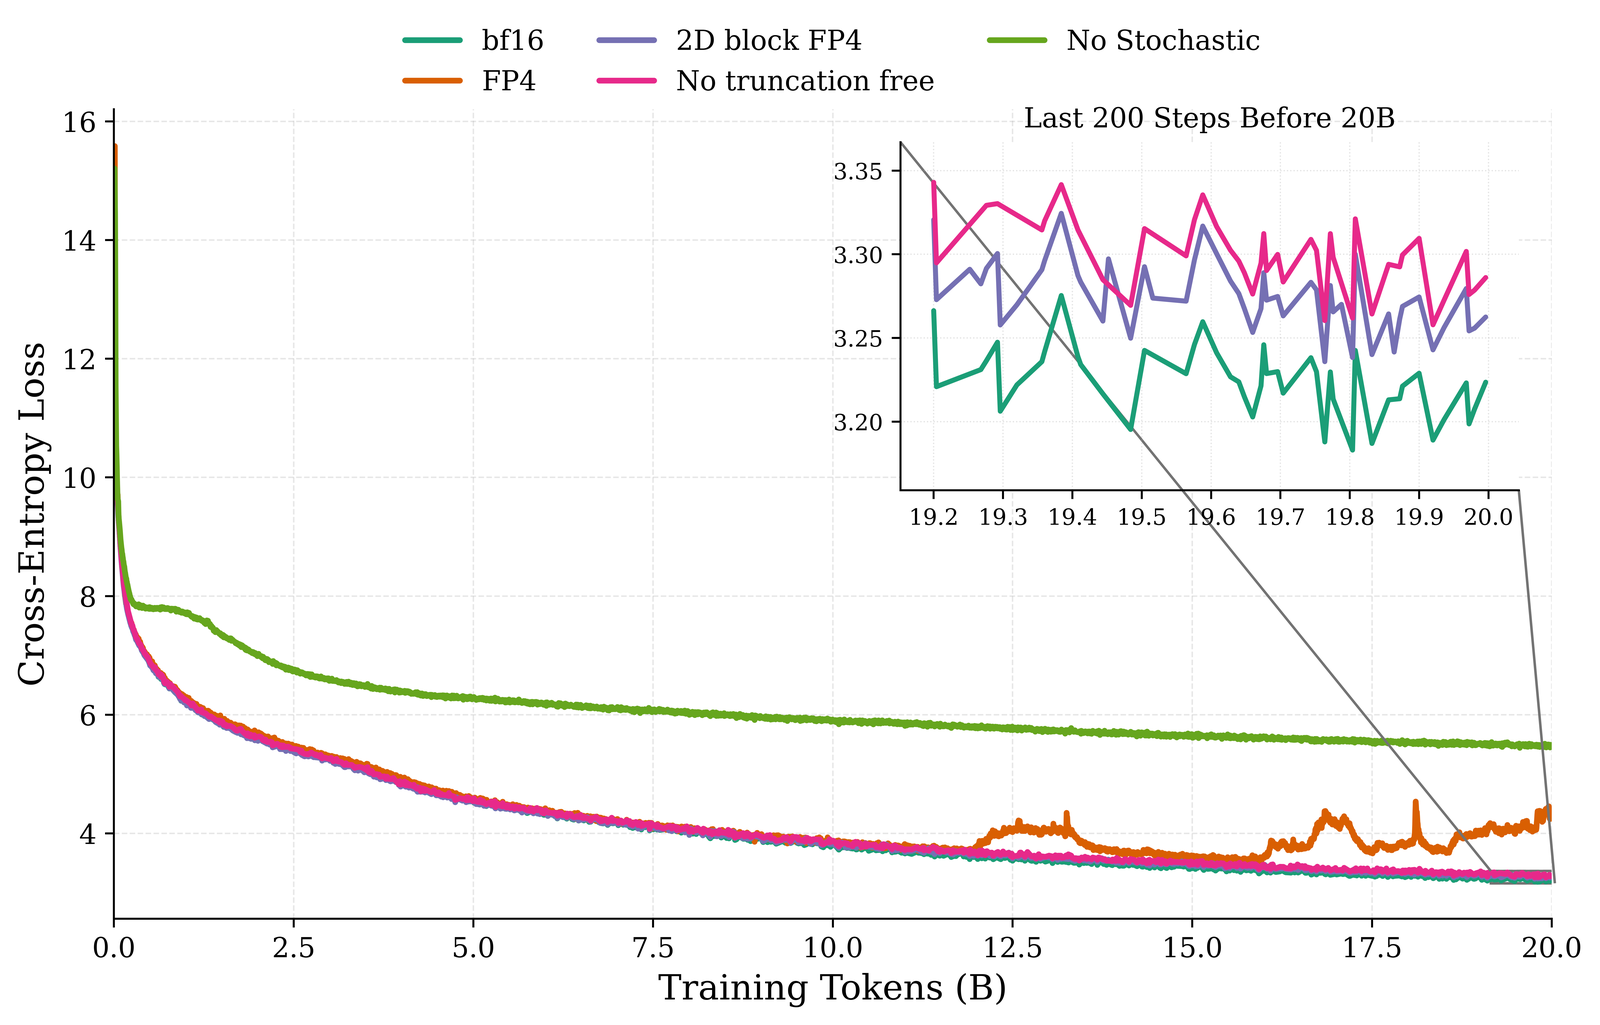
为了剖析框架中每一项设计决策的真实贡献,作者进行了细致的消融分析。当把 2D 方块量化回退到传统的 1D 微缩放时,模型的损失曲线立即恶化,并最终在优化深水区难以正常收敛;而一旦抽离无截断缩放与随机舍入,梯度方差与数值截断会立即拖累模型的最终精度达数个百分点。同样,如果放弃对 Query-Key 投影的 MXFP8 保护、盲目执行全盘 FP4,注意力分布的畸变会直接导致模型在上下文理解任务中遭遇断崖式下跌。这表明,2D 几何一致性、无偏数值护栏与关键通路的自适应混合精度,三者缺一不可,共同构筑了超低精度训练的稳定三角。
在 2D 方块尺寸的选择上,研究同样给出了工程权衡指导。从 $8 \times 8$、$16 \times 16$、$32 \times 32$ 到 $64 \times 64$,方块尺寸越小,表示局部动态范围的精细度越高,模型收敛越好,但缩放因子的显存开销也随之水涨船高;反之,方块过大则会稀释局部缩放的优势。综合精度保留率与硬件存储开销,在当前场景下 $16 \times 16$ 至 $32 \times 32$ 的方块尺寸展现出了最佳的实用性价比。
重新定义低精度训练的底层逻辑
长期以来,低精度模型量化领域的研究重心大多聚焦于“如何压缩误差”——设计更复杂的量化网格、寻找非线性的数值分布、或是引入复杂的缩放优化算法。然而,这项工作以极具启发性的视角向整个行业指出:在由反向传播构成的闭环优化体系中,“运算一致性”的优先级甚至要高于“单次表示的高保真度”。
传统 1D 微缩放方案在静态精度测量上无可挑剔,但它的非对称设计破坏了梯度反向传播的守恒定律,导致正向计算与反向梯度被撕裂。而 2D 方块量化通过极为精炼的几何对称性,重新拉直了前向与反向梯度的映射桥梁,用极简的结构设计化解了困扰 FP4 优化的顽疾。
从更广阔的算力演进视角来看,这一进展具有深远的工业价值。尽管目前该论文仍基于软件模拟,但它为新一代 AI 专用芯片(如未来的张量处理核心)的微架构演进提供了极具针对性的理论参考。当前主流硬件在支持 MX 格式时普遍倾向于一维连续向量,若能在未来硬件中原生支持二维分块张量计算核心与转置一致的缩放逻辑,大模型预训练将能够以近乎零代价的姿态迈入 FP4 纪元。在模型规模依然指数级扩张的当下,这项研究不仅为低成本训练大模型扫清了一大理论拦路虎,更展示了算法对称性与数值优化交织所带来的巨大力量。