给Agent加技能真有用?近6000次实验揭秘“回归税”:59%的新增收益被抹平!
The Regression Tax: Decomposing Why Skills Help and Hurt LLM Agents
在大语言模型(LLM)驱动的自主智能体(Agent)研究中,“技能沉淀”正成为提升系统能力的主流路线。无论是让模型在探索环境中提取经验,还是使用自动工作流将历史轨迹提炼为标准操作程序(SOP),背后的直觉往往非常朴素:给 Agent 灌输的专业技能和流程指引越多,它的成功率就应该越高。
ArXiv URL:https://arxiv.org/abs/2607.22520
然而,各大评测榜单上那些光鲜的“平均成功率提升”,实际上掩盖了一笔巨大的隐藏成本。一项最新的评测研究通过对 2 个真实办公自动化基准和 3 套主流模型框架进行了共计 5,832 次配对运行实验,揭开了一个惊人却被长期忽视的现象:在给 Agent 引入技能库后,模型在攻克新难题的同时,大量原本不需要技能就能做对的任务却莫名其妙地失败了。作者将这种“老题做错”对“新题做对”的抵消现象命名为“回归税”(The Regression Tax)。统计数据显示,技能库所带来的全部正向增益中,有高达 59% 被这些退步(Regressions)悄然抹平。
这项研究最具颠覆性的发现不仅在于量化了损失,更指出了当前 Agent 技能优化的本质误区:在多数场景下,顶尖技能库之所以胜出,根本不是因为它们帮 Agent 攻克了更多新任务,而是因为它们“犯的退步错误更少”。这种认知反转迫使我们重新审视现有的 Agent 开发范式——如果我们继续沉迷于为中间推理过程编写繁琐的程序化说明,Agent 系统的可靠性或许永远无法跨过落地的及格线。
拆开“平均分”:配对分解下的残酷算术
传统针对 Agent 技能库的评测几乎全靠平均通过率(Pass Rate)说话。如果一个智能体原本的成功率是 60%,加上一套技能后提升到了 65%,大家便理所当然地认为该技能库有效。但这种净值的微弱增长,究竟是因为它多解决了 5% 的新问题且毫无副作用,还是因为它新攻克了 20% 的任务却同时搞砸了 15% 原本已经通关的任务?
为了厘清这个根本问题,研究者将每一次评测严格控制为针对相同任务的“有技能 vs. 无技能”配对实验(Paired Comparison)。在固定的模型、运行框架以及任务输入下,唯一改变的变量就是上下文中是否存在技能库。每一次任务的输出由此被精确拆解为四种互斥状态:
-
始终成功:没有技能时能做对,加入技能后依然做对;
-
始终失败(Residual Failure):无论加不加技能都无法解决的顽固错误;
-
新增收益(Gain):原本做错、引入技能后成功做对的任务;
-
倒退错误(Regression):原本做对、引入技能后反而被改错的任务。
传统意义上的净提升率,在数学上完全等价于“新增收益减去倒退错误,再除以总任务数”。但只有把收益和倒退彻底拆开,才能看清技能库对模型行为的真实干预。
在覆盖财务问答(OfficeQA-Pro)和复杂表格处理(SpreadsheetBench)两大真实办公场景的 5,832 次测试中,研究者总计记录到了 553 次新增收益,但紧随其后的却是整整 324 次倒退错误。在财务分析场景中,退步错误吃掉了 66% 的正向收益;在表格任务中,这一抵消比例也达到了 56%。甚至在某些配置下,比如使用某款前沿推理模型跑表格任务时,某套技能库新做对了 45 道题,却同时搞砸了 41 道原本正确的题,净增益仅剩可怜的 4 道。如果不做配对拆解,开发者只会看到一个微小的正向指标,根本无法意识到系统正在大面积“杀熟”。
更耐人寻味的是横向对比的结果。在财务问答测试中,某知名厂商生成的技能库在纸面新增题数上排在第一,新增了 12 个成功案例,但它同时也引发了 7 次倒退,净胜分仅为 +5;而另一套较为克制的技能库虽然只新增了 10 个成功案例,却仅引发了 2 次倒退,最终以 +8 的净胜分位列第一。这意味着,在许多实际业务中,工程师花费大量心力去挖掘和优化的“复杂技能”,很多时候只是在不断用引入新 Bug 的代价去置换旧 Bug。
统计学检验下的脆弱假象
当研究者对这 18 组对比实验应用更严格的统计学检验时,局面变得更加耐人寻味。
在未修正的常规检验下,有 5 组实验呈现出名义上的显著改善($p < .05$)。但在 18 组同时比较的场景中,如果不进行多重比较校正,极易将纯粹的随机波动误判为技能生效。当研究者引入严格的 Bonferroni 校正(将显著性阈值收紧至 $\alpha/18 = 0.0028$)后,原本显著的 5 组实验中仅有 3 组依然存活,且全部局限在单一模型与表格工具组合的特定搭配中。其余绝大多数看似提升的技能库,在统计学上根本无法与运行噪声区分开来。
这一统计层面的冷酷事实,直接戳穿了当前不少 Agent 技能研究的泡沫:很多研究者宣称的“技能让模型突飞猛进”,在严谨的对照实验和多重校正下,相当一部分仅仅是因为上下文增减带来的随机抖动,或者是拿巨大的倒退风险换来的一点点统计虚高。
技能为何会帮倒忙?三大回归机制剖析
如果技能原本是根据过往错误日志总结出的“优秀实践”,为什么会把原本正常的模型改笨?研究者通过比对执行轨迹,将倒退错误归结为三种截然不同的失效机制。
1. 技能描述渗透(Skill-description Osmosis)
这是最隐蔽、也最颠覆传统认知的一种破坏机制。目前大多数 Agent 框架为了节省 Token,通常只在系统提示词中常驻技能的“简短描述”(Description),当 Agent 判断需要该技能时,再去动态检索或加载其“详细指令”(Body)。很多过滤恶意技能的算法也仅在“检索”或“执行”阶段起效。
然而轨迹分析显示,很多倒退错误的发生,伴随着该技能在整个任务周期内“从未被实际调用过”。仅仅是因为某条技能描述常驻在 Context 中,它的措辞风格、暗示的领域偏好或关键词,就足以像渗透作用一样污染底座模型的注意力分配。在某些轻量模型上,这种纯粹由描述引起的退步占到了全部倒退的 40% 以上。它表明模型对长提示词环境下的先入偏见极度敏感,静态描述的存在本身就是在向模型施加无形的干扰。当然,渗透效应并非全盘有害,在部分任务中,常驻描述也让模型在未显式调用技能的情况下莫名答对了题目,这反过来更证明了它是一把难以预测的双刃剑。
2. 锚定置换(Grounding Displacement)
当 Agent 确实加载并调用了技能时,最常见的致命伤不是技能逻辑本身有错,而是它粗暴地置换了模型原本正确的“信息锚定”(Grounding)。
在复杂的真实任务中,解决问题的首要前提是精准定位输入信息:这是哪张报表、哪一行数据、哪个实体、哪个时间维度的口径。基座模型在没有技能干扰时,往往能老老实实通过语义阅读找对数据源;但当一个写满固定套路的技能被加载进来后,技能所强调的“标准步骤”往往会反客为主。Agent 开始机械化地套用技能推荐的操作范式,强行把输入文本削足适履地塞进预设的模板里,从而在第一步就看错了表格范围、选错了统计口径、甚至张冠李戴了实体。这种由于死板流程覆盖了原始感知理解的现象,在被显式调用的回归案例中占据了绝大多数。
3. 验证置换(Verification Displacement)
第三种机制发生在任务的收尾阶段。一个未被强加技能的成熟 Agent,在给出最终结果之前,往往会保留一部分原生的自省和检验倾向,比如核对计算结果的合理性、检查输出格式是否符合要求。
但在引入某些程序化技能后,技能详尽的操作步骤会给模型带来一种虚假的“完成感”。模型机械地走完了技能规定的最后一步,便心安理得地将中间产物直接输出,原有的自我验证动作被彻底抑制。研究者在表格基准的复查中发现,许多被判负的案例,其核心计算步骤完全正确,但由于缺乏最后的输出检查,模型留下了一个测评评测引擎无法解析的新版 Excel 公式,导致全盘皆输。这种由于遵循流程而放弃终端校验的现象,构成了另一种典型的技能毒性。
错位的供给:为什么残余错误永远修不好?
三种回归机制共同指向了一个深层次的结构性失衡:我们教 Agent 的东西,和它真正需要的支持,出现了严重的错位。
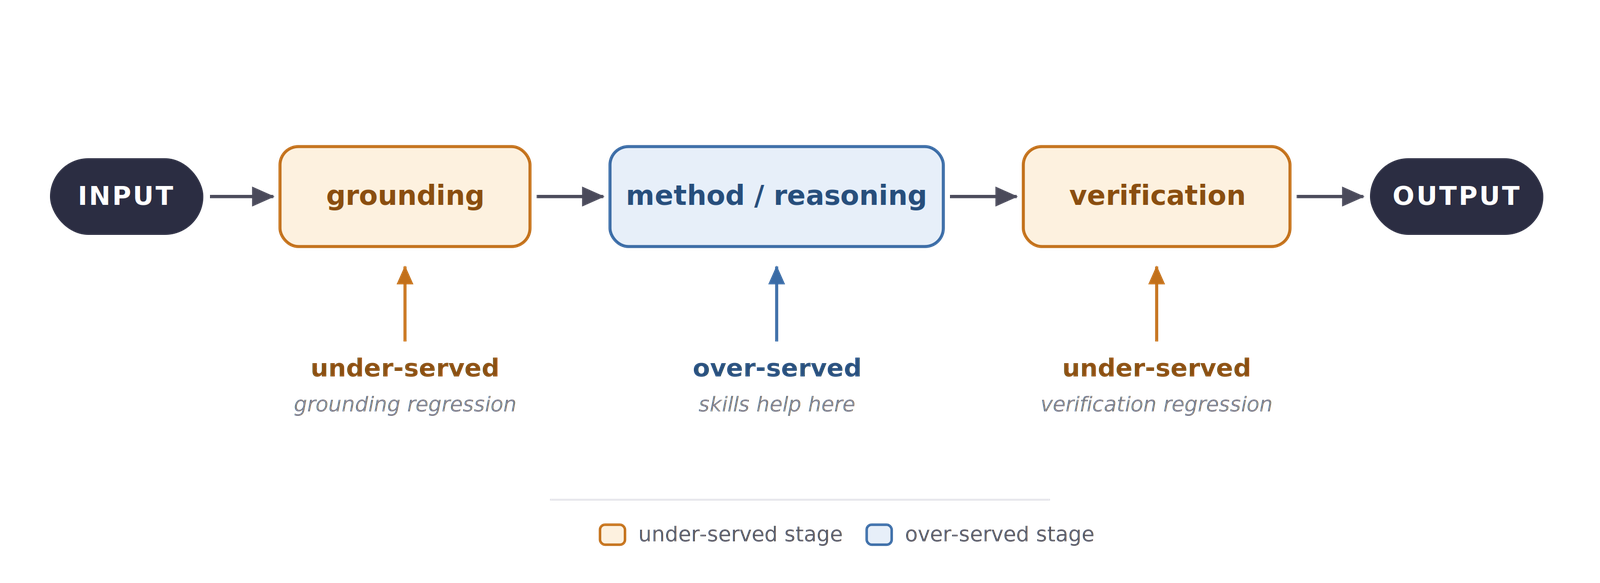
如论文中的流程图所示,一个完整的 Agent 求解链路可以清晰地拆分为三个阶段:输入端的信息锚定(Grounding)、中间层的方法与推理(Method/Reasoning)、以及输出端的结果验证(Verification)。
当前学术界和工业界狂热研发的各路技能自动生成工具,绝大多数都在疯狂加码中间的方法层。人们热衷于教会 Agent 复杂的推理树、精巧的调用链路、自成体系的业务操作流程。然而,无论是在那些引发退步的案例中,还是在那些无论加不加技能都顽固失败的“残余错误”(Residual Failures)中,真正导致崩溃的几乎从来都不是中间的方法步骤。
在财务问答中,模型的命门全在输入端:它能不能分辨出资产负债表与利润表的时间差?它能不能搞懂特定金融名词在特定财报附注里的定义?在表格操作中,决定胜负的则往往在输出端:公式引用的区域对不对?生成的数据格式能不能被宿主环境正确重算?
现有的技能体系过度服务了最不容易出错的中间方法层,却严重冷落了真正决定成败的两头。这种错位导致了一个尴尬的局面:中间的规矩越来越多,模型的行动越来越僵化,而两头的感知漏洞和验证盲区却原封不动。甚至当研究者仅仅通过给表格评测引入更完备的计算引擎与输出验证逻辑时,瞬间就挽救了超过 200 个被误杀的任务——这比费尽心思调优几十个业务技能所带来的净收益要大得多。
告别虚假繁荣:对未来 Agent 设计的警示
这项研究给狂奔中的 Agent 应用落地敲响了一记警钟。在真实生产环境中,用户对系统稳定性的容忍度通常远低于基准测试。一个原本能做对简单任务的 Agent,在被工程师强塞了一堆专家 SOP 后,突然开始在基础常识上翻车,这种体验是灾难性的。
要想走出“加技能反而更不稳定”的怪圈,系统设计者必须改变评测与架构的底层思维。
一方面,任何 Agent 评测都必须废除只看净通过率的单一指标,转而全面推行“收益-倒退”配对分解报告。评估一个技能库的优劣,不仅要看它帮谁翻了盘,更要严密监控它让谁翻了车。任何以高倒退为代价换取微弱平均分上涨的技能,在工程落地中都应该被无情剔除。同时,对于技能描述的系统提示词污染,必须在架构上引入隔离测试,评估其纯文本常驻所带来的渗透风险。
另一方面,技能研发的重心应当从死磕“流程指令”转向强化“输入锚定”与“输出检验”。与其教给模型一套十步走的复杂分析套路,不如为它提供精确的领域概念对齐工具,或者配备几段极度严苛的输出格式断言代码。Agent 的核心短板往往不在于它不会计算或缺乏套路,而在于它看不准起点、验不清终点。只有把资源从臃肿的方法层撤出,补齐感知与验证的两翼,“回归税”才能被真正降下来,自主智能体也才能从演示 Demo 真正走向可靠的产业落地。