ToolGuardian:声明式逻辑锁死Agent工具风险,准入拦截F1达0.86
ToolGuardian: Declarative Security for AI Agent-Tool Interactions
当大语言模型(LLM)从单纯的文本生成迈向自主智能体(AI Agent)时,整个系统的能力边界发生了根本性跃迁。通过 Model Context Protocol(MCP)服务器、各种插件以及外部 API 封装,Agent 拥有了读写文件系统、执行 Shell 命令、调用远程服务以及自动化操作浏览器的强大行动力。然而,伴随能力跃迁而来的是安全防御边界的彻底移位:第三方工具不再只是模型上下文中的一段静态参考资料,而是以 Agent 授权身份在主机或企业内网中实际运转的可执行代码。
ArXiv URL:https://arxiv.org/abs/2607.21835
这种机制给攻击者留下了巨大的攻击面。攻击者无需去越狱大模型本身,完全可以通过“伪装成无害工具”来实现特权跃迁。一个声称用于天气查询或数据排版的 MCP 工具,在工具描述和接口定义上可能毫无破绽,其实现代码内部却可能在特定输入触发后悄悄读取本地凭据、发起秘密网络外联,甚至在多步协同中破坏文件系统。更严峻的是,现有的主流防御方式往往存在致命短板:要么仅凭元数据进行浅层扫描,将“事实刻画”与“安全裁决”混为一谈;要么依赖另一个 LLM 或硬编码启发式脚本充当裁判,在面对复杂的任务上下文和多工具组合时缺乏确定性推理能力与审计线索。
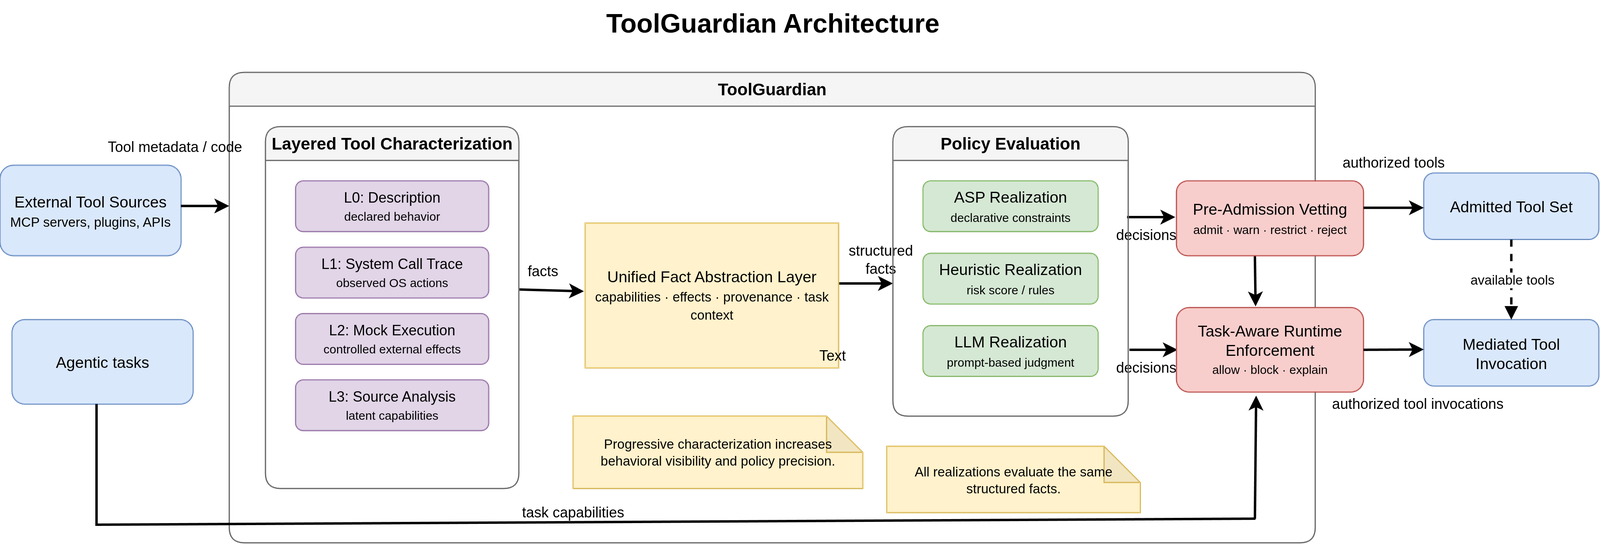
针对这一困境,研究团队提出了 ToolGuardian。该框架将 Agent 工具安全重构为一个双阶段的声明式策略问题:在工具进入系统前进行严格的前置准入审查(Pre-admission Vetting),并在实际任务执行中进行任务感知的运行时授权(Task-aware Runtime Authorization)。其核心创新在于彻底将“行为证据提取”与“安全决策逻辑”解耦,通过渐进式表征捕获工具的“表里不一”,并首次将回答集编程(Answer Set Programming,简称 ASP)这一经典的声明式逻辑求解范式引入 Agent 工具治理。在 16 个真实开源 MCP 工具及其恶意变体、20 个端到端运行时场景的严苛评测中,基于 ASP 的 ToolGuardian 在准入审查中实现了 0.86 的拒绝类别 $F_1$ 值与 88% 的准确率,并在完全规则下精准拦截了全部运行时违规操作。
为什么大模型裁决和传统代码扫描都靠不住?
要理解 ToolGuardian 的设计意图,首先需要审视目前 Agent 工具安全防御上的结构性失效。许多现有的防护思路倾向于“端到端”解决问题:要么写一套静态扫描脚本,在安装包或仓库中找高危关键词;要么把工具代码和系统 Prompt 一同塞给 GPT-4 这一级别的模型,让 LLM 自己判断“该工具是否安全”。
这种做法在复杂的 Agent 协同场景中极为脆弱。首先,接口层与实现层存在天然的信息鸿沟。恶意工具完全可以把接口描述写得无比规范、人畜无害,而将恶意逻辑隐藏在动态拼接的指令、环境变量判断或偶发触发条件中。单看描述必定漏报,而仅做静态扫描又常常因为缺乏上下文产生严重的误报,甚至把合法的系统管理工具直接拒之门外。
其次,现有的安全防护往往忽略了“组合风险”和“任务语境”。在现代 Agent 体系中,单个工具的行为可能在孤立状态下是完全合法的。例如,工具 A 读取本地配置文件,工具 B 负责调用远程 API 发送汇报。在代码级别单独审视这两个工具,二者都不具备绝对恶意;但如果 Agent 在同一个工作流中先调用 A 获取系统私钥,紧接着把数据作为参数喂给 B 发送出去,这就构成了严重的数据外泄(Exfiltration)。这种危险只有在关联了具体的任务目标与多工具调用顺序后才会浮出水面。无论是硬编码的一组 if-else 规则,还是缺乏严谨形式化逻辑的 LLM 自主推断,都难以在面对多步骤、长链路调用时提供可解释、可审计且零随机性的裁决。
ToolGuardian 破局的关键,正是将“收集行为证据”和“制定安全策略”切分为两个独立阶段。系统首先客观提取工具在各个层级暴露出的行为事实(Facts),随后将这些结构化事实交付给严密的形式化规则引擎进行定夺,从机制上杜绝了黑盒判断与直觉推断带来的模糊性。
渐进式表征:撕开“表里不一”的伪装
为了让策略引擎拥有足够扎实的研判依据,ToolGuardian 建立了一套纵深的“渐进式表征”(Progressive Characterization)体系。工具的真实行为往往被层层包裹,单一维度的观测必定存在死角,ToolGuardian 将证据提取划分为由浅入深的四个累积层级:
-
L0 级描述表征(Description-based):从工具自带的文档、README、配置清单以及参数声明中提取声明意图。这层证据代表了工具开发者向外部宣称的“合法功能”,但由于完全由不受信的第三方提供,ToolGuardian 仅将其作为基准预期,决不作为安全背书。
-
L1 级系统调用追踪(System-call Traces):在底层操作系统层面监控工具运行时发起的系统调用,捕获文件读写、套接字连接、子进程派生等底层动作。这一层提供了脱离文档描述的物理证据,但其缺陷在于缺乏应用层语境,无法直接区分正常的 API 通信与隐蔽的数据渗漏。
-
L2 级沙箱模拟执行与观测效果(Mock Execution & Observed Effects):在受控的沙箱环境中,使用典型输入并对外部依赖进行 Mock,实际执行工具代码。系统记录这一过程中工具产生的高级效应,包括外发请求的端点类型、访问的敏感数据类别、执行的 Shell 指令以及持久化状态变动。这一层能够抓到大部分动态触发的恶意行为。
-
L3 级静态源码抽象语法树分析(Static AST Analysis):当工具以开源形式提供时,ToolGuardian 会通过抽象语法树分析其潜在逻辑,挖掘那些未在 L2 动态测试中被触发的条件分支、休眠逻辑或高危 API 组合。
这四层证据并非割裂存在,而是累加构建为累积知识包($P_0$ 到 $P_3$)。更关键的是,ToolGuardian 引入了专门的效果一致性检查(Effect Conformance)。系统会自动对比 L0 中“宣称做的事情”与 L2 中“实际做的事情”。例如,一个自称纯本地 Markdown 格式化工具,却在沙箱执行中对公网 IP 建立了 HTTP 连接;或者一个文件重命名插件却暗中修改了系统级配置文件。这种“声明意图与实测效果的偏差”会被直接提炼为高等级的安全事实,成为后续策略拒绝工具的核心依据。
所有来自这四层的异构信息,最终都会被清洗、归一化为标准的策略事实事实库(Fact Base)。这种统一的事实表达,不仅剥离了底层操作系统和编程语言的实现细节,也让不同的策略推断机制能够在完全相同的输入契约下公平竞技。
声明式逻辑:用 ASP 替代黑盒大模型做安全裁决
拥有了标准化的行为事实之后,由谁来下达最终的拦截指令?这正是 ToolGuardian 最具理论深度的部分。研究团队没有盲目随波逐流地在中间挂一个负责仲裁的大模型,而是引入了逻辑编程领域的利器——回答集编程(ASP)。
ASP 是一种面向复杂组合搜索与约束求解的形式化逻辑编程范式。与传统的命令式编程(如写满分支判断的 Python 脚本)不同,在 ASP 规则中,安全架构师只需要声明“什么样的状态是绝对不被允许的”以及“权限推导的逻辑公理”,底层求解器(如 Clingo)就会根据输入的事实库自动计算出唯一的稳定模型(Stable Models)。
在 ToolGuardian 的设计中,安全判定被清晰划分为两个维度:
前置准入审查负责评估工具本身的固有风险。ASP 策略在这里编码了最小权限原则与零信任架构:一旦发现工具存在隐蔽外联、未经声明的提权操作,或者存在 L0 与 L2 的显著效果冲突,系统将直接触发 deny(硬拒绝)规则。对于具有高危能力但在管理范围内受控的工具,策略还可以输出 restricted_admit(带限制准入),为其打上沙箱标签。
运行时授权则紧扣任务上下文(Task Context)展开。这正是形式化逻辑大显身手的领域。同样的网络请求操作,当当前任务定义为“获取公开股票数据”时,属于合法行为;但若前序步骤已经读取了本地密钥文件,ASP 规则中的信息流追踪公理(Information-flow Control)就会瞬间闭合,判定后续的外网访问构成高危组合动作,从而立即生成 block 决策。
相比于目前流行的“用大模型审大模型”方案,ASP 的优势在于严格确定性、完全可审计以及强大的组合约束能力。大模型在处理否定语义、多层因果嵌套和边界约束时不可避免地存在幻觉和随机波动,但在安全防御中,一次漏判就意味着整个系统的权限崩塌。ASP 的每一步决策都可以溯源到具体的逻辑规则满足链,给出的解释标签完全对应形式化命题,没有模糊地带。
实测结果与取舍:证据并不是越深越好
为了检验这一架构在实战中的效能,研究人员构建了一个包含 16 个 MCP 工具的测试基准。其中 8 个为真实的开源良性工具(涵盖 SQLite 管理、文件系统操作、Git 交互等),另外 8 个则是基于这些开源项目改写的恶意变体。这些变体完整保留了原工具对外宣称的描述和基础功能,但暗中植入了凭据窃取、数据篡改和资源耗尽等恶意行为。同时,评估涵盖了 20 个运行时场景,包括 12 个针对单次调用的原子场景和 7 个针对多工具链式调用的组合场景。
在核心的准入审查实验中,研究团队横向对比了 ASP 策略、传统命令式启发式规则(Heuristic)以及 120B 参数量级的开源前沿推理大模型(LLM Realization)。
| 证据层级 | 评估指标 | 启发式规则 (Heuristic) | LLM 策略实现 | ASP 策略实现 (ToolGuardian) |
|---|---|---|---|---|
| $P_0$ (仅文档描述) | Deny F1 / 准确率 | 0.44 (44%) | 未定义* (50%) | 0.56 (56%) |
| $P_1$ (+$L1$ 系统调用) | Deny F1 / 准确率 | 0.67 (62%) | 0.67 (62%) | 0.77 (75%) |
| $P_2$ (+$L2$ 模拟观测) | Deny F1 / 准确率 | 0.86 (88%) | 0.86 (88%) | 0.86 (88%) |
| $P_3$ (+$L3$ 静态源码) | Deny F1 / 准确率 | 0.76 (69%) | 0.82 (81%) | 0.82 (81%) |
(注:在 $P_0$ 阶段,LLM 由于缺乏足够代码证据不敢轻易给出直接拒判,Deny 召回为 0,因此 $F_1$ 未定义,仅输出警告)
实验揭示出了几个极为耐人寻味的安全工程权衡:
第一,证据深度带来的非单调效应。数据表明,从 $P_0$ 到 $P_2$,随着系统调用和沙箱动态观测事实的加入,各策略的检测能力全面跃升,并在 $P_2$(即结合了声明、系统调用与观测效果)达到峰值,ASP 实现了 0.86 的 $F_1$ 值与 88% 的准确率。然而,当进一步引入 $L3$ 静态源码分析时,综合指标反而出现了回落。
原因在于静态源码分析往往伴随着“过度近似”(Over-approximation)。静态 AST 会扫出代码中所有潜在的高危模块引入和底层调用,哪怕这些代码属于死代码分支或仅在极端维护模式下触发。过于敏感的启发式脚本在 $P_3$ 阶段误将 5 个正常的良性工具判为硬拒绝,导致实用性断崖式下跌。而 ASP 和 LLM 表现出更好的鲁棒性,通过更平衡的规则约束化解了部分误报,但依然反映出一个现实:在工具准入中,盲目堆砌静态代码特征并不一定会带来安全效用的正向收益,$P_2$ 层级表现出的动态效果一致性才是性价比最高的安全观测面。
第二,大模型在安全底线裁决上的“过度审慎”。在只提供接口描述的 $P_0$ 阶段,大模型展现出了典型的安全对齐副作用:它对恶意样本完全不敢输出极端的拒绝(Hard Reject),而是全部以保守的“警告”(Warning)了事。这在实际生产中会导致防线形同虚设。相比之下,ASP 依靠显式的形式化规则,能够直接对违背最小权限原则的声明给出坚决的拦截。
第三,运行时组合场景的全维度压制。在 20 个运行时场景的授权评估中,完全配置的 ASP 策略达成了 100% 的精准判定。消融实验显示,如果移除“效果一致性规则”,系统在部分伪装型调用的识别上会出现严重迟钝;而一旦剥离“组合约束规则”(Compositional Rules),系统在面对跨工具多步协同攻击(例如“合法读文件 + 合法发网络”构成的窃密链条)时,拦截成功率会出现暴跌。这充分印证了在 Agent 运行时环境中,安全边界必须从“关注单点行为合法性”转移到“关注信息流在工具链间的流动闭环”。
走向确定性的 Agent 安全新范式
ToolGuardian 的技术路线为当前狂热的 Agent 工具生态泼了一盆冷静的结构化冷水。它证明了一件事:在保护底层基础设施和敏感数据资产免受外部不受信工具侵害时,单纯依靠更大参数的大模型进行黑盒判定,不仅成本高昂、延迟不可控,更无法在合规性与确定性上提供数学意义上的保障。
通过将复杂的动态追踪、沙箱观测提炼为标准事实,再交由以 ASP 为代表的形式化逻辑引擎进行求解,ToolGuardian 展现出了一种全新的工程可能:让大模型专注于发挥其擅长的规划与生成能力,而将安全准入、权限流转与组合隔离牢牢锁死在确定性的声明式逻辑栅栏之内。
随着 Model Context Protocol 等开放标准的快速普及,第三方 Agent 市场正在复刻当年移动应用商店与开源软件包仓库的爆炸式增长。历史经验告诉我们,生态繁荣的背后往往紧跟着恶意软件的大规模滋生。ToolGuardian 所探索的这套“渐进式表征解耦 + 声明式逻辑授权”的框架,恰恰为今后构建自动化 Agent 应用商店安全审核网关、以及企业级 Agent 本地运行时沙箱,提供了一套高度严密且经得起形式化验证的安全底座。