TRIM:削减多达32.9%代码水份,轨迹反事实搜索半数成本逼近最小补丁
TRIM: Reducing AI-Generated CodeSlop via Agent Trajectory Minimization
让 AI 帮程序员修 Bug、跑测试甚至写功能,已经从实验演示变成了许多工程师的日常工作。从 SWE-Agent、OpenHands 到各类基于前沿大模型的自主编程智能体(Coding Agents),它们在大型代码仓库中探索、尝试、修补并最终提交补丁。大多数评估基准和开发团队通常只关注一个核心指标:这个补丁是否通过了现有测试?
ArXiv URL:https://arxiv.org/abs/2607.18161v1
现实中能够跑通测试的补丁,往往距离人类工程师认可的高质量代码相去甚远。代码智能体在漫长的推理与执行过程中,就像一个在黑盒系统里试错的调试者:尝试一次假设,写进几行日志或保护逻辑;推翻假设后,又转去另一个文件增加改动;在经历数轮循环终于撞上能够通过测试的方案后,先前探索残留的无用修改却未经清理,被打包塞进了最终的合并请求(Pull Request)中。来自哥伦比亚大学与 Google DeepMind 的研究团队在这篇工作中正式将这种现象定义为 CodeSlop——即 AI 生成代码中残留且在功能上毫无必要的编辑。
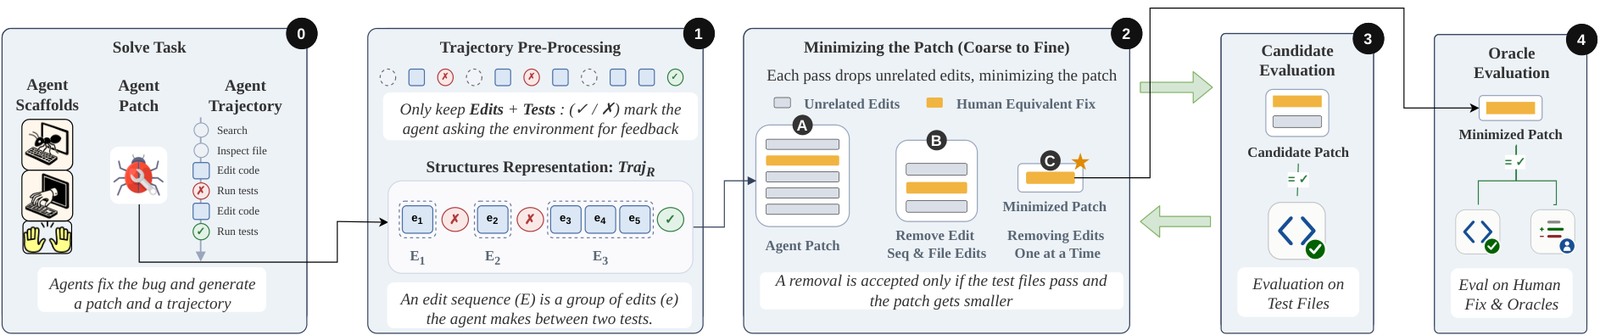
为了解决这种长期侵蚀代码库可维护性的隐性冗余,研究人员提出了名为 TRIM(Trajectory-guided Redundancy Identification and Minimization)的算法框架。TRIM 没有落入让大模型“重写补丁”的自监督陷阱,而是将补丁最小化视作基于智能体执行轨迹的反事实搜索问题。评测数据显示,TRIM 能够在保持极高功能正确性的前提下,将各类 Agent 补丁中的 CodeSlop 降低 17.9% 至 32.9%,且验证成本仅有传统经典差分调试(Delta Debugging)方法的一半左右。
从代码异味到 CodeSlop:Agent 探索留下的功能级烂摊子
软件工程领域长久以来都在关注代码异味(Code Smells)和代码膨胀。但在大模型时代,CodeSlop 呈现出了截然不同的特征。以往对 AI 生成内容中“垃圾成分”(Slop)的探讨,大多停留在静态层面,例如冗长的自然语言解释、不必要的语法包装或是过度重复的防御性编程。这类问题即便影响可读性,其中的代码在逻辑上依然构成了当前实现的一部分。
TRIM 的作者们指出,智能体生成的 CodeSlop 是一种纯粹的行为冗余(Functional Redundancy)。具体而言,它指代那些在补丁中即使被彻底连根拔起、整行删除,也完全不会改变软件在指定任务环境下所有可观测行为的修补片段。也就是说,一段代码在静态检查工具看来或许格式工整、命名规范且符合规范,但它在当前补丁里根本就是盲目试错留下的“化石”。
这种冗余的根源深深植根于 Agent 的工作机制中。面对复杂的 Bug,智能体通常需要经历“提出假设 $\to$ 修改代码 $\to$ 运行测试 $\to$ 接收反馈”的多轮循环。在早期的循环中,Agent 可能误以为内存泄漏是由模块 A 引起的,于是给模块 A 加上了一处空指针检查或引用计数变更;然而后续测试表明该改动无效,Agent 紧接着转向模块 B 做出了正确的修复。此时测试通过,Agent 判定任务达成并退出循环。然而,留在模块 A 里的无用修改并不会被自主撤销,它们成了静默躺在代码库中的暗礁。当大量的代码改动交给 Agent 持续迭代,代码库的熵增速度将远超人类维护者的重构能力。
为什么不能让大模型自我检查?
面对这种冗余,最直观的工程直觉通常是:把生成的补丁和测试报告再次喂给大语言模型,提示它“请精简这段补丁,去掉不需要的修改”。但实证结果表明,这种被称为 Agentic Minimization 的生成式方案表现极其糟糕。
让大模型自我审视自身补丁存在两大根本缺陷。首先是虚幻删减与功能破坏。大语言模型在没有严密外部执行验证的情况下,倾向于根据局部语法和常识猜测代码的相关性,极易删掉看似不重要但实际上维系边界条件的关键语句,导致本已修好的测试再度崩溃。其次是幻觉与偏航。在提示模型重构补丁时,大模型往往会忍不住“自由发挥”,不仅没有干净利落地做减法,反而引入了风格重构或新的未测试代码,进一步恶化了补丁的可信度。
研究团队在包含 4,500 余条轨迹的 Live-kBench 数据集上测试发现,使用前沿模型(如 Gemini-3-Flash)进行自我审视精简时,大量的精简尝试因无法通过测试或改变原有功能而被系统直接过滤。这揭示了一个关键判断:补丁最小化本质上是一个离散的约束搜索与验证问题,而不是文本再生成问题。
轨迹反事实搜索:TRIM 如何层层剥离冗余
既然不能依赖生成式重写,又该如何从补丁中精准剔除冗余?传统程序分析中有一类经典技术叫差分调试(Delta Debugging, DD),其核心思想是通过类似二分法的尝试,不断测试代码修改块的子集,从而找出最小补丁。然而在真实的复杂工程环境(例如 Linux 内核)中,运行一次验证套件可能需要耗费数十分钟。如果把补丁拆解为大量细小的代码块并做无差别组合验证,庞大的验证开销在现实中根本无法承受。
TRIM 的核心创新在于:把智能体的历史执行轨迹当成了剪枝的结构先验。
虽然最终提交的补丁是一张扁平的差异比对表(Git Diff),但在生成这个补丁的过程中,Agent 的每一步操作其实自带清晰的时序结构和因果假设。TRIM 首先对原始执行轨迹 $Traj$ 进行重构,剔除无关的环境探测命令,只保留代码编辑操作 $\mathcal{E}$ 与测试反馈请求 $\mathcal{FR}$ 构成的有序元组:
\[Traj_{R} = \left\langle(\mathcal{E}_{1},\mathcal{FR}_{1}),(\mathcal{E}_{2},\mathcal{FR}_{2}),\ldots,(\mathcal{E}_{k},\mathcal{FR}_{k})\right\rangle\]在重构出有效编辑后,TRIM 采用了一种自粗到细的层次化反事实搜索策略(Hierarchical Counterfactual Search):
-
编辑序列级剪枝(Edit Sequence Level):首先将两次反馈请求之间的所有编辑视作一个完整的修复尝试单元 $\mathcal{E}_i$。TRIM 直接提出反事实假设:“如果 Agent 当年根本没有做过第 $i$ 次尝试,现有的补丁还能否通过全部测试?”如果移除整组编辑后测试依然绿灯,系统便能以单次验证的代价,瞬间消除一整批连带的试错代码。
-
文件级剪枝(File Level):当粗粒度的序列不可再拆时,算法下沉到文件维度,尝试将某个被波及但可能无关的文件修改全盘撤销并验证。
-
原子编辑级剪枝(Edit Action Level):最后,算法深入到最小的代码行修改单元。在更窄的基础之上,逐一验证剩下的独立修改是否确实不可或缺。
在整个过程中,TRIM 引入了严格的不可逆约束:只有当候选反事实补丁在严苛的测试套件下表现出完全相同的行为,并且补丁总行数严格缩减时,这种删减才会被最终采纳。
为了兼顾不同工程场景对成本的敏感度,TRIM 提供了两种运行模式。带有一致最小化保证的 TRIM-G 模式会在每个粒度层级循环排查,直至达到局部不动点,确保最终留下的编辑子集具备 1-Minimality(即任意再删单条修改均会导致测试失败);而无需保证的 TRIM-NG 模式则对每个层级只执行单遍线性扫描,将算法的测试执行成本严格锁定在线性复杂度内。
实验检验:性能、效率与跨基准迁移
研究团队对 TRIM 的评估覆盖了多种前沿大模型(包括 Gemini-3-Pro、Claude-Opus-4.5 与 Claude-Sonnet-4)和四类主流的智能体框架(SWE-Agent、MiniSWE-Agent、OpenHands、CrashFixer)。
在涉及底层操作系统安全性修复的 Live-kBench 基准测试中,TRIM 展现出了极高的冗余压缩能力。实验表明,经过 TRIM-G 的层次化剪枝,不同 Agent 架构生成的补丁长度平均缩短了 17.9% 到 32.9%。更重要的是,在独立隐藏的基准测试集(Hidden Oracle Tests)检验下,这种大刀阔斧的代码剔除并未引发功能倒退,验证通过率与精简前几乎持平,Oracle 性能退化率在各模型与框架下均处于极低水平。单遍扫描的 TRIM-NG 同样表现惊艳,其精简程度极其接近全量 TRIM-G,但验证耗时显著下降。
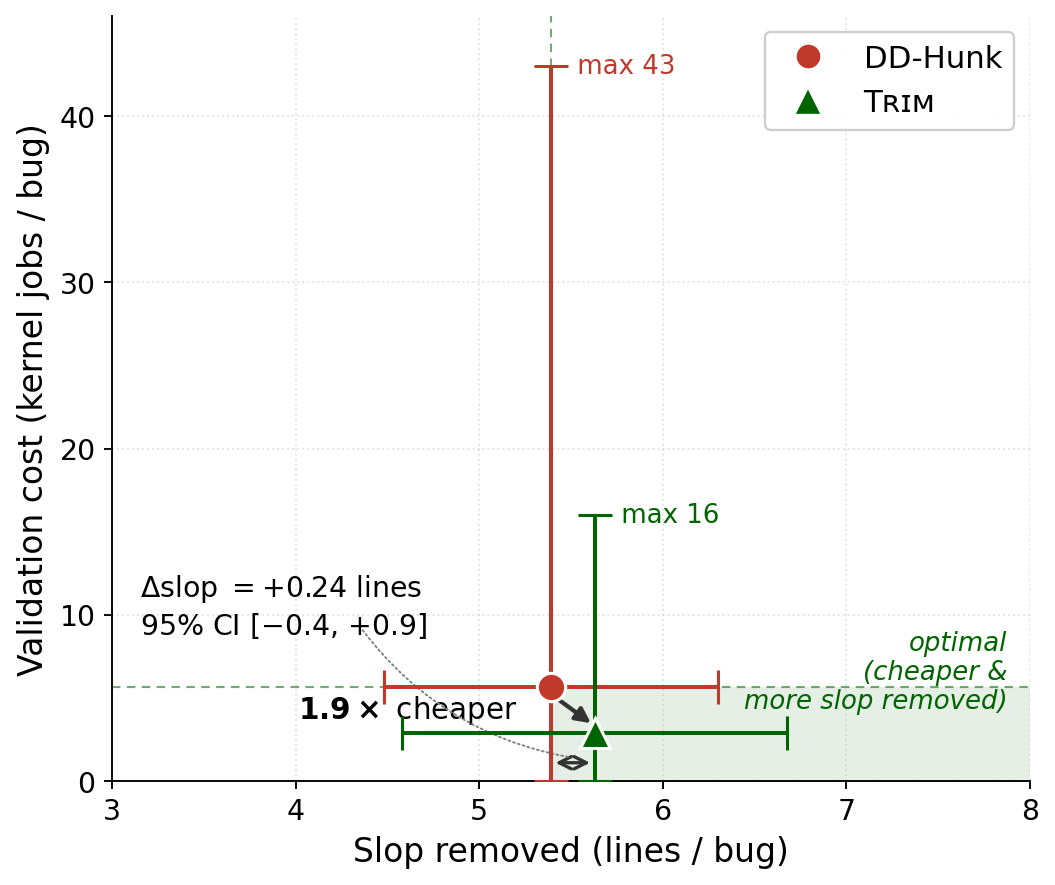
在与传统差分调试方案的对抗中,基于轨迹的先验优势得到了直观展现。研究人员将 TRIM 与针对 Git 代码块的差分调试变种 DD-Hunk 进行了横向对比。
如图所示,DD-Hunk 依赖盲目的分块组合测试,验证执行次数随着补丁规模的扩大呈现剧烈发散;而 TRIM 凭借从轨迹中提取出的因果层级,优先在粗粒度上排除成片的试错痕迹,在达到完全相同甚至更优的 CodeSlop 消除比例的前提下,将整体验证套件的执行次数降低了约 1.9 倍。对于测试套件庞大、编译执行耗时漫长的系统级软件开发而言,将验证成本腰斩意味着补丁精简流水线具备了真正落地的工程可行性。
在跨领域的泛化性测试中,研究团队进一步将 TRIM-G 部署到了广为人知的通用软件工程基准 SWE-Bench-Verified(选取了由 Claude 生成的 333 条真实开发轨迹)。虽然 SWE-Bench 中的任务与测试具有更动态、异构的特征,TRIM 依然稳定剔除了大量非必要修改,且在 99.1% 的成功修复案例中完全保全了原本的修复功能。此外,研究人员还观察到附带的积极收益:伴随功能冗余代码的剔除,代码在静态评估中的膨胀度(Verbosity)也同步呈现显著下滑。
自动化软件工程的冷思考:从“能跑就行”到“严谨交付”
TRIM 这篇研究给正在快速演进的 Agent 领域带来了一个清醒的警示:单纯依赖基准通过率,正在掩盖 AI 编程工具对代码库造成的渐进式破坏。
过去一年多,各大技术团队不断刷新 SWE-Bench 的榜单得分,但很少有人审视那些打着“Passed”标签的合并请求底层到底掺杂了多少试错残留。如果缺乏对生成轨迹的因果追踪与行为验证,任由 Agent 自主累加代码,未来的代码库终将被海量的“能跑但没人敢动”的 CodeSlop 填满。
TRIM 的价值在于,它跳出了“用模型修模型”的思维定势,展示了一种将智能体历史过程信息(Execution Trajectory)与形式化搜索约束相结合的优雅范式。在代码智能体逐步走向深水区的当下,这项工作提醒我们:一个优秀的 AI 工程师不仅要懂得如何找到出路,更要学会在离场前,干净地抹平所有试探的脚印。