工具检索不是单打独斗!HYSET首提集合级超边预测,Agent通过率提升13.1%
Tools Are Not Islands: Set-Level Tool Retrieval for LLM Agents via Query-Conditioned Hyperedge Prediction
在构建基于大语言模型(LLM)的自主智能体(Agent)时,调用外部 API 工具已经成为解决复杂真实任务的标准路径。然而,面对包含数万个真实 API 的庞大生态,如何为用户的特定查询准确挑选出所需工具,成了制约智能体性能的“隐形瓶颈”。
ArXiv URL:https://arxiv.org/abs/2607.25718v2
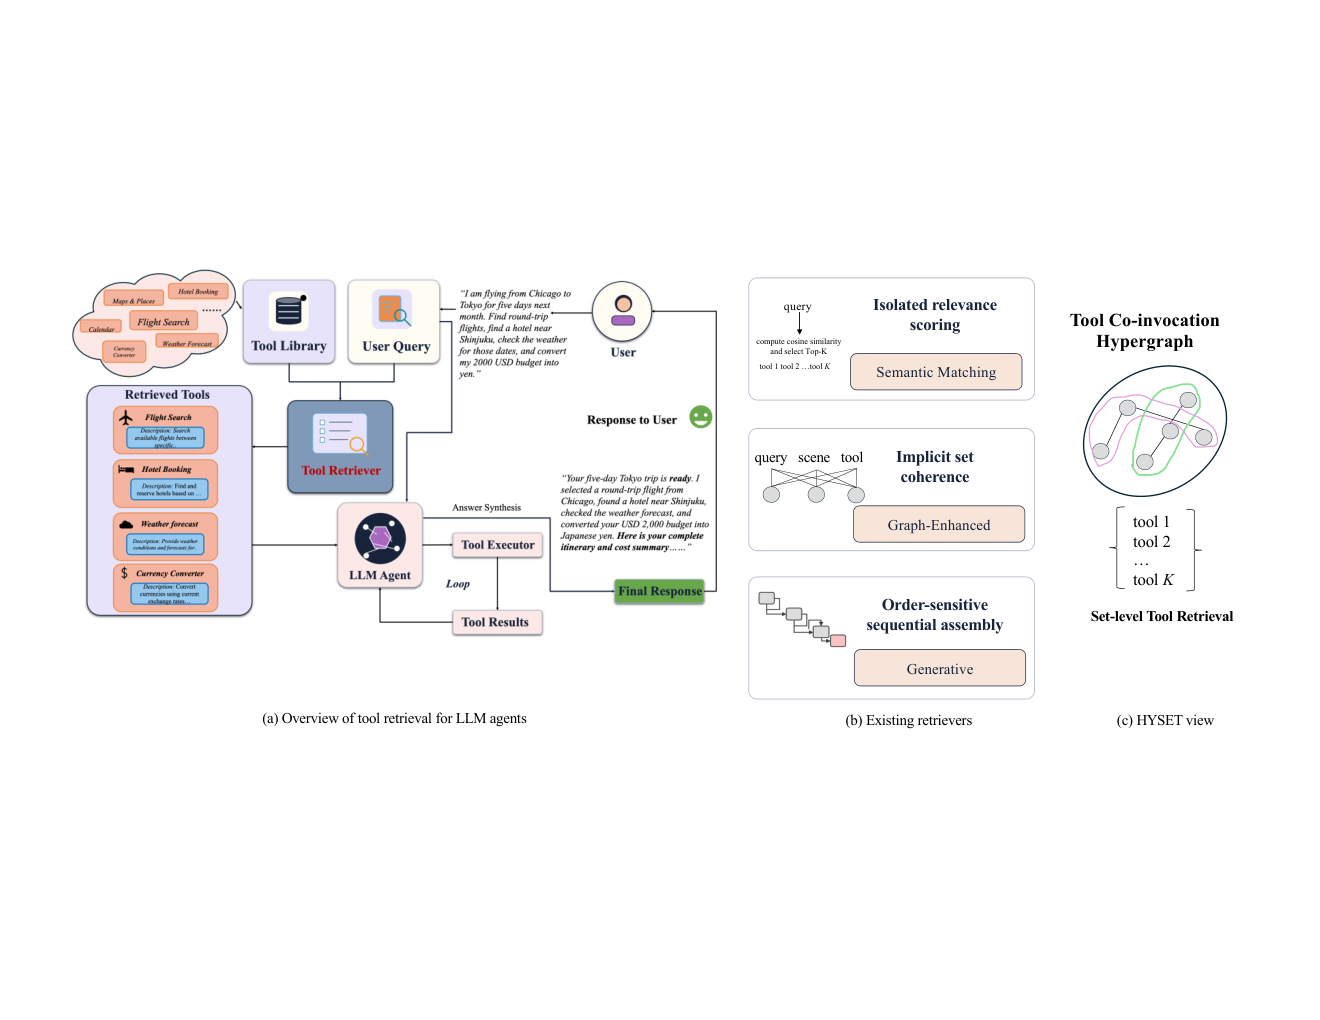
以往的技术路线默认将工具检索视为传统的信息检索任务:要么计算单个 API 描述与用户意图的语义相似度,要么依序逐个生成 API 名称。这种做法忽视了一个基本事实——工具不是孤岛(Tools are not islands)。真实世界中的复杂任务往往需要多个工具协同完成,工具集合的整体可用性绝非各个工具单独相关性的简单线性叠加。一个工具在孤立打分时可能排名垫底,但在组合中却是不可或缺的拼图;反之,几个高度重合的工具即使单项得分极高,堆叠在一起也无法覆盖任务的完整需求。
来自上海交通大学与香港理工大学的研究团队提出了 HYSET(HYperedge-based SEt-level Tool retrieval)。该研究首次将大模型智能体的工具检索重构为基于工具共调用超图的条件超边预测问题,直接将“候选工具集合”作为整体进行打分,并设计了随集合容量自适应调整的交互矩阵,以捕捉多工具间的协同机制。
实验表明,HYSET 在主流基准 ToolBench 上将表征工具完整覆盖度的指标 COMP@5 相对提升了 11.6%,端到端任务执行通过率(Pass Rate)最高提升了 13.1%。这项工作不仅打破了工具独立打分的固有范式,也为工具密集型 Agent 架构提供了一个无需改动下游模型、即插即用的前置筛选框架。
为什么说现有工具检索从根上“审题偏差”?
现存的工具检索技术主要可以归纳为三类范式:
-
语义匹配检索:以 BM25 等稀疏检索,或 Contriever、Sentence-BERT 为代表的稠密双编码器为主。这类方案为每个 API 独立计算匹配分,选出 Top-$k$。它的致命伤在于将“集合效用”等同于“单点效用总和”。实际测试中,微调后的 Contriever 在 ToolBench 上的 Recall@3 能达到 68.6%,但其完整召回所需集合的比例(COMP@3)却跌落至 39.7%。
-
图增强检索:例如 COLT 等方法引入了用户-场景-工具图来进行协同表示学习。但这类方法最终在训练后仍将协同信号蒸馏回单个工具的静态表征中,在推理时依然依靠单工具的 Top-$k$ 截断,对集合层面的协同性只是做了隐式近似。
-
生成式检索:如 ToolGen 依托自回归模型依序输出工具标识符。然而,自回归依靠局部条件概率一步一步拼凑序列,整个候选集合的全局兼容性只有在完全生成完毕后才能见分晓,无法在候选集之间进行显式的对比与打分。
上述范式都没有直接回答一个核心痛点:多工具交互具有强烈的组合效应与冗余排斥效应。
举一个非常具体的场景:用户输入“下个月我要从芝加哥飞往东京待五天,帮我找往返机票、预订新宿附近的酒店、查看这些日子的天气,并把两千美元预算换算成日元”。在这个四任务需求中,标准答案集合是 ${\textit{Flight}, \textit{Hotel}, \textit{Weather}, \textit{Currency}}$。
如果交给稠密检索器,由于用户 query 里充满航空术语,模型会对 Flight、CheapFlight、FlightTracker 等多款功能重合的机票 API 打出高达 0.9 左右的极高相似分,而把 Weather 和 Currency 压得很低。最终检索出的候选集会被三个功能冗余的机票工具挤满,导致天气和货币换算两个子任务彻底失序。
更深层的一点在于,工具之间的相容性是随集合大小(Cardinality)动态变化的。在两个工具的小任务中,汇率工具和天气工具几乎不可能共同出现(在 ToolBench 中共现率仅为 0.4%);但在四个工具的跨国差旅任务中,两者共同出现的概率骤增到了 23%。这种非线性的高阶组合规律,是传统的独立评分和两两关系图无法有效建模的。
把工具集合看作超边:HYSET 的数学重构
针对这两个问题,HYSET 从根本上重写了工具检索的形式化定义:如果把所有可调用的工具集合看作超图 $\mathcal{H}=(\mathcal{V},\mathcal{E})$ 的节点 $\mathcal{V}$,那么每一次针对复杂任务的多工具共同调用,本质上就是超图上的一条超边 $E \subseteq \mathcal{V}$。
给定自然语言查询 $x$,检索的目标不再是输出一个排序列表,而是从最大基数为 $M$ 的超边候选空间 $\mathcal{E}_M$ 中,寻找联合效用最大的那个候选集 $\widehat{E}(x)$:
\[\widehat{E}(x) = \arg\max_{E \in \mathcal{E}_M} F_\theta(x, E)\]在这个形式下,整个工具集合成为了打分不可分割的基本单元。
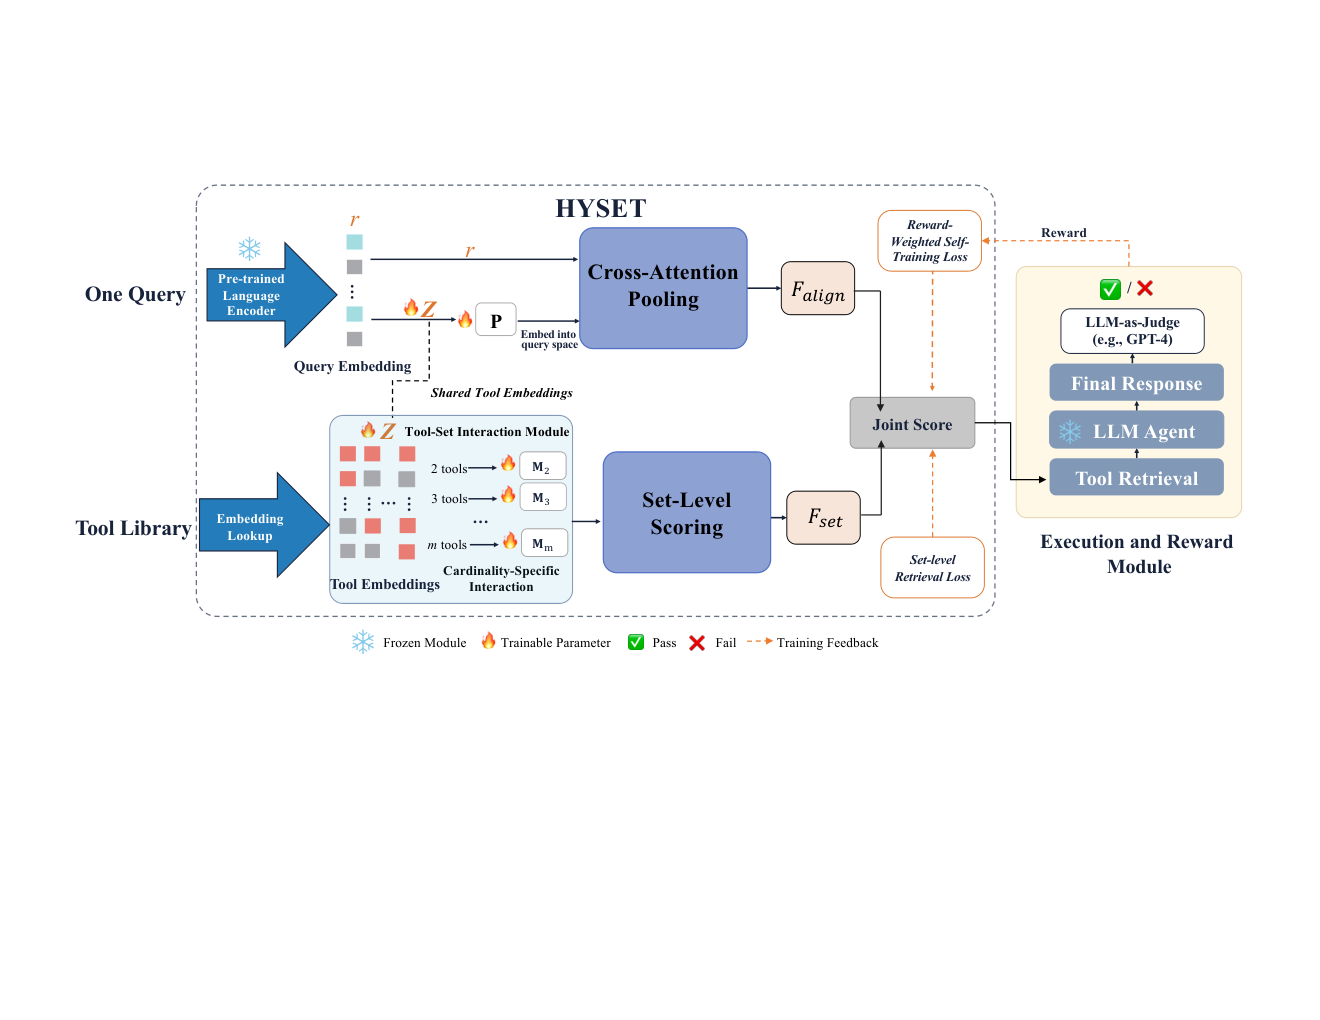
为了让这个打分函数既能精准捕捉高阶协同,又在计算上切实可行,HYSET 将参数化打分函数解耦为两项:集合内在相容性 $F_{\mathrm{set}}(E)$ 与查询-集合对齐度 $F_{\mathrm{align}}(x, E)$。
\[F_\theta(x, E) = F_{\mathrm{set}}(E) + F_{\mathrm{align}}(x, E)\]集合内在相容性与基数特定交互
如果候选集合 $E$ 包含 $m$ 个工具,如何评估这 $m$ 个工具凑在一起的合理性?HYSET 采用了基数特定的双线性交互形式:
\[F_{\mathrm{set}}(E) = \sum_{1 \leq a < b \leq m} \mathbf{z}_{j_a}^{\top} \mathbf{M}_m \mathbf{z}_{j_b}\]这里,每个工具节点拥有一个表征向量 $\mathbf{z}$,而矩阵 $\mathbf{M}_m$ 是专门为规模为 $m$ 的集合定制的可学习交互矩阵。
这个设计的巧妙之处在于理论上的高阶诱导能力。在协作博弈论与集合函数理论中,利用莫比乌斯反演(Möbius inversion),任意集合函数都可以被唯一分解为各阶交互项。论文在定理 1 中证明:当且仅当所有规模对应的交互矩阵完全相同时(即 $\mathbf{M}_2 = \mathbf{M}_3 = \dots = \mathbf{M}_M$),该集合打分函数才是严格两两可分解的(不存在三阶及以上的高阶交互)。
换句话说,只要令矩阵 $\mathbf{M}_m$ 随集合容量 $m$ 独立演化,矩阵差值(例如 $\mathbf{M}_3 - \mathbf{M}_2$)就会在数学上自然诱导出高阶超边协同效应,而完全不需要引入极其昂贵的三阶或多阶张量运算。
查询-集合感知对齐
面对输入查询 $x$,工具集合中每个成员对语义覆盖的贡献并不是均等的。HYSET 采用多头注意力机制,令集合内部的所有工具表征共同参与计算注意力权重 $\alpha_k(x, E)$:
\[F_{\mathrm{align}}(x, E) = \mathbf{r}(x)^{\top} \sum_{k=1}^m \alpha_k(x, E) \mathbf{P} \mathbf{z}_{j_k} = \sum_{k=1}^m \alpha_k(x, E) \ell(x, t_{j_k})\]这意味着,工具 $t$ 在匹配当前 query 时的打分贡献,取决于它与集合中其他工具是如何搭配的。如果集合中已经存在了机票工具,模型就会通过注意力权重自适应稀释第二款机票工具的贡献,从而倒逼系统去挑选能够覆盖其他意图的互补工具。
克服组合爆炸:负采样训练与两阶段重排
将打分单元提升到集合级别后,最直接的技术挑战就是计算量爆炸。如果工具库有数万个 API,在最大容量为 $M$ 的空间里,可能的子集数量是天文数字,既不可能穷举训练,也无法在推理时全量扫描。
在训练阶段,HYSET 引入了高信息量的负采样策略。针对每个带标签训练样本 $(x_i, E_i^\star)$,构建包含 $K_{\mathrm{neg}}-1$ 个负样本集合的对比池,负样本按固定比例严格配比:
-
50% 同样大小的随机负样本(Size-matched negatives);
-
30% 来自同一 Batch 内其他任务的标准答案集(In-batch negatives);
-
20% 硬负样本(Hard negatives),即把标注集合中的一到两个工具替换为其表征空间中最接近的近邻工具。
此外,由于人工标注的工具集并不一定是能够解决任务的唯一可行解,HYSET 进一步引入了下游智能体实际执行环境的奖励信号。利用自训练损失 $\mathcal{L}_{\mathrm{self}}$,当模型预测出的候选集能够成功驱动智能体完成任务并获得奖励 $\rho_i$ 时,该集合也会被作为正向伪标签进行强化更新。
在推理阶段,HYSET 采用两阶段解耦设计,确保毫秒级的响应延迟:
-
初筛阶段:针对单点工具,将单元素集合带入打分公式,退化为快速单点检索,从全库中选出规模适中的候选子池(例如 $K_{\mathrm{pool}}=20$)。
-
集合重排阶段:仅在这 20 个候选工具所构成的受限子集空间内进行超边打分。在 $M=5$ 的设定下,只需对 21,699 个候选组合进行并行张量打分,耗时完全可控,且能完整输出任意可变长度的最佳工具子集 $\widehat{E}(x)$,直接移交给下游冻结的 Agent 执行。
实验结论:更全面的工具覆盖,换来更高的执行通过率
该研究以包含 13,860 个真实可用 API 的 ToolBench 为基准,并进一步在 UltraTool 上检验泛化性。下游智能体统一使用冻结参数的 ToolLLaMA-2-7B-v2,评估检索的召回率(Recall@$K$)、排序质量(NDCG@$K$)、集合完整度(COMP@$K$),以及真实调用执行的通过率(Pass Rate)。
主实验对比
如表 1 所示,无论是搭载 BERT-base 还是 Qwen2.5-1.5B 骨干网络,HYSET 在所有指标上均显著超越了包括 BM25、Contriever、ToolLLaMA-Retriever、ToolRerank、COLT 以及 ToolGen 在内的所有基线。
最值得关注的是衡量“候选集是否完整包含所有必要工具”的 COMP@5 指标。相比以往最强的生成式模型 ToolGen,HYSET(BERT)的 COMP@5 达到了 77.55%,相对提升达 10.8%;换用 Qwen 骨干时,COMP@5 进一步拉升到 78.13%,相对提升达 11.6%。
这种工具集合完整性的提升直接折射在下游的任务执行上。在 ToolBench 官方的 GPT-4 裁判评测下,HYSET 驱动的 Agent 端到端通过率从主流基线的 58%~63% 水平跨越至 69.69%(BERT)与 71.11%(Qwen),相对提升最高达 13.1%。通过两两配对 Bootstrap 检验与 McNemar 显著性检验,各项指标的提升均具有统计学意义($p < 10^{-4}$)。
即便剔除执行反馈带来的加成、仅使用纯标注数据进行训练,HYSET(BERT)的 COMP@5 依然录得 77.02%,比 ToolGen 高出 10.0% 相对值,证明超边建模机制本身就是提升性能的主因。
消融实验与架构探索
为了验证各个核心机制的贡献,论文对核心模块进行了剥离测试(见表 2):
-
去掉超边集合打分 $F_{\mathrm{set}}$:COMP@5 骤跌 13.1%,端到端通过率大幅下降 16.8%,直接证实了“集合级协同信号”是决定最终任务成功率的核心引擎。
-
去掉基数特定交互矩阵(退化为共享矩阵 $\mathbf{M}$ 或单位阵 $\mathbf{I}$):模型表现出显著的性能回退。在对比实验中,使用基数不可知矩阵的方案在 COMP@5 上落后 HYSET 近 4 个百分点;即使引入参数量更大的 DeepSets 或 Set Transformer,HYSET 依然在效率和准确率上保持着 6.4% 的相对优势。这充分验证了定理 1 的洞见:根据集合大小动态适配工具间交互,是拟合真实调用场景的必要手段。
-
少样本迁移能力:在面向未见过的 API 类别或孤立领域时,HYSET 展现出极高的数据效率。实验表明,每个类别仅需 5 个标注样例进行微调,HYSET 就能恢复全监督状态下 93.2% 的检索效能,为冷启动生态中的工具扩充提供了切实可行的工程路径。
对未来智能体工程的启示
HYSET 的提出在 LLM 检索与工具系统之间划出了一条清晰的界线:工具检索不等于文档检索。
文档检索追求的是相关文档的相关度排序,多篇文档之间存在冗余通常不会带来致命破坏;但智能体工具调用是一个强协作、弱容错的执行回路。下游模型在处理工具上下文时注意力预算极其宝贵,且不同工具之间存在明确的前后依赖、状态交接和互斥约束。
这项研究给从业者带来两点启发:
其一,在工程落地时,不必将全部压力放在下游 Agent 极其有限的上下文窗口里去“大海捞针”,也不必指望用超长 Context 吞下整个 API 库;将“工具协同兼容性”前置在检索召回环节,以极小的轻量化参数量(HYSET 训练参数仅 13.59M,远小于主模型)进行集合超边打分,能以更低的时延和成本换来更高的任务成功率。
其二,超图形式天然适用于多对多交互关系。在未来涉及多智能体协同(Multi-Agent)、工作流插件编排等更为复杂的系统级场景中,这种面向“集合作为一等公民”的超边预测建模,或将展现出更广阔的通用潜力。