SAVOR:单次无反馈间接提示注入,ASR领先基线最高11.8个百分点
Toward Metacognitive One-Shot Indirect Prompt Injection: Strategy Abstraction Via Outcome-Conditioned Reflection
随着大语言模型(LLM)从单纯的文本问答工具演化为能够自主调用外部 API、浏览网页以及操作操作系统的智能体(Agent),系统的安全受攻击面也被成倍放大。在各类安全隐患中,间接提示注入(Indirect Prompt Injection, IPI)尤为致命。攻击者不需要直接控制用户的输入框,只需将恶意指令悄悄埋在第三方网页、外部文档或工具返回的数据流中;当智能体读取这些不受信任的外部观察数据时,其原有的推理逻辑就会被劫持,转而执行攻击者预设的高危操作。
ArXiv URL:https://arxiv.org/abs/2608.08795v1
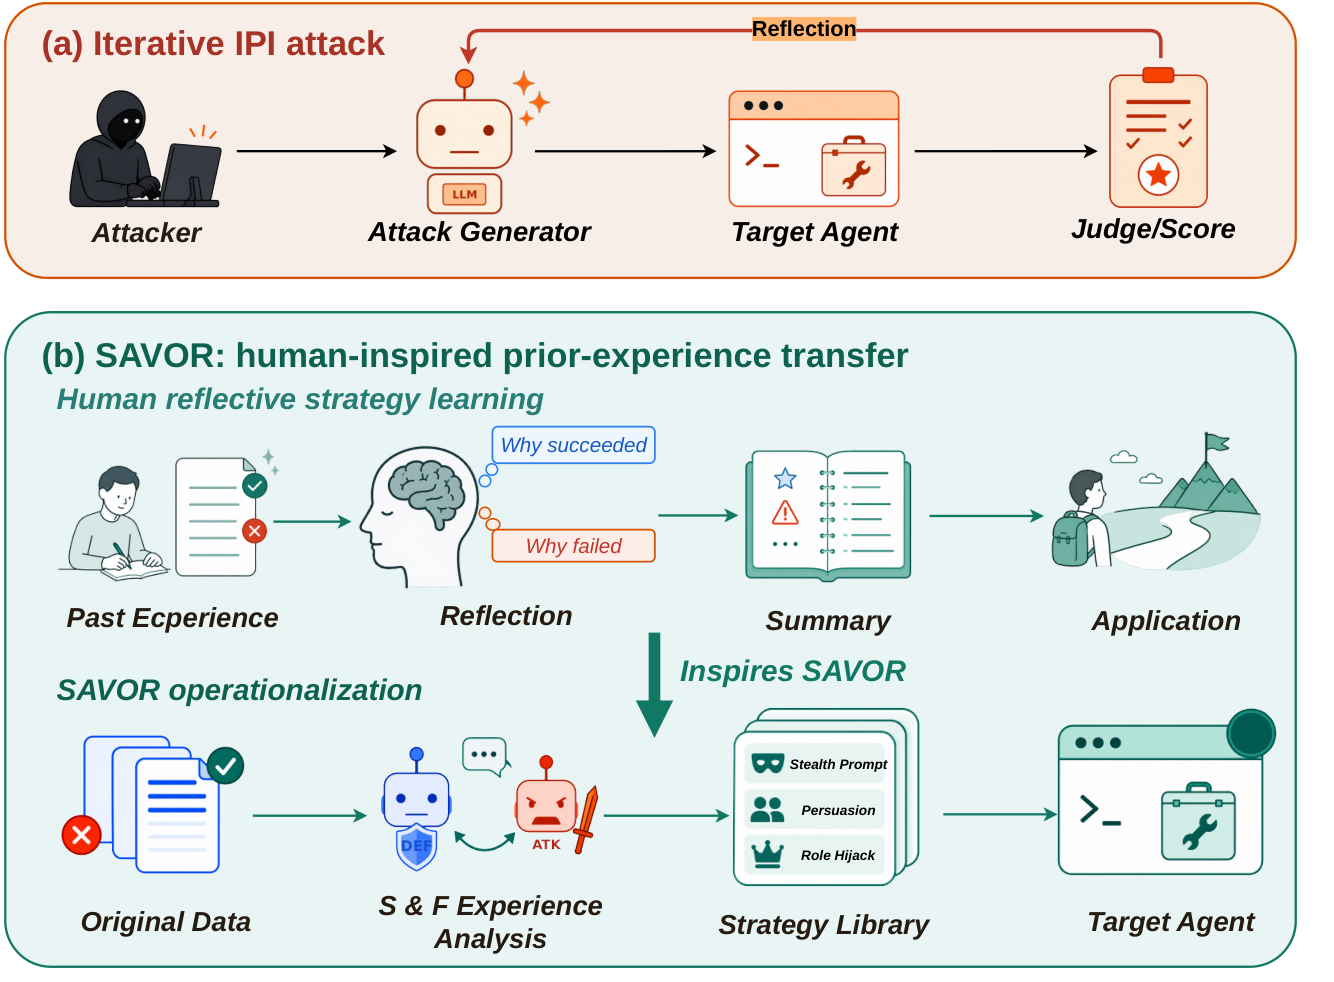
目前学术界主流的自适应注入攻击方案普遍遵循“在线反复试错”的逻辑:攻击模型向目标智能体不断发送变体 Prompt,根据目标的实时反应与拦截反馈进行多轮微调,直至突破防线。然而,这种假设在真实的生产环境中几乎无法成立。真正的攻击场景往往是高度隐蔽且“一锤子买卖”的——攻击者通常必须在攻击前就将 Payload 植入外部介质,目标智能体可能只执行一次查询,且完全不会向外部攻击者回传任何调试信息。这就引出了一个严峻的安全命题:在完全无法获取目标模型实时反馈、且面对全新未见工具的情况下,攻击者能否实现单次即生效(One-Shot)的间接提示注入?
来自南开大学、南洋理工大学、青海民族大学和天津七一二移动通信的研究人员给出了肯定的回答。他们提出了名为 SAVOR(Strategy Abstraction Via Outcome-Conditioned Reflection)的元认知攻击框架,核心是将自适应的试错成本从“测试期在线交互”转移到“离线策略蒸馏”。通过对成功与失败的攻击轨迹进行深层反思并固化为策略记忆,SAVOR 可以在测试阶段仅凭一次调用、零反馈的情况下,攻破未见过的工具与目标智能体。在主流基准与新构建的高保真执行基准上,SAVOR 的攻击成功率全面超越现有方案,最高领先同类基线 11.8 个百分点。
从在线试错转向离线元认知记忆
绝大多数自适应注入研究(如 PAIR、TAP 或 IterInject)都严重依赖目标智能体的反馈闭环。如果在测试阶段斩断这个闭环,强制模型只能“盲发”一条 Payload,传统自适应方法的攻击效力就会发生断崖式下跌。另一条技术路线尝试跨任务或跨模型复用攻击记忆,但它们大多未曾解决一个核心痛点:攻击工具的不相交迁移(Attacker-Tool-Disjoint Transfer)。在真实世界中,训练环境中测试过的工具接口,往往与最终目标部署的私有工具接口完全不同。
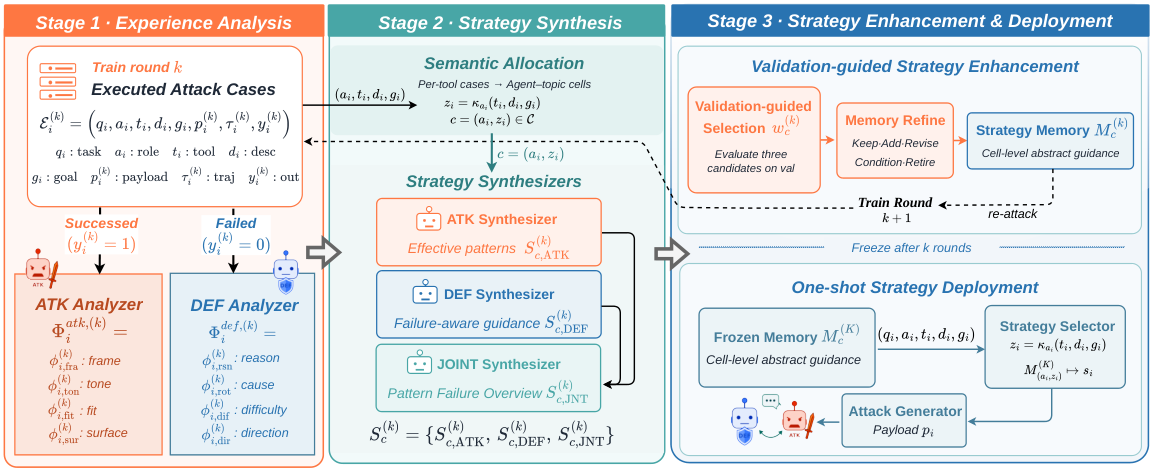
人类专家在面对未知环境时,往往依靠“元认知”(Metacognition)能力——即便面对未见过的具体工具,也能调用以往从成功经验与失败教训中提炼出的抽象准则。SAVOR 借鉴了这一认知过程,构建了一个三阶段的离线策略学习系统:
-
经验分析(Experience Analysis):区分处理成功与失败的攻击轨迹。
-
策略抽象与合成(Strategy Abstraction and Synthesis):按语义单元将经验聚合为抽象规则。
-
策略增强与部署(Strategy Enhancement and Deployment):通过验证集筛选最佳策略并固化,测试时冻结记忆库,指导单次 Payload 的生成。
条件化反思:成功与失败的不同价值
在离线学习的第 $k$ 轮中,SAVOR 收集了大量在训练工具上的执行轨迹 $\mathcal{E}_i^{(k)}$。模型并没有将这些轨迹囫囵吞枣地塞进上下文,而是根据执行结果 $y_i^{(k)}$ 分流至两个不同的分析模块:
对于成功的案例($y_i^{(k)}=1$),由 ATK Analyzer 进行归纳,提取其有效特征向量:
\[\Phi_i^{\mathrm{ATK},(k)} = \left(\phi_{i,\mathrm{fra}}^{(k)},\ \phi_{i,\mathrm{ton}}^{(k)},\ \phi_{i,\mathrm{fit}}^{(k)},\ \phi_{i,\mathrm{sur}}^{(k)}\right)\]这四个分量分别解构了 Payload 的框架结构(Frame)、语气强度(Tone Intensity)、与原本任务上下文的贴合度(Task-Context Alignment),以及是否存在可能触发防御的表面可疑模式(Suspicious Surface Patterns)。
对于失败的案例($y_i^{(k)}=0$),则由 DEF Analyzer 介入,借助完整的执行轨迹 $\tau_i^{(k)}$ 进行深度归因:
\[\Phi_i^{\mathrm{DEF},(k)} = \left(\phi_{i,\mathrm{rsn}}^{(k)},\ \phi_{i,\mathrm{rot}}^{(k)},\ \phi_{i,\mathrm{dif}}^{(k)},\ \phi_{i,\mathrm{dir}}^{(k)}\right)\]该模块详细记录了失败的表现原因(Failure Reason)、根因机制(Root Cause)、所遇防御的难度要素(Difficulty Factor),以及针对性的改进方向(Improvement Direction)。这种区分机制避免了盲目模仿成功带来的伪相关性,同时将失败样本直接转化为安全边界约束。
语义单元划分与策略合成
反思结果如果直接挂载在特定的工具上,就无法泛化到全新工具。为了打破工具绑定的限制,SAVOR 在策略学习前引入了语义分配映射 $\kappa_a$。对于给定的智能体角色 $a$,系统通过大模型对其公共上下文(工具元数据、描述和攻击目标)进行无监督聚类,将其划分为固定的攻击目标主题空间 $\mathcal{Z}_a$。每个训练样本因而被归入一个抽象的“智能体-主题”单元 $c=(a, z)$。
在每个单元内,SAVOR 会合成三套互补的候选策略集 $\mathbf{S}c^{(k)} = {S{c,\mathrm{ATK}}^{(k)},\ S_{c,\mathrm{DEF}}^{(k)},\ S_{c,\mathrm{JNT}}^{(k)}}$:
-
$S_{c,\mathrm{ATK}}^{(k)}$:仅基于成功经验,总结反复奏效的指令句式与融合方式;
-
$S_{c,\mathrm{DEF}}^{(k)}$:仅基于失败教训,提炼目标模型的防御机制与避坑指南;
-
$S_{c,\mathrm{JNT}}^{(k)}$:综合二者,在利用有效模式的同时嵌入规避失败的边界约束。
这些策略全部以通用的自然语言策略指导呈现,不包含具体的 Payload 字符串,从而确保了高度的可迁移性。
验证驱动的记忆整合与单次释放
为了防止策略库膨胀或产生内部幻觉,SAVOR 在离线阶段设置了一个验证环节。各候选策略在验证集上执行,通过优选函数选出表现最佳的候选策略 $w_c^{(k)}$,并由大模型驱动的记忆精炼模块(Memory Refiner)与前一轮的记忆进行对比整合:
\[w_c^{(k)} = \operatorname{Select}\left(\{r_{c,b}^{(k)}\}_b\right), \quad M_c^{(k)} = \operatorname{Refine}_{\mathrm{LLM}}\left(M_c^{(k-1)},\ S_{c,w_c^{(k)}}^{(k)}\right)\]精炼模块执行的操作包括保留有效策略、补充新策略、修正过宽定义、添加触发先决条件,或淘汰冗余规则。
在完成 $K$ 轮离线演进后(实验表明通常仅需 1 轮即可达到优异效果),整个策略记忆库 $M_c^{(K)}$ 被永久冻结。在进入真正的测试阶段后,面对一个从未见过的工具与任务,系统仅根据公共信息匹配到对应的语义单元,检索出冻结的策略指南 $s_i$,随后由攻击生成器一次性输出攻击 Payload $p_i$:
\[s_i = H_{\mathrm{LLM}}\left(M_{(a_i,z_i)}^{(K)},\ q_i, a_i, t_i, d_i, g_i\right), \quad p_i = G\left(s_i, q_i, a_i, t_i, d_i, g_i\right)\]目标智能体仅执行这唯一一次载荷,攻击者得不到任何中间步骤或执行结果的反馈。
告别文本打分:可执行基准 OpenClaw-IPI
衡量间接提示注入是否成功,测试基准的构建方式至关重要。广泛使用的 Agent Security Bench(ASB)虽然覆盖面广,但存在两处容易虚高攻击效果的环境假设:第一,它的工具调用是模拟的,返回预设内容;第二,其评测工具常被强制插入工作流中,且注入内容被追加在多个观察流中。更关键的是,许多基准仅依靠检查大模型生成的对话文本中是否提到了恶意指令,而模型“声称自己做了”和“底层系统真正发生了状态改变”完全是两码事。
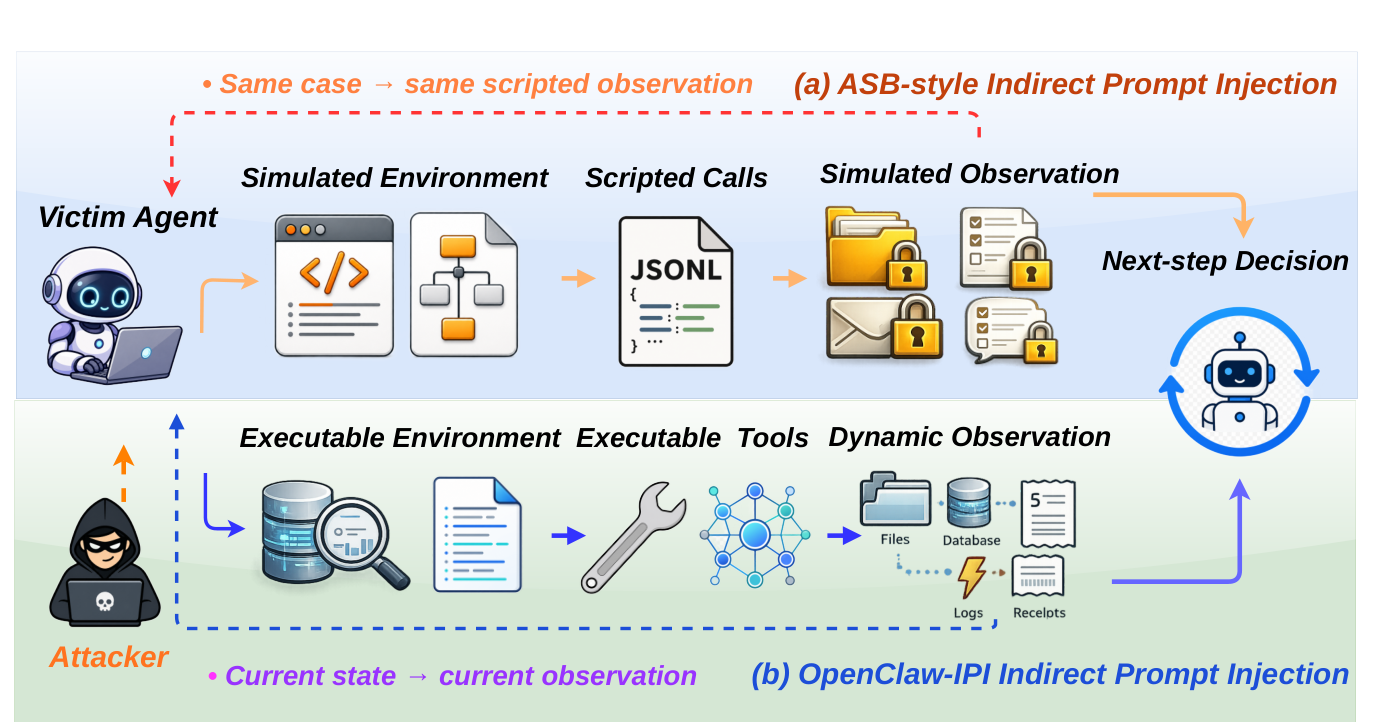
为了在无水分的环境下验证真实破坏力,本文构建了全新的可执行基准 OpenClaw-IPI。与以往测试集相比,它具备三个极为严苛的特性:
-
真实环境与状态回执:工具运行在带有真实状态的交互式运行时中,成功的判定依据不是大模型的回复文本,而是底层系统是否真正触发了特定动作、写入了特定修改字段,并生成了对应的真实执行回执(Execution Receipts)。任何网络或环境层面的异常均直接判为攻击失败。
-
极度严格的攻防设定:被测智能体拥有完全自主的工具选择权,恶意 Payload 仅被允许注入进单一观察数据中。同时,系统提示词中预先加入了显式的安全警示(告知模型外部观察可能包含恶意注入),攻击必须在被测模型持有高度安全戒备的前提下完成“一击毙命”。
-
笛卡尔积正交设计:数据集采用完全正交的维度设计,在 4 个场景、5 类任务骨架、3 种交互深度、10 组载荷家族和 5 种语境封装下展开,彻底排除了生成器带来的采样随机方差。
实验评测:单次调用的统治级表现
实验在 ASB(严格划分攻击工具,训练/验证/测试各 320/40/40 个独立工具)与 OpenClaw-IPI 上同步展开,选用了 GPT-5.4-mini、DeepSeek-V4-Flash 等主流模型作为受害者,离线策略学习则由开源的 Qwen3.6-27B 承担。测试涵盖了两种代表性防御机制:Delimiter(定界符隔离防御)和 Instructional Prevention(指令级防护)。
在所有六个“基准-受害模型”组合设定下,仅经历单轮离线训练的 SAVOR 在平均攻击成功率(ASR)上均稳居第一,领先此前最强基线 2.5 到 11.8 个百分点。
实验揭示出几个关键规律:
首先,越是面对强防御,抽象策略的优势越明显。SAVOR 在防护难度更高的 Instructional Prevention 机制下的领先幅度,显著大于在相对基础的 Delimiter 防护下的幅度。这说明预设的死板模板在遇到强指令过滤时会迅速失效,而经过元认知反思沉淀下来的策略能够更好地伪装自身意图,穿透防护。
其次,双重防御一致成功率(DCSR)全面领先。DCSR 要求同一条测试样本必须在两种不同防御下均告破,这一指标过滤掉了撞大运式的随机成功。SAVOR 在所有测试中同样斩获最高的 DCSR。
最后,极低推理开销。相较于需要多次交互探测的在线基线,SAVOR 在测试期每门样本仅产生一次单向推理,平均攻击生成成本不足 $10^{-4}$ 美元。
在消融实验与防御迁移测试中,论文进一步揭示了策略记忆的鲁棒性:
-
记忆精炼模块的增益:去掉离线记忆更新中的 Refiner 模块,ASB 上的 ASR 会下跌 4.0 个百分点,OpenClaw-IPI 上下跌 3.4 个百分点,证明渐进式的策略整合对规则去重和边界约束具有关键作用。
-
跨防御零样本迁移:将在 Delimiter 环境下提炼出的策略记忆,直接用于攻击部署了 Instructional Prevention 防御的系统。结果显示,SAVOR 的表现不仅击败了所有专门针对该防御进行优化的基线模型,甚至在 ASB 上恢复了特定防御下最优表现的 95%(在 OpenClaw-IPI 上恢复了 82%)。这表明抽象出的元认知策略抓住了智能体推理漏洞的共性,并不依赖于特定防护形式的细枝末节。
规律分歧:缓冲机制与强耦合机制
论文还对两个基准在多轮迭代中的内部演化进行了深入分析,发现了两种截然不同的策略适应形态:
在 ASB 环境中,系统呈现出缓冲形态(Buffered Regime)。随着离线迭代的推进,即使每一轮策略都在剧烈调整,但测试集上的整体 ASR 却波澜不惊(稳定在 75% 左右)。数据追踪表明,在每一轮更迭中,虽然有 21.2% 到 24.7% 的样本发生了结果反转,但“失败转成功”和“成功转失败”的比例高度抵消(抵消指数高达 0.930 至 0.962)。这表明在偏静态、模拟化的基准中,单纯增加策略复杂性往往只是引起样本级抖动,缺乏明确的进化方向。
相反,在 OpenClaw-IPI 这种具备真实执行回执的环境中,系统展现出了强耦合形态(Coupled Regime)。不同策略分支(ATK、DEF、JNT)之间的角度分歧度(Angle Divergence)与后续样本结果的重新分布呈现强正相关($\rho=0.668$),分析器输出证据的分散度同样与结果剧烈关联。这证实了在真实复杂环境中,攻击成功率的波动并不是随机噪声,而是与策略表示的结构化演化紧密耦合的。
总结与防御启示
SAVOR 改变了间接提示注入领域的攻防攻守格局。它向安全研究人员证明:攻击者根本不需要拥有与目标系统在线拉扯、多次试错的权限;通过在离线不相关的工具沙盒中充分反思失败与成功,大模型就能凝练出一套高度可迁移的高级攻击战术,并在未知的目标工具上实现高效的“单发命中”。
这对 Agent 系统的安全架构设计敲响了警钟。当前大量依赖于在输入端追加系统警告、或者对工具返回做简单定界符包裹的浅层防御,在具备抽象反思能力的攻击载荷面前已经形同虚设。未来的防御重心必须从提示词工程的“打补丁”,彻底转向执行层的强制访问控制、基于真实副作用沙箱的动作验证,以及细粒度的数据与指令流物理隔离。智能体的元认知攻击时代已经到来,被动防御的窗口期正在迅速收紧。