TrajDebug:追踪生命周期,清华腾讯将长程Agent根因定位提升8.4分
TRAJDEBUG: Tracing Error Lifecycle to Identify Critical Failures in Long-Horizon Agent Trajectories
随着大语言模型(LLM)被广泛应用于软件工程、多轮复杂客服以及自动化科研等长程(Long-Horizon)复杂任务,智能体的执行步骤动辄跨越几十甚至上百个回合。然而,流程越长,系统的脆弱性就越明显:一次早期的意图偏离或工具误用,往往会像滚雪球一样在后续几十步中层层传导,最终导致整个任务彻底失败。
ArXiv URL:https://arxiv.org/abs/2608.06346v1
在软件工程或日常运维中,排查这类长程失败极其昂贵。学术界与工业界将这一挑战形式化为“关键错误检测”(Critical Error Detection),即从一条失败的长轨迹中,精准定位出那个最初导致任务失败的“第一责任步”。然而,现有的直接提示(Direct Prompting)或多智能体诊断系统在这一任务上的表现普遍不尽如人意。
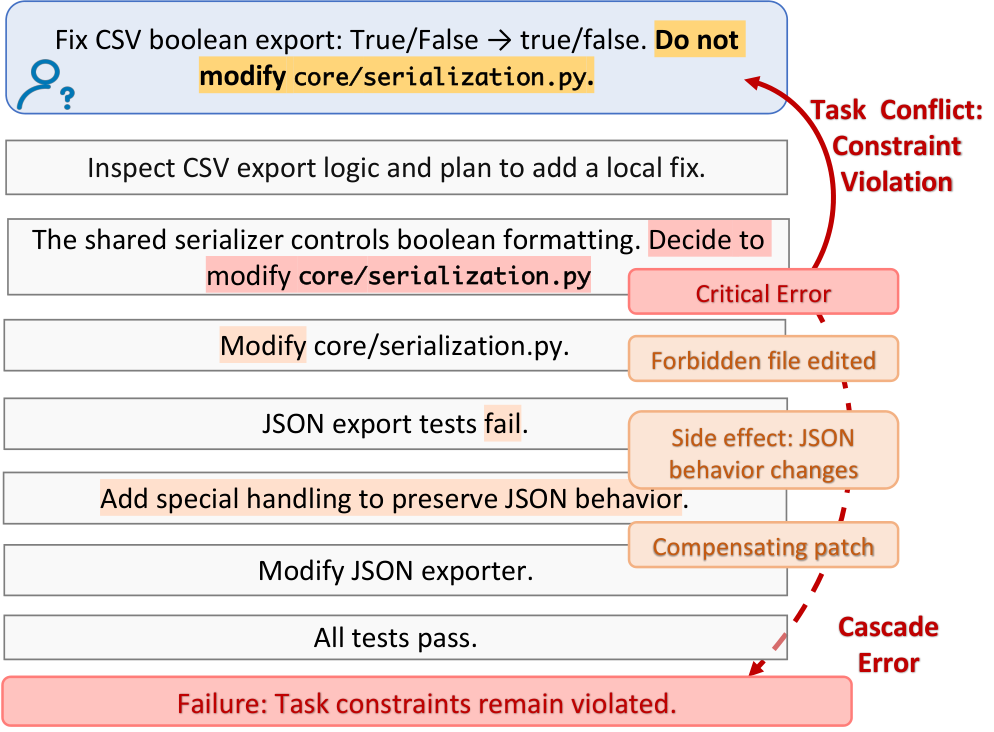
来自清华大学和腾讯的研究团队近期提出了全新的框架 TrajDebug。该工作指出,现阶段长程智能体调试之所以失效,根源在于长轨迹中充斥着复杂的“错误动力学”——智能体在执行过程中会产生大量局部小失误,其中超过六成会被它自己随后修正,只有极少数真正引发了致命连锁反应。如果不对错误的生命周期进行追踪,模型很容易被中途发生的无关报错误导。TrajDebug 通过多粒度上下文压缩、严格证据锚定的触发器检测、错误状态分类以及因果归因,将诊断准确率大幅提升,并在同骨干模型下比直接 Prompting 提升了 8.42 个百分点。
长程轨迹里的“狼来了”:为什么传统排错总是失准?
让大模型直接读完长达上百步的执行日志并找出“哪一步犯了致命错误”,往往会遇到两个难以逾越的障碍。
第一个障碍是跨越超长距离的证据分散。智能体在执行复杂任务时,通常交织着规划、推理、工具调用、环境观察以及自我修正。判定第 80 步的某个动作是否错误,其判别依据可能远在第 2 步的用户隐式约束中,或者是第 15 步某个工具返回的具体字段。当把整条长轨迹灌入 LLM 时,由于“大海捞针”式的注意力衰减和上下文污染,模型极易产生幻觉,虚构出根本不存在的违规。
第二个障碍则更加隐蔽:局部错误的多样性与干扰性。在长程决策中,失败的轨迹往往不是“一处错、步步错”,而是伴随着大量的良性试错。为了探究这一现象,研究团队在先导实验中抽样分析了 50 条长程失败轨迹,并对其中的局部错误进行了极其详尽的人工标注。
统计结果令人吃惊:这 50 条最终失败的轨迹共包含 381 个局部错误步骤,平均每条轨迹出现 7.62 个错误,但每一条轨迹最终致命的“关键错误”只有 1 个。在这 331 个非致命的局部错误中:
-
$61.9\%$ 的错误在后续被智能体自行修复了。例如工具参数传错触发了报错,智能体在下一步自动重试并修正了参数;
-
$6.6\%$ 的错误属于休眠性错误(Dormant)。例如智能体在某一步数错了搜索结果的数量,但后续任何核心决策都没有引用这个数字,这一错误对最终结果毫无负面影响;
-
剩下的非致命错误中,许多只是更早先失误的下游衍生物。
这就解释了为什么现有诊断系统表现脆弱:许多方法只关注“这一步有没有出错”,一旦发现候选错误就试图进行归因,结果大量被智能体自身修好的、或者本质无害的局部扰动,严重干扰了对真正致命错误的判断。
TrajDebug:追踪错误全生命周期的三阶管道
针对上述挑战,TrajDebug 改变了“通读全文、一步到位找根因”的传统模式,将关键错误定位拆解为一个全生命周期的可审计流程。
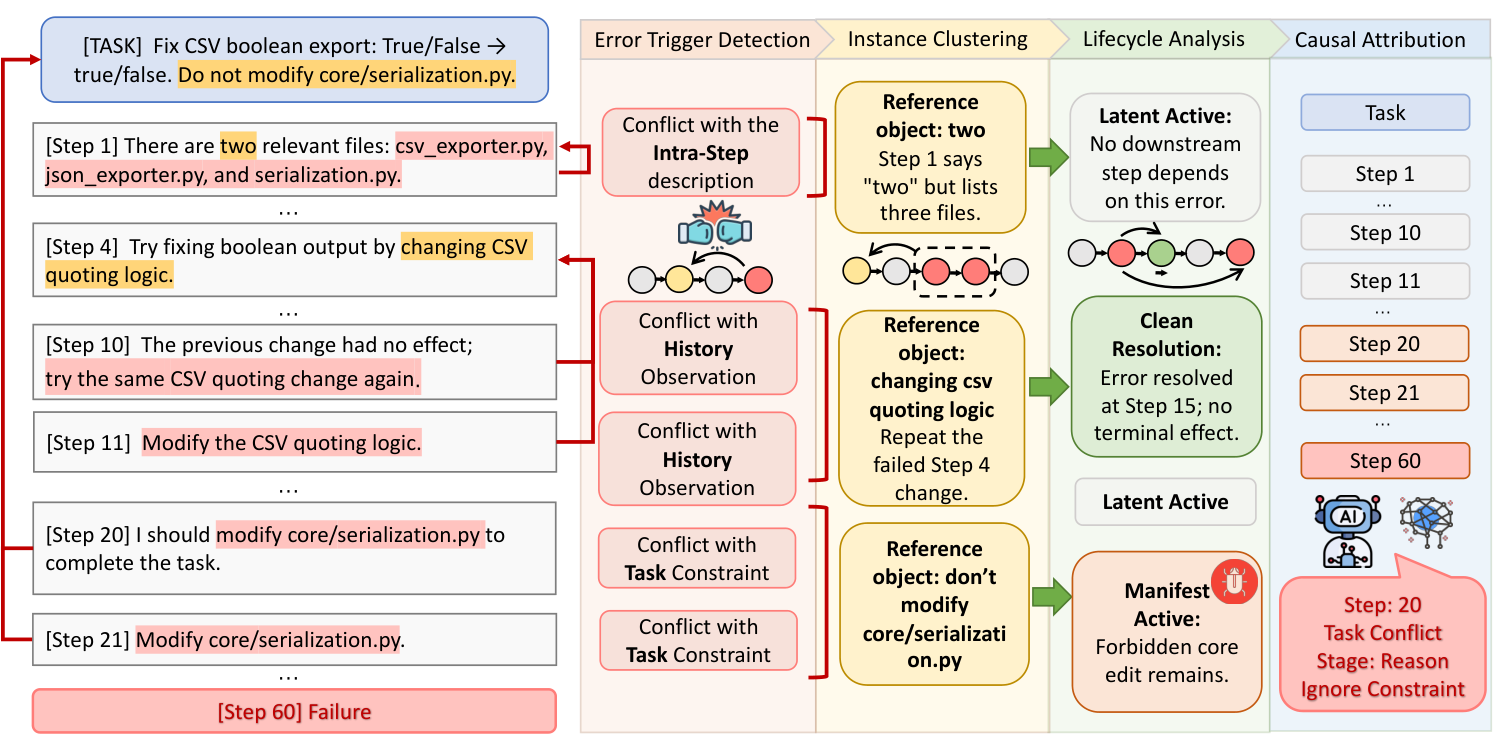
整个框架包含多粒度压缩与三个递进的诊断阶段:
1. 多粒度历史压缩与证据锚定
长上下文之所以容易导致 LLM 诊断漂移,是因为模型在审视当前步骤时,必须同时保留细粒度的局部细节和宏观的全局目标。TrajDebug 为轨迹中的每个步骤构建了三重视角:
-
高细节视图(High-detail View):保留完整的指令、动作、环境原始反馈及局部思考片段,用于当前步骤的严格事实比对;
-
中细节视图(Medium-detail View):提炼该步骤的核心意图、动作与状态更新,提供紧邻上下文;
-
低细节视图(Low-detail View):仅记录粗粒度的执行进度、关键实体与尚未履行的承诺。
当系统检查某个具体步骤 $t$ 时,它只对当前步和初始指令展开高细节视图,对紧邻的前两步使用中细节视图,对其余遥远历史使用低细节视图。这种分级机制在极大压缩上下文 Token 消耗的同时,保证了诊断所需的核心证据不发生形变。
在此基础上,TrajDebug 的第一阶段进行原子错误触发器检测(Error Trigger Detection)。研究团队制定了严苛的“逐字证据约束”(Verbatim Evidence Condition):只有当一个步骤中的错误承诺 $q_{w}$ 与某个被违背的参考事实 $q_{r}$ 都能在上下文中找到可逐字引用的原文依据时,才会被记录为有效触发器。这些参考事实被细分为四类:
-
任务冲突(Task Conflict):违背了用户在初始指令中设定的硬性约束;
-
历史冲突(History Conflict):违背了前期交互、环境工具返回或已确立的轨迹事实;
-
步内冲突(Intra-Step Conflict):当前步骤自身的推理逻辑与做出的动作产生自相矛盾;
-
环境异常(Environment Anomaly):智能体动作合理,但外部环境出现非预期故障。
2. 聚类为实例与错误状态分类
单个错误承诺往往会跨越多个连续步骤反复出现(例如智能体对某个错误文件路径的执念可能会连续体现在规划、调用和复查中)。如果按单步处理,很容易产生重复计数。
TrajDebug 根据所违背的“核心参照对象”(Reference Object $O$),将相关联的单步触发器聚类为宏观的“错误实例”(Error Instance $E$)。随后,系统开始对每个实例的生命周期状态进行追踪与分类:
-
错误在后续交互中是否得到了彻底解决?
-
如果未解决,它是否对最终环境留下了不可逆的足迹(Terminal Footprint)?
通过追踪,系统能够清晰区分出那些虽然发生过、但已被成功纠正的扰动,以及那些虽然存在逻辑瑕疵但未产生实质性阻碍的休眠状态,最终筛选出真正具有持久危害、遗留严重代价的候选实例集合 $\mathcal{F}(\tau)$。
3. 候选集引导的因果归因
在完成了局部噪声的过滤后,候选集合中的条目数量大幅精简。此时,系统并不简单地套用“取时间最早者”的朴素规则,因为一个较早发生的轻微资源浪费,不一定会比稍后发生的严重语义误解更具致命性。
TrajDebug 采用一个专门的归因头(Attribution Head),输入仅包含通过前两阶段验证的候选错误实例的首发步骤、状态标签及逐字引用的底层证据。LLM 充当因果仲裁者,在极高信噪比的信息输入下,最终判定究竟是哪一个错误实例开启了通往最终失败的因果链条,从而定位出全局的关键错误步骤。
构建高难度评测基准:TrajErrBench
为了客观衡量诊断系统在真实复杂场景中的表现,现有基准如 GAIA、ALFWorld 往往由于轨迹较短(平均十几到几十步)而无法充分暴露长程问题。研究团队构建了目前极具挑战性的高质量评测基准 TrajErrBench。
TrajErrBench 包含 486 条经由人工精细标注的真实失败轨迹,分为两大多样化领域:
-
$\tau^{2}$-Bench 子集(400条):涵盖真实的多轮工具调用与复杂用户交互,平均轨迹长度为 29.3 步。
-
SWE-Bench Pro 子集(86条):源自真实的复杂代码仓库与软件工程任务,平均轨迹长度达到了惊人的 119.7 步。
所有数据均经过严格的三人交叉标注与多数票决,在 $\tau^{2}$-Bench 上标注一致性系数(Fleiss’ $\kappa$)达到 0.91,在超长代码场景 SWE-Bench Pro 上也达到了 0.67。
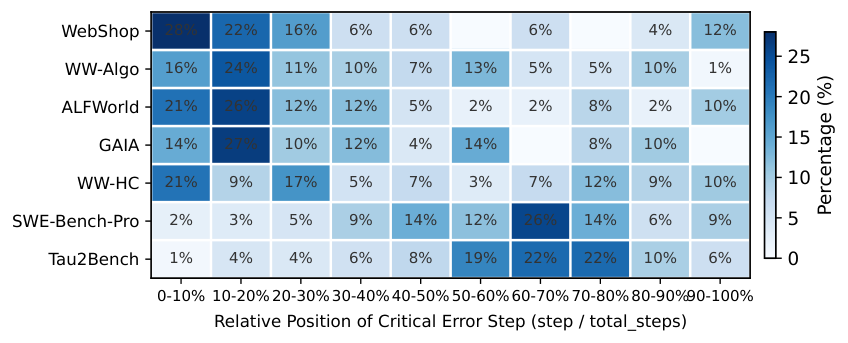
对 TrajErrBench 关键错误分布的统计揭示了长程智能体的一个普遍规律:如图所示,在 $\tau^{2}$-Bench 和 SWE-Bench Pro 这类长程任务中,关键错误往往发生在中后期。这是因为智能体在前期通常处于“信息搜集阶段”(例如与用户澄清需求、在代码仓库中检索上下文),真正的决定性动作出现在信息汇总之后。一旦前期搜集的信息被模型误读,随后的关键决策就会瞬间崩塌。这也反向印证了依靠传统“截断开头”或“只看前几步”的启发式方法完全无法解决实际长程诊断问题。
实验结果:在长程与复杂交互中全面胜出
评测在无需任何真实任务答案或金标准轨迹的严苛前提下展开,诊断模型仅仅依赖失败轨迹本身。研究团队对比了两大类基准方案:包括 GLM-5.1、Gemini-3.1-Pro、DeepSeek-V4-Pro、Claude 4.6 系列、GPT-5.4 等在内的 直接提示基准(Direct Prompting),以及专门为诊断设计的 多智能体调试系统(如 AgentDebugger、CHIEF、AgentRX)。
为了确保完全公平的对比,TrajDebug 与所有多智能体基准系统均统一采用 Qwen3-235B-A22B-Thinking 作为底层骨干模型。
实验结果展现出几个关键趋势:
首先,在涵盖 7 个不同领域的综合测试中,TrajDebug 取得了 34.11% 的最高宏平均准确率,相较于直接提示同一骨干模型(25.69%)提升了 8.42 个百分点,且显著优于各类多智能体基准(后者的平均准确率多在 18% 至 23% 之间徘徊)。值得注意的是,所有方法在长程关键错误定位上的绝对准确率都算不上高,这充分证明了仅凭一条长日志反推唯一关键诱因的难度之大。
其次,轨迹越长,TrajDebug 的优势越明显。在平均步数达到 119.7 步的超长任务 SWE-Bench Pro 上,主流大模型直接提示的定位准确率多数在 10% 到 17% 之间,部分复杂图因果分析方法(如 CHIEF)甚至直接退化到了 2.32%;而 TrajDebug 凭借状态过滤与上下文多粒度压缩,取得了 24.41% 的定位准确率。
在消融实验中,研究团队深入分析了各个模块的不可替代性:
-
若将多粒度压缩替换为常规的硬截断策略,平均准确率断崖式下跌了 21.02 个百分点,这说明在长程任务中,粗暴截断会彻底破坏证据链条;
-
去除错误状态分类模块,在 SWE-Bench Pro 上的表现从 24.41% 骤降至 16.28%,甚至低于无架构的基线模型。这一现象充分佐证了前述论断:超长代码轨迹中存在太多被修补好的局部错误和无害错误,缺少状态生命周期的判定,模型在最后因果仲裁时必然会被严重误导。
从“精准定位”走向“实操纠错”
找出系统到底死在哪一步,其终极价值是帮助智能体在后续执行中变得更聪明。研究团队进一步探索了 TrajDebug 的诊断结果如何转化为实际的智能体性能提升,设计了两种极具工程价值的推理期应用范式:
第一种是单任务即时重执行(Trajectory Repair):当智能体某次任务失败后,TrajDebug 介入定位出关键错误步,并将该错误背后的违规证据与原因提炼为靶向指导提示(Targeted Guidance),让智能体在同一任务上重新运行。实验表明,这一机制为智能体带来了 $10.80\%$ 的平均任务成功率绝对提升。
第二种是跨任务失败记忆迁移(Failure Memory Transfer):在实际业务场景中,我们不可能让每个失败任务都有机会重试。研究团队收集了少量历史失败案例,利用 TrajDebug 提炼出致命模式,聚合形成可复用的“失败记忆库”(Failure Memory)。在面对完全未见过的全新任务时,智能体通过检索这些前车之鉴,依然获得了 $5.70\%$ 的平均成功率提升。
这证明了 TrajDebug 不仅是一个事后复盘的质检探针,更可以无缝嵌入到现代 Agentic 系统的自省进化循环中,为智能体从失败中学习提供了高信噪比的经验接口。
总结与展望
在长程智能体从玩具走向生产级应用的拐点期,系统的可解释性与容错调试能力正逐渐成为制约上限的核心瓶颈。TrajDebug 带来的启示在于:面对复杂的长程交互,不能再把错误当成孤立的时间点来看待,而必须将其视为具有演化过程的“生命体”。
通过严格的证据逐字锚定、长程多粒度压缩,以及对错误状态(是否解决、是否有后遗症)的全程追踪,TrajDebug 成功地在大规模试错噪声中剥离出那颗最具毁灭性的多米诺骨牌。无论是对于代码生成智能体、复杂工具流编排,还是未来的自主数字员工,这种细粒度的生命周期追踪框架,都为构建更可靠、可调试、具备自主进化能力的下一代长程智能体系统提供了坚实的底层抓手。