UserToolBench:从表面调API到替人决策,顶尖模型准确率不足50%
UserToolBench: A User-Profile-Hidden Benchmark for Personalized Decision Making in Tool-Use LLMs
当人们期待大模型真正作为个人代理(Personal Agent)接管日常事务时,一个长期被忽视的矛盾正在浮出水面:大模型学会调用各类 API 并不难,但要让调用行为完全契合特定用户的长期隐式偏好,目前的顶尖模型几乎全部不及格。
ArXiv URL:https://arxiv.org/abs/2608.10042v1
在真实场景中,用户极少会给出结构完备、毫无歧义的指令。人们往往只会随口抛出一句“帮我订今天回程的机票”或“找个附近的餐厅预订四人座”,其中省略了预算习惯、航司偏好、舱位偏好、餐饮忌口以及行程排期等大量决策约束。过去的工具评测往往预先给定明确参数,考核模型能否正确填入 JSON;而个性化评测则多聚焦在文本风格、口吻模仿或开放式问答上。来自华为、南洋理工大学和中山大学的研究团队提出了 UserToolBench 基准,首次将评估焦点转向隐式画像下的个性化决策(Personalized Decision Making)。
这项研究最引人注目的结论在于:在包含 10 类用户画像、36 个工具集、170 个独特工具以及 1065 轮交互的隐藏画像评测中,即便是业界最前沿的大模型,其严格轨迹准确率最高也仅有 49.36%;当任务从单工具延伸至多工具链条时,平均准确率更是跌至 25.24%。实验清楚地表明,能把 API 跑通(Relaxed Acc 普遍超过 60% 至 70%)与真正替用户做出正确决策之间,存在着巨大的能力鸿沟。
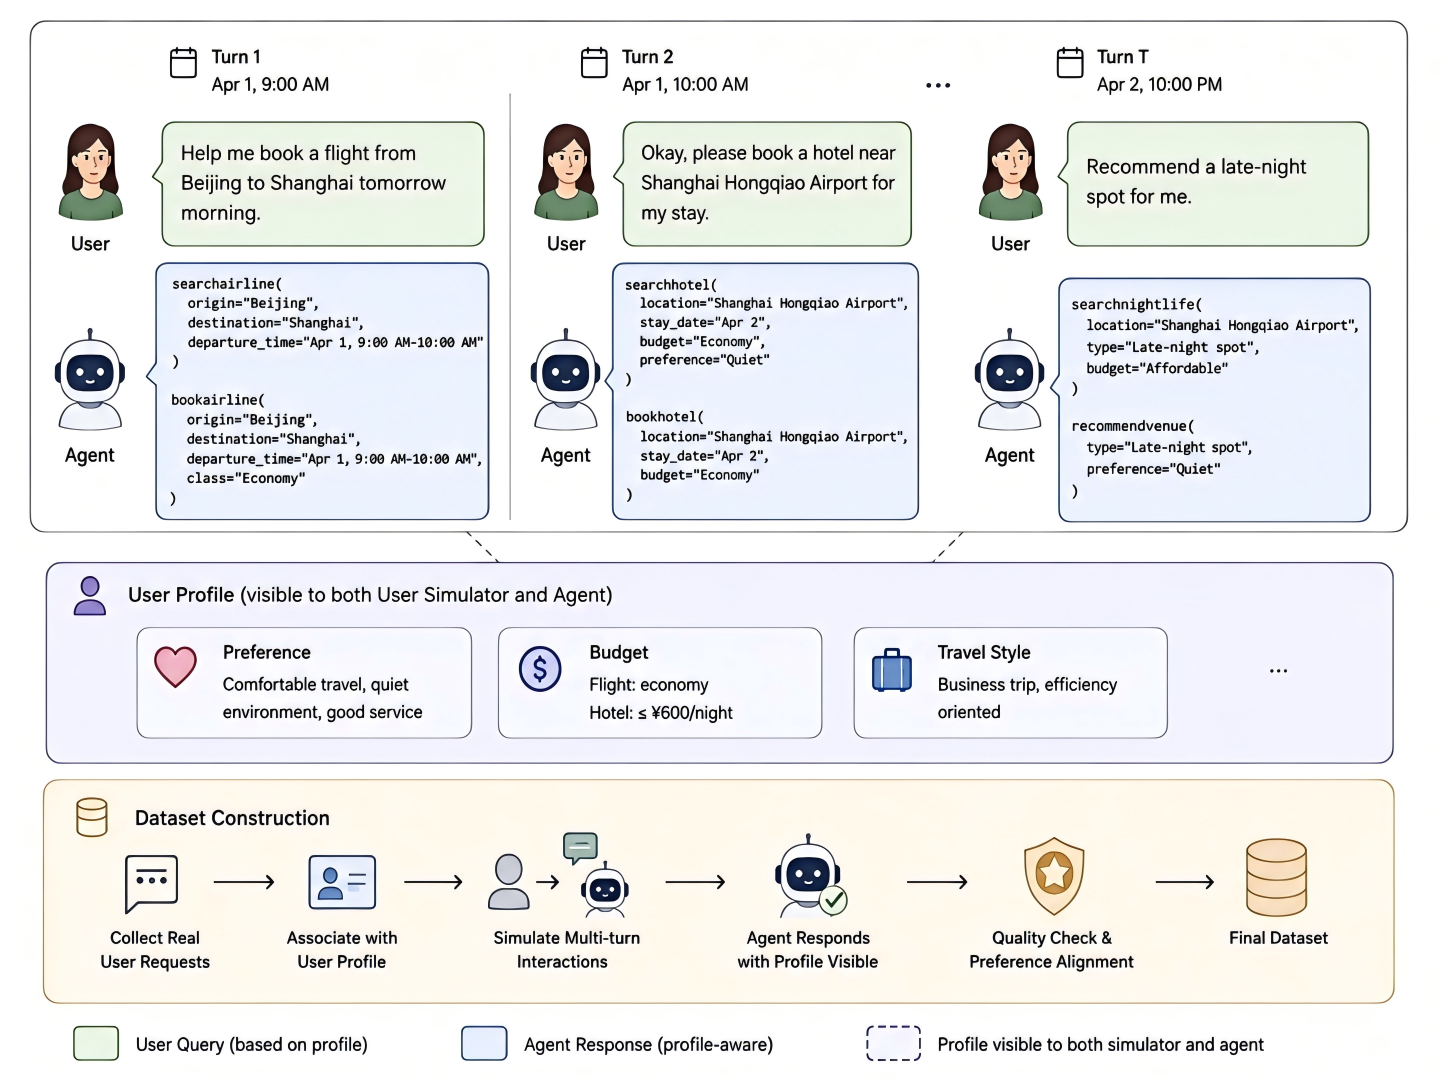
从“照单抓药”到“隐式代理”:个性化评测的范式重塑
现存的工具调用与个性化基准大体割裂在两个平行维度。一类如 ToolLLM、API-Bank 等,专注考察大模型在参数构造、多步规划和 API 纠错上的工程表现,但所有测试用例中的用户指令都被假设为完全自洽的孤立指令;另一类如 LaMP 等个性化评测,核心在于根据用户历史生成更贴近用户语言习惯的摘要、书评或推荐回复,停留于纯文本生成层面,不涉及实际的环境交互与外部执行。
UserToolBench 试图击碎这种人为割裂。作者团队将个性化代理行为形式化为一个不完全信息条件下的序列化工具调用决策问题:
\[y^{\star}=f_{\mathrm{ref}}(p,h,q,T)\] \[\hat{y}=f_{\theta}(h,q,T)\] \[\tau=\{a^{T}_{1},e_{1},a^{T}_{2},e_{2},\dots,a^{T}_{S},e_{S}\}\]其中 $p$ 代表用户的长期稳定画像,$h$ 为累积的交互历史,$q$ 为当前用户提出的请求,而 $T$ 则是可调用的工具架构集合。在理想参考状态下,标准动作序列 $y^{\star}$ 是在已知持久画像 $p$、历史 $h$ 和请求 $q$ 下规划出的最优工具调用轨迹 $\tau$。然而,在模型推理阶段,大模型 $f_{\theta}$ 面对的是一个画像隐藏(Profile-Hidden)的严苛环境:模型根本无法直接读取显式的画像文本 $p$。
这种画像隐藏设计切中了当下代理系统的核心痛点。在实际工程落地中,系统不可能把一个长达上万 Token 的完整用户画像直接拼接在每一次系统提示词中,更不可能保证用户画像本身是静态且完全标注好的。模型必须学会像一个有默契的私人助理一样,自主在过往长程交互记录 $h$ 中搜寻潜在的偏好线索,推断出当前请求中缺省的决策约束;一旦发现既有历史根本不足以支持某一决策,还必须主动向用户发起澄清确认,而不是擅自臆测或盲目调用。
真实轨迹蒸馏与长程任务构建
为了支撑这种高精度的决策评测,UserToolBench 在数据构建上放弃了纯随机合成的方式,而是采用了一套融合隐私脱敏与里程碑推进的数据合成管线。
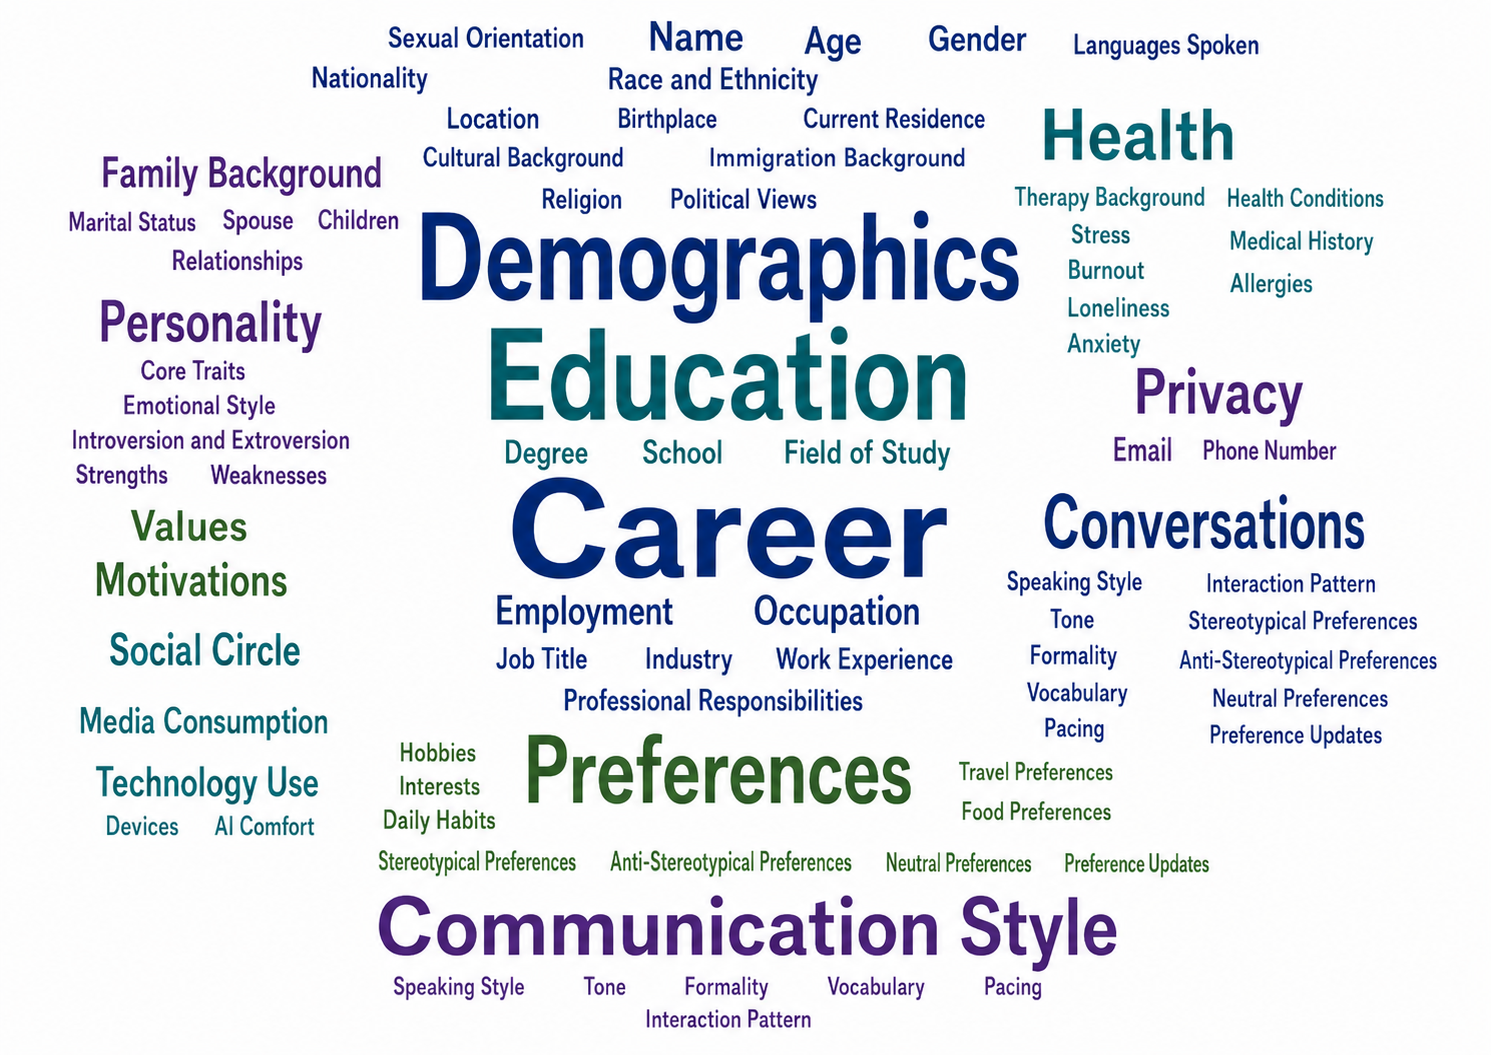
每个基准实例背后的持久画像均提取自真实交互痕迹,经由大模型协助进行抽象化与去标识化,转化为包含人口统计特征、语言背景、沟通风格、性格特质以及复现性决策偏好的结构化档案。这些档案重点保留了非敏感却极度影响决策的特征,例如特定的差旅报销标准、固定的时间排程习惯、对特定服务商的偏好以及沟通风格。
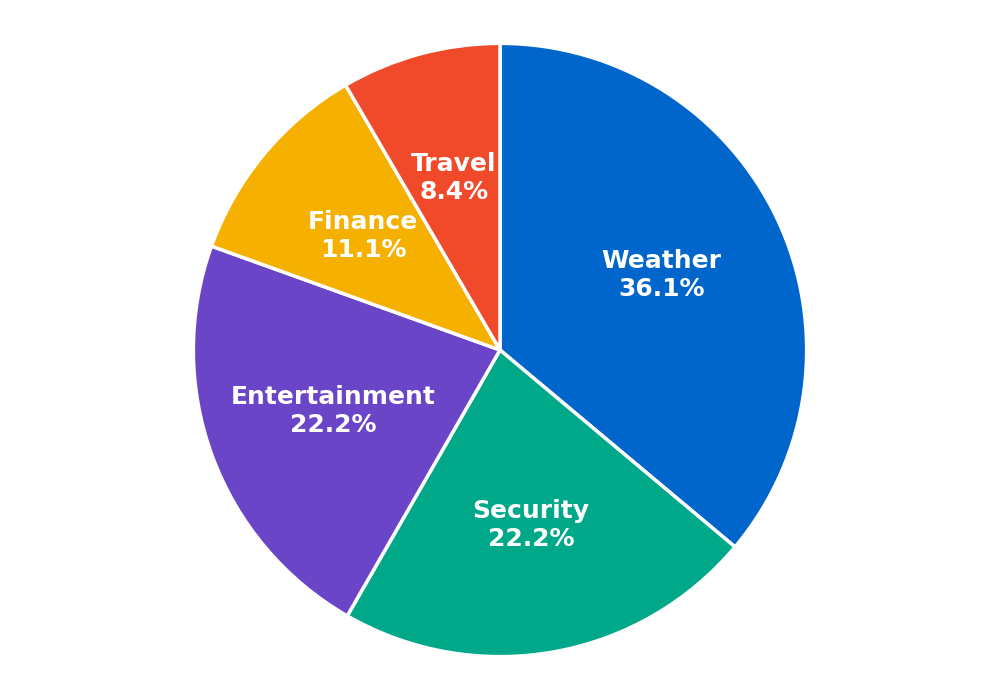
在此基础上,研究团队构建了 36 个场景级的工具生态,涵盖出行、办公、生活管理等多种复杂情境,工具总数达到 170 个。所有工具均按照标准 API 规范组织,具备完整的参数类型约束与功能描述。
为了让交互轨迹具备长程上下文依赖,构建流程采用了“里程碑驱动合成(Milestone-based Synthesis)”。系统设定一个具备特定画像的模拟用户和一个能够访问该画像的标准参考轨迹生成器。每完成四个里程碑阶段,前面的交互历史就会被冻结并累积注入到后续的上下文池中。这种机制强制后续的请求去引用、继承乃至依赖前期交互中确立的信息。整个基准最终沉淀了 300 个不重复的复杂主题,并在同一工具集下针对不同画像展现出了高度分散的真实决策差异。
为了精确衡量模型能力,基准划分了三个互为补充的任务类型:
-
信息缺失场景(Lack-of-Information, LOI):用户请求刻意隐去了关键参数。若历史中有迹可循,模型必须自主推断并直接执行;若历史从未提及,模型必须发起反问澄清,擅自调用即判错。
-
单工具任务(Single-Tool, ST):虽然仅需调用单个 API,但工具选择与参数赋值完全取决于模型是否成功从历史中提取出专属偏好。
-
多工具任务(Multi-Tool, MT):要求模型完成跨工具的复杂链式规划,既涉及前序工具返回值的动态传递,又要求全流程持续遵循用户的个性化约束。
评测结果:跑通 API 与理解用户之间的鸿沟
研究团队选取了六款通用/前沿模型(Kimi K2.6、GPT-5.4、Qwen 3.6 Plus、DeepSeek V4 Pro、Gemini 3.5 Flash、GLM-5)以及三款专注工具调用的轻量级模型(Hammer2.1-7B、ToolACE-2.5-8B、Watt-Tool-8B)展开评测。评估体系设立了两个对比维度:严格轨迹准确率(Exact Acc.)和宽松任务完成率(Relaxed Acc.)。严格准确率要求工具选择、参数赋值以及调用顺序与参考轨迹精准一致;宽松准确率则只关注调用是否合法、是否在宽泛层面上完成了任务表面意图。
实验数据揭示出几个极具启发性且颠覆直觉的现象。
首先,所有被测模型在面对隐藏画像的个性化代理任务时均表现得相当挣扎。在严格轨迹匹配下,即便表现最好的模型,其平均准确率也未突破 50%(最高仅为 49.36%)。专用工具小模型更是全线溃败,平均表现普遍徘徊在 10% 到 20% 上下。这说明单纯在 API 语法、JSON 格式上做指令微调,根本无法建立起对用户隐式意图的理解能力。
其次,表面上的执行成功掩盖了大量的个性化违背。对比宽松任务完成率与严格准确率,两者存在着令人吃惊的断层。例如,DeepSeek V4 Pro 的宽松完成率高达 72.55%,但严格对齐率直接腰斩至 42.49%;GPT-5.4 的差距更为夸张,从 67.71% 的宽松完成率暴跌至 31.98% 的严格对齐率。这意味着,超过三分之一甚至半数的调用,模型确实给出了语法正确、能够成功返回结果的 API 序列,但这套方案根本不是当前用户想要的。模型给出的只是一个“对大众而言合理,但对特定用户完全错误”的平庸解。
为了验证严格匹配未命中是否仅仅是因为模型选择了等价的替代路径,团队对失败轨迹展开了细粒度归因审计。诊断表明,在分析的模型失败样本中,高达 82.1% 至 96.5% 的错误直接源自调用顺序与数据依赖断裂,48.2% 至 90.3% 出现了工具选择错误,40.9% 至 53.5% 明确违背了用户的硬性约束;而在严重度审计中,轻微偏离仅占不到 2.1 个百分点,绝大多数错误均属于根本性的决策走偏。
多工具级联与不确定性校准的双重坍塌
进一步剖析不同任务类型的表现,可以清晰定位出当前代理系统的核心技术瓶颈。
其一,多工具调用构成了绝对的“能力断崖”。在单工具任务(ST)上,强模型尚能取得 50% 到 60% 左右的严格准确率,但一旦进入多工具编排(MT),整体平均准确率立刻骤降到 25.24%。多工具场景不仅考验第一步工具选得对不对,更要求模型在整个调用链条中维持对用户约束的长期注意力。前序调用的细微偏差会在多步推理中被层层放大,导致后续调用的参数完全偏离预设目标。
其二,在信息缺失(LOI)场景下,通用工具能力无法平移。该任务极其考验模型的不确定性校准能力:模型不仅要检索历史,还要精准判断“检索到的信息是否足以支撑一次无风险的工具调用”。实验中出现了鲜明的分化现象:GPT-5.4 虽然在总体轨迹匹配上表现平平,但在 LOI 任务中却拿下了全场最高的 42.22% 准确率,展现出极佳的审慎澄清倾向;反观在单工具上表现强势的 Qwen 3.6 Plus(单工具准确率 58.02%),在 LOI 任务上却断崖式跌落至 19.52%。这种分化印证了一个判断:过于激进的模型容易在缺乏证据时盲目推断并乱调接口,而过于保守的模型则可能在历史信息已经十分完备时频繁发起冗余反问,二者都会破坏代理体验。
其三,累积的交互历史在多数模型上呈现出“负效用”。直觉上,随着对话轮数增加,上下文里沉淀的用户行为线索越多,模型理应做得更好。然而,轨迹位置分段实验呈现了截然相反的趋势:大部分模型在交互后期(后三分之一阶段)的表现显著逊于早期。例如,GPT-5.4 从前期的 52.12% 持续下滑至后期的 31.33%,Qwen 3.6 Plus 亦从 45.93% 下滑至 28.56%。历史记录拉长后,陈旧的过往细节、特定主题的瞬时变量与真正持久的偏好纠缠在一起,模型的长文本检索机制被噪声所稀释,反而难以锚定最核心的约束。唯一的例外是 Gemini 3.5 Flash,在轨迹后期展现出逆势上扬,表明极少部分模型在海量历史信息的过滤和利用上具备更优的架构鲁棒性。
从静态指令执行到动态用户状态跟踪
UserToolBench 的测试结果给火热的 Agent 落地潮浇了一盆冷水,也为大模型个性化研究指明了新的演进方向。过去行业内习惯于把“个性化”包装成简单的 Prompt 增强工程,或将“工具调用”简化为 Function Call 的语法对齐,而该基准以翔实的实验证明:当二者结合时,系统面临的是一个高度复杂的认知决策挑战。
个性化代理的本质,并非在每次输入前拼接一段用户喜好的静态描述,而是要求智能体具备动态用户状态跟踪(User-State Tracking)的能力。模型必须在持续滚动的长程交互中,完成从非结构化行为反推隐式偏好、识别时效性偏好覆盖、过滤偶发性临时需求,并在信息不足时做出合理置信度校准的全套动作。
这项工作所确立的 Profile-Hidden 评估范式,意味着对个人智能体的评判标准正在发生质的跃迁——评测不再只看输出的文字是否听起来像某个特定的人,更要看它做出的每一个可执行动作、发起的每一次 API 申请,是否真正代表了那个具体用户的利益与意志。在这个标准下,大模型距离成为一名真正值得托付的个人代理,依然有着漫长的一段路要走。