UniTexture:单一3D物体纹理跨任务攻破VLA,成功率从90%腰斩至48.4%
UniTexture: Cross-Task Universal Adversarial Textures for Vision-Language-Action Models
在具身智能的演进路径中,视觉-语言-动作(Vision-Language-Action,简称 VLA)模型正在成为通用机器人策略的核心支柱。无论是基于自回归离散 Token 预测的 OpenVLA,还是基于流匹配(Flow Matching)连续动作块预测的 $\pi_{0.5}$,它们都展现出了前所未有的泛化潜力:一个预训练策略即可同时听懂成百上千种自然语言指令,并在多视角视觉输入引导下完成抓取、放置、推拉等多样化操作。然而,当多任务共享同一视觉感知与决策骨干时,也无形中暴露出一片前所未见的跨任务攻击面。
ArXiv URL:https://arxiv.org/abs/2608.13453v1
如果攻击者只在工作台某个普通道具的表面贴上一张精心设计的 3D 贴图,是否就能在机器人执行各种毫不相关的任务时,持续诱导其做出危险的动作偏差?由北京邮电大学、MBZUAI、同济大学和电子科技大学等机构联合提出的 UniTexture 正式给出了令人警惕的答案。作为针对多任务 VLA 模型的跨任务通用 3D 对抗纹理攻击,UniTexture 仅优化单一物体的 3D 表面贴图,便在无需针对具体任务二次调优的前提下,使 VLA 模型在多样化任务集上的平均成功率从良性工况下的 $90.0\%$ 锐减至 $48.4\%$,并实现了对预测动作在物理空间维度的定向诱导。这项研究揭示了一个关键安全隐患:任务的多样性与复杂性,并不能天然成为防御通用物理扰动的屏障。
从二维补丁到三维通用纹理的范式进阶
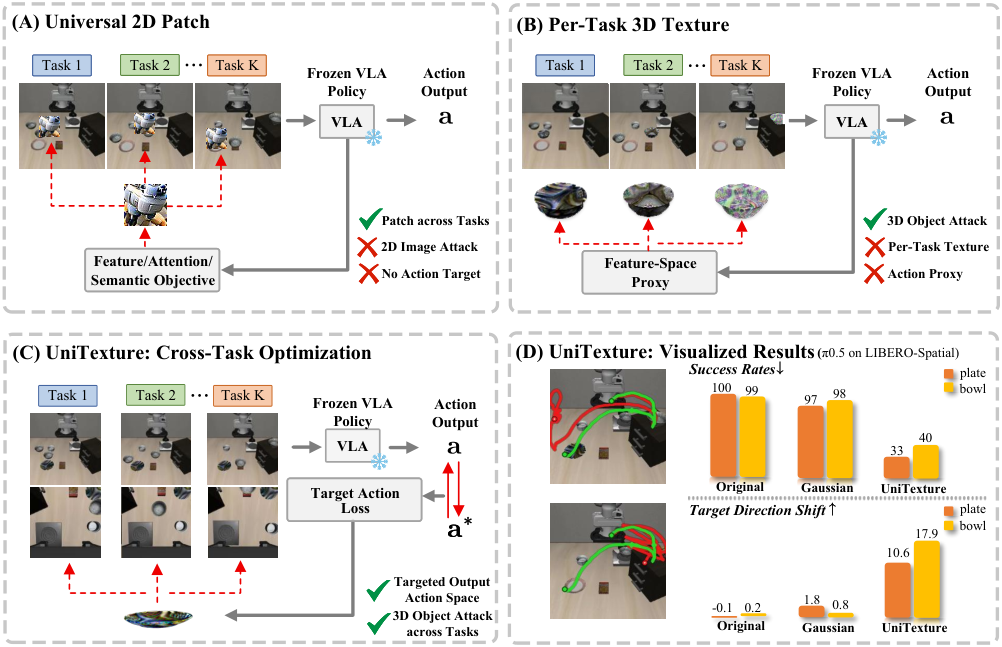
回顾针对机器人视觉策略的对抗攻击研究,早期的思路大体可划分为两条脉络。第一条脉络集中在二维图像空间或二维物理补丁。这类方法通过向相机图像注入像素级扰动,或者在工作台中放置一张固定的 2D 贴纸,去干扰视觉编码器的特征提取。尽管二维补丁具备一定的跨任务与跨视角迁移性,但其本质是平面的,无法与环境中复杂的 3D 物体几何形状建立严格的物理几何绑定,更难在机械臂遮挡、视角连续变换、物体翻转运动的全轨迹中保持稳定的对应关系。
另一条脉络则是以 Tex3D 为代表的单任务 3D 表面纹理攻击。这类工作将对抗扰动参数化为 3D 网格表面的 UV 贴图,借助可微渲染技术,把梯度从模型输出端沿着光路反向传播回物体表面。这种方式保证了扰动在几何与时空维度的一致性,但存在两大致命短板:一是针对单一任务、单条固定指令单独优化,换一个操作目标往往需要重新训练整张纹理;二是针对流匹配等复杂动作专家模型时,往往依赖视觉特征空间的代理损失(Feature-space Proxy),仅仅破坏抽象表征,难以在物理动作空间实现精确的定向操控。
UniTexture 恰好切入了这两条脉络的盲区。具身操作中的多任务攻击比单任务分类或静态分割困难得多。在多任务连续操作中,机器人的语言指令随时在变,场景上下文不同,标称动作分布各异,且交互轨迹千差万别。目标物体在操作过程中的位姿、可见性、在图像画面中所占的像素比例都在剧烈演化。要在这一组高度耦合的动态分布中,提炼出一张“放之四海皆起效”的静态 3D 贴图,并在物理动作输出端施加稳定的定向偏置,对攻击框架的设计提出了极为严苛的考验。
统一的对抗框架:可微渲染与动作空间定向优化
UniTexture 的核心哲学是把攻击牢牢锚定在机器人的原生动作空间,并跨越异构任务分布进行联合优化。攻击者假设拥有目标 VLA 模型的白盒梯度,但完全不触碰策略权重、语言指令、相机位姿或机械臂的本体感知状态,仅允许篡改操作台面上单一 3D 物体的表面纹理 $\theta$。
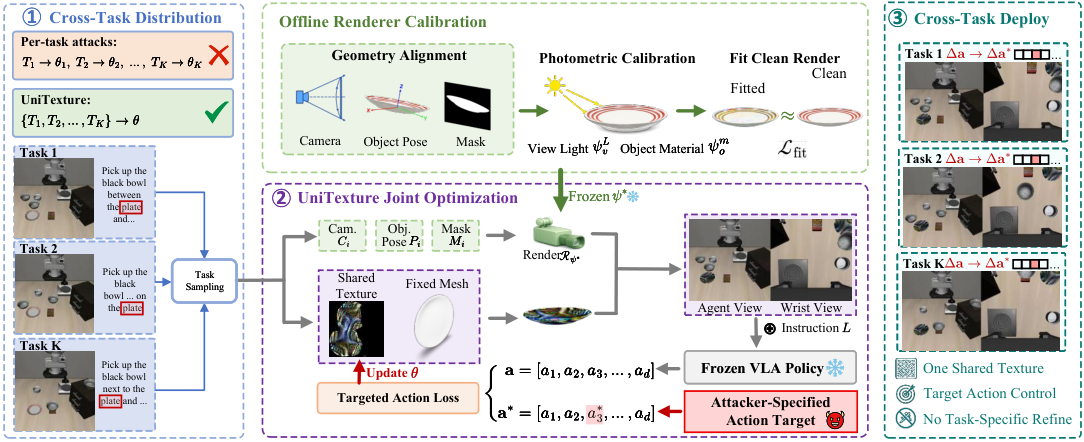
整个攻击流程由两大部分组成:离线渲染器标定,以及跨任务分布上的联合对抗更新。
在纹理优化开始前,研究团队首先解决了一个长期困扰可微渲染攻击的痛点:模拟器与渲染器之间的光度与材质差异。如果可微渲染器渲染出的物体光影与模拟器真实画面脱节,反向传播的梯度就会在渲染伪影上过度拟合,导致优化出的纹理迁移到仿真环境或物理环境中失效。为此,UniTexture 设计了一个离线标定阶段,利用多视角纯净观测图像,对环境光强、主光源位置以及物体材质的漫反射与镜面反射系数进行联合拟合。标定完成后,这套精细对齐的光照与材质参数被全盘冻结,确保后续所有的梯度反传均来自策略对纹理语义的感知反馈,而非渲染器自身带来的系统误差。
进入联合优化阶段后,框架在任务套件 $\mathcal{S}$ 中进行任务均衡采样,依次提取对应的语言指令 $L$、初始演示轨迹中的观测图像 $I$ 以及物体的空间位姿。可微渲染器基于当前的纹理参数 $\theta$,将渲染得到的 3D 物体以软渲染形式无缝融合到主摄像机视角以及机械臂腕部视角中,生成被污染的观测帧 $\tilde{I}$。
为了跨越不同 VLA 模型之间动作接口的巨大鸿沟,UniTexture 针对不同的策略结构定制了基于原生动作空间的损失函数 $\mathcal{L}_{\mathrm{tgt}}$:
对于像 OpenVLA 这样将连续动作量化为离散 Token、采用自回归方式预测的策略,UniTexture 针对攻击者指定的目标动作标量 $a^{\star}$,将其通过分箱函数映射为目标动作 Token $z_{j}^{\star}$,并直接最大化该 Token 在目标自由度 $j$ 上的预测对数似然:
\[\mathcal{L}_{\mathrm{tgt}}^{\mathrm{tok}}(\theta) = -\frac{1}{\vert{}\mathcal{J}\vert{}}\sum_{j\in\mathcal{J}}\log p_{F}\left(z_{j}^{\star}\big\vert{}\tilde{I},L\right)\]而对于像 $\pi_{0.5}$ 这类采用流匹配机制、在去噪步中预测速度场的连续动作块专家,传统的跨熵损失或特征距离代理完全无法胜任。UniTexture 直接在流匹配的速度场空间构建目标,要求策略预测的速度场向量 $v_{F}$ 强制逼近攻击者定义的方向向量 $u_t$:
\[\mathcal{L}_{\mathrm{tgt}}^{\mathrm{flow}}(\theta) = \frac{1}{H_{a}}\sum_{h=1}^{H_{a}}\left[v_{F}(\tilde{I},L,x_{t},t)_{h,j}-(u_{t})_{h,j}\right]^{2}\]其中 $h$ 索引连续预测的动作步長,且损失严格限制在受攻击的动作自由度 $j$ 上,其余非目标自由度不予惩罚。这种解耦方式不仅避免了对非目标轴向的盲目破坏,还能使有限的纹理容量最大限度地聚焦于诱导特定的动作偏移。在每次迭代中,策略权重保持冻结,梯度仅穿透策略感知主干与可微渲染器更新纹理参数 $\theta$。优化完成后的贴图在物理空间一次性成型,随后原封不动地部署到该套件的所有任务评测中。
评测体系与实证:全面击穿双主流架构
为了验证攻击的真实杀伤力,研究人员在机器人基准 LIBERO-Spatial 与 LIBERO-Goal 两个套件上展开了详尽评估。这两个套件分别包含 10 个具有挑战性的桌面操作任务。评测选取的靶标涵盖了两种完全不同机理的具身模型:自回归架构的 OpenVLA 与基于连续流匹配动作块的 $\pi_{0.5}$;受攻击的目标物体则选定为在两套任务中均频繁出现的“盘子(plate)”与“碗(bowl)”。
为了准确衡量对抗纹理的操控精度与破坏程度,实验定义了多个关键指标:任务成功率(SR)衡量最终操作成败;目标方向位移量(Target-Direction Shift, TDS)衡量对抗动作相对于无攻击动作在目标轴上的均值偏置;而配对方向命中率(paired Directional Hit Rate, pDHR)则统计对抗诱导动作偏移与攻击目标方向同向的步数比例。同时,实验引入了无渲染的纯净基线、经过可微渲染器重构的原版纹理对照组、以及随机高斯噪声纹理对照组,彻底排除了渲染合成伪影与普通外观随机扰动对结论的干扰。
从实验汇总结果来看,单张跨任务纹理展现出了惊人的泛化破坏力。在未受攻击时,被测 VLA 策略在各任务套件上的平均基准成功率为 $90.0\%$,而在单一对抗纹理常驻场景的条件下,该均值直接暴跌至 $48.4\%$。
细分到具体模型,在 OpenVLA 上,LIBERO-Spatial 的成功率从无攻击纯净状态的 $84\%$ 分别跌落至 $53\%$(盘子受攻击)和 $25\%$(碗受攻击);在 LIBERO-Goal 上,成功率亦从 $80\%$ 滑落至 $58\%$ 与 $29\%$。对于当前表现极佳、基准成功率高达 $99\%$ 的 $\pi_{0.5}$ 而言,UniTexture 的打击更为致命:在 LIBERO-Spatial 下,其任务成功率被一举压制到 $33\%$(盘子)和 $40\%$(碗)。与之形成鲜明对比的是,未优化的随机高斯噪声纹理虽然也改变了物体外观,但 $\pi_{0.5}$ 的成功率依然坚挺在 $97\%$ 与 $95\%$。这雄辩地证明,性能雪崩完全源于动作空间目标梯度的定向驱动,而非单纯的图像分布偏移。
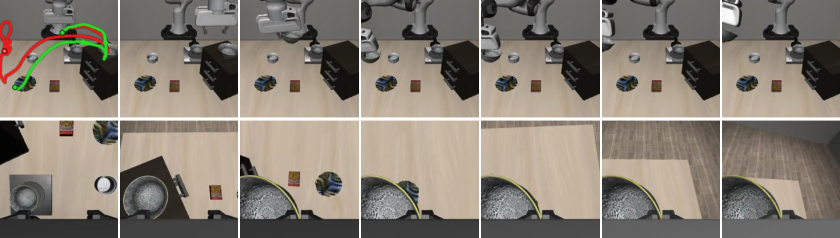
上图记录了一个极其典型的对抗干预过程。在 LIBERO-Spatial 的第 91 个测试回合中,良性状态下的机械臂本来需要执行下压抓取动作(无攻击轨迹的垂直标称均值 TDA 为 $-12.4$)。但在盘子表面被附着 UniTexture 纹理后,策略在目标 $+z$ 轴(垂直向上)上被强制注入了极大的正向偏移量,TDS 飙升至 $18.3$,每步与目标方向一致的比例 pDHR 达到了 $58.6\%$。从轨迹对比中可以清晰看到,红色的受攻击轨迹在机械臂反复尝试向下修正与对抗纹理诱发向上抬起的拉锯中剧烈震荡,最终彻底偏离抓取点宣告失败。
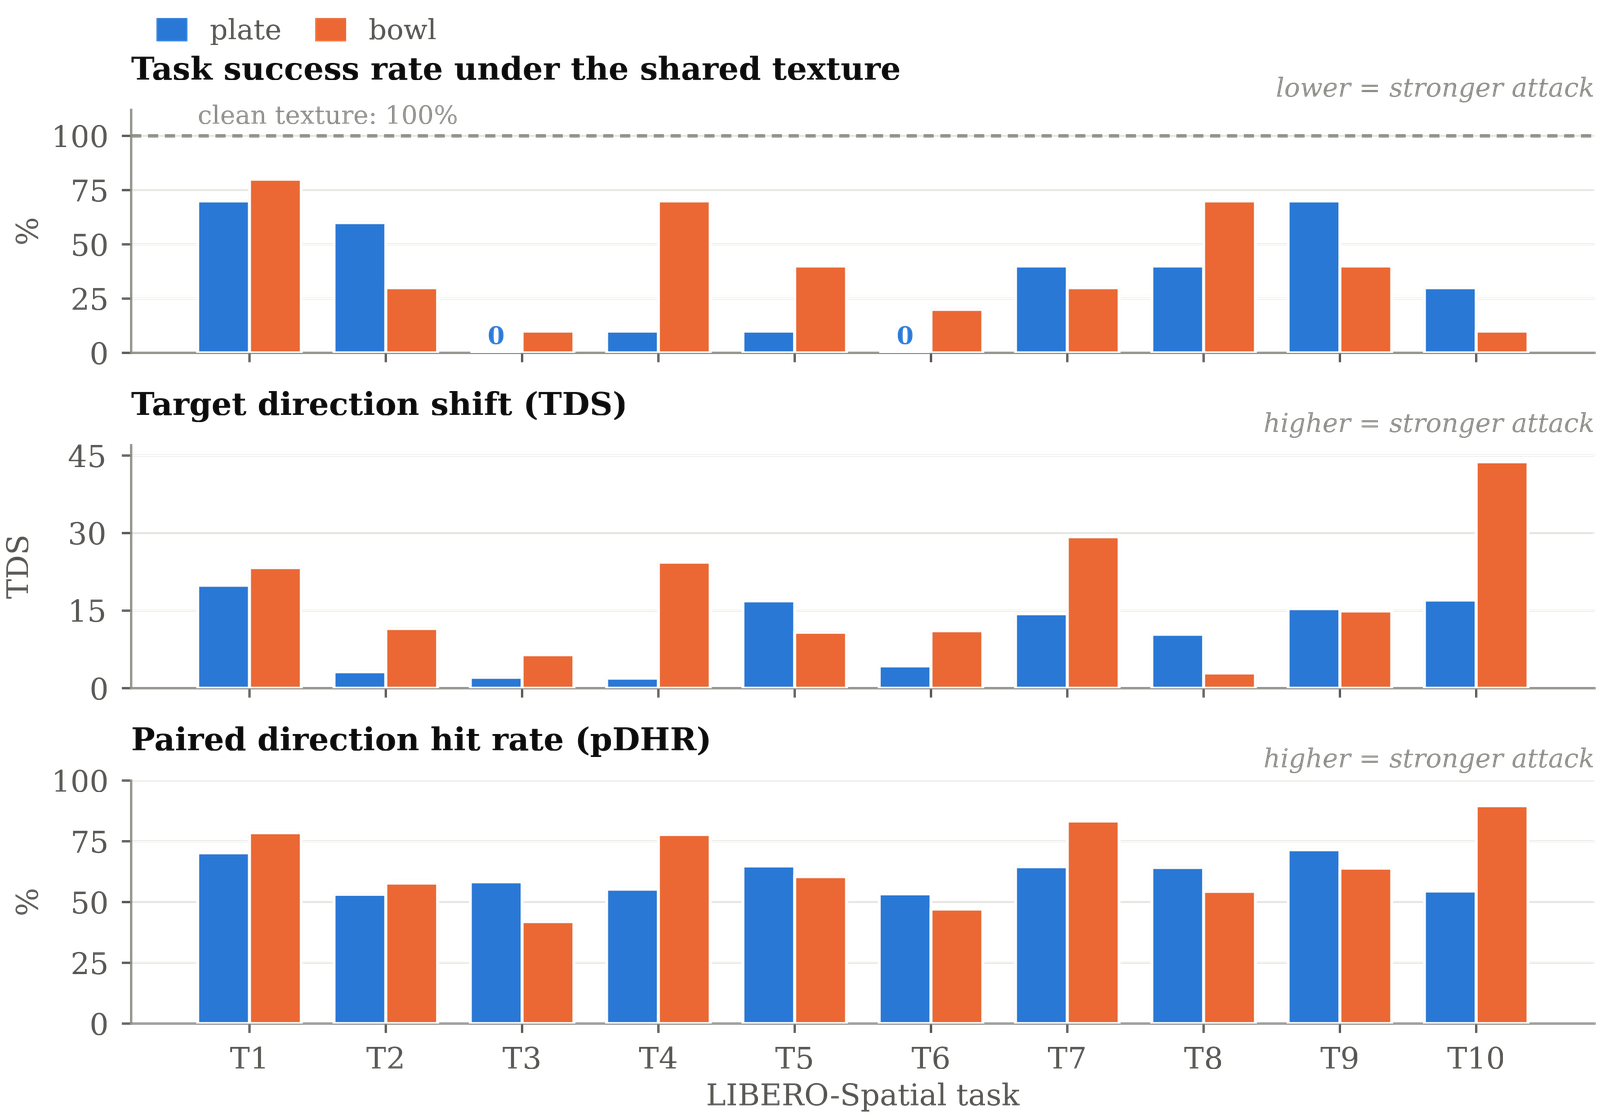
更加值得注意的是,单一共享纹理并非靠“牺牲某些任务以换取极值”,而是在所有任务中均产生了均匀的作用力。在展开的 LIBERO-Spatial 10 个独立任务评测中,针对盘子和碗的两组纹理均在每一个任务(T1 至 T10)上实现了正向的 TDS 偏置,配对方向命中率 pDHR 普遍落在 $42\%$ 至 $90\%$ 的区间内。尽管由于任务固有的物理几何容错度不同,最终的残留成功率存在分化(部分任务降至 $0\%$,部分任务仍有残余成功),但方向性位移的普适存在表明:多任务共享的单一物体外观,确实构成了多任务策略内部统一且通用的对抗脆弱点。
迁移性与不对称阻断:超乎预期的泛化外溢
UniTexture 带来的另一个深刻洞见在于对抗纹理在不同任务分布乃至不同模型架构间的无缝迁移能力。研究人员将未做任何微调的优化贴图直接放置于全新环境中测试,观察其跨域外溢效应。
首先是跨套件(Cross-Suite)迁移。在保持目标物体不变的情况下,将仅在 LIBERO-Spatial 上优化好的纹理直接搬运至 LIBERO-Goal 进行推理,或者反向迁移。结果显示,纹理在全部测试配置下,均使策略的成功率显著低于纯净状态及高斯噪声基准。对于 $\pi_{0.5}$ 而言,方向性诱导不仅没有衰退,TDS 在跨套件测试中依然全线为正,pDHR 稳定在 $42.7\%$ 至 $60.3\%$ 之间。这一现象证明,对抗纹理并非仅仅拟合了某一特定空间布局或任务逻辑,而是成功捕捉到了该物体在多视角感知下与底层动作流向之间的通用耦合关系。
更为戏剧性的发现在于跨模型(Cross-Model)迁移的不对称性:
-
当使用专门针对流匹配模型 $\pi_{0.5}$ 优化出的对抗纹理去攻击自回归模型 OpenVLA 时,攻击表现出了惊人的破坏力,直接将 OpenVLA 的任务成功率打压至 $26\%$ 到 $61\%$ 的低位;
-
然而反过来,针对 OpenVLA 优化得到的对抗纹理,在直接迁移去攻击 $\pi_{0.5}$ 时却几乎完全失效,$\pi_{0.5}$ 的成功率依旧维持在 $92\%$ 至 $97\%$ 的高位。
这种强不对称性为具身模型的架构安全性提供了极具价值的理论线索。研究者推测,$\pi_{0.5}$ 采用流匹配在连续动作块空间进行建模,其优化的对抗梯度直接作用于高维连续速度场,所捕捉到的视觉-动作映射模式更为底层和宽泛;而 OpenVLA 基于离散 Token 分箱的交叉熵优化,更容易在特定的 Token 边界附近陷入局部过拟合。高容量连续模型上提炼出的物理对抗表征,反倒构成了更具杀伤力的“上位攻击”。
几何方向不对称:为什么向上拉扯最有效?
在攻击目标维度的消融实验中,研究团队系统性地对比了空间六个移动自由度(沿摄像机深度轴的 $\pm x$、水平侧向的 $\pm y$、垂直升降的 $\pm z$)作为攻击目标时的实际破坏力。
实验数据显示,空间各轴向对扰动的敏感度存在鲜明的物理几何差异。水平方向的侧移($\pm y$)和纵深位移($\pm x$)均能在一定程度上控制动作偏置(pDHR 处于 $48.1\%$ 到 $55.1\%$),将成功率压制在 $45\%$ 至 $68\%$ 之间。但所有方向中,杀伤力最强的是向上移动($+z$),成功率降幅最为剧烈;而杀伤力最弱的恰恰是其相反方向——向下移动($-z$),成功率高达 $91\%$,诱导命中率 pDHR 仅有 $36.4\%$。
这一不对称性完全契合机器人桌面操纵的真实物理约束。在多数桌面操作场景中,机械臂的自然标称轨迹本质上就是在不断向下探寻、接近桌面并与物体接触。攻击者诱导策略施加一个向下的偏置,往往顺应了标称动作的整体趋势,即便产生些微超调,机械臂也能在工作台表面的物理支撑和自闭环修正下完成交互。相反,一个持续向上的动作偏置,相当于在机械臂试图接近目标的关键交互界面时,不断施加一个向上的“虚幻拉力”,直接破坏了抓取前期的空间几何对齐与物理接触建立,从而以最低的干扰代价达成了最彻底的任务阻断。
对具身智能物理部署的警示
UniTexture 的提出,打破了过去对于 VLA 策略鲁棒性的一种乐观假设——即“任务越杂、指令越广、场景越多,模型就越难被单一对抗输入所左右”。这项研究用详实的证据证明:只要多任务策略复用了统一的视觉感知与动作预测主干,那么环境中哪怕一个日常摆放的三维道具表面的静态纹理,都足以充当一枚常驻的、跨越多任务的通用“视觉地雷”。
这不仅意味着现有的单任务对抗评测标准亟需升级,也向具身智能在现实工业制造、医疗辅助、仓储物流等高安全要求场景的落地敲响了警钟。当机器人从数字屏幕走向物理世界,针对物理实体外观的微小篡改,能够直接转化为执行机构的不可逆动作偏移。未来的通用具身策略在追求跨任务“泛化”的同时,如何构建对物理空间连续扰动的几何不变性与异常动作闭环防御,将是具身 AI 真正走向物理现实前不可回避的核心议题。