HarnessLens:仅需1/24验证预算,复旦让Agent框架自演进性能提升13.6%
Verify Smarter, Evolve Further: Efficient Harness Evolution through Behavior-Aware Verification
在大模型驱动的智能体系统落地过程中,决定智能体上限的往往不仅是底层基础模型的能力,还有包裹在模型外部的 Agent Harness。这套控制架构定义了智能体如何理解系统提示词、调用外部工具、维护长期记忆、执行权限校验以及分配子角色。然而,针对具体的任务环境去定制或持续优化一套高效的 Harness,历来依赖工程师枯燥的手动调优;近年来学术界尝试让智能体走向“自演进”(Self-Improving),即基于执行轨迹自动提出修改建议并进行验证评估。
ArXiv URL:https://arxiv.org/abs/2608.27311v1
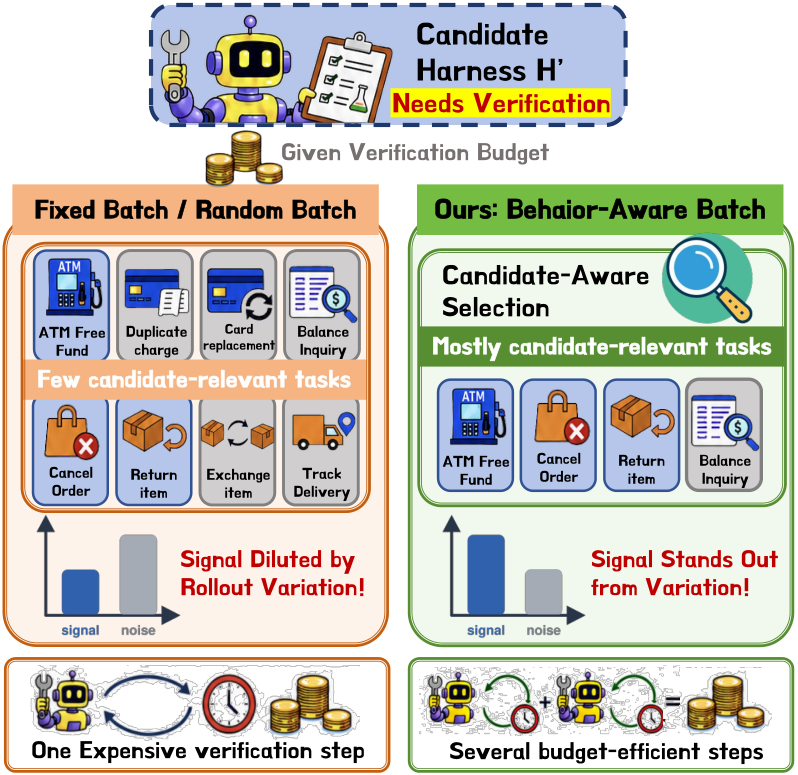
但在现有的提议-验证(Propose-and-Verify)范式中,隐藏着一个长期被忽视的效率陷阱:无论针对系统的哪项细微组件进行修改,算法通常都在一组固定或随机抽样的任务集上运行全面的验证。这种粗放的做法不仅消耗了大量的交互预算(Rollouts),更严重的是,无关任务引入的性能波动往往会冲淡具体修改带来的真实行为变化,甚至用宏观的平均分掩盖了关键行为的退化。
复旦大学与上海市数据科学重点实验室的研究团队提出了名为 HarnessLens 的自演进框架。该框架打破了传统自优化方案“大水漫灌”式的评测逻辑,提出以“行为感知验证”(Behavior-Aware Verification)与“可归因证据门控”(Attributable-Evidence Gate)为核心的高效演进路径。实验表明,HarnessLens 仅消耗基线方案数分之一甚至二十四分之一的评估预算,就在 OpenCode、Codex CLI 和 Pi 等主流 Agent 框架上取得了 7.6% 至 13.6% 的测试集性能提升,且在所有测试中均未发生性能倒退。
传统演进范式的盲区:为什么评测跑得越多,反而越容易跑偏?
要理解 HarnessLens 的突破,首先需要认清现有智能体自演进算法的核心瓶颈。当前主流方案大多沿袭程序合成或提示词自动优化的思路:从历史执行轨迹中诊断失败原因,生成新的组件修改候选(例如修改某一个工具的描述或微调特定角色的系统指令),随后在固定的任务集上运行多轮候选系统,通过对比整体成功率或奖励值来决定是否采纳修改。
这种设计在直觉上合情合理,但在真实的复杂交互场景下却暴露出严重的系统性偏差。如上图所示,当系统针对某种特定数据库查询行为修改了工具调用约束时,如果评估批次中包含大量与该工具完全无关的文件搜索或代码重构任务,整个评估过程就会产生双重扭曲:
其一,资源极度浪费。智能体在无关任务上消耗了大量的语言模型调用会话与环境交互轮次,这些交互无法为当前修改项提供任何有价值的反馈。
其二,因果信号被稀释,引入统计假象。智能体与动态环境的交互本就伴随着随机方差。如果依靠固定任务集上的宏观平均分作为唯一裁判,一个本已修复了特定缺陷的优秀修改,可能仅仅因为某个无关任务的偶然失败而被丢弃;更危险的是,一个破坏了特定逻辑但碰巧在其他任务上凭运气通关的有害修改,反而可能因为总分的虚假微增而被系统误收。在实验分析中,许多耗费数千次 Rollout 的基线方法最终在测试集上遭遇严重退化,根源便在于此。
框架解构:从语境探索到因果归因的三阶段闭环
HarnessLens 的核心逻辑在于将“验证”本身视为一个可调度的决策过程:针对某一项具体修改,系统应该精准挑选能够体现该修改意图的任务,并在轨迹层面严格审查“成功究竟是不是由这次修改直接引起的”。为了实现这一目标,框架构建了一个由确定性控制器协调的三阶段闭环。
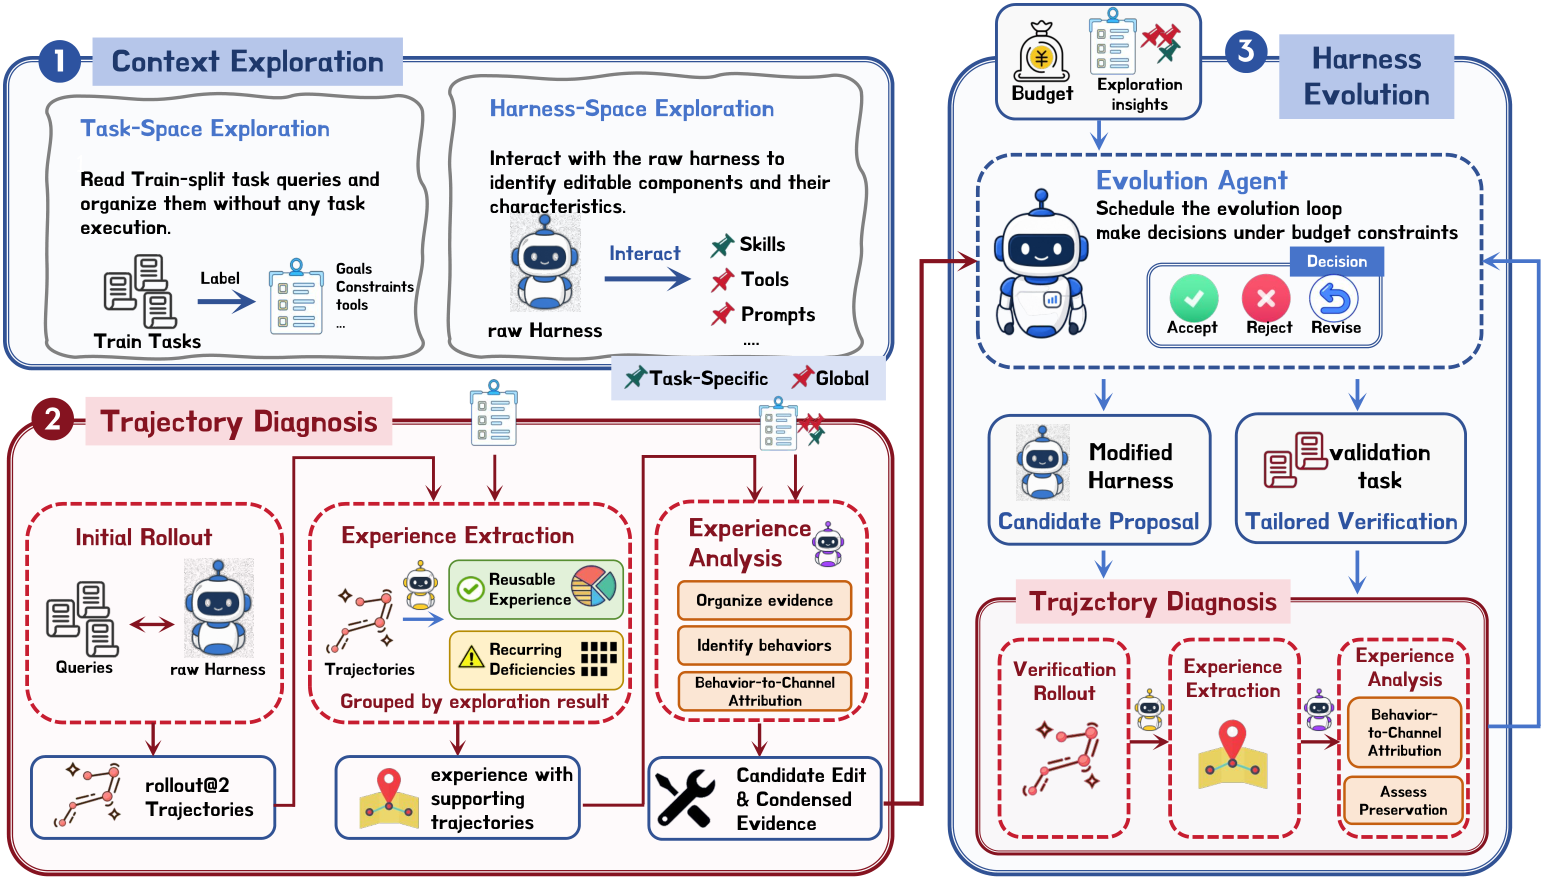
1. 语境探索(Context Exploration)
演进系统不能盲目地直接开始改写代码。在未发生实际任务交互的冷启动阶段,HarnessLens 首先对外部任务空间与内部框架空间进行静态解构。
-
任务空间探索:仅通过分析训练任务的初始 Query、环境策略说明及工具参数定义,将任务聚类为不同的意图分组。该过程不接触测试集,也不执行任何真实环境步骤,其建立的目标结构仅用于后续指导评测批次的构建和回退风险检测。
-
Harness 空间探索:检查当前智能体架构中所有用户可配置的组件(如指令、工具定义、上下文中间件等),明确每个组件对运行时的作用边界、更新接口以及可能波及的行为范围,从机制上排除无法稳定持久化的不可控属性。
2. 轨迹诊断(Trajectory Diagnosis)
在交互执行阶段,单纯的胜负奖励(Task Reward)无法说明智能体具体做对了什么或做错了什么。诊断模块包含两个紧密配合的子流程:
-
经验提取(Experience Extraction):对智能体运行生成的交互轨迹进行细粒度剖析,将执行片段提炼为具体的“可复用经验”或“高频缺陷”,并强制将每一条提炼出的经验与对应的执行轨迹挂钩,形成带证据链条的知识沉淀。
-
经验分析(Experience Analysis):分析器将提炼出的经验与此前建立的任务分组、组件范围交叉比对,形成修改提案(Proposal)。提案必须清晰声明:这次改动意在纠正哪类行为、基于哪些失败轨迹作为立论依据、涉及哪些具体的可调组件。任何缺乏充足轨迹证据支撑的空想型提议都会在这一步被果断过滤。
3. 行为感知演进(Harness Evolution)
进入正式迭代阶段后,一个独立运行的演进智能体(Evolution Agent)开始驱动 Harness 版本的更新。它并不采用盲目的多候选并发搜索,而是步步为营地执行三项精细操作:
-
候选构建:从提案池中挑选优先级最高的一项修改,通过标准化接口将其作用于当前基线 Harness 的副本之上,并在执行前完成极轻量级的静态一致性检查。
-
行为感知验证:演进智能体首先调取与该提案强相关的失败任务,接着根据意图重叠度从任务空间中挑选可能涉及相同约束或工具的相关任务,并针对该修改可能波及的边缘能力,拉入特定潜在回退任务,构成一组高相关性的动态评测集(通常至少包含 5 个典型任务)。
-
可归因证据门控:在基线与新候选运行完这组评测后,系统并非简单对比胜率,而是重新调用轨迹诊断,进行双向行为归因:不仅要确认目标行为的改善确实是由修改引起的(而非随机试错碰巧过关),还要严格审查既有能力是否出现可归因的退步。只有通过归因审查的候选才能晋升为新的基础版本;未通过者则立即作废,系统保持原状不变。
实验评测:极限预算下的稳健超越
为了严谨评估自演进效果,研究团队选择了三个代表性开源 Harness 框架(OpenCode、Codex CLI 和 Pi Coding Agent),并在涵盖交互式环境、复杂指令与数据分析的四大主流基准上展开测试:$\tau^2$-bench Retail、$\tau^3$-bench Banking Knowledge、Terminal-Bench 2.0 以及高难度的 BIRD Mini-Dev 子集。实验中的基模型统一采用 deepseek-v4-flash-preview。
在预算设置上,基线方法展现出了极高的计算胃口:Self-Harness 允许消耗高达 4800 次训练 Rollout,Meta-Harness 设定为 660 次,较轻量的 HarnessFix 也需要 300 次。而 HarnessLens 将包含了初始运行、语境探索、诊断分析以及演进验证在内的总交互单位严格限制在 200 次以内(且该额度同时计入了 LLM 会话轮次与环境执行,实际可用 Rollout 远少于基线)。
在十二组严苛的“框架-基准”交叉实验中,HarnessLens 的表现呈现出两个极为显著的技术特征:
第一,样本效率与最终泛化性能的全面占优。尽管所消耗的预算仅有基线的几分之一甚至数十分之一,HarnessLens 在绝大多数配置下均取得了显著超越未演进基线($\mathcal{H}_0$)的最佳泛化通过率。在 OpenCode 框架上,测试集绝对通过率最高提升了 13.6 个百分点;在 Codex 和 Pi 框架上也分别取得了最高 7.6% 和 9.2% 的稳固提升。即便在初始能力较强的零售(Retail)场景下,HarnessLens 也未曾落后于竞争对手。
第二,“只进不退”的决策稳定性。对比实验中最令人触目惊心的数据在于基线的劣化率:在 24 组基线演进实验中,Self-Harness 和 Meta-Harness 竟有高达一半的测试表现落后于未经修改的初始版本 $\mathcal{H}_0$,在极端情况下测试集表现下滑了近 10 个百分点。这种现象清晰地印证了前述论断:当验证机制缺乏行为归因能力时,更多的探索不仅不会带来增益,反而成了持续引入隐蔽缺陷的温床。而 HarnessLens 在所有评测中,最差结果也仅仅是与初始版本打成平手——这表明当系统发现某项修改缺乏决定性的归因支撑或潜藏副作用时,归因门控会坚决否决合并请求,完美锁死既有能力的下限。
机制剥离:行为感知与归因门控缺一不可
为了确认系统收益究竟源自哪里,作者团队设计了细致的消融实验,分别针对“任务批次挑选策略”和“候选接纳门控”进行了单变量拆解。
当把动态行为感知任务替换为“固定批次(Fixed Batch)”、“随机采样(Random Batch)”或基于表征核心集的“RHO-based 批次”后,系统的演进成功率迅速暴跌。其背后的根本机理在于:一旦验证集脱离了具体修改的行为靶向,引入的大量噪声任务使得轨迹分析器根本无法确凿断定目标行为是否真正改善,导致绝大多数合理的修改因为缺乏局部显著证据而被误杀,系统长期停滞在初始状态。
反之,若保留行为感知任务筛选,但将严苛的“可归因证据门控”退化为传统的“宏观指标门控(Metric-Only Gate)”,虽然候选修改通过验证的频率大幅上升,但测试集泛化效果却急剧恶化。在 Banking 和 BIRD 等复杂任务上,这种变体几乎没有产生任何正向增益。这证明仅有针对性的任务还不够,系统必须深入执行轨迹内部,确认行为变更是由机制优化引发的确定性改善,才能阻断虚假相关性的渗透。
此外,任务空间本身的结构异质性也深刻影响着演进的形态。在针对 SQL 复杂生成的 BIRD 基准中,不同任务之间存在明确的逻辑共性(例如对极端值计算的特定处理规则)。诊断模块能够迅速从一个失败用例中提炼出普适规则,并在相关任务的验证中展现出强大的可归因收益,进而成功采纳。而在像 Terminal-Bench 2.0 这种每个任务环境差异极大、系统状态高度发散的场景中,演进智能体尝试制定的泛化规则极易在其他异质任务上引发意外的回退报错;此时,归因门控会敏锐地捕捉到这种退化并果断予以驳回,避免了盲目优化带来的灾难性破坏。
总结与启示
HarnessLens 展现的不仅是一个针对 Agent Harness 的自动调优框架,更是对大模型自提升系统底层评测哲学的一次纠偏。它向业界揭示了一个核心事实:在智能体系统的自主迭代中,“评测”不应该被降级为一个被动的打分工具,而应当作为一个具备主动感知力、因果归因力的高级过滤器。
随着大模型落地场景向深度专业化演进,手动编写精细复杂的 Harness 规则终将遇到工程瓶颈。复旦大学这项研究指明了一条极具可行性且计算成本极为节约的自主演化新路径:将演进的重心从“追求更多算力推演”转向“建立更精准的行为级归因闭环”。只有学会聪明地验证,自进化的智能体才能在复杂的现实世界中真正行稳致远。