ZGCM-1:7B模型如何靠工具搜索叫板超大模型?全开源训推提速4.2倍
ZGCM-1: A Fully Open and Extremely Efficient Foundation Model for Math and Agentic Search
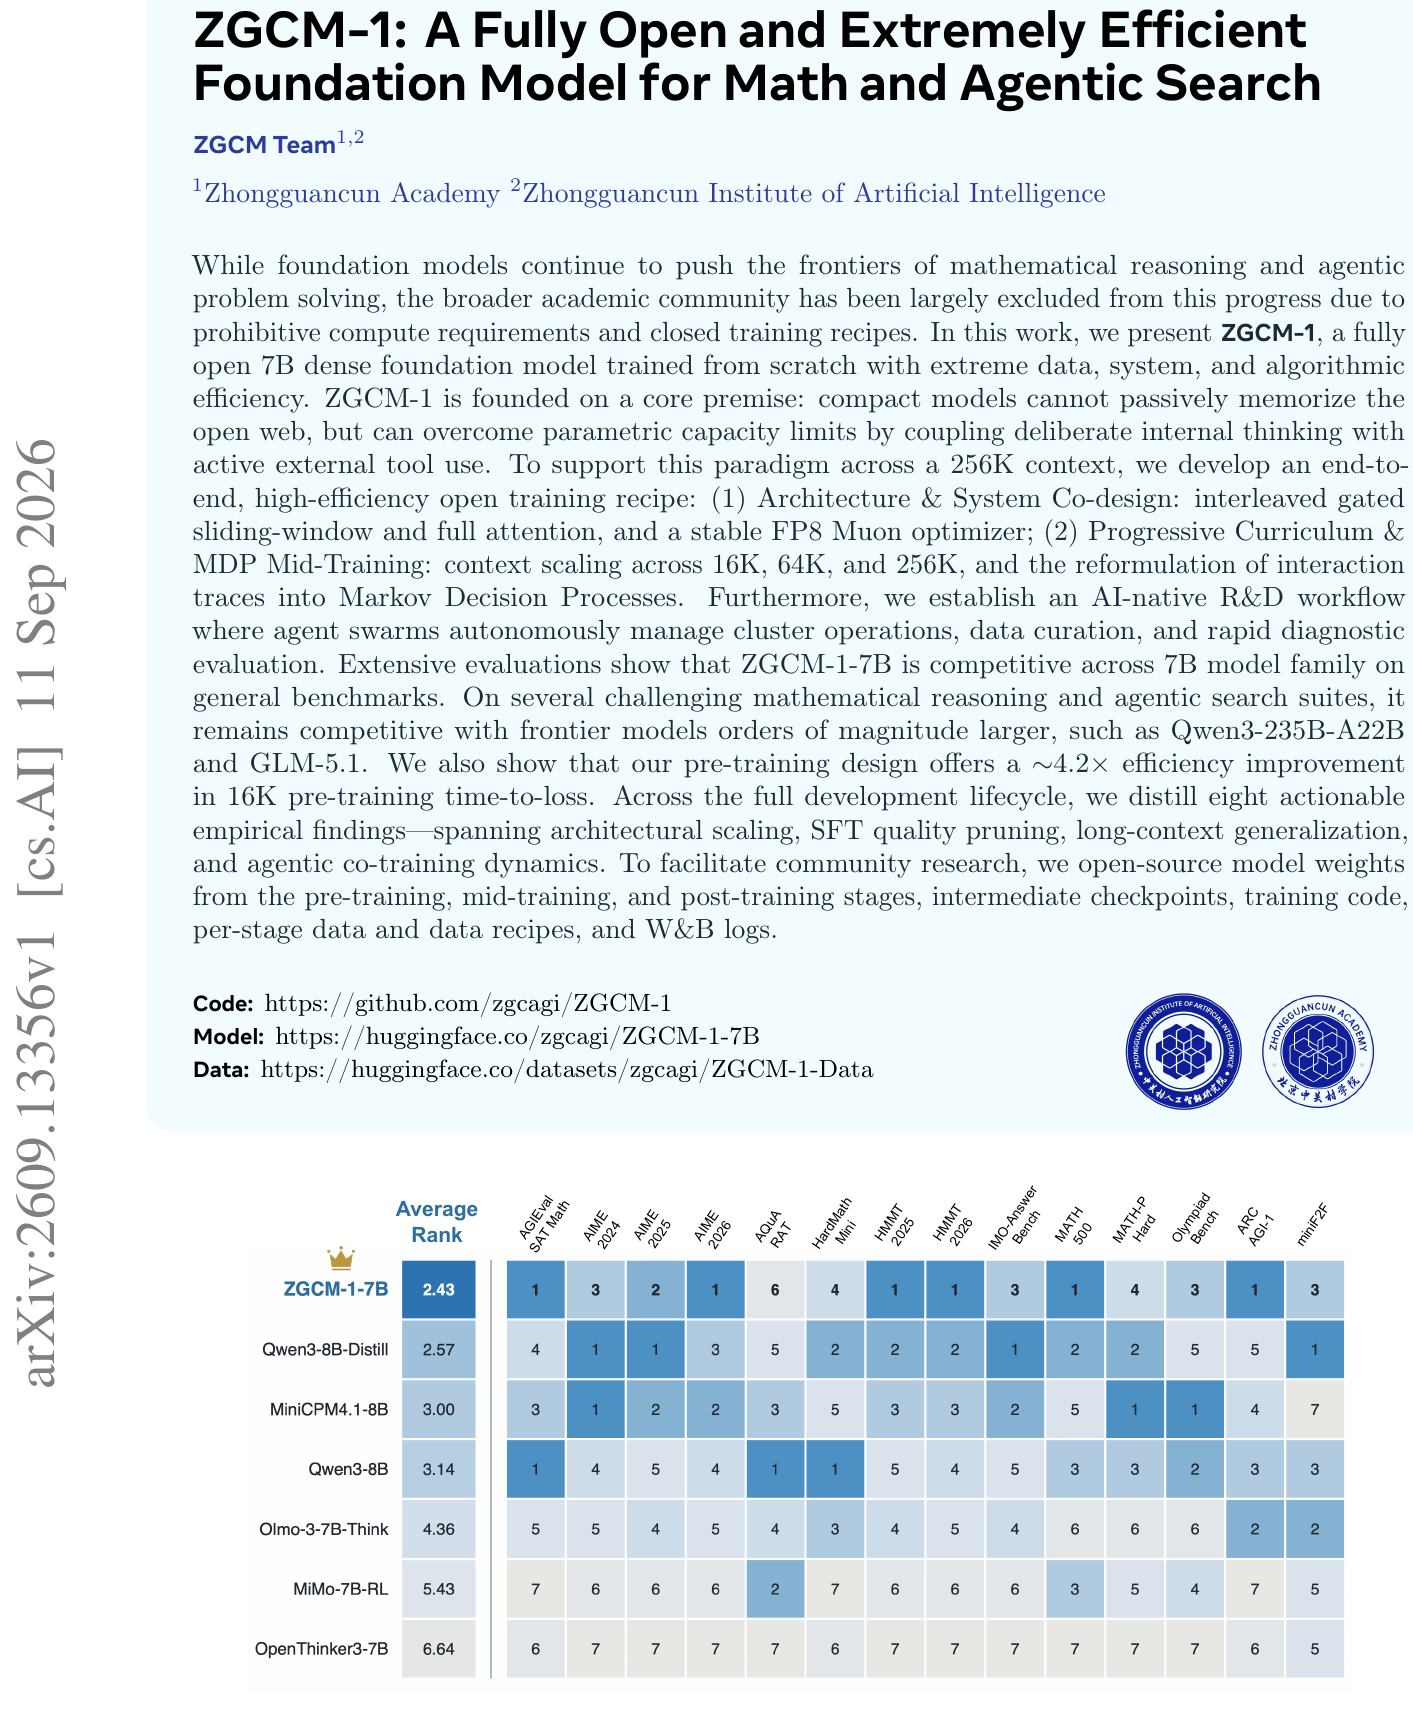
在过去一两年的大模型竞逐中,学术界与大多数中小研发团队其实陷入了一种双重困境:一方面是规模壁垒,顶尖的数学推理与深度智能体(Agent)搜索能力,似乎已经成了动辄千亿甚至万亿参数模型的专属特权;另一方面则是更为严重的黑盒壁垒,市面上所谓“开源”的模型,绝大多数仅仅是开放了最终权重(Open-weight),而最关键的上游清洗配方、中间训练(Mid-training)课程、长上下文渐进策略以及多轮 Agent 轨迹,依旧被牢牢锁在各家机构的私有服务器里。
ArXiv URL:https://arxiv.org/abs/2609.13356
来自中关村学院与中关村人工智能研究院的研究团队推出的 ZGCM-1,正是为了打破这种现状。这是一个参数量仅为 7.39B 的稠密基座模型,不仅从零开始训练,更在数据、系统和算法全链路实现了端到端开源——包括各阶段权重、中间检查点、训练代码、数据配方以及完整的 W&B 训练日志。
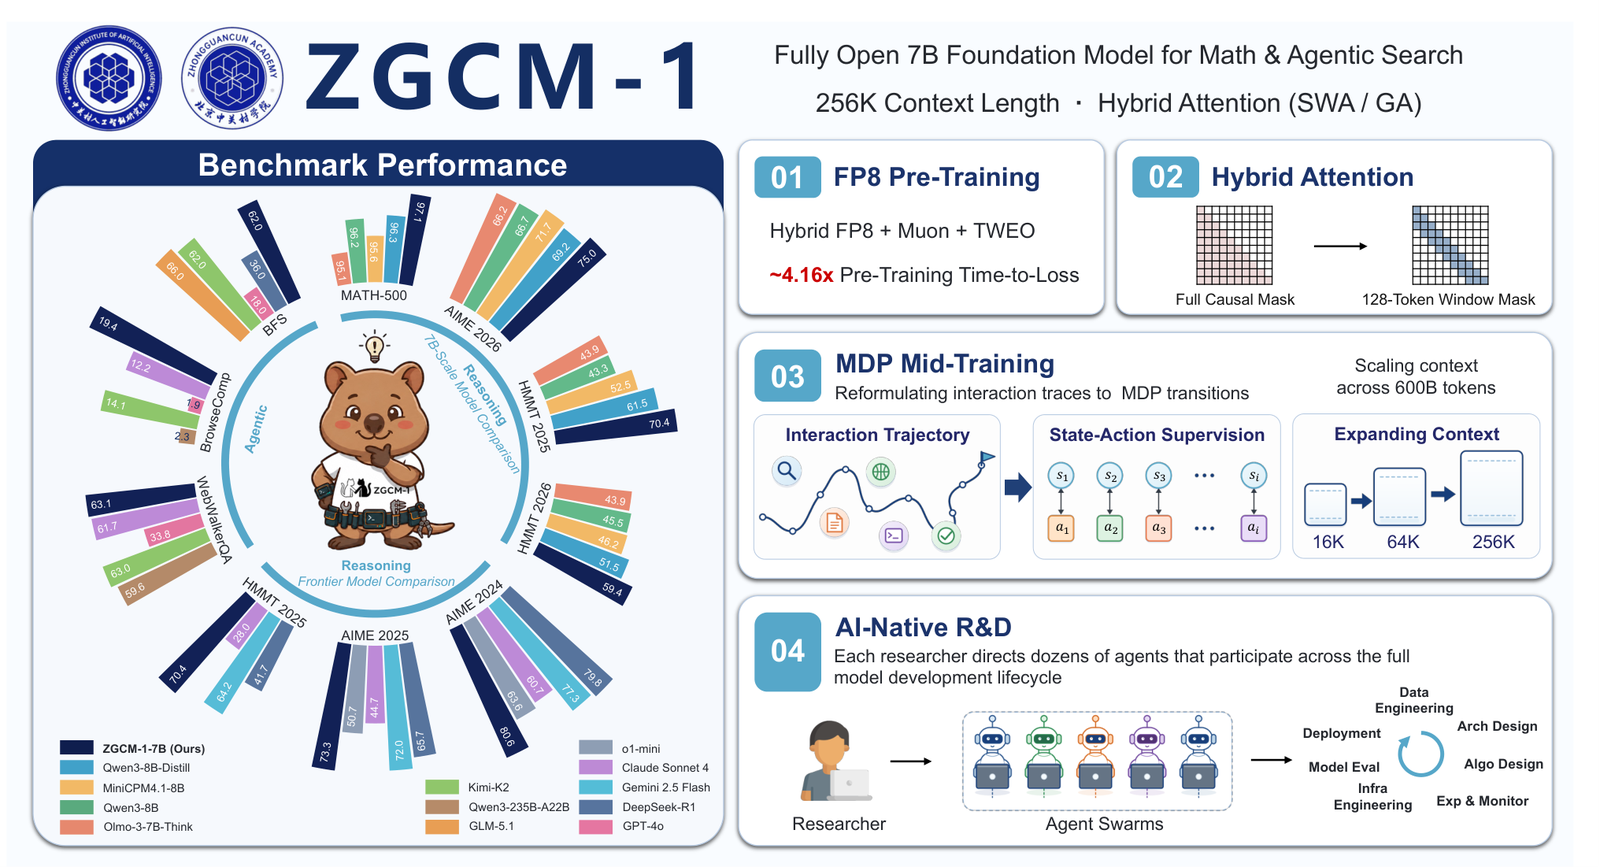
这项工作的立论核心非常直接:7B 规模的紧凑模型在物理参数容量上存在天然天花板,不可能被动死记硬背下整个互联网的海量事实;但小模型想要在复杂任务上越级匹敌前沿大模型,出路并不是盲目堆砌通用语料,而是将长程内在思维链推理(Internal Thinking)与主动外部工具使用(External Tool Use)深度耦合。当模型学会主动检索网页、调用代码执行器排查错误、甚至逆向分析二进制程序时,参数容量的局限就被外部动态获取的信息打破了。
凭借这一范式与多项系统级协同设计,ZGCM-1-7B 在 16K 预训练中实现了约 4.2 倍的训练效率提升(Time-to-loss),支持原生 256K 上下文,并在数学推理与复杂 Agent 搜索基准上,展现出足以叫板 Qwen3-235B-A22B、GLM-5.1 和 Claude 4 Sonnet 等数百亿乃至千亿参数庞然大物的战斗力。
架构与系统协同:让长上下文推理不再受困于显存
处理智能体交互与长程推理,最大的工程瓶颈往往来自显存与计算开销。当交互轮次不断增加、检索回传的网页堆叠至 256K 上下文时,传统全注意力(Full Attention)机制无论是在训练吞吐还是在推理时的键值缓存(KV Cache)占用上,都会迅速击穿硬件瓶颈。
为了让紧凑模型在长序列下具备极高吞吐,ZGCM-1 并没有盲目照搬现成架构,而是深入探索了混合注意力机制。模型骨架采用 32 层 Transformer,隐藏层维度 4,096,包含 32 个 Query 头和 8 个 Key-Value 头。最关键的改造在于,团队采用了门控滑动窗口注意力(Gated SWA)与全局注意力交替交错的混合结构(Hybrid SWA 5:1)。
在具体的层级排布上,全网络仅有 5 层保留全局全注意力,其余 27 层全部采用仅保留 128 个 Token 局部窗口的门控滑动窗口。公式定义为:
\[\operatorname{GatedSWA}(h)=o_{\mathrm{proj}}\!\left(A_{\mathrm{SWA}}(q,k,v)\odot\sigma(g_{\mathrm{proj}}(h))\right)\]这种门控机制对局部特征进行了自适应增益,同时极大地削减了全局上下文的交互开销。实验显示,在 4K 上下文时,该方案相比全注意力仅有约 1.13 倍的微弱吞吐提升;但随着序列长度延展到 256K,混合滑动窗口的吞吐优势直接放大到了 3.94 倍。
更具实用价值的收益发生在推理阶段。由于绝大部分层只需要缓存固定 128 个 Token 的局部状态,模型每个 Token 的 KV 占用从全注意力的 128 KiB 骤降至 20 KiB。在展开到 256K 上下文时,传统全注意力 7B 模型需要吞噬高达 32.0 GiB 的 KV 缓存,而 ZGCM-1 仅需 5.0 GiB,显存缩减达到惊人的 6.4 倍。在自回归解码严重受限于显存带宽的现实场景下,极度压缩的 KV Cache 意味着成倍提升的解码吞吐量,这恰恰为需要频繁长文本调用的深度 Agent 搜索扫清了工程障碍。
在优化器与数值精度层面,团队采用了专为大矩阵正交化更新设计的 Muon 优化器与 FP8 混合精度训练。针对 Transformer 中的二维权重矩阵,Muon 利用牛顿-舒尔茨迭代保持更新谱范数的一致性,标量参数则回退至常规 Adam。这一套组合拳——混合 SWA(1.4倍)、FP8 硬件优化(1.5倍)、Muon 优化器(1.8倍)以及 Pre-LN 结构改进(1.1倍)协同发力,最终在 16K 预训练阶段跑出了累积约 4.2 倍的训练提速。
课程预训练:表面词汇复杂度并不是通用的难度标尺
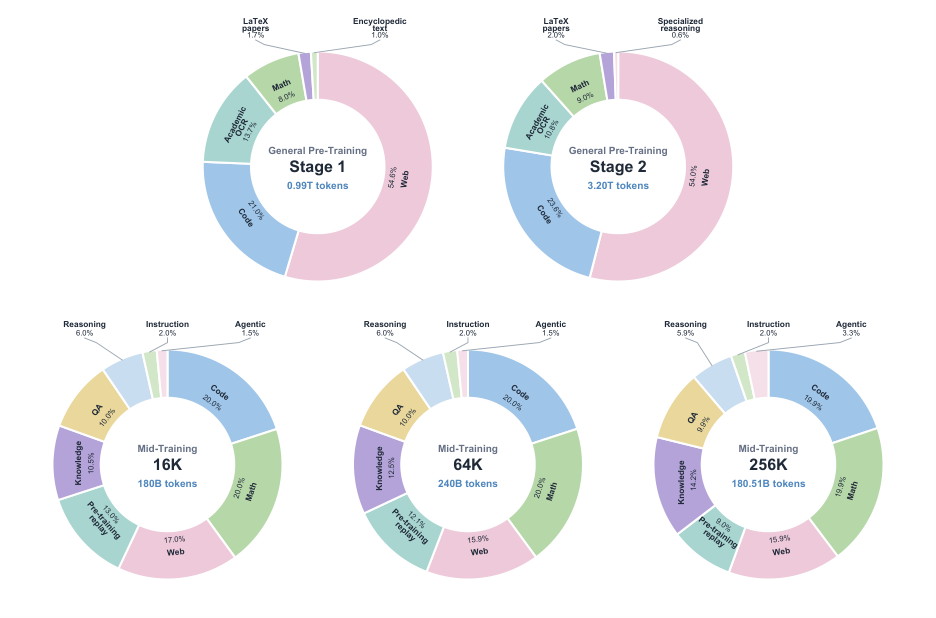
在预训练语料的处理上,ZGCM-1 的第一阶段包含了 0.99T Token 的课程学习(Curriculum Pre-training)探索。学界通常认为,按照“由易到难”呈现数据有助于加速收敛,但什么样的指标才能真正衡量数据的难度?
团队在实践中提炼出了至关重要的经验发现 1:基于词汇复杂度的统计排序,对于通用自然语言语料是一种低成本且有效的难度代理信号;但如果将这套指标直接照搬到代码和数学数据上,就会彻底失效。原因在于,代码和数学的表面词汇丰富度往往与真正的算法深度或逻辑推理链毫无关联——许多极其深奥的算法实现只包含极为简单的循环和基础关键字,而表面词汇冗长的片段反而多是模板化样板代码(Boilerplate)或低质抓取垃圾。
因此,ZGCM-1 确立了差异化的课程调度策略:仅对非代码、非数学的通用语料按词汇复杂度由低到高组织呈现,剔除极端复杂(多为乱码或损坏文本)的离群样本;而代码与数学数据则作为独立分支,平行交织插入训练流中。在 7B 探针测试中,这种混合课程设计让模型的代码 BPB(Bits Per Byte)从 1.99 骤降到 0.81,数学 BPB 从 0.97 降至 0.94,仅仅在通用文本损失上让出了不到 0.09 BPB 的轻微代价,极其精准地将表征能力倾斜在了高价值推理领域。
渐进式 Mid-Training 与 MDP 式交互重构
当通用预训练完成语言与世界常识的铺垫后,模型进入了决定其 Agent 与长上下文能力的中间训练(Mid-Training)阶段。团队从 2.86T 的候选池中去重抽取出 600.51B 高密度 Token,并采用了阶梯式上下文扩展:从 16K 逐步跃迁至 64K,最终延伸到 256K。
每一个后续阶段并非全量替代短序列,而是采取累积保留结构。例如 64K 阶段包含 180.89B 的 16K 以内 Token 以及 59.11B 的 16K–64K Token;256K 阶段则保留了超千亿的短上下文样本与三成以上的超长文本混合。通过动态调优全局 Batch Size(从 16K 阶段的 768,到 256K 阶段压缩至 48),全局每步计算维持恒定的约 12.6M Tokens,搭配将 RoPE 底数调增至 10M 并开启全激活重计算,保证了模型在跨越上下文长度跃迁时的数值稳定性。
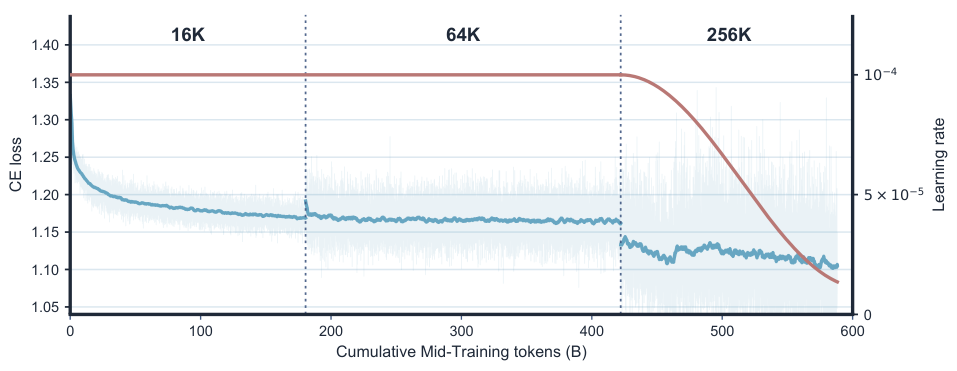
除了上下文尺度的扩展,Mid-Training 最具突破性的设计在于对 Agent 轨迹的数据建模范式重塑。团队并没有把外部工具交互日志当作普通的对话文本直接塞给模型,而是将其重构为马尔可夫决策过程(MDP)风格的状态-动作序列(State-conditioned Next-action Prediction)。
在长文本交互中,环境反馈、系统报错与工具回传的内容动辄数千字,若全部施加因果语言模型损失,模型极易退化成复读机或过度拟合特定工具的报错模板。将其改写为 MDP 范式后,上下文负责完整记录状态演变轨迹,但梯度的监督信号主要集中于局部决策步骤与动作预测。
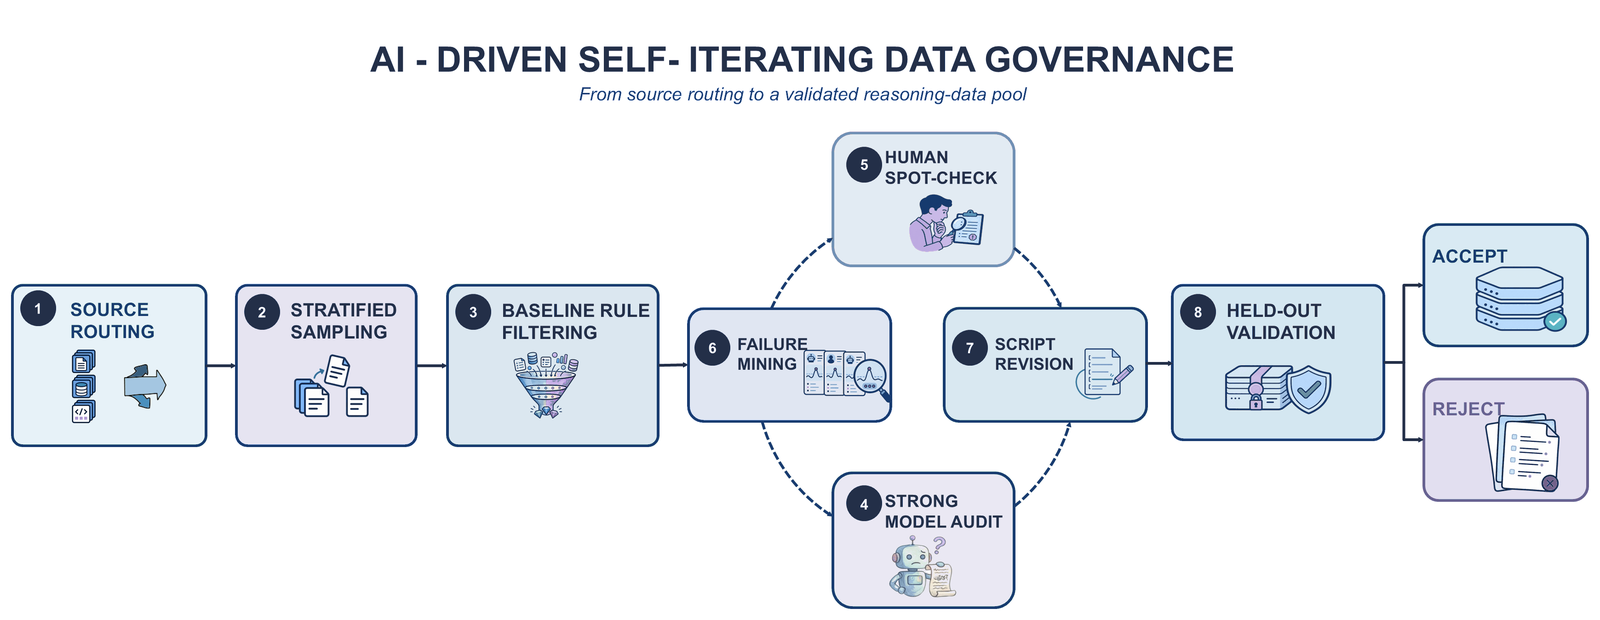
为了支撑如此庞大的推理与交互数据治理,团队搭建了一套由 Agent 群体自治驱动的闭环清洗管线。针对数学解题、软件工程、终端控制等不同源数据,流程首先通过规则抽样,交由强模型进行逻辑严谨性审计;在挖掘出失败用例后,Agent 自动迭代修复清洗脚本,并经由人工抽样复核与独立验证集测试,最终将清洗合格的语料送入候选池。这种机制彻底将问题的本体价值与原始数据中可能存在瑕疵的思维链解耦开来——题目立意极佳但前序过程混乱的数据,可以通过教师模型在受控环境下重新推导生成,避免了粗暴丢弃高价值题目。
后训练对齐:思考模式与直接模式的双向迁移
在监督微调(SFT)阶段,ZGCM-1 面临着一个经典的工业级矛盾:过度强调深度思考链(CoT)的模型在面对简短问答或常规指令时极其冗长啰嗦,且吞吐消耗巨大;而未经过深度思考洗礼的直接响应模型,遇到复杂任务又会立刻暴露出逻辑短板。
为此,团队在 492 万微调样本中设计了统一思考与直接响应混合监督(Unified Think and Direct-Response Supervision)。同一个底层权重,既学习包含显式逻辑标签(<think> ... </think>)的长程推理链,也学习直接给出紧凑最终答案的直答轨迹。
实验揭示出了一个非常惊艳的底层规律:思考训练能够正向迁移至直接响应能力(Thinking-to-Direct Transfer)。在混合训练中,即便强制模型在不展开 <think> 标签的情况下直接输出答案,模型在数学、代码与逻辑问题上的零样本表现也显著优于那些从未见过思考链的对照组。更重要的是,微调阶段依然必须牢牢锚定通用指令数据。团队在经验发现 6中明确指出:脱离通用数据的纯 Agent 微调会导致严重的交互退化。Agent 行为表面上是工具调用与 API 拼接,底层依赖的却是极高水准的指令遵循、格式对齐与因果推演;唯有与通用推理数据协同微调,模型才能在复杂的现实工具交互中保持高保真度的决策稳定性。
在具体落地的 Agent 分支上,ZGCM-1 针对三类严苛场景进行了深度适配:
-
深度研究(Deep Research):涵盖检索与深度网页访问,经过多轮状态配对验证,杜绝参数格式错乱与幻觉调用;
-
软件工程(SWE):区分可执行环境的真实排错轨迹与代码检索定位的执行无关轨迹,提升模型在复杂代码仓库中的补丁规划能力;
-
终端交互(Terminal):在隔离的 Docker 容器中捕获真实 Bash 执行轨迹,配合环境侧校验器确保每一步系统运维动作真实生效。
7B 撬动前沿大模型:实验结果意味着什么?
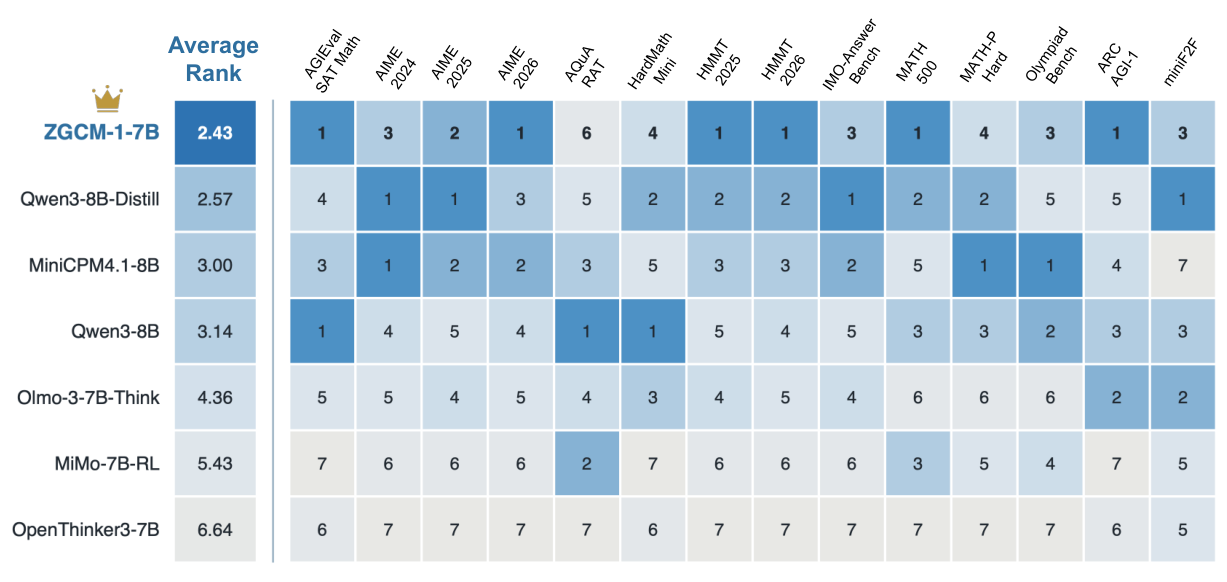
在最终的基准测试中,ZGCM-1 展现出的不仅是同级别参数量(7B 级别)中的压倒性优势,更是其跨越参数数量级越级挑战的能力。
在传统推理方面,结合深度思考的 ZGCM-1 保持了极高的解题密度;而最能体现其架构与方法论价值的,是需要高强度环境交互的 Agent 搜索任务。在极度考验复杂网页信息抓取与交叉求证的 WebWalkerQA 基准上,ZGCM-1 斩获了 63.1% 的得分;在极度严苛的网页浏览理解评测 BrowseComp 中取得 19.4%;在高度抽象且依赖逆向推演的 Binary Function Search 任务中,更是拿下了 62.0% 的佳绩。
这些成绩已经直接逼近甚至超越了参数量是其数十倍的业界顶级模型(如 Qwen3-235B-A22B、GLM-5.1、Kimi-K2 乃至闭源的 Claude 4 Sonnet)。这一结果为开源社区带来了一个极具说服力的结论:当紧凑模型掌握了可靠的工具调用协议,并且在 256K 上下文中具备极低开销的自适应检索与修正能力时,庞大参数池所承载的“被动世界知识”就不再是不可逾越的鸿沟。
更进一步,ZGCM-1 全面公开了从 0 到 1 的整套研发工作流与数据流水线,甚至将集群监控排障、数据清洗迭代交由 Agent 协作完成的 AI-native R&D 经验全盘托出。对于整个大模型研究生态而言,这项工作不仅证明了 7B 模型能达到的智能上限,更以完全透明的姿态,为计算资源受限的高校、研究所以及中小型开发者,提供了一套能够真正复现、修改并持续演进的高效基座大模型研发范本。