大模型编排到底划算吗?消耗2到4倍Token仅换来4.6%提升
When Does LLM Orchestration Pay Off? A Controlled Evaluation of Accuracy, Cost, and Task Difficulty
在推理阶段通过复杂的工作流编排来提升大语言模型(LLM)的推理能力,已经成为当前 AI 应用开发的显学。无论是让模型自我反思修正(Self-Refine)、多路采样择优(Best-of-$N$),还是引入多智能体辩论(Debate),直觉上更复杂的控制结构和更多的推理计算,理应换取更强的准确率。
ArXiv URL:https://arxiv.org/abs/2608.00685
然而,这笔“计算账”到底划不划算?现有研究在鼓吹编排收益时,往往忽视了两个关键漏洞:一是把“多智能体编排”带来的收益与“花费更多精力精细调试 Prompt”混为一谈;二是默认任务越难,编排带来的边际效益越大。
最新的一项严谨实证研究直接戳破了这一神话。研究人员在相同的自动化提示词优化预算下,横跨算法竞赛、国际象棋解谜与数学三大高难度推理场景,对五款主流开源底座模型进行了严格的受控评估。结果表明:多调用编排带来的平均准确率提升极其有限(最高仅 4.6 个百分点),但付出的 Token 资源代价却高达 2 到 4 倍;更关键的是,编排带来的收益并没有随着任务难度的增加而扩大,且不同模型之间的适配表现极度分化。
控制变量:把 Prompt 调优的“水分”挤干净
评估多智能体或编排工作流最大的痛点在于基准不公。一个包含生成、反思、评审的多节点复杂编排系统,通常由开发者投入了成倍的 Prompt 工程调试;而作为对比的单次调用基线(如基础 Chain-of-Thought, CoT)往往只是粗糙的简单 Prompt。这种“用精雕细琢对抗粗放原生”的对比,无法证明编排本身的拓扑结构有何独特价值。
为了剥离这种优化偏差,研究团队引入了自动化提示词优化框架 GEPA。无论是最简单的单次调用 CoT,还是包含多个模板节点的 Self-Refine、Best-of-$N$(BoN)与 Debate,都在完全相同的优化预算上限下进行调优。对于单次 CoT,优化器调整其思维链系统提示;对于 Self-Refine,联合优化生成、反馈与修正模板;对于 BoN,优化生成与打分选择模板;对于 Debate,则联合优化双智能体辩论与裁判提示。
在测试基准的选择上,研究采用了具备连续人类难度标注的 Easy2Hard-Bench,涵盖三大领域:
-
Codeforces:编程算法竞赛题目,通过代码测试用例自动验证结果;
-
Lichess:国际象棋战术解谜,依赖棋手天梯分评定难度,以标准走法为准;
-
AMC:美国数学竞赛,基于项目反应理论(IRT)校准题目难度。
底座模型则覆盖了 DeepSeek V4 Flash、Gemma 4(26B-A4B-it)、GLM 4.7 Flash、Qwen 3.6(35B-A3B-FP8)以及 NVIDIA GPT-OSS Puzzle 88B。所有测试均在固定的最大输出 Token 限制下运行,并引入“加权 Token”(Weighted Tokens,$t_w = \text{输入} + 4 \times [\text{输出} + \text{思考}]$)来真实折算推理开销。
收益天花板:耗费数倍算力,增益最高仅4.6%
当剥离了额外的调优红利后,编排带来的宏观增益远没有想象中惊艳。
在算法竞赛(Codeforces)上,单次调用的优化 CoT 整体平均准确率为 61.5%。采用 Self-Refine 后准确率达到 66.1%,提升了 4.6 个百分点;BoN 达到 65.7%(+4.2 个百分点);而结构最复杂的 Debate 仅提升到 63.7%(+2.2 个百分点)。在数学(AMC)基准上,各模型单次 CoT 的基线已经高达 87.9%,BoN 带来的最大增益也仅有 2.6 个百分点(提升至 90.5%),Self-Refine 提升 1.9 个百分点。而在国际象棋(Lichess)场景下,任何一种编排方式相较于优化后的单次 CoT 都没有产生统计学意义上的显著差异。
尤为讽刺的是被寄予厚望的“多智能体辩论”(Debate)。在全部三大基准测试中,Debate 在五次模型调用的高昂开销下,没有任何一项测试在统计学上显著战胜单次 CoT,甚至在部分场景下还出现了负向反噬。
与这微弱的个位数百分点提升形成鲜明对比的是暴涨的推理资源消耗。在 Codeforces 上,Self-Refine 消耗的加权 Token 是 CoT 的 2.12 倍,Debate 是 3.40 倍,BoN 更是飙升到了 3.76 倍;在 AMC 上,这三者的消耗倍数也分别达到了 1.82、3.08 和 3.25 倍。
换言之,系统为了挤出这 2 到 4 个百分点的准确率余量,必须承担平时 2 到 4 倍的 API 账单和数倍的推理延迟。这直接推翻了“更多交互必然换来更佳推理”的预设。
破除直觉迷思:任务越难,编排越有效?
行业中普遍存在一种假设:简单任务用单次推理即可,面对人类定义的高难度难题,才需要祭出多智能体协作或反思等重型编排。
这一假设在研究的严格统计检验下破灭了。虽然题目的人类难度(天梯积分或 IRT 难度)与模型的绝对解决率呈现极其显著的负相关(各领域 Spearman 相关系数在 $-0.485$ 到 $-0.660$ 之间,证明题目确实越来越难),但多调用编排带来的相对收益,并没有随题目难度的攀升而出现任何单调递增的趋势。
统计学家建立的线性混合效应模型显示,包含“编排方法 $\times$ 题目难度”交互项的模型,相较于纯加性模型,在拟合度上没有任何统计学改进(三个场景的显著性检验 $p$ 值分别为 0.688、0.972 和 0.874)。所有的编排相对斜率比值均在 1 左右徘徊,置信区间完全覆盖原假设。
这说明了一个残酷的现实:如果一个高难度难题超出了模型底层权重的知识表征与基础逻辑能力范畴,单纯靠多轮调用、让模型自己挑刺或多智能体胡乱辩论,根本无法无中生有地“涌现”出正确答案;相反,在盲目循环反思的过程中,模型极易推翻原本蒙对的正确结论,产生更严重的“过度思考”(Overthinking)。
真正的关键变量:编排方案与底座模型的强耦合
如果任务难度不能作为启动复杂编排的依据,那决策的核心应该是什么?
混合效应分析揭示了一个极为显著且被长期忽视的特征:编排方法与底座模型之间存在极强的交互异质性($p < 0.002$)。换句话说,一种编排架构究竟是良药还是毒药,不取决于任务难不难,而取决于你插在底层的是哪一家模型。
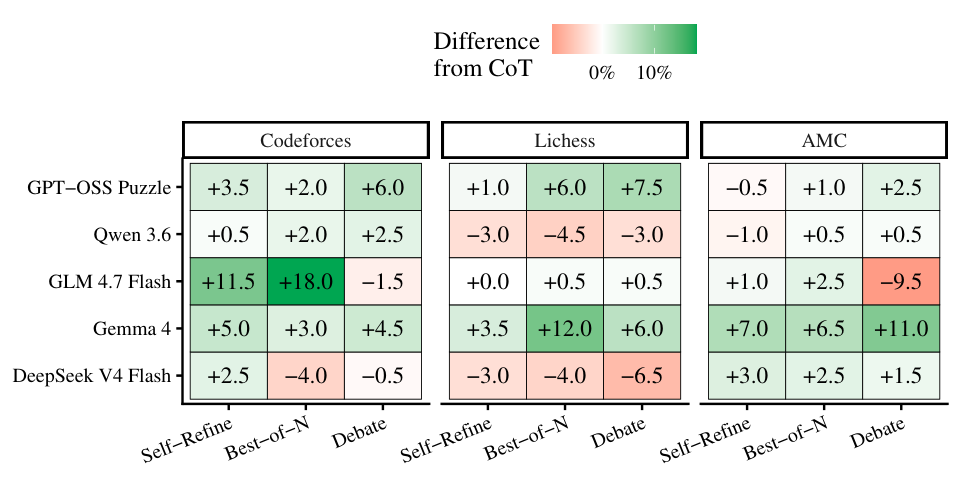
从模型维度的拆解数据中,可以清晰看到这种近乎割裂的极端分化:
-
GLM 4.7 Flash 在单次 CoT 下表现较弱,但在引入 BoN 候选选择后,Codeforces 上的准确率瞬间狂飙 18.0 个百分点;然而同样是 GLM,在 AMC 上引入 Debate 机制反而导致准确率大跌 9.5 个百分点。
-
Gemma 4 在 Lichess 上借助 BoN 实现了 12.0 个百分点的增益,在 AMC 上通过 Debate 获得了 11.0 个百分点的显著提升;但在另外一些基础场景下,Gemma 却频繁遭遇长文本推理超额,大量请求直接撞向 12 万 Token 的生成上限而归零。
-
DeepSeek V4 Flash 的表现则截然相反:由于其单次 CoT 基线本身已经足够强大(在多项任务中均跑出了顶级准确率),外加的多调用编排不仅几乎无法带来任何正面增益,反而在 Codeforces 上使用 BoN 下跌 4.0 个百分点,在 Lichess 上使用 Debate 大跌 6.5 个百分点。强大的底层模型在面对冗余的外挂反思机制时,反而被错误的判别逻辑拖了后腿。
这种现象在机理上完全说得通:Self-Refine 高度依赖模型的自我诊断能力,如果底座缺乏精准的错误捕捉机制,反思只会让回答南辕北辙;BoN 依赖生成的多样性与判别器的挑选水准;Debate 则需要极强的长上下文整合与事实裁判能力。底座模型在这些原子能力上的微小差异,在经过多层调用放大后,最终呈现出了天差地别的输出效果。
结语:告别无脑编排,回归精准算力账
这项研究为当下狂热的多智能体与复杂编排潮浇了一盆清醒的冷水。
它传递出的核心结论十分明确:在多数严肃推理场景下,经过充分 Prompt 调优的单次思考链(Single-call CoT)仍然是兼顾效果与成本的最高效默认解。
盲目设计花哨的“多智能体辩论”或“循环修正”拓扑,不仅极有可能在白白浪费 2 到 4 倍的 Token 账单后一无所获,甚至可能由于底层模型的判别短板导致整体效果劣变。企业在规划推理时计算架构时,绝不应脱离底座模型谈编排;唯有针对具体模型进行严格的准确率-成本平衡测试,并确认获得的微小准确率收益确实能在业务侧覆盖倍增的推理成本时,引入复杂编排才真正具有现实意义。